


Kubernetes Exit Code 143とは?
Kubernetes Exit Code 143は、コンテナが外部からのSIGTERM(シグナル15)リクエストによって正常に終了したことを示します。ほとんどの場合、これはアプリケーションのエラーではなく、Kubernetesがワークロードをグレースフルに停止するという本来の動作が正しく機能している証拠です。
なぜ発生するのか? KubernetesはPodのメインプロセス(PID 1)にSIGTERMシグナルを送信し、現在のタスクの完了、オープン中の接続のクローズ、クリーンな終了を要求します。主な運用上のトリガーは次のとおりです:
- デプロイまたはローリングアップデート: ロールアウト中に代替のPodが作成される際、Kubernetesは古いPodをSIGTERMで終了させます。
- Podの手動削除: Podを削除するとグレースフルな終了処理が開始され、通常はコンテナにSIGTERMが送信されます。
- Podのスケーリングとレプリカ数の削減: ワークロードをスケールダウンすると、不要になったレプリカが終了されます。
- ノードのドレインまたはPodのエビクション: メンテナンスやエビクションにより、ワークロードを他のノードへ移動するためにPodが終了されることがあります。
- Kubernetesノードのシャットダウン: グレースフルなノードシャットダウンでは、ノードの電源が切れる前にワークロードへSIGTERMが送信されることがあります。
- LivenessプローブまたはStartupプローブの失敗: プローブの失敗により、グレースフルな終了から始まるコンテナの再起動がトリガーされることがあります。
- アプリケーションやプロセスマネージャーによる終了: プロセスマネージャー、スクリプト、サイドカー、アプリケーションコンポーネントが直接SIGTERMを送信することがあります。
- クラスターのオートスケーリングまたはノードの置き換え: ノードの削除、アップグレード、修復、インフラの変更により、影響を受けるワークロードがグレースフルに終了されることがあります。
ベストプラクティスと対処法:
- SIGTERMのグレースフルなハンドリングを実装する: アプリケーションがSIGTERMを捕捉し、新しい処理の受け付けを停止し、必要なクリーンアップを完了してクリーンに終了するようにします。
- 適切なterminationGracePeriodSecondsを設定する: KubernetesがSIGKILLを送信する前に、アプリケーションがシャットダウン処理を完了できる十分な時間を確保します。
- 追加のシャットダウンロジックが必要な場合はpreStopフックを使用する: 通常のコンテナ終了の前に、サービスの登録解除やその他必要なシャットダウンタスクを実行します。
- バックグラウンドワーカーを安全に停止させる: 新しいジョブの受け付けを停止し、未完了の処理をリトライ可能または再開可能にすることで、処理の喪失や不整合を防ぎます。
- Exit Code 143は状況とあわせて監視する: すべての発生を障害として扱うのではなく、終了をロールアウト、スケーリング、ノード操作、プローブの失敗、アプリケーションエラーと関連付けて分析します。
本記事は、Kubernetesトラブルシューティングに関する連載記事の一部です
本記事の内容:
- KubernetesにおけるPod終了の仕組み
- Kubernetes Exit Code 143の主な原因
- Kubernetes Exit Code 143とExit Code 137の違い
- Kubernetes Exit Code 143のトラブルシューティング方法
- Kubernetes Exit Code 143を防ぐベストプラクティス
KubernetesにおけるPod終了の仕組み
ステップ1:KubernetesがコンテナにSIGTERMを送信する
Podの終了が開始されると、kubeletはコンテナランタイムにコンテナの停止を要求します。ランタイムは通常、各コンテナのメインプロセスにSIGTERMを送信します。SIGTERMはLinuxにおけるシグナル15で、プロセスを即座に強制終了するのではなく、正常な手順での終了を要求するものです。
アプリケーションはシグナルハンドラーを登録してSIGTERMに対応できます。たとえばWebサーバーであれば、既存のリクエストの完了を待ちながら、新規リクエストの受け付けを停止できます。アプリケーションがシグナルを明示的に処理しない場合は、デフォルトのシグナル動作に従って終了します。
コンテナやイメージに別の停止シグナルが設定されている場合、Kubernetesはそれを使用することもあります。ただし、SIGTERMはほとんどのKubernetesシャットダウンで使われる標準的なシグナルであり、Exit Code 143がよく見られる理由でもあります。
ステップ2:終了猶予期間が開始される
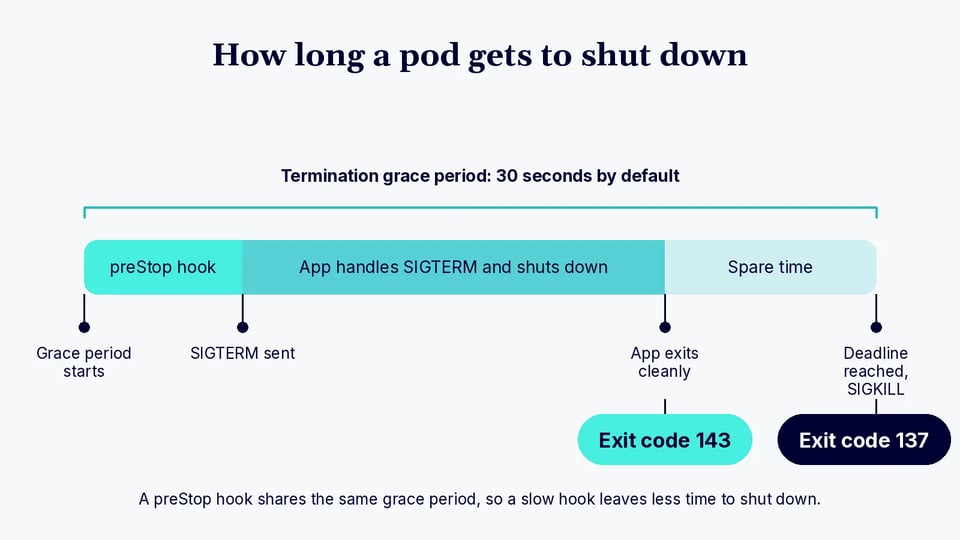
同時に、KubernetesはPodの終了猶予期間を開始します。この期間はPod仕様のterminationGracePeriodSecondsで制御され、デフォルトは30秒です。Kubernetesが残りのコンテナを強制停止するまでに、通常の終了処理に使える時間を定めるものです。
コンテナにpreStopライフサイクルフックがある場合、Kubernetesはランタイムにコンテナの停止を要求する前に、この終了期間中にフックを実行します。フックでは、他のサービスへの通知、トラフィックのドレイン待機、アプリケーション固有のシャットダウン動作のトリガーなどのタスクを行えます。
preStopフックは通常、追加のシャットダウン時間を提供するものではありません。その実行は同じ猶予期間を消費するため、実行時間の長いフックは、アプリケーションがSIGTERMを処理して自身のクリーンアップを完了するための時間を減らしてしまう可能性があります。
ステップ3:アプリケーションがグレースフルシャットダウンを実行する
SIGTERMを受信したら、アプリケーションはシャットダウン処理を開始すべきです。サーバーであれば、新規接続の受け付け停止、処理中リクエストの完了、データベース接続のクローズ、バッファされた書き込みのフラッシュ、バックグラウンドワーカーの停止などが考えられます。
シャットダウンロジックは、終了猶予期間が切れる前に完了する必要があります。そのため、長時間のリクエストやジョブを扱うアプリケーションでは、より長いterminationGracePeriodSecondsの値が必要になる場合があります。設定する期間には、ライフサイクルフックとアプリケーションの最悪ケースのシャットダウン時間の両方を考慮してください。
プロセスがSIGTERMの結果として終了した場合、監視ツールやコンテナのステータス情報にExit Code 143が記録されることがあります。この文脈では、このコードはアプリケーションのクラッシュではなく、Kubernetesが開始した通常のシャットダウンを示していることがほとんどです。
ステップ4:コンテナが終了しない場合、KubernetesがSIGKILLを送信する
終了期限に達してもコンテナが稼働し続けている場合、Kubernetesは強制シャットダウンを要求します。コンテナランタイムは残っているプロセスにSIGKILL(シグナル9)を送信します。SIGTERMとは異なり、SIGKILLはアプリケーションが捕捉・無視・処理することができません。
これにより、PodがTerminating状態のまま無期限に残り続けることを防ぎます。ただし、強制終了はアクティブなリクエストの中断、処理の未完了、バッファされたデータやアプリケーション状態の正しい書き込みの阻害につながる可能性があります。
SIGKILLで強制終了されたプロセスは、128 + 9 = 137であるため、通常Exit Code 137を返します。計画されたPod終了時にExit Code 137が繰り返し発生する場合は、アプリケーションのグレースフルシャットダウンが、利用可能な終了猶予期間よりも長くかかっている可能性があります。
Kubernetes Exit Code 143の主な原因
Exit Code 143は、コンテナのプロセスがSIGTERMを受信して終了したことを示します。Kubernetesでは通常、プラットフォームまたは別のプロセスが意図的にコンテナの停止を要求したときに発生します。前後のPodイベントやワークロードの履歴から、どの操作がシグナルをトリガーしたのかを特定できます。
デプロイまたはローリングアップデート
Deploymentのローリングアップデートの際、Kubernetesは新しいReplicaSet用のPodを作成し、古いReplicaSetのPodを終了させます。古いコンテナは、削除される前にグレースフルにシャットダウンできるようSIGTERMを受信します。したがって、計画されたロールアウト中にExit Code 143が見られるのは、通常は想定どおりの動作です。問題となるのは、シャットダウンがリクエストを中断させたり、設定された終了猶予期間を繰り返し超過したりする場合です。
Podの手動削除
kubectl delete podを実行すると、通常のPod終了プロセスが開始されます。KubernetesはPodに削除マークを付け、最終的にkubeletがコンテナランタイムにコンテナの停止を要求します(通常はSIGTERMを使用)。このシグナルによってアプリケーションのメインプロセスが終了した場合、KubernetesはExit Code 143を記録することがあります。Podを意図的に削除した場合、これは正常な動作です。
Podのスケーリングとレプリカ数の削減
Deployment、StatefulSet、またはその他のコントローラーのレプリカ数を減らすと、Kubernetesは不要になったPodを終了させます。これらのPodは標準的なグレースフル終了プロセスを経ます。たとえば、Deploymentを10レプリカから5レプリカにスケールダウンすると、5つのPodが停止する必要があります。それらのコンテナは、SIGTERM受信後にExit Code 143を報告することがあります。
ノードのドレインまたはPodのエビクション
ノードをドレインすると、通常は対象となるPodがエビクションされ、ワークロードが別の場所へ移動できるようになります。エビクションされたPodは元のノード上で終了され、コントローラーが利用可能な他のノード上に代替Podを作成できます。終了対象のコンテナは通常のシャットダウンシグナルを受信し、コード143で終了することがあります。ほぼ同時期にこうした終了が複数見られる場合、ノードのメンテナンスやインフラ操作が一般的な原因です。
Kubernetesノードのシャットダウン
KubernetesがOSのグレースフルシャットダウンを検出し、グレースフルノードシャットダウンが設定されている場合、kubeletはノードの電源が切れる前にPodを終了させることができます。これにより、ノードとともに突然消えるのではなく、ワークロードがクリーンに停止する時間が確保されます。この過程で終了されたコンテナはExit Code 143を報告することがあります。ノードイベントやホストのシャットダウン履歴を確認すれば、このケースをアプリケーションレベルの障害と区別できます。
LivenessプローブまたはStartupプローブの失敗
Livenessプローブの失敗が繰り返されると、Kubernetesは該当コンテナを再起動します。Startupプローブの失敗も、許容されるチェック回数内でアプリケーションが正常状態にならない場合に同じ結果をもたらします。再起動の一環として、kubeletはコンテナを終了させ、通常はグレースフルにシャットダウンする機会を与えます。プロセスがSIGTERM受信後に終了した場合、前回のコンテナ状態にExit Code 143が表示されることがあります。
アプリケーションやプロセスマネージャーによるSIGTERMの送信
SIGTERMは常にKubernetesから送られるとは限りません。以下の要素も、コンテナのメインプロセスにシグナル15を送信できます:
- シェルスクリプト
- スーパーバイザー
- プロセスマネージャー
- サイドカー
- アプリケーションコンポーネント
この場合、Kubernetesは結果として生じたプロセス終了を観測するだけです。Kubernetesイベントからはシグナルの送信元を特定できないことがあるため、アプリケーションログやプロセスマネージャーのログが重要になります。
クラスターのオートスケーリングまたはノードの置き換え
クラスターオートスケーラーは、キャパシティが不要になった際に利用率の低いノードを削除することがあります。マネージドKubernetesプラットフォームも、以下のタイミングでノードを置き換えることがあります:
- アップグレード
- メンテナンス
- 修復
- インフラの変更
意図的に削除されるノード上のワークロードは、通常ドレインまたは終了され、適切な場合は再スケジュールされます。このプロセス中にグレースフルに停止されたコンテナはExit Code 143を報告することがあり、その場合の根本原因はアプリケーションエラーではなくインフラ側のイベントです。
Kubernetes Exit Code 143とExit Code 137の違い
Exit Code 143と137はいずれも、コンテナがLinuxシグナルによって終了されたことを示しますが、対応するシグナルが異なります。Exit Code 143はSIGTERMに、Exit Code 137はSIGKILLに対応します:
- Exit Code 143は128 + 15として算出され、15はSIGTERMのシグナル番号です。このシグナルはアプリケーションにグレースフルシャットダウンの機会を与えます。Podの削除、ローリングアップデート、スケーリング、ノードのドレインなど、通常のKubernetes操作でよく見られます。
- Exit Code 137は128 + 9として算出され、9はSIGKILLのシグナル番号です。プロセスはSIGKILLを捕捉・処理できないため、終了は即座に行われます。Kubernetesは、終了猶予期間内にコンテナが終了しなかった場合にこれを使用することがあります。また、Exit Code 137は、Linuxカーネルがメモリ不足(OOM)によりプロセスを強制終了した場合にも発生します。
この違いはトラブルシューティングの際に役立ちます。Exit Code 143は通常、意図的な終了要求を示し、Exit Code 137は強制終了を示します。コード137の場合は、コンテナにOOMKilledの理由が表示されていないかを確認し、メモリ使用量と制限を見直してください。OOMによるものでなければ、アプリケーションが終了猶予期間を超過していないかを確認します。
Kubernetes Exit Code 143のトラブルシューティング方法
Exit Code 143のトラブルシューティングとは、誰がSIGTERMを送ったのか、そしてなぜ送ったのかを突き止めることです。Kubernetesは通常のワークロード管理でこのシグナルを頻繁に使用するため、Exit Codeだけでは障害とは判断できません。
まずPodとコンテナのステータスを確認し、次に終了時刻をログ、イベント、ロールアウト、スケーリング活動、ノード操作と関連付けます。また、アプリケーションがSIGTERM受信時に正しく応答するかも確認しましょう。
ステップ1:Podのステータスを確認する
まず、Podの現在の状態と詳細なステータスを確認します:
kubectl get pod <pod-name> -n <namespace>kubectl describe pod <pod-name> -n <namespace>コンテナの再起動、Podの状態(Conditions)、直近のイベント、終了に関する情報を確認します。kubectl describe podでは、プローブの失敗、エビクション、スケジューリングの変更など、シャットダウンに関連するその他のイベントも確認できます。
PodがDeployment、StatefulSet、その他のコントローラーによって管理されている場合は、そのオーナーも特定しましょう。終了が通常のコントローラー動作の一部だったかどうかの判断に役立ちます。
ステップ2:コンテナのExit Codeと終了理由を確認する
コンテナの現在および直前の終了状態を確認します。再起動したコンテナについては、KubernetesがExit Code、理由、シグナル、タイムスタンプなどの詳細を保持していることがあります:
kubectl get pod <pod-name> -n <namespace> \ -o jsonpath='{.status.containerStatuses[*].lastState.terminated}'記録されたExit Codeが143であることを確認します。あわせて終了理由と、startedAtおよびfinishedAtのタイムスタンプも確認しましょう。これらはKubernetesイベントやアプリケーションログと突き合わせることができます。
Exit Code 143そのものが原因を説明していると考えないでください。これは、プロセスがSIGTERMによって終了したことを示すだけで、どのKubernetes操作や外部プロセスが終了を開始したのかまでは分かりません。
ステップ3:現在および直前のコンテナログを確認する
終了時刻前後のアプリケーションログを確認します:
kubectl logs <pod-name> -n <namespace>コンテナが再起動している場合は、前回のコンテナインスタンスのログを確認します:
kubectl logs <pod-name> -n <namespace> --previousシャットダウンメッセージ、シグナル受信メッセージ、未完了のリクエスト、接続エラー、アプリケーションの例外を探します。SIGTERMの受信、新規処理の停止、リソースのクローズ、終了という一連の正常な流れが確認できれば、通常はグレースフルな終了を示しています。
複数コンテナのPodでは、-c <container-name>で対象のコンテナを指定します。
ステップ4:Kubernetesイベントを調べる
Kubernetesイベントからは、終了直前に何が起きたのかという文脈を得られます:
kubectl get events -n <namespace> \ --sort-by=.metadata.creationTimestampプローブの失敗、Podのエビクション、コンテナの再起動、スケーリング、スケジューリング、ノードの問題に関するメッセージを探します。イベントのタイムスタンプをコンテナの終了タイムスタンプと比較してください。
イベントは有用ですが、完全な監査証跡ではありません。期限切れで消えることがあり、また、すべてのPod終了原因が、なぜSIGTERMが送られたのかを明確に説明するイベントを生成するとは限りません。
ステップ5:Deploymentとロールアウトの状況を確認する
Deploymentの更新やその他のワークロード変更中にコンテナが停止したのかどうかを確認します:
kubectl rollout status deployment/<deployment-name> -n <namespace>kubectl rollout history deployment/<deployment-name> -n <namespace>Deploymentのトラブルシューティングでは、ReplicaSetも確認しましょう。終了時刻の前後に新しいReplicaSetが出現している場合、ロールアウトによって古いPodが置き換えられていた可能性が高いと言えます。
Exit Code 143が新しいアプリケーションバージョンのデプロイ時にのみ発生するのであれば、通常のPod置き換えの一部である可能性が高いです。次に確認すべきは、それらのPodがリクエストを落としたり処理を失ったりすることなく、クリーンにシャットダウンしているかどうかです。
ステップ6:スケーリング、エビクション、ノードイベントを確認する
レプリカの変更、オートスケーリング、ノードのドレイン、インフラ操作が終了のタイミングと一致していないかを確認します。HorizontalPodAutoscalerを使用しているワークロードでは、その現在の状態と直近の挙動を確認します:
kubectl get hpa -n <namespace>kubectl describe hpa <hpa-name> -n <namespace>Podが稼働していたノードも確認します:
kubectl describe node <node-name>ノードのシャットダウン、メンテナンス、リソース圧迫、オートスケーラーの動作、エビクション関連のイベントを探します。無関係な多数のPodがほぼ同時に終了している場合は、アプリケーション固有の問題よりも、ノードレベルまたはクラスターレベルの操作である可能性が高くなります。
ステップ7:アプリケーションがSIGTERMを正しく処理しているかを確認する
最後に、アプリケーションのメインプロセスがSIGTERMにどう応答するかを検証します。通常は、新規処理の受け付けを停止し、アクティブな操作を完了または安全にキャンセルし、必要なデータをフラッシュし、外部接続を閉じて、終了猶予期間が切れる前に終了すべきです。
Podに設定されている猶予期間を確認します:
kubectl get pod <pod-name> -n <namespace> \ -o jsonpath='{.spec.terminationGracePeriodSeconds}'また、シグナルが実際にアプリケーションに届いているかも確認してください。シェルスクリプトや設定が誤っているプロセスマネージャー経由でアプリケーションを起動しているコンテナでは、アプリケーションがPID 1でない場合にシグナルの転送が妨げられることがあります。
グレースフルシャットダウンが利用可能な期間より常に長くかかる場合は、シャットダウン処理を改善するか、必要に応じてterminationGracePeriodSecondsを増やしましょう。アプリケーションに直接SIGTERMを送ってテストすれば、シグナルハンドラーが実行され、想定時間内に終了することを確認できます。
Kubernetes Exit Code 143を防ぐベストプラクティス {#best-practices-to-prevent-kubernetes-exit-code-143}
ここでは、Kubernetesを運用する際にExit Code 143を防ぐための方法をいくつか紹介します。
1. SIGTERMのグレースフルなハンドリングを実装する
アプリケーションはSIGTERMを明示的に処理し、シグナルが到着したら正常な手順でシャットダウンを開始すべきです。サービスは、新規処理の受け付けを停止し、アクティブなリクエストを完了または安全にキャンセルし、接続を閉じ、バッファされたデータをフラッシュしてから終了します。
アプリケーションが実際にシグナルを受信していることを必ず確認してください。ラッパーのシェルスクリプトやプロセスマネージャーがシグナルを正しく転送しないと、シグナルがアプリケーションに届かないことがあります。エントリーポイントスクリプトでexecを使えば、シェルをアプリケーションプロセスに置き換えられます:
exec /app/my-serviceこれによりアプリケーションがPID 1となり、コンテナの終了シグナルが直接届くようになります。
2. 適切なterminationGracePeriodSecondsを設定する
アプリケーションが通常のシャットダウン処理を完了できる十分な長さに、terminationGracePeriodSecondsを設定します。Kubernetesのデフォルトは30秒ですが、長時間のリクエスト、バッチジョブ、メッセージコンシューマー、クリーンアップ作業の多いアプリケーションには不十分な場合があります。
例:
spec: terminationGracePeriodSeconds: 60単に大きなタイムアウトを設定するのではなく、実際に観測されたシャットダウン時間に基づいて値を決めてください。不必要に長い猶予期間はロールアウト、スケーリング操作、ノードメンテナンスを遅らせる可能性があるため、アプリケーションは可能な限り速やかに終了すべきです。
3. 追加のシャットダウンロジックが必要な場合はpreStopフックを使用する
preStopフックを使うと、コンテナが通常の停止シグナルを受け取る前に追加のロジックを実行できます。シャットダウンに明示的なコマンド、サービスの登録解除、またはアプリケーションの標準的なSIGTERMハンドラーの外で行う操作が必要な場合に有用です。
例:
lifecycle: preStop: exec: command: ["/bin/sh", "-c", "/app/prepare-shutdown.sh"]フックは短く、信頼性の高いものに保ちましょう。フックの実行時間はPodの終了猶予期間を消費するため、遅いpreStopフックは、SIGTERM受信後にアプリケーションがシャットダウンに使える時間を減らしてしまいます。
4. バックグラウンドワーカーを安全に停止させる
バックグラウンドワーカーにも、HTTPサービスと同様に終了処理が必要です。ワーカーがSIGTERMを受信したら、通常は新しいジョブの受け付けを停止し、現在のジョブを完了させるか、キューシステムがサポートする仕組みを使って未完了の処理をキューに戻すべきです。
ジョブの処理が途中の状態で即座に終了することは避けてください。ワークロードによっては、処理の喪失、重複処理、不完全なデータベース更新、アプリケーション状態の不整合につながる可能性があります。
長時間実行されるジョブについては、終了猶予期間が想定される処理時間と整合していることを確認してください。期間内に確実に完了できないジョブは、リトライ可能または再開可能になるように設計しましょう。
5. Exit Code 143は状況とあわせて監視する
Exit Code 143が発生するたびにアラートを出さないでください。ローリングデプロイ、Podの手動削除、スケールダウン操作、ノードのドレインなど、日常的なKubernetesの動作では発生が想定されるものです。
その代わりに、Exit Code 143をPodの再起動率、デプロイ活動、Kubernetesイベント、ノード操作、アプリケーションエラー、失敗したリクエストと関連付けて分析します。既知のクラスター操作がないのにSIGTERMによる終了が繰り返される場合は、さらなる調査が必要です。
前後の状況とあわせて監視することで、Exit Code 143は診断シグナルとして有用になります。正常なライフサイクル活動を、プローブの失敗、不安定なワークロード、予期しないプロセス終了、インフラの変更と区別するのに役立ちます。
FAQ
Kubernetes Exit Code 143はエラーですか? 通常はエラーではありません。Exit Code 143は、コンテナのメインプロセスがSIGTERMを受信して停止したことを意味します。Kubernetesはローリングアップデート、Podの削除、スケールダウン、ノードのドレインなどの通常の動作中にこのシグナルを送信するため、このコードだけでは障害とは判断できません。
Exit Code 143とExit Code 137の違いは何ですか? Exit Code 143は128 + 15で、SIGTERM受信後にプロセスが停止したことを意味し、アプリケーションにはグレースフルシャットダウンの機会が与えられます。Exit Code 137は128 + 9で、捕捉できないSIGKILLを意味します。コンテナが終了猶予期間内に終了しなかった場合や、メモリ不足で強制終了された場合に発生します。
KubernetesはSIGKILLを送信するまでどのくらい待ちますか? 終了猶予期間のデフォルトは30秒で、terminationGracePeriodSecondsで設定します。preStopフックも同じ時間枠内で実行されるため、フックの処理が遅いと、アプリケーションがSIGTERMを処理する時間が減ります。
SIGTERMの送信元はどうすれば特定できますか? まずkubectl describe podとコンテナの直前の終了状態を確認し、次にタイムスタンプをKubernetesイベント、ロールアウト履歴、HPAの動作、ノードイベントと比較します。クラスター内に一致するものがなければ、スクリプト、スーパーバイザー、サイドカーもSIGTERMを送信できるため、アプリケーションやプロセスマネージャーのログを確認してください。
Exit Code 143でアラートを出すべきですか? いいえ、すべての発生に対してではありません。既知のロールアウト、スケーリング、ノード操作がないのにSIGTERMによる終了が繰り返される、あるいは失敗したリクエストや再起動率の上昇と重なるといったパターンに対してアラートを出しましょう。
PerfectScaleで、どんな終了処理でもKubernetesワークロードを安定稼働
Exit Code 143は通常、正常なライフサイクル活動の表れですが、ロールアウト、スケールダウン、ノードの変更が頻繁に行われると、日常的な終了と本当のレジリエンス問題を見分けるのが難しくなります。DoiTのPerfectScale for Kubernetesは、安定性を最優先とするアプローチで、ワークロードの特性を踏まえた自動化を提供し、あらゆる最適化推奨の中心にアプリケーションの健全性を据えます。プラットフォームチーム、SREチーム、FinOpsチームは、クラスターの健全性、パフォーマンス、コストを単一のビューで把握できるため、手動での監視や再設定を繰り返すことなく、レジリエンスの問題を発見し、ワークロードを適正化できます。
PerfectScale for Kubernetesの主な機能:
- レジリエンス問題の検出: Podfitはクラスターの健全性とコストをきめ細かく可視化し、注意が必要な領域を優先順位付けして、無駄なリソースやレジリエンスの問題を素早く特定できるよう支援します。
- 安定性を最優先にしたライトサイジング: コンテキストを考慮したライトサイジングが、パフォーマンスのベースライン、トラフィックパターン、ビジネス上の重要度に基づいてアクションを調整するため、最適化がアプリケーションの健全性を犠牲にすることはありません。
- 自律的なワークロード最適化: データドリブンな推奨と自動化ワークフローがワークロードを継続的に適正化し、エンジニアリングの時間を奪う再設定の繰り返しを解消します。
- オートスケーラー設定のインサイト: 実行可能な推奨によりHPAやKEDAの設定を改善でき、InfrafitはKarpenterなどのノードオートスケーラーの効果を最大化します。
- ノード使用率の可視化: Infrafitがアイドル状態のノードキャパシティを特定し、ワークロードに最適なノードを推奨することで、クラスターのパフォーマンスと信頼性を最大限に引き出します。
- コンテナレベルのリソース追跡: CPUとメモリをコンテナレベルで監視し、無駄を排除して実際の使用量に基づいてリソースを設定できます。
- ガードレールとポリシー: ワークロードの重要度と環境タイプに応じた最適化ルールを定義し、本番ワークロードを保護します。
- マルチクラウド・マルチクラスターの可視性: GPU使用率の追跡を含め、クラスター数やクラウドプロバイダーを問わず、データドリブンなインテリジェンス、ポリシー適用、最適化アクションを利用できます。
信頼性が高く、コスト効率に優れたKubernetesワークロードを運用しませんか?PerfectScale for Kubernetesの詳細はこちら。