


Was ist Kubernetes Exit Code 143?
Kubernetes Exit Code 143 zeigt an, dass ein Container durch eine externe SIGTERM-Anforderung (Signal 15) erfolgreich beendet wurde. In den meisten Fällen handelt es sich dabei nicht um einen Anwendungsfehler, sondern um ein Zeichen dafür, dass Kubernetes genau wie vorgesehen arbeitet und einen Workload kontrolliert herunterfährt.
Warum tritt er auf? Kubernetes sendet ein SIGTERM-Signal an den Hauptprozess eines Pods (PID 1) und fordert ihn damit auf, laufende Aufgaben abzuschließen, offene Verbindungen zu schließen und sich sauber zu beenden. Häufige betriebliche Auslöser sind:
- Deployment oder Rolling Update: Kubernetes beendet alte Pods per SIGTERM, während bei einem Rollout Ersatz-Pods erstellt werden.
- Manuelles Löschen eines Pods: Das Löschen eines Pods startet die kontrollierte Terminierung und sendet normalerweise SIGTERM an seine Container.
- Pod-Skalierung und Reduzierung der Replicas: Beim Herunterskalieren eines Workloads werden nicht mehr benötigte Replicas beendet.
- Node Drain oder Pod-Eviction: Wartungsarbeiten oder Evictions können Pods beenden, damit Workloads auf andere Nodes verschoben werden können.
- Herunterfahren eines Kubernetes-Nodes: Beim kontrollierten Herunterfahren eines Nodes kann SIGTERM an Workloads gesendet werden, bevor sich der Node abschaltet.
- Fehlgeschlagene Liveness- oder Startup-Probes: Fehlgeschlagene Probes können Container-Neustarts auslösen, die mit einer kontrollierten Terminierung beginnen.
- Terminierung durch Anwendung oder Prozessmanager: Ein Prozessmanager, Skript, Sidecar oder eine Anwendungskomponente kann SIGTERM direkt senden.
- Cluster-Autoscaling oder Node-Austausch: Das Entfernen von Nodes, Upgrades, Reparaturen und Infrastrukturänderungen können betroffene Workloads kontrolliert beenden.
Best Practices und Lösungswege:
- Implementieren Sie eine saubere SIGTERM-Behandlung: Stellen Sie sicher, dass die Anwendung SIGTERM abfängt, keine neuen Aufgaben mehr annimmt, notwendige Aufräumarbeiten abschließt und sich sauber beendet.
- Setzen Sie ein passendes terminationGracePeriodSeconds: Geben Sie der Anwendung genug Zeit, ihren Shutdown-Prozess abzuschließen, bevor Kubernetes SIGKILL sendet.
- Nutzen Sie einen preStop-Hook, wenn zusätzliche Shutdown-Logik erforderlich ist: Führen Sie die Deregistrierung von Services oder andere notwendige Shutdown-Aufgaben vor der normalen Container-Terminierung aus.
- Sorgen Sie dafür, dass Background-Worker sicher herunterfahren: Nehmen Sie keine neuen Jobs mehr an und machen Sie unerledigte Arbeit wiederholbar oder fortsetzbar, um verlorene oder inkonsistente Verarbeitung zu verhindern.
- Überwachen Sie Exit Code 143 im Kontext: Korrelieren Sie Terminierungen mit Rollouts, Skalierung, Node-Operationen, Probe-Fehlern und Anwendungsfehlern, statt jedes Auftreten als Fehler zu behandeln.
Dieser Artikel ist Teil einer Serie über Kubernetes-Troubleshooting
In diesem Artikel:
- So funktioniert die Pod-Terminierung in Kubernetes
- Häufige Ursachen für Kubernetes Exit Code 143
- Kubernetes Exit Code 143 vs. Exit Code 137
- Troubleshooting von Kubernetes Exit Code 143
- Best Practices zur Vermeidung von Kubernetes Exit Code 143
So funktioniert die Pod-Terminierung in Kubernetes
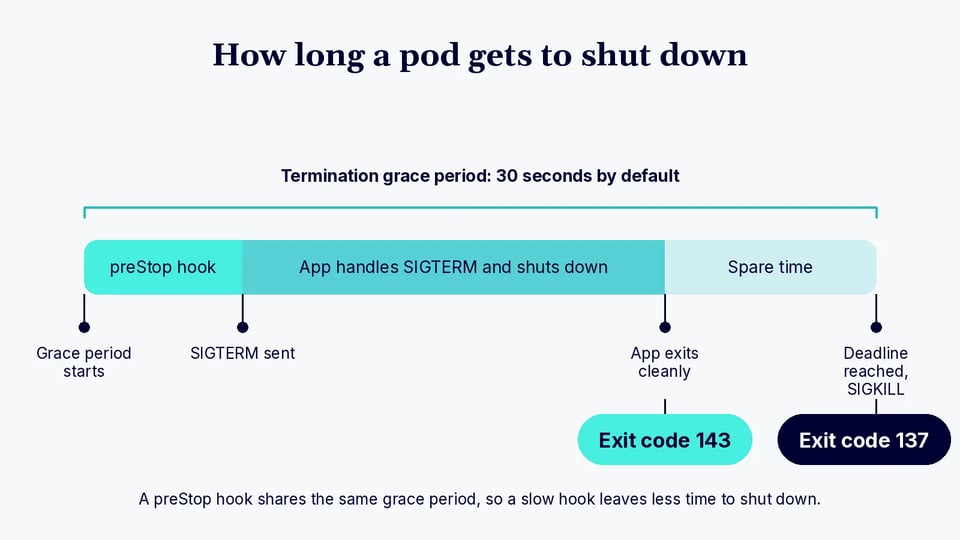
Schritt 1: Kubernetes sendet SIGTERM an den Container
Wenn die Pod-Terminierung beginnt, fordert das kubelet die Container-Runtime auf, die Container zu stoppen. Die Runtime sendet normalerweise SIGTERM an den Hauptprozess jedes Containers. SIGTERM ist unter Linux das Signal 15 und fordert ein geordnetes Herunterfahren an, statt den Prozess sofort zu beenden.
Anwendungen können einen Signal-Handler registrieren, um auf SIGTERM zu reagieren. Ein Webserver kann zum Beispiel keine neuen Requests mehr annehmen, während laufende Requests noch abgeschlossen werden. Behandelt die Anwendung das Signal nicht explizit, bestimmt ihr Standard-Signalverhalten, wie sie sich beendet.
Kubernetes kann auch ein anderes Stopp-Signal verwenden, wenn eines für den Container oder das Image konfiguriert ist. SIGTERM ist jedoch das Standardsignal bei den meisten Kubernetes-Shutdowns und der Grund, warum Exit Code 143 so häufig auftritt.
Schritt 2: Die Termination Grace Period beginnt
Gleichzeitig startet Kubernetes die Termination Grace Period des Pods. Dieser Zeitraum wird über terminationGracePeriodSeconds in der Pod-Spezifikation gesteuert und beträgt standardmäßig 30 Sekunden. Er legt fest, wie viel Zeit für den normalen Terminierungsprozess zur Verfügung steht, bevor Kubernetes verbleibende Container zwangsweise stoppt.
Hat der Container einen preStop-Lifecycle-Hook, führt Kubernetes diesen während der Terminierungsphase aus, bevor die Runtime aufgefordert wird, den Container zu stoppen. Der Hook kann Aufgaben übernehmen wie das Benachrichtigen eines anderen Services, das Warten auf das Abfließen des Traffics oder das Auslösen anwendungsspezifischer Shutdown-Logik.
Der preStop-Hook verschafft normalerweise keine zusätzliche Shutdown-Zeit. Seine Ausführung zählt zur selben Grace Period – ein lang laufender Hook kann der Anwendung also weniger Zeit lassen, SIGTERM zu verarbeiten und ihre eigenen Aufräumarbeiten abzuschließen.
Schritt 3: Die Anwendung fährt kontrolliert herunter
Nach dem Empfang von SIGTERM sollte die Anwendung ihren Shutdown-Prozess starten. Ein Server kann etwa keine neuen Verbindungen mehr annehmen, laufende Requests abschließen, Datenbankverbindungen schließen, gepufferte Schreibvorgänge wegschreiben und Background-Worker stoppen.
Die Shutdown-Logik sollte abgeschlossen sein, bevor die Termination Grace Period abläuft. Anwendungen mit lang laufenden Requests oder Jobs benötigen daher unter Umständen einen höheren Wert für terminationGracePeriodSeconds. Der konfigurierte Zeitraum sollte sowohl Lifecycle-Hooks als auch die maximale Shutdown-Dauer der Anwendung berücksichtigen.
Beendet sich der Prozess infolge von SIGTERM, können Monitoring-Tools und Container-Statusinformationen Exit Code 143 melden. In diesem Kontext deutet der Code oft auf ein normales, von Kubernetes initiiertes Herunterfahren hin und nicht auf einen Absturz der Anwendung.
Schritt 4: Kubernetes sendet SIGKILL, wenn der Container sich nicht beendet
Läuft ein Container beim Erreichen der Terminierungsfrist noch, fordert Kubernetes ein erzwungenes Herunterfahren an. Die Container-Runtime sendet dann SIGKILL, also Signal 9, an den verbleibenden Prozess. Anders als SIGTERM kann SIGKILL von der Anwendung nicht abgefangen, ignoriert oder behandelt werden.
Das verhindert, dass ein Pod unbegrenzt im Terminating-Status hängen bleibt. Eine erzwungene Terminierung kann jedoch aktive Requests unterbrechen, Arbeit unvollständig zurücklassen oder verhindern, dass gepufferte Daten und der Anwendungszustand korrekt geschrieben werden.
Ein mit SIGKILL beendeter Prozess erzeugt üblicherweise Exit Code 137, da 128 + 9 = 137. Wiederholter Exit Code 137 bei geplanten Pod-Terminierungen kann daher darauf hindeuten, dass das kontrollierte Herunterfahren der Anwendung länger dauert als die verfügbare Termination Grace Period.
Häufige Ursachen für Kubernetes Exit Code 143
Exit Code 143 zeigt an, dass der Container-Prozess SIGTERM empfangen hat und beendet wurde. In Kubernetes passiert das in der Regel, weil die Plattform oder ein anderer Prozess den Container absichtlich zum Stoppen aufgefordert hat. Die zugehörigen Pod-Events und die Workload-Historie helfen dabei zu erkennen, welche Operation das Signal ausgelöst hat.
Deployment oder Rolling Update
Bei einem Rolling Update eines Deployments erstellt Kubernetes Pods für das neue ReplicaSet und beendet Pods des alten ReplicaSets. Die alten Container erhalten SIGTERM, damit sie vor dem Entfernen kontrolliert herunterfahren können. Exit Code 143 während eines geplanten Rollouts ist daher in der Regel zu erwarten. Kritisch wird es erst, wenn das Herunterfahren Requests unterbricht oder wiederholt die konfigurierte Termination Grace Period überschreitet.
Manuelles Löschen eines Pods
Der Befehl kubectl delete pod startet den normalen Terminierungsprozess des Pods. Kubernetes markiert den Pod zum Löschen, und das kubelet fordert die Container-Runtime schließlich auf, die Container zu stoppen – normalerweise per SIGTERM. Beendet sich der Hauptprozess der Anwendung aufgrund dieses Signals, kann Kubernetes Exit Code 143 protokollieren. Das ist normal, wenn der Pod absichtlich gelöscht wurde.
Pod-Skalierung und Reduzierung der Replicas
Wird die Replica-Anzahl eines Deployments, StatefulSets oder eines anderen Controllers reduziert, beendet Kubernetes die nicht mehr benötigten Pods. Diese durchlaufen den standardmäßigen kontrollierten Terminierungsprozess. Wird ein Deployment zum Beispiel von zehn auf fünf Replicas herunterskaliert, müssen fünf Pods stoppen. Deren Container können nach dem Empfang von SIGTERM Exit Code 143 melden.
Node Drain oder Pod-Eviction
Beim Draining eines Nodes werden geeignete Pods normalerweise per Eviction verdrängt, damit Workloads anderswo weiterlaufen können. Verdrängte Pods werden auf dem alten Node beendet, während ihre Controller Ersatz-Pods auf anderen verfügbaren Nodes erstellen können. Die zu beendenden Container erhalten die normalen Shutdown-Signale und können sich mit Code 143 beenden. Node-Wartung und Infrastruktur-Operationen sind häufige Gründe dafür, dass mehrere solcher Terminierungen etwa zeitgleich auftreten.
Herunterfahren eines Kubernetes-Nodes
Erkennt Kubernetes ein geordnetes Herunterfahren des Betriebssystems und ist Graceful Node Shutdown konfiguriert, kann das kubelet Pods beenden, bevor sich der Node abschaltet. So haben Workloads Zeit, sauber zu stoppen, statt mit dem Node schlagartig zu verschwinden. Container, die während dieses Prozesses beendet werden, können Exit Code 143 melden. Ein Blick auf Node-Events und Host-Shutdown-Aktivitäten hilft, diesen Fall von Fehlern auf Anwendungsebene zu unterscheiden.
Fehlgeschlagene Liveness- oder Startup-Probes
Wiederholt fehlgeschlagene Liveness Probes führen dazu, dass Kubernetes den betroffenen Container neu startet. Fehlgeschlagene Startup Probes können dasselbe Ergebnis haben, wenn die Anwendung innerhalb der zulässigen Checks keinen gesunden Zustand erreicht. Im Rahmen des Neustarts beendet das kubelet den Container und gibt ihm normalerweise die Gelegenheit, kontrolliert herunterzufahren. Beendet sich der Prozess nach dem Empfang von SIGTERM, kann der vorherige Container-Status Exit Code 143 zeigen.
SIGTERM durch Anwendung oder Prozessmanager
SIGTERM stammt nicht immer von Kubernetes. Auch diese Komponenten können Signal 15 an den Hauptprozess des Containers senden:
- Ein Shell-Skript
- Ein Supervisor
- Ein Prozessmanager
- Ein Sidecar
- Eine Anwendungskomponente
In diesem Fall beobachtet Kubernetes nur die resultierende Prozess-Terminierung. Anwendungs- und Prozessmanager-Logs sind wichtig, weil Kubernetes-Events den ursprünglichen Absender des Signals möglicherweise nicht identifizieren.
Cluster-Autoscaling oder Node-Austausch
Ein Cluster Autoscaler kann wenig genutzte Nodes entfernen, wenn Kapazität nicht mehr benötigt wird. Managed-Kubernetes-Plattformen können Nodes außerdem ersetzen bei:
- Upgrades
- Wartungsarbeiten
- Reparaturen
- Infrastrukturänderungen
Workloads auf absichtlich entfernten Nodes werden typischerweise gedraint oder anderweitig beendet und bei Bedarf neu eingeplant. Container, die dabei kontrolliert gestoppt werden, können Exit Code 143 melden – die eigentliche Ursache ist dann das Infrastruktur-Ereignis, nicht ein Anwendungsfehler.
Kubernetes Exit Code 143 vs. Exit Code 137
Die Exit Codes 143 und 137 zeigen beide an, dass ein Container durch ein Linux-Signal beendet wurde – sie stehen jedoch für unterschiedliche Signale. Exit Code 143 entspricht SIGTERM, Exit Code 137 entspricht SIGKILL:
- Exit Code 143 berechnet sich aus 128 + 15, wobei 15 die Signalnummer von SIGTERM ist. Dieses Signal gibt der Anwendung die Chance, kontrolliert herunterzufahren. Er tritt häufig bei Pod-Löschungen, Rolling Updates, Skalierung, Node Drains und anderen normalen Kubernetes-Operationen auf.
- Exit Code 137 berechnet sich aus 128 + 9, wobei 9 die Signalnummer von SIGKILL ist. Ein Prozess kann SIGKILL weder abfangen noch behandeln, die Terminierung erfolgt also sofort. Kubernetes kann es einsetzen, wenn sich ein Container nicht vor Ablauf seiner Termination Grace Period beendet. Exit Code 137 kann auch auftreten, wenn der Linux-Kernel einen Prozess wegen einer Out-of-Memory-Situation beendet.
Die Unterscheidung ist beim Troubleshooting hilfreich. Exit Code 143 deutet in der Regel auf eine absichtliche Terminierungsanfrage hin, Exit Code 137 auf eine erzwungene Terminierung. Prüfen Sie bei Code 137, ob der Container den Grund OOMKilled anzeigt, und kontrollieren Sie Speichernutzung und Limits. Wurde er nicht OOM-gekillt, klären Sie, ob die Anwendung ihre Termination Grace Period überschritten hat.
Troubleshooting von Kubernetes Exit Code 143
Beim Troubleshooting von Exit Code 143 geht es darum herauszufinden, wer SIGTERM gesendet hat – und warum. Da Kubernetes dieses Signal im normalen Workload-Management häufig nutzt, ist der Exit Code allein noch kein Hinweis auf einen Fehler.
Beginnen Sie mit dem Pod- und Container-Status und korrelieren Sie anschließend den Terminierungszeitpunkt mit Logs, Events, Rollouts, Skalierungsaktivitäten und Node-Operationen. Prüfen Sie außerdem, ob die Anwendung korrekt reagiert, wenn sie SIGTERM empfängt.
Schritt 1: Pod-Status prüfen
Prüfen Sie zunächst den aktuellen Zustand und den detaillierten Status des Pods:
kubectl get pod <pod-name> -n <namespace>kubectl describe pod <pod-name> -n <namespace>Achten Sie auf Container-Neustarts, Pod-Conditions, aktuelle Events und Terminierungsinformationen. kubectl describe pod kann außerdem Probe-Fehler, Eviction-Aktivitäten, Scheduling-Änderungen und weitere Events rund um das Herunterfahren aufdecken.
Wird der Pod von einem Deployment, StatefulSet oder einem anderen Controller verwaltet, identifizieren Sie auch dessen Owner. Das hilft zu klären, ob die Terminierung Teil der normalen Controller-Aktivität war.
Schritt 2: Exit Code und Terminierungsgrund des Containers prüfen
Untersuchen Sie den aktuellen und den vorherigen Terminierungsstatus des Containers. Bei einem neu gestarteten Container kann Kubernetes Details wie Exit Code, Grund, Signal und Zeitstempel vorhalten:
kubectl get pod <pod-name> -n <namespace> \ -o jsonpath='{.status.containerStatuses[*].lastState.terminated}'Bestätigen Sie, dass der protokollierte Exit Code 143 lautet. Prüfen Sie außerdem den Terminierungsgrund sowie die Zeitstempel startedAt und finishedAt, die sich mit Kubernetes-Events und Anwendungs-Logs korrelieren lassen.
Gehen Sie nicht davon aus, dass Exit Code 143 selbst die Ursache erklärt. Er sagt Ihnen, dass der Prozess wegen SIGTERM beendet wurde – aber nicht, welche Kubernetes-Operation oder welcher externe Prozess die Terminierung ausgelöst hat.
Schritt 3: Aktuelle und vorherige Container-Logs prüfen
Prüfen Sie die Anwendungs-Logs rund um den Terminierungszeitpunkt:
kubectl logs <pod-name> -n <namespace>Wurde der Container neu gestartet, sehen Sie sich die Logs der vorherigen Container-Instanz an:
kubectl logs <pod-name> -n <namespace> --previousAchten Sie auf Shutdown-Meldungen, Meldungen über empfangene Signale, nicht abgeschlossene Requests, Verbindungsfehler und Anwendungs-Exceptions. Eine saubere Abfolge – SIGTERM empfangen, keine neue Arbeit mehr annehmen, Ressourcen schließen, beenden – deutet in der Regel auf eine kontrollierte Terminierung hin.
Geben Sie bei Pods mit mehreren Containern den relevanten Container mit -c <container-name> an.
Schritt 4: Kubernetes-Events untersuchen
Kubernetes-Events können Kontext dazu liefern, was unmittelbar vor der Terminierung passiert ist:
kubectl get events -n <namespace> \ --sort-by=.metadata.creationTimestampAchten Sie auf Meldungen zu fehlgeschlagenen Probes, Pod-Evictions, Container-Neustarts, Skalierung, Scheduling oder Node-Problemen. Vergleichen Sie die Zeitstempel der Events mit dem Terminierungszeitpunkt des Containers.
Events sind nützlich, aber kein vollständiger Audit-Trail. Sie können ablaufen, und nicht jede Ursache einer Pod-Terminierung erzeugt ein Event, das klar erklärt, warum SIGTERM gesendet wurde.
Schritt 5: Deployment- und Rollout-Aktivitäten prüfen
Klären Sie, ob der Container während eines Deployment-Updates oder einer anderen Workload-Änderung gestoppt wurde:
kubectl rollout status deployment/<deployment-name> -n <namespace>kubectl rollout history deployment/<deployment-name> -n <namespace>Untersuchen Sie beim Troubleshooting eines Deployments auch die ReplicaSets. Taucht rund um den Terminierungszeitpunkt ein neues ReplicaSet auf, ist das ein starkes Indiz dafür, dass alte Pods im Rahmen eines Rollouts ersetzt wurden.
Tritt Exit Code 143 nur beim Deployment neuer Anwendungsversionen auf, ist er meist Teil des normalen Pod-Austauschs. Die nächste Frage lautet dann, ob diese Pods sauber herunterfahren, ohne Requests abzubrechen oder Arbeit zu verlieren.
Schritt 6: Auf Skalierung, Evictions oder Node-Events prüfen
Prüfen Sie, ob Replica-Änderungen, Autoscaling, Node Drains oder Infrastruktur-Operationen zeitlich mit der Terminierung zusammenfallen. Bei Workloads mit einem HorizontalPodAutoscaler untersuchen Sie dessen aktuellen Zustand und das jüngste Verhalten:
kubectl get hpa -n <namespace>kubectl describe hpa <hpa-name> -n <namespace>Untersuchen Sie außerdem den Node, auf dem der Pod lief:
kubectl describe node <node-name>Achten Sie auf Node-Shutdowns, Wartungsarbeiten, Pressure-Conditions, Autoscaler-Aktivitäten oder Eviction-bezogene Events. Wenn viele voneinander unabhängige Pods etwa zeitgleich beendet werden, ist eine Operation auf Node- oder Cluster-Ebene wahrscheinlicher als ein anwendungsspezifisches Problem.
Schritt 7: Prüfen, ob die Anwendung SIGTERM korrekt behandelt
Überprüfen Sie abschließend, wie der Hauptprozess der Anwendung auf SIGTERM reagiert. Er sollte normalerweise keine neue Arbeit mehr annehmen, aktive Operationen abschließen oder sicher abbrechen, notwendige Daten wegschreiben, externe Verbindungen schließen und sich vor Ablauf der Termination Grace Period beenden.
Prüfen Sie die konfigurierte Grace Period des Pods:
kubectl get pod <pod-name> -n <namespace> \ -o jsonpath='{.spec.terminationGracePeriodSeconds}'Stellen Sie außerdem sicher, dass Signale die Anwendung tatsächlich erreichen. Container, die Anwendungen über Shell-Skripte oder falsch konfigurierte Prozessmanager starten, können die Signalweiterleitung stören, wenn die Anwendung nicht PID 1 ist.
Dauert das kontrollierte Herunterfahren regelmäßig länger als der verfügbare Zeitraum, verbessern Sie den Shutdown-Pfad oder erhöhen Sie terminationGracePeriodSeconds, wo es sinnvoll ist. Ein direkter Test der Anwendung mit SIGTERM kann bestätigen, dass ihr Signal-Handler ausgeführt wird und sie sich innerhalb der erwarteten Zeit beendet.
Best Practices zur Vermeidung von Kubernetes Exit Code 143 {#best-practices-to-prevent-kubernetes-exit-code-143}
Hier einige Möglichkeiten, wie Sie Exit Code 143 bei der Arbeit mit Kubernetes vermeiden können.
1. Saubere SIGTERM-Behandlung implementieren
Anwendungen sollten SIGTERM explizit behandeln und beim Eintreffen des Signals ein geordnetes Herunterfahren einleiten. Ein Service sollte keine neue Arbeit mehr annehmen, aktive Requests abschließen oder sicher abbrechen, Verbindungen schließen, gepufferte Daten wegschreiben und sich dann beenden.
Stellen Sie sicher, dass die Anwendung das Signal tatsächlich erhält. Wrapper-Shell-Skripte und Prozessmanager können verhindern, dass Signale die Anwendung erreichen, wenn sie diese nicht korrekt weiterleiten. Mit exec in einem Entrypoint-Skript lässt sich die Shell durch den Anwendungsprozess ersetzen:
exec /app/my-serviceDadurch wird die Anwendung PID 1, und Terminierungssignale des Containers erreichen sie direkt.
2. Ein passendes terminationGracePeriodSeconds setzen
Setzen Sie terminationGracePeriodSeconds so, dass die Anwendung ihren normalen Shutdown-Prozess abschließen kann. Kubernetes verwendet standardmäßig 30 Sekunden – für lang laufende Requests, Batch-Jobs, Message-Consumer oder Anwendungen mit umfangreichen Aufräumarbeiten kann das zu knapp sein.
Zum Beispiel:
spec: terminationGracePeriodSeconds: 60Orientieren Sie den Wert an beobachteten Shutdown-Zeiten, statt einfach ein großes Timeout zu setzen. Anwendungen sollten sich dennoch so schnell wie praktikabel beenden, denn eine unnötig lange Grace Period kann Rollouts, Skalierungsoperationen und Node-Wartung verzögern.
3. preStop-Hook nutzen, wenn zusätzliche Shutdown-Logik erforderlich ist
Ein preStop-Hook kann zusätzliche Logik ausführen, bevor der Container sein normales Stopp-Signal erhält. Das ist nützlich, wenn das Herunterfahren einen expliziten Befehl, die Deregistrierung eines Services oder eine andere Operation außerhalb des standardmäßigen SIGTERM-Handlers der Anwendung erfordert.
Zum Beispiel:
lifecycle: preStop: exec: command: ["/bin/sh", "-c", "/app/prepare-shutdown.sh"]Halten Sie den Hook kurz und zuverlässig. Seine Laufzeit zählt zur Termination Grace Period des Pods – ein langsamer preStop-Hook verkürzt also die Zeit, die der Anwendung nach dem Empfang von SIGTERM zum Herunterfahren bleibt.
4. Background-Worker sicher herunterfahren lassen
Background-Worker brauchen eine Terminierungsbehandlung genauso wie HTTP-Services. Erhält ein Worker SIGTERM, sollte er normalerweise keine neuen Jobs mehr annehmen und entweder seinen aktuellen Job abschließen oder unerledigte Arbeit über den vom Queue-System unterstützten Mechanismus in die Queue zurückgeben.
Vermeiden Sie ein sofortiges Beenden, während ein Job nur teilweise verarbeitet ist. Je nach Workload kann das zu verlorener Arbeit, doppelter Verarbeitung, unvollständigen Datenbank-Updates oder einem inkonsistenten Anwendungszustand führen.
Für lang laufende Jobs: Stellen Sie sicher, dass die Termination Grace Period mit den erwarteten Verarbeitungszeiten vereinbar ist. Wo Jobs nicht zuverlässig innerhalb dieses Zeitraums abgeschlossen werden können, gestalten Sie sie wiederholbar oder fortsetzbar.
5. Exit Code 143 im Kontext überwachen
Alarmieren Sie nicht bei jedem Auftreten von Exit Code 143. Er ist bei Rolling Deployments, manuellen Pod-Löschungen, Scale-Down-Operationen, Node Drains und anderen routinemäßigen Kubernetes-Aktivitäten zu erwarten.
Korrelieren Sie Exit Code 143 stattdessen mit Pod-Neustartraten, Deployment-Aktivitäten, Kubernetes-Events, Node-Operationen, Anwendungsfehlern und fehlgeschlagenen Requests. Wiederholte SIGTERM-Terminierungen ohne bekannte Cluster-Operation verdienen eine genauere Untersuchung.
Durch die Überwachung des Kontexts wird Exit Code 143 zu einem nützlichen Diagnosesignal. Er hilft, gesunde Lifecycle-Aktivität von Probe-Fehlern, instabilen Workloads, unerwarteten Prozess-Terminierungen oder Infrastrukturänderungen zu unterscheiden.
FAQ
Ist Kubernetes Exit Code 143 ein Fehler? In der Regel nicht. Exit Code 143 bedeutet, dass der Hauptprozess des Containers SIGTERM empfangen hat und gestoppt wurde. Kubernetes sendet dieses Signal bei normalen Aktivitäten wie Rolling Updates, Pod-Löschungen, Scale-Downs und Node Drains – der Code allein deutet also nicht auf einen Fehler hin.
Was ist der Unterschied zwischen Exit Code 143 und Exit Code 137? Exit Code 143 ist 128 + 15 und bedeutet, dass der Prozess nach SIGTERM gestoppt wurde, was der Anwendung die Chance gibt, kontrolliert herunterzufahren. Exit Code 137 ist 128 + 9 und bedeutet SIGKILL, das nicht abgefangen werden kann. Er kann auftreten, wenn ein Container seine Termination Grace Period überschreitet oder wegen Speichermangels beendet wird.
Wie lange wartet Kubernetes, bevor SIGKILL gesendet wird? Die Termination Grace Period beträgt standardmäßig 30 Sekunden und wird mit terminationGracePeriodSeconds festgelegt. Ein preStop-Hook läuft innerhalb desselben Zeitfensters – ein langsamer Hook lässt der Anwendung also weniger Zeit, SIGTERM zu verarbeiten.
Wie finde ich heraus, wer das SIGTERM gesendet hat? Beginnen Sie mit kubectl describe pod und dem letzten Terminierungsstatus des Containers und vergleichen Sie dann die Zeitstempel mit Kubernetes-Events, der Rollout-Historie, HPA-Aktivitäten und Node-Events. Wenn im Cluster nichts zusammenpasst, prüfen Sie Anwendungs- und Prozessmanager-Logs, denn auch ein Skript, Supervisor oder Sidecar kann SIGTERM senden.
Sollte ich bei Exit Code 143 Alarme auslösen? Nein, nicht bei jedem Auftreten. Alarmieren Sie stattdessen bei Mustern, etwa wiederholten SIGTERM-Terminierungen ohne bekannte Rollout-, Skalierungs- oder Node-Operation oder bei Terminierungen, die mit fehlgeschlagenen Requests oder steigenden Neustartraten zusammenfallen.
Mit PerfectScale bleiben Kubernetes Workloads bei jeder Terminierung stabil
Exit Code 143 ist in der Regel ein Zeichen gesunder Lifecycle-Aktivität. Häufige Rollouts, Scale-Downs und Node-Änderungen machen es jedoch schwieriger, routinemäßige Terminierungen von echten Resilienzproblemen zu unterscheiden. PerfectScale for Kubernetes by DoiT liefert workload-aware Automatisierung mit einem Stability-First-Ansatz und stellt die Gesundheit Ihrer Anwendungen in den Mittelpunkt jeder Optimierungsempfehlung. Plattform-, SRE- und FinOps-Teams erhalten eine zentrale Sicht auf Cluster-Gesundheit, Performance und Kosten – so erkennen sie Resilienzprobleme und dimensionieren Workloads richtig, ohne ständiges manuelles Monitoring und permanente Rekonfiguration.
Die wichtigsten Funktionen von PerfectScale for Kubernetes:
- Erkennung von Resilienzproblemen: Podfit bietet eine granulare Sicht auf Cluster-Gesundheit und -Kosten, priorisiert die Bereiche mit Handlungsbedarf und hilft Teams, verschwendete Ressourcen und Resilienzprobleme schnell zu identifizieren.
- Right-Sizing mit Stabilität an erster Stelle: Kontextbewusstes Right-Sizing richtet Maßnahmen an Performance-Baselines, Traffic-Mustern und Geschäftskritikalität aus – Optimierung geht so nie zulasten der Anwendungsgesundheit.
- Autonome Workload-Optimierung: Datengetriebene Empfehlungen und Automatisierungs-Workflows dimensionieren Workloads kontinuierlich richtig und beenden den ständigen Rekonfigurationszyklus, der wertvolle Engineering-Zeit frisst.
- Insights zur Autoscaler-Konfiguration: Umsetzbare Empfehlungen verbessern HPA- und KEDA-Konfigurationen, während Infrafit die Effektivität von Node-Autoscalern wie Karpenter maximiert.
- Transparenz bei der Node-Auslastung: Infrafit identifiziert ungenutzte Node-Kapazität und empfiehlt die passenden Nodes für Ihre Workloads – für maximale Cluster-Performance und Zuverlässigkeit.
- Ressourcen-Tracking auf Container-Ebene: Überwachen Sie CPU und Arbeitsspeicher auf Container-Ebene, um Verschwendung zu eliminieren und Ressourcen anhand der tatsächlichen Nutzung festzulegen.
- Guardrails und Richtlinien: Definieren Sie Optimierungsregeln nach Workload-Kritikalität und Umgebungstyp, um Produktions-Workloads zu schützen.
- Multi-Cloud- und Multi-Cluster-Transparenz: Datengetriebene Intelligenz, Richtliniendurchsetzung und Optimierungsmaßnahmen über beliebig viele Cluster und Cloud-Anbieter hinweg – inklusive GPU-Auslastungs-Tracking.
Bereit für zuverlässige, kosteneffiziente Kubernetes Workloads? Erfahren Sie mehr über PerfectScale for Kubernetes.