


Qu'est-ce que l'Exit Code 143 de Kubernetes ?
L'Exit Code 143 de Kubernetes indique qu'un conteneur a été correctement arrêté à la suite d'une demande externe SIGTERM (signal 15). Dans la plupart des cas, il ne s'agit pas d'une erreur applicative, mais plutôt du signe que Kubernetes fonctionne exactement comme prévu pour arrêter un workload en douceur.
Pourquoi cela se produit-il ? Kubernetes envoie un signal SIGTERM au processus principal d'un pod (PID 1) pour lui demander de terminer ses tâches en cours, de fermer les connexions ouvertes et de se terminer proprement. Parmi les déclencheurs opérationnels courants :
- Déploiement ou rolling update : Kubernetes arrête les anciens pods avec SIGTERM à mesure que les pods de remplacement sont créés pendant un rollout.
- Suppression manuelle d'un pod : supprimer un pod déclenche l'arrêt en douceur et envoie normalement SIGTERM à ses conteneurs.
- Scaling de pods et réduction des réplicas : le scale-down d'un workload entraîne l'arrêt des réplicas devenus inutiles.
- Drain de nœud ou éviction de pods : une maintenance ou une éviction peut arrêter des pods afin de déplacer les workloads vers d'autres nœuds.
- Arrêt d'un nœud Kubernetes : un arrêt en douceur du nœud peut envoyer SIGTERM aux workloads avant l'extinction du nœud.
- Échecs des sondes liveness ou startup : des sondes en échec peuvent déclencher des redémarrages de conteneurs qui commencent par un arrêt en douceur.
- Arrêt déclenché par l'application ou un gestionnaire de processus : un gestionnaire de processus, un script, un sidecar ou un composant applicatif peut envoyer SIGTERM directement.
- Autoscaling du cluster ou remplacement de nœuds : la suppression de nœuds, les mises à niveau, les réparations et les changements d'infrastructure peuvent arrêter en douceur les workloads concernés.
Bonnes pratiques et solutions :
- Implémentez une gestion propre de SIGTERM : assurez-vous que l'application intercepte SIGTERM, cesse d'accepter de nouvelles tâches, effectue le nettoyage nécessaire et se termine proprement.
- Définissez un terminationGracePeriodSeconds adapté : laissez à l'application suffisamment de temps pour achever sa procédure d'arrêt avant que Kubernetes n'envoie SIGKILL.
- Utilisez un hook preStop lorsqu'une logique d'arrêt supplémentaire est nécessaire : exécutez le désenregistrement de services ou d'autres tâches d'arrêt requises avant la terminaison normale du conteneur.
- Faites en sorte que les workers d'arrière-plan s'arrêtent en toute sécurité : cessez d'accepter de nouveaux jobs et rendez les tâches inachevées réexécutables ou reprenables afin d'éviter toute perte ou incohérence de traitement.
- Surveillez le code de sortie 143 dans son contexte : corrélez les terminaisons avec les rollouts, le scaling, les opérations sur les nœuds, les échecs de sondes et les erreurs applicatives plutôt que de traiter chaque occurrence comme une défaillance.
Cet article fait partie d'une série consacrée au dépannage de Kubernetes
Dans cet article :
- Fonctionnement de la terminaison des pods Kubernetes
- Causes courantes de l'Exit Code 143 de Kubernetes
- Kubernetes Exit Code 143 vs Exit Code 137
- Comment diagnostiquer l'Exit Code 143 de Kubernetes
- Bonnes pratiques pour prévenir l'Exit Code 143 de Kubernetes
Fonctionnement de la terminaison des pods Kubernetes
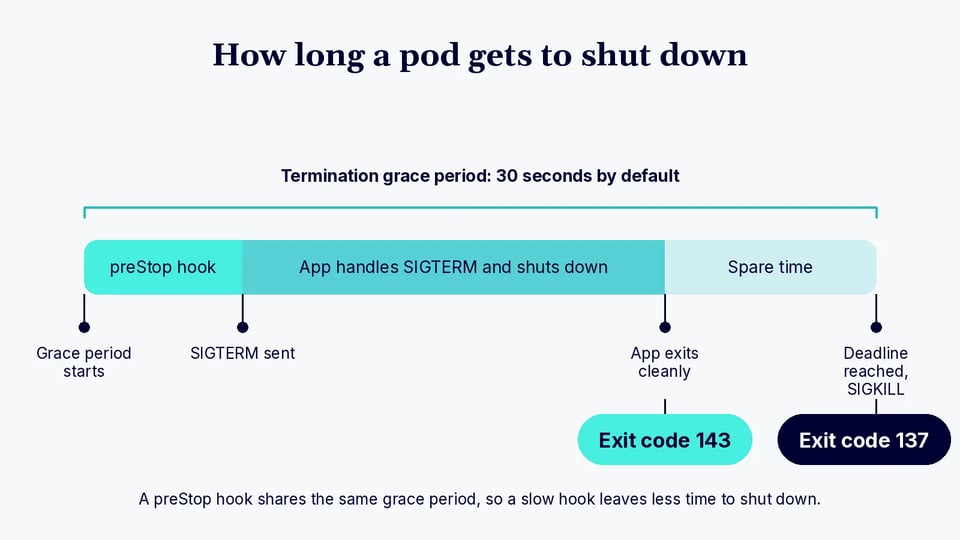
Étape 1 : Kubernetes envoie SIGTERM au conteneur
Lorsque la terminaison d'un pod commence, le kubelet demande au runtime de conteneurs d'arrêter les conteneurs. Le runtime envoie normalement SIGTERM au processus principal de chaque conteneur. SIGTERM est le signal 15 sous Linux et demande un arrêt ordonné plutôt que de tuer immédiatement le processus.
Les applications peuvent enregistrer un gestionnaire de signal pour réagir à SIGTERM. Par exemple, un serveur web peut cesser d'accepter de nouvelles requêtes tout en laissant les requêtes en cours se terminer. Si l'application ne gère pas explicitement le signal, son comportement par défaut détermine la manière dont elle se termine.
Kubernetes peut également utiliser un autre signal d'arrêt si celui-ci est configuré pour le conteneur ou l'image. SIGTERM reste toutefois le signal standard impliqué dans la plupart des arrêts Kubernetes, et c'est la raison pour laquelle le code de sortie 143 est si fréquemment observé.
Étape 2 : Le délai de grâce de terminaison commence
En parallèle, Kubernetes démarre le délai de grâce de terminaison du pod. Ce délai est contrôlé par terminationGracePeriodSeconds dans la spécification du pod et vaut 30 secondes par défaut. Il définit le temps disponible pour le processus de terminaison normal avant que Kubernetes ne force l'arrêt des conteneurs restants.
Si le conteneur dispose d'un hook de cycle de vie preStop, Kubernetes l'exécute pendant cette période de terminaison, avant de demander au runtime d'arrêter le conteneur. Le hook peut effectuer des tâches comme notifier un autre service, attendre que le trafic soit drainé ou déclencher un comportement d'arrêt propre à l'application.
Le hook preStop n'offre normalement pas de temps d'arrêt supplémentaire. Son exécution consomme le même délai de grâce : un hook trop long peut donc laisser à l'application moins de temps pour traiter SIGTERM et achever son propre nettoyage.
Étape 3 : L'application effectue un arrêt en douceur
Après avoir reçu SIGTERM, l'application doit entamer sa procédure d'arrêt. Un serveur peut cesser d'accepter de nouvelles connexions, terminer les requêtes en cours, fermer les connexions aux bases de données, vider les écritures en mémoire tampon et arrêter les workers d'arrière-plan.
La logique d'arrêt doit se terminer avant l'expiration du délai de grâce. Les applications avec des requêtes ou des jobs de longue durée peuvent donc nécessiter une valeur terminationGracePeriodSeconds plus élevée. Le délai configuré doit tenir compte à la fois des hooks de cycle de vie et du temps d'arrêt de l'application dans le pire des cas.
Si le processus se termine suite à SIGTERM, les outils de supervision et les informations de statut du conteneur peuvent signaler le code de sortie 143. Dans ce contexte, ce code indique souvent un arrêt normal initié par Kubernetes plutôt qu'un crash applicatif.
Étape 4 : Kubernetes envoie SIGKILL si le conteneur ne se termine pas
Si un conteneur est toujours en cours d'exécution à l'échéance du délai de terminaison, Kubernetes demande un arrêt forcé. Le runtime de conteneurs envoie alors SIGKILL, le signal 9, au processus restant. Contrairement à SIGTERM, SIGKILL ne peut être ni intercepté, ni ignoré, ni géré par l'application.
Cela évite qu'un pod reste indéfiniment bloqué à l'état terminating. La terminaison forcée peut toutefois interrompre des requêtes actives, laisser du travail inachevé ou empêcher l'écriture correcte des données en mémoire tampon et de l'état de l'application.
Un processus tué par SIGKILL produit généralement le code de sortie 137, car 128 + 9 = 137. Des codes 137 répétés lors de terminaisons de pods planifiées peuvent donc indiquer que l'arrêt en douceur de l'application dépasse le délai de grâce disponible.
Causes courantes de l'Exit Code 143 de Kubernetes
Le code de sortie 143 indique que le processus du conteneur a reçu SIGTERM et s'est terminé. Dans Kubernetes, cela arrive généralement parce que la plateforme ou un autre processus a demandé intentionnellement l'arrêt du conteneur. Les événements du pod et l'historique du workload permettent d'identifier l'opération à l'origine du signal.
Déploiement ou rolling update
Lors d'un rolling update d'un Deployment, Kubernetes crée les pods du nouveau ReplicaSet et termine ceux de l'ancien. Les anciens conteneurs reçoivent SIGTERM afin de pouvoir s'arrêter en douceur avant d'être supprimés. Observer le code de sortie 143 pendant un rollout planifié est donc généralement attendu. Cela devient préoccupant lorsque l'arrêt interrompt des requêtes ou dépasse régulièrement le délai de grâce configuré.
Suppression manuelle d'un pod
Exécuter kubectl delete pod lance le processus normal de terminaison du pod. Kubernetes marque le pod pour suppression et le kubelet finit par demander au runtime de conteneurs d'arrêter ses conteneurs, normalement via SIGTERM. Si le processus principal de l'application se termine à cause de ce signal, Kubernetes peut enregistrer le code de sortie 143. C'est normal lorsque le pod a été supprimé intentionnellement.
Scaling de pods et réduction des réplicas
Réduire le nombre de réplicas d'un Deployment, d'un StatefulSet ou d'un autre contrôleur conduit Kubernetes à terminer les pods devenus inutiles. Ces pods passent par le processus standard d'arrêt en douceur. Par exemple, faire passer un Deployment de dix réplicas à cinq implique l'arrêt de cinq pods. Leurs conteneurs peuvent signaler le code de sortie 143 après avoir reçu SIGTERM.
Drain de nœud ou éviction de pods
Drainer un nœud évince normalement les pods éligibles afin que les workloads puissent être déplacés ailleurs. Les pods évincés sont terminés sur l'ancien nœud, tandis que leurs contrôleurs peuvent créer des pods de remplacement sur d'autres nœuds disponibles. Les conteneurs en cours de terminaison reçoivent les signaux d'arrêt habituels et peuvent se terminer avec le code 143. La maintenance des nœuds et les opérations d'infrastructure expliquent souvent plusieurs terminaisons de ce type survenant au même moment.
Arrêt d'un nœud Kubernetes
Lorsque Kubernetes détecte un arrêt en douceur du système d'exploitation et que l'arrêt en douceur des nœuds est configuré, le kubelet peut terminer les pods avant l'extinction du nœud. Les workloads disposent ainsi de temps pour s'arrêter proprement au lieu de disparaître brutalement avec le nœud. Les conteneurs terminés pendant ce processus peuvent signaler le code de sortie 143. Vérifier les événements du nœud et l'activité d'arrêt de l'hôte permet de distinguer ce cas des défaillances applicatives.
Échecs des sondes liveness ou startup
Des échecs répétés de la sonde liveness conduisent Kubernetes à redémarrer le conteneur concerné. Les échecs de sonde startup peuvent produire le même résultat lorsque l'application ne devient pas saine dans le nombre de vérifications autorisé. Dans le cadre du redémarrage, le kubelet termine le conteneur en lui laissant normalement l'occasion de s'arrêter en douceur. Si le processus se termine après avoir reçu SIGTERM, l'état du conteneur précédent peut afficher le code de sortie 143.
SIGTERM envoyé par l'application ou un gestionnaire de processus
SIGTERM ne provient pas toujours de Kubernetes. Ces éléments peuvent également envoyer le signal 15 au processus principal du conteneur :
- Un script shell
- Un superviseur
- Un gestionnaire de processus
- Un sidecar
- Un composant applicatif
Dans cette situation, Kubernetes observe uniquement la terminaison de processus qui en résulte. Les logs de l'application et du gestionnaire de processus sont importants, car les événements Kubernetes peuvent ne pas identifier l'émetteur original du signal.
Autoscaling du cluster ou remplacement de nœuds
Un autoscaler de cluster peut retirer les nœuds sous-utilisés lorsque la capacité n'est plus nécessaire. Les plateformes Kubernetes managées peuvent aussi remplacer des nœuds lors de :
- Mises à niveau
- Maintenance
- Réparations
- Changements d'infrastructure
Les workloads des nœuds retirés intentionnellement sont généralement drainés ou terminés, puis replanifiés le cas échéant. Les conteneurs arrêtés proprement durant ce processus peuvent signaler le code de sortie 143 : la cause sous-jacente est alors l'événement d'infrastructure, et non une erreur applicative.
Kubernetes Exit Code 143 vs Exit Code 137
Les codes de sortie 143 et 137 indiquent tous deux qu'un conteneur a été terminé par un signal Linux, mais ils correspondent à des signaux différents. Le code de sortie 143 correspond à SIGTERM, tandis que le code 137 correspond à SIGKILL :
- Le code de sortie 143 se calcule comme 128 + 15, où 15 est le numéro du signal SIGTERM. Ce signal donne à l'application la possibilité d'effectuer un arrêt en douceur. On le rencontre couramment lors de la suppression de pods, des rolling updates, du scaling, des drains de nœuds et d'autres opérations Kubernetes normales.
- Le code de sortie 137 se calcule comme 128 + 9, où 9 est le numéro du signal SIGKILL. Un processus ne peut ni intercepter ni gérer SIGKILL, la terminaison est donc immédiate. Kubernetes peut l'utiliser lorsqu'un conteneur ne se termine pas avant l'expiration de son délai de grâce. Le code 137 peut aussi survenir lorsque le noyau Linux tue un processus pour cause de manque de mémoire (out-of-memory).
Cette distinction est utile lors du dépannage. Le code 143 pointe généralement vers une demande de terminaison intentionnelle, tandis que le code 137 indique une terminaison forcée. Pour le code 137, vérifiez si le conteneur affiche un motif OOMKilled et examinez l'utilisation et les limites de mémoire. S'il n'a pas été tué pour cause d'OOM, déterminez si l'application a dépassé son délai de grâce de terminaison.
Comment diagnostiquer l'Exit Code 143 de Kubernetes
Diagnostiquer le code de sortie 143 revient à déterminer qui a envoyé SIGTERM et pourquoi. Kubernetes utilisant fréquemment ce signal dans la gestion normale des workloads, le code de sortie à lui seul n'indique pas une défaillance.
Commencez par le statut du pod et du conteneur, puis corrélez l'heure de terminaison avec les logs, les événements, les rollouts, l'activité de scaling et les opérations sur les nœuds. Vérifiez également que l'application réagit correctement à la réception de SIGTERM.
Étape 1 : Inspecter le statut du pod
Commencez par vérifier l'état actuel du pod et son statut détaillé :
kubectl get pod <pod-name> -n <namespace>kubectl describe pod <pod-name> -n <namespace>Recherchez les redémarrages de conteneurs, les conditions du pod, les événements récents et les informations de terminaison. kubectl describe pod peut aussi révéler des échecs de sondes, une activité d'éviction, des changements de planification et d'autres événements liés à l'arrêt.
Si le pod est géré par un Deployment, un StatefulSet ou un autre contrôleur, identifiez également son propriétaire. Cela aide à déterminer si la terminaison faisait partie de l'activité normale du contrôleur.
Étape 2 : Vérifier le code de sortie du conteneur et le motif de terminaison
Inspectez l'état de terminaison actuel et précédent du conteneur. Pour un conteneur redémarré, Kubernetes peut conserver des détails comme le code de sortie, le motif, le signal et les horodatages :
kubectl get pod <pod-name> -n <namespace> \ -o jsonpath='{.status.containerStatuses[*].lastState.terminated}'Confirmez que le code de sortie enregistré est bien 143. Vérifiez aussi le motif de terminaison ainsi que les horodatages startedAt et finishedAt, que vous pouvez corréler avec les événements Kubernetes et les logs applicatifs.
Ne partez pas du principe que le code 143 explique à lui seul la cause. Il vous indique que le processus s'est terminé à cause de SIGTERM, mais pas quelle opération Kubernetes ou quel processus externe a initié la terminaison.
Étape 3 : Examiner les logs du conteneur actuel et du précédent
Consultez les logs applicatifs autour de l'heure de terminaison :
kubectl logs <pod-name> -n <namespace>Si le conteneur a redémarré, examinez les logs de l'instance précédente :
kubectl logs <pod-name> -n <namespace> --previousRecherchez les messages d'arrêt, les messages de réception de signal, les requêtes inachevées, les erreurs de connexion et les exceptions applicatives. Une séquence propre — réception de SIGTERM, arrêt des nouvelles tâches, fermeture des ressources, puis sortie — indique généralement un arrêt en douceur.
Pour les pods multi-conteneurs, précisez le conteneur concerné avec -c <container-name>.
Étape 4 : Inspecter les événements Kubernetes
Les événements Kubernetes peuvent fournir du contexte sur ce qui s'est passé juste avant la terminaison :
kubectl get events -n <namespace> \ --sort-by=.metadata.creationTimestampRecherchez les messages liés aux sondes en échec, à l'éviction de pods, aux redémarrages de conteneurs, au scaling, à la planification ou aux problèmes de nœuds. Comparez les horodatages des événements avec celui de la terminaison du conteneur.
Les événements sont utiles, mais ne constituent pas une piste d'audit complète. Ils peuvent expirer, et toutes les causes de terminaison de pod ne génèrent pas un événement expliquant clairement pourquoi SIGTERM a été envoyé.
Étape 5 : Vérifier l'activité de déploiement et de rollout
Déterminez si le conteneur s'est arrêté pendant une mise à jour de Deployment ou un autre changement de workload :
kubectl rollout status deployment/<deployment-name> -n <namespace>kubectl rollout history deployment/<deployment-name> -n <namespace>Inspectez également les ReplicaSets lors du dépannage d'un Deployment. L'apparition d'un nouveau ReplicaSet autour de l'heure de terminaison indique fortement que les anciens pods étaient remplacés pendant un rollout.
Si le code 143 n'apparaît que lors du déploiement de nouvelles versions de l'application, il s'agit généralement du remplacement normal des pods. La question suivante est de savoir si ces pods se sont arrêtés proprement, sans perdre de requêtes ni de travail.
Étape 6 : Rechercher des événements de scaling, d'éviction ou liés aux nœuds
Vérifiez si des changements de réplicas, l'autoscaling, des drains de nœuds ou des opérations d'infrastructure coïncident avec la terminaison. Pour les workloads utilisant un HorizontalPodAutoscaler, inspectez son état actuel et son comportement récent :
kubectl get hpa -n <namespace>kubectl describe hpa <hpa-name> -n <namespace>Inspectez aussi le nœud qui hébergeait le pod :
kubectl describe node <node-name>Recherchez les arrêts de nœuds, les opérations de maintenance, les conditions de pression, l'activité de l'autoscaler ou les événements liés à l'éviction. Si de nombreux pods sans lien entre eux se terminent à peu près au même moment, une opération au niveau du nœud ou du cluster est plus probable qu'un problème propre à l'application.
Étape 7 : Déterminer si l'application gère correctement SIGTERM
Enfin, vérifiez comment le processus principal de l'application réagit à SIGTERM. Il doit normalement cesser d'accepter de nouvelles tâches, terminer ou annuler en toute sécurité les opérations actives, écrire les données nécessaires, fermer les connexions externes et se terminer avant l'expiration du délai de grâce.
Vérifiez le délai de grâce configuré pour le pod :
kubectl get pod <pod-name> -n <namespace> \ -o jsonpath='{.spec.terminationGracePeriodSeconds}'Vérifiez aussi que les signaux atteignent réellement l'application. Les conteneurs qui lancent les applications via des scripts shell ou des gestionnaires de processus mal configurés peuvent perturber la transmission des signaux lorsque l'application n'est pas le PID 1.
Si l'arrêt en douceur dépasse systématiquement le délai disponible, améliorez la procédure d'arrêt ou augmentez terminationGracePeriodSeconds le cas échéant. Tester l'application directement avec SIGTERM permet de confirmer que son gestionnaire de signal s'exécute et se termine dans le temps imparti.
Bonnes pratiques pour prévenir l'Exit Code 143 de Kubernetes {#best-practices-to-prevent-kubernetes-exit-code-143}
Voici quelques moyens de prévenir le code de sortie 143 lorsque vous travaillez avec Kubernetes.
1. Implémenter une gestion propre de SIGTERM
Les applications doivent gérer explicitement SIGTERM et entamer un arrêt ordonné à la réception du signal. Un service doit cesser d'accepter de nouvelles tâches, terminer ou annuler en toute sécurité les requêtes actives, fermer les connexions, vider les données en mémoire tampon, puis se terminer.
Assurez-vous que l'application reçoit effectivement le signal. Les scripts shell d'encapsulation et les gestionnaires de processus peuvent empêcher les signaux d'atteindre l'application s'ils ne les transmettent pas correctement. Utiliser exec dans un script d'entrypoint permet de remplacer le shell par le processus de l'application :
exec /app/my-serviceL'application devient ainsi le PID 1 et reçoit directement les signaux de terminaison du conteneur.
2. Définir un terminationGracePeriodSeconds adapté
Définissez terminationGracePeriodSeconds avec une durée suffisante pour que l'application achève sa procédure d'arrêt normale. Kubernetes utilise 30 secondes par défaut, ce qui peut être insuffisant pour des requêtes longues, des jobs batch, des consommateurs de messages ou des applications avec un nettoyage conséquent.
Par exemple :
spec: terminationGracePeriodSeconds: 60Basez cette valeur sur les temps d'arrêt observés plutôt que de simplement définir un délai élevé. Les applications doivent malgré tout se terminer aussi vite que possible, car un délai de grâce inutilement long peut ralentir les rollouts, les opérations de scaling et la maintenance des nœuds.
3. Utiliser un hook preStop lorsqu'une logique d'arrêt supplémentaire est nécessaire
Un hook preStop peut exécuter une logique supplémentaire avant que le conteneur ne reçoive son signal d'arrêt habituel. Il est utile lorsque l'arrêt nécessite une commande explicite, le désenregistrement d'un service ou une autre opération en dehors du gestionnaire SIGTERM standard de l'application.
Par exemple :
lifecycle: preStop: exec: command: ["/bin/sh", "-c", "/app/prepare-shutdown.sh"]Gardez le hook court et fiable. Son temps d'exécution est décompté du délai de grâce du pod : un hook preStop lent réduit donc le temps dont dispose l'application pour s'arrêter après réception de SIGTERM.
4. Faire en sorte que les workers d'arrière-plan s'arrêtent en toute sécurité
Les workers d'arrière-plan ont autant besoin d'une gestion de la terminaison que les services HTTP. Lorsqu'un worker reçoit SIGTERM, il doit normalement cesser de prendre de nouveaux jobs et soit terminer le job en cours, soit remettre le travail inachevé dans la file en utilisant le mécanisme prévu par le système de files d'attente.
Évitez de quitter immédiatement alors qu'un job est partiellement traité. Selon le workload, cela peut entraîner du travail perdu, des traitements en double, des mises à jour de base de données incomplètes ou un état applicatif incohérent.
Pour les jobs de longue durée, assurez-vous que le délai de grâce est compatible avec les temps de traitement attendus. Lorsque les jobs ne peuvent pas se terminer de façon fiable dans ce délai, concevez-les pour être réexécutables ou reprenables.
5. Surveiller le code de sortie 143 dans son contexte
Ne déclenchez pas d'alerte à chaque occurrence du code de sortie 143. Il est attendu lors des déploiements progressifs, de la suppression manuelle de pods, des opérations de scale-down, des drains de nœuds et d'autres activités Kubernetes de routine.
À la place, corrélez le code 143 avec les taux de redémarrage des pods, l'activité de déploiement, les événements Kubernetes, les opérations sur les nœuds, les erreurs applicatives et les requêtes en échec. Des terminaisons SIGTERM répétées sans opération de cluster connue méritent une investigation plus poussée.
Surveiller le contexte environnant fait du code 143 un véritable signal de diagnostic. Il permet de distinguer une activité de cycle de vie saine des échecs de sondes, des workloads instables, des terminaisons de processus inattendues ou des changements d'infrastructure.
FAQ
L'exit code 143 de Kubernetes est-il une erreur ? Généralement non. Le code de sortie 143 signifie que le processus principal du conteneur a reçu SIGTERM et s'est arrêté. Kubernetes envoie ce signal lors d'activités normales comme les rolling updates, la suppression de pods, le scale-down et les drains de nœuds ; ce code seul n'indique donc pas une défaillance.
Quelle est la différence entre l'exit code 143 et l'exit code 137 ? Le code de sortie 143 correspond à 128 + 15 et signifie que le processus s'est arrêté après SIGTERM, ce qui laisse à l'application la possibilité de s'arrêter en douceur. Le code de sortie 137 correspond à 128 + 9 et signifie SIGKILL, qui ne peut pas être intercepté. Il peut survenir lorsqu'un conteneur dépasse son délai de grâce de terminaison ou est tué faute de mémoire.
Combien de temps Kubernetes attend-il avant d'envoyer SIGKILL ? Le délai de grâce de terminaison est de 30 secondes par défaut et se configure via terminationGracePeriodSeconds. Un hook preStop s'exécute dans cette même fenêtre : un hook lent laisse donc moins de temps à l'application pour gérer SIGTERM.
Comment identifier l'origine du SIGTERM ? Commencez par kubectl describe pod et le dernier état de terminaison du conteneur, puis comparez les horodatages avec les événements Kubernetes, l'historique des rollouts, l'activité du HPA et les événements des nœuds. Si rien ne correspond côté cluster, consultez les logs de l'application et du gestionnaire de processus, car un script, un superviseur ou un sidecar peut aussi envoyer SIGTERM.
Faut-il créer des alertes sur l'exit code 143 ? Non, pas à chaque occurrence. Alertez plutôt sur des schémas récurrents, comme des terminaisons SIGTERM répétées sans rollout, scaling ou opération de nœud connus, ou des terminaisons coïncidant avec des requêtes en échec ou une hausse des taux de redémarrage.
Des workloads Kubernetes stables à chaque terminaison avec PerfectScale
Le code de sortie 143 est généralement le signe d'une activité de cycle de vie saine, mais la fréquence des rollouts, des scale-downs et des changements de nœuds rend plus difficile de distinguer les terminaisons de routine des véritables problèmes de résilience. PerfectScale for Kubernetes by DoiT apporte une automatisation adaptée aux workloads avec une approche axée sur la stabilité, en plaçant la santé des applications au cœur de chaque recommandation d'optimisation. Les équipes plateforme, SRE et FinOps disposent d'une vue unique sur la santé, les performances et les coûts du cluster, pour repérer les problèmes de résilience et redimensionner les workloads sans surveillance ni reconfiguration manuelles permanentes.
Principales capacités de PerfectScale for Kubernetes :
- Détection des problèmes de résilience : Podfit offre une vue granulaire de la santé et des coûts du cluster, en priorisant les points nécessitant une attention et en aidant les équipes à identifier rapidement les ressources gaspillées et les problèmes de résilience.
- Right-sizing axé sur la stabilité : le right-sizing contextuel adapte les actions à partir des bases de référence de performance, des schémas de trafic et de la criticité métier, pour que l'optimisation ne se fasse jamais au détriment de la santé applicative.
- Optimisation autonome des workloads : des recommandations fondées sur les données et des workflows d'automatisation redimensionnent les workloads en continu, éliminant le cycle de reconfiguration permanent qui accapare le temps des équipes d'ingénierie.
- Analyse de la configuration des autoscalers : des recommandations concrètes aident à améliorer les configurations HPA et KEDA, tandis qu'Infrafit maximise l'efficacité des autoscalers de nœuds comme Karpenter.
- Visibilité sur l'utilisation des nœuds : Infrafit identifie la capacité inutilisée des nœuds et recommande les nœuds adaptés à vos workloads, pour des performances et une fiabilité optimales du cluster.
- Suivi des ressources au niveau conteneur : surveillez le CPU et la mémoire au niveau des conteneurs pour éliminer le gaspillage et définir les ressources en fonction de l'utilisation réelle.
- Garde-fous et politiques : définissez des règles d'optimisation selon la criticité des workloads et le type d'environnement afin de protéger vos workloads de production.
- Visibilité multi-cloud et multi-cluster : bénéficiez d'une intelligence fondée sur les données, de l'application de politiques et d'actions d'optimisation sur un nombre illimité de clusters et de fournisseurs cloud, y compris le suivi de l'utilisation des GPU.
Prêt à exécuter des workloads Kubernetes fiables et économes ? Découvrez PerfectScale for Kubernetes.