


Che cos'è l'exit code 143 di Kubernetes?
L'exit code 143 di Kubernetes indica che un container è stato terminato correttamente da una richiesta esterna SIGTERM (segnale 15). Nella maggior parte dei casi non si tratta di un errore applicativo, bensì del segno che il sistema Kubernetes sta funzionando esattamente come previsto per arrestare un workload in modo controllato.
Perché si verifica? Kubernetes invia un segnale SIGTERM al processo principale di un pod (PID 1) per chiedergli di completare le attività in corso, chiudere le connessioni aperte e terminare in modo pulito. I trigger operativi più comuni includono:
- Deployment o rolling update: durante un rollout, Kubernetes termina i vecchi pod con SIGTERM mentre vengono creati i pod sostitutivi.
- Eliminazione manuale di un pod: l'eliminazione di un pod avvia la terminazione controllata e di norma invia SIGTERM ai suoi container.
- Scaling dei pod e riduzione delle repliche: lo scale-down di un workload termina le repliche non più necessarie.
- Node drain o eviction dei pod: la manutenzione o l'eviction possono terminare i pod per spostare i workloads su altri nodi.
- Arresto di un nodo Kubernetes: l'arresto controllato del nodo può inviare SIGTERM ai workloads prima dello spegnimento del nodo.
- Fallimento delle probe di liveness o startup: le probe fallite possono attivare riavvii del container che iniziano con una terminazione controllata.
- Terminazione da parte dell'applicazione o di un process manager: un process manager, uno script, un sidecar o un componente applicativo possono inviare SIGTERM direttamente.
- Autoscaling del cluster o sostituzione dei nodi: rimozione di nodi, upgrade, riparazioni e modifiche all'infrastruttura possono terminare in modo controllato i workloads interessati.
Best practice e come risolvere:
- Implementare una gestione corretta di SIGTERM: assicurarsi che l'applicazione intercetti SIGTERM, smetta di accettare nuovo lavoro, completi le operazioni di pulizia necessarie e termini in modo pulito.
- Impostare un terminationGracePeriodSeconds adeguato: concedere all'applicazione tempo sufficiente per completare la procedura di arresto prima che Kubernetes invii SIGKILL.
- Usare un hook preStop quando serve logica di arresto aggiuntiva: eseguire la deregistrazione dei servizi o altre attività di arresto necessarie prima della normale terminazione del container.
- Fare in modo che i worker in background si arrestino in sicurezza: smettere di accettare nuovi job e rendere il lavoro incompiuto ritentabile o riprendibile per evitare elaborazioni perse o incoerenti.
- Monitorare l'exit code 143 nel suo contesto: correlare le terminazioni con rollout, scaling, operazioni sui nodi, probe fallite ed errori applicativi, invece di trattare ogni occorrenza come un guasto.
Questo articolo fa parte di una serie dedicata al troubleshooting di Kubernetes
In questo articolo:
- Come funziona la terminazione dei pod in Kubernetes
- Le cause più comuni dell'exit code 143 in Kubernetes
- Kubernetes: exit code 143 vs. exit code 137
- Come eseguire il troubleshooting dell'exit code 143
- Best practice per prevenire l'exit code 143 in Kubernetes
Come funziona la terminazione dei pod in Kubernetes
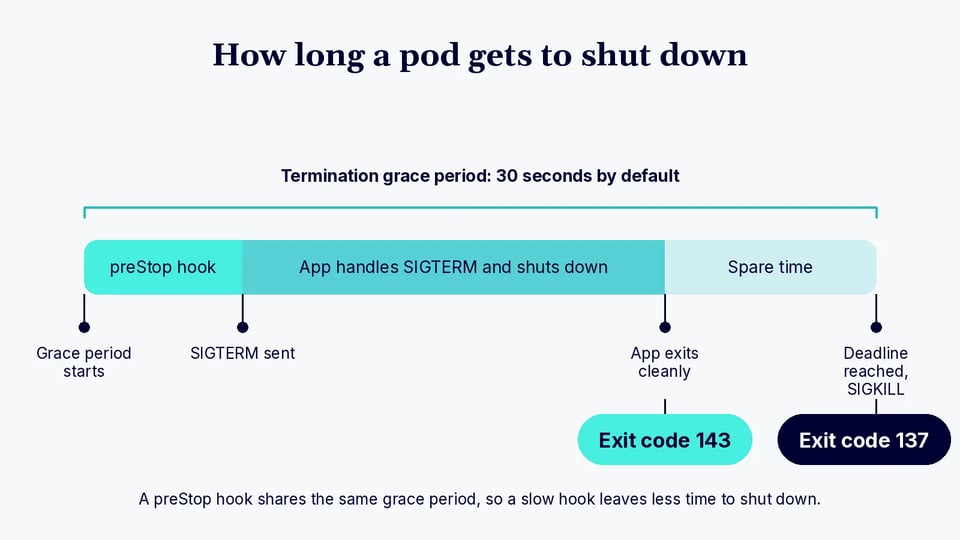
Passo 1: Kubernetes invia SIGTERM al container
Quando inizia la terminazione del pod, il kubelet chiede al container runtime di arrestare i container. Il runtime di norma invia SIGTERM al processo principale di ciascun container. SIGTERM è il segnale 15 su Linux e richiede un arresto ordinato, invece di uccidere immediatamente il processo.
Le applicazioni possono registrare un signal handler per reagire a SIGTERM. Ad esempio, un web server può smettere di accettare nuove richieste consentendo al contempo il completamento di quelle esistenti. Se l'applicazione non gestisce esplicitamente il segnale, è il suo comportamento predefinito per i segnali a determinare come termina.
Kubernetes può anche usare un segnale di arresto diverso quando ne è configurato uno per il container o per l'immagine. SIGTERM resta tuttavia il segnale standard coinvolto nella maggior parte degli arresti in Kubernetes ed è il motivo per cui l'exit code 143 è così frequente.
Passo 2: inizia il grace period di terminazione
Contestualmente, Kubernetes avvia il grace period di terminazione del pod. Questo periodo è controllato da terminationGracePeriodSeconds nella specifica del pod ed è di 30 secondi per impostazione predefinita. Definisce il tempo a disposizione del normale processo di terminazione prima che Kubernetes forzi l'arresto dei container rimanenti.
Se il container ha un lifecycle hook preStop, Kubernetes lo esegue durante questo periodo di terminazione, prima di chiedere al runtime di arrestare il container. L'hook può svolgere attività come notificare un altro servizio, attendere il drenaggio del traffico o attivare comportamenti di arresto specifici dell'applicazione.
Di norma l'hook preStop non fornisce tempo di arresto aggiuntivo. La sua esecuzione consuma lo stesso grace period, quindi un hook di lunga durata può lasciare all'applicazione meno tempo per elaborare SIGTERM e completare la propria pulizia.
Passo 3: l'applicazione esegue un arresto controllato
Dopo aver ricevuto SIGTERM, l'applicazione dovrebbe avviare la propria procedura di arresto. Un server potrebbe smettere di accettare nuove connessioni, completare le richieste già in corso, chiudere le connessioni al database, svuotare le scritture in buffer e arrestare i worker in background.
La logica di arresto dovrebbe completarsi prima della scadenza del grace period di terminazione. Le applicazioni con richieste o job di lunga durata potrebbero quindi aver bisogno di un valore di terminationGracePeriodSeconds più alto. Il periodo configurato dovrebbe tenere conto sia dei lifecycle hook sia del tempo di arresto dell'applicazione nel caso peggiore.
Se il processo termina a causa di SIGTERM, gli strumenti di monitoraggio e le informazioni sullo stato del container possono riportare l'exit code 143. In questo contesto, il codice indica spesso un normale arresto avviato da Kubernetes e non un crash dell'applicazione.
Passo 4: Kubernetes invia SIGKILL se il container non termina
Se un container è ancora in esecuzione quando viene raggiunta la scadenza di terminazione, Kubernetes richiede un arresto forzato. Il container runtime invia quindi SIGKILL, ovvero il segnale 9, al processo rimanente. A differenza di SIGTERM, SIGKILL non può essere intercettato, ignorato o gestito dall'applicazione.
Questo impedisce a un pod di rimanere bloccato indefinitamente nello stato di terminazione. Tuttavia, la terminazione forzata può interrompere richieste attive, lasciare lavoro incompleto o impedire la corretta scrittura dei dati in buffer e dello stato dell'applicazione.
Un processo terminato con SIGKILL produce in genere l'exit code 137, perché 128 + 9 = 137. Un exit code 137 ripetuto durante terminazioni pianificate dei pod può quindi indicare che l'arresto controllato dell'applicazione richiede più tempo del grace period disponibile.
Le cause più comuni dell'exit code 143 in Kubernetes
L'exit code 143 indica che il processo del container ha ricevuto SIGTERM ed è terminato. In Kubernetes, questo di solito avviene perché la piattaforma o un altro processo ha richiesto intenzionalmente l'arresto del container. Gli eventi del pod e la cronologia del workload possono aiutare a identificare quale operazione ha generato il segnale.
Deployment o rolling update
Durante un rolling update di un Deployment, Kubernetes crea i pod del nuovo ReplicaSet e termina quelli del vecchio ReplicaSet. I vecchi container ricevono SIGTERM per potersi arrestare in modo controllato prima della rimozione. Osservare l'exit code 143 durante un rollout pianificato è quindi, di norma, un comportamento atteso. Diventa un problema quando l'arresto interrompe richieste o supera ripetutamente il grace period di terminazione configurato.
Eliminazione manuale di un pod
L'esecuzione di kubectl delete pod avvia il normale processo di terminazione del pod. Kubernetes contrassegna il pod per l'eliminazione e il kubelet chiede quindi al container runtime di arrestare i container, di norma con SIGTERM. Se il processo principale dell'applicazione termina a causa di questo segnale, Kubernetes può registrare l'exit code 143. È normale quando il pod è stato eliminato intenzionalmente.
Scaling dei pod e riduzione delle repliche
La riduzione del numero di repliche di un Deployment, di uno StatefulSet o di un altro controller porta Kubernetes a terminare i pod non più necessari. Questi pod seguono il processo standard di terminazione controllata. Ad esempio, scalare un Deployment da dieci repliche a cinque richiede l'arresto di cinque pod. I loro container possono riportare l'exit code 143 dopo aver ricevuto SIGTERM.
Node drain o eviction dei pod
Il drain di un nodo di norma esegue l'eviction dei pod idonei, così i workloads possono spostarsi altrove. I pod sottoposti a eviction vengono terminati sul vecchio nodo, mentre i loro controller possono creare pod sostitutivi su altri nodi disponibili. I container in fase di terminazione ricevono i normali segnali di arresto e possono uscire con il codice 143. La manutenzione dei nodi e le operazioni infrastrutturali sono motivi comuni per cui si osservano più terminazioni di questo tipo nello stesso intervallo di tempo.
Arresto di un nodo Kubernetes
Quando Kubernetes rileva un arresto controllato del sistema operativo ed è configurato il graceful node shutdown, il kubelet può terminare i pod prima dello spegnimento del nodo. Questo dà ai workloads il tempo di arrestarsi in modo pulito, invece di scomparire di colpo insieme al nodo. I container terminati durante questo processo possono riportare l'exit code 143. Controllare gli eventi del nodo e l'attività di arresto dell'host consente di distinguere questo caso dai guasti a livello applicativo.
Fallimento delle probe di liveness o startup
Ripetuti fallimenti della liveness probe portano Kubernetes a riavviare il container interessato. I fallimenti della startup probe possono produrre lo stesso risultato quando l'applicazione non diventa healthy entro i controlli consentiti. Nell'ambito del riavvio, il kubelet termina il container, dandogli di norma la possibilità di arrestarsi in modo controllato. Se il processo termina dopo aver ricevuto SIGTERM, lo stato del container precedente può mostrare l'exit code 143.
SIGTERM inviato dall'applicazione o da un process manager
SIGTERM non proviene sempre da Kubernetes. Anche questi elementi possono inviare il segnale 15 al processo principale del container:
- Uno script shell
- Un supervisor
- Un process manager
- Un sidecar
- Un componente applicativo
In questa situazione Kubernetes osserva soltanto la conseguente terminazione del processo. I log dell'applicazione e del process manager sono importanti, perché gli eventi di Kubernetes potrebbero non identificare il mittente originale del segnale.
Autoscaling del cluster o sostituzione dei nodi
Un cluster autoscaler può rimuovere nodi sottoutilizzati quando la capacità non è più necessaria. Le piattaforme Kubernetes gestite possono inoltre sostituire i nodi durante:
- Upgrade
- Manutenzione
- Riparazioni
- Modifiche all'infrastruttura
I workloads sui nodi in rimozione intenzionale vengono in genere drenati o comunque terminati e rischedulati quando opportuno. I container arrestati in modo controllato durante questo processo possono riportare l'exit code 143: la causa sottostante è quindi l'evento infrastrutturale, non un errore applicativo.
Kubernetes: exit code 143 vs. exit code 137
Gli exit code 143 e 137 indicano entrambi che un container è stato terminato da un segnale Linux, ma rappresentano segnali diversi. L'exit code 143 corrisponde a SIGTERM, mentre l'exit code 137 corrisponde a SIGKILL:
- L'exit code 143 si calcola come 128 + 15, dove 15 è il numero del segnale SIGTERM. Questo segnale dà all'applicazione la possibilità di eseguire un arresto controllato. Compare comunemente durante eliminazioni di pod, rolling update, scaling, node drain e altre normali operazioni di Kubernetes.
- L'exit code 137 si calcola come 128 + 9, dove 9 è il numero del segnale SIGKILL. Un processo non può intercettare o gestire SIGKILL, quindi la terminazione è immediata. Kubernetes può usarlo quando un container non termina entro la scadenza del grace period di terminazione. L'exit code 137 può verificarsi anche quando il kernel Linux uccide un processo per una condizione di out-of-memory.
La distinzione è utile in fase di troubleshooting. L'exit code 143 indica di solito una richiesta di terminazione intenzionale, mentre l'exit code 137 indica una terminazione forzata. Per il codice 137, verificare se il container mostra il motivo OOMKilled ed esaminare utilizzo e limiti di memoria. Se non è stato terminato per OOM, stabilire se l'applicazione ha superato il grace period di terminazione.
Come eseguire il troubleshooting dell'exit code 143 di Kubernetes
Fare il troubleshooting dell'exit code 143 significa scoprire chi ha inviato SIGTERM e perché. Poiché Kubernetes usa frequentemente questo segnale durante la normale gestione dei workloads, l'exit code da solo non indica un guasto.
Iniziare dallo stato del pod e del container, poi correlare il momento della terminazione con log, eventi, rollout, attività di scaling e operazioni sui nodi. Verificare inoltre che l'applicazione risponda correttamente quando riceve SIGTERM.
Passo 1: ispezionare lo stato del pod
Iniziare controllando lo stato attuale e i dettagli del pod:
kubectl get pod <pod-name> -n <namespace>kubectl describe pod <pod-name> -n <namespace>Cercare riavvii del container, condizioni del pod, eventi recenti e informazioni sulla terminazione. kubectl describe pod può anche rivelare probe fallite, attività di eviction, modifiche di scheduling e altri eventi legati all'arresto.
Se il pod è gestito da un Deployment, da uno StatefulSet o da un altro controller, identificare anche il suo owner. Questo aiuta a capire se la terminazione rientrava nella normale attività del controller.
Passo 2: controllare l'exit code del container e il motivo della terminazione
Ispezionare lo stato di terminazione attuale e precedente del container. Per un container riavviato, Kubernetes può conservare dettagli come exit code, motivo, segnale e timestamp:
kubectl get pod <pod-name> -n <namespace> \ -o jsonpath='{.status.containerStatuses[*].lastState.terminated}'Confermare che l'exit code registrato sia 143. Controllare anche il motivo della terminazione e i timestamp startedAt e finishedAt, che possono essere correlati con gli eventi di Kubernetes e i log applicativi.
Non dare per scontato che l'exit code 143 spieghi di per sé la causa. Indica che il processo è terminato a causa di SIGTERM, ma non quale operazione di Kubernetes o processo esterno ha avviato la terminazione.
Passo 3: esaminare i log del container attuale e precedente
Controllare i log applicativi intorno al momento della terminazione:
kubectl logs <pod-name> -n <namespace>Se il container è stato riavviato, ispezionare i log dell'istanza precedente del container:
kubectl logs <pod-name> -n <namespace> --previousCercare messaggi di arresto, messaggi relativi ai segnali ricevuti, richieste non completate, errori di connessione ed eccezioni applicative. Una sequenza pulita — ricezione di SIGTERM, interruzione del nuovo lavoro, chiusura delle risorse e uscita — indica di solito una terminazione controllata.
Per i pod multi-container, specificare il container pertinente con -c <container-name>.
Passo 4: ispezionare gli eventi di Kubernetes
Gli eventi di Kubernetes possono fornire contesto su quanto accaduto immediatamente prima della terminazione:
kubectl get events -n <namespace> \ --sort-by=.metadata.creationTimestampCercare messaggi relativi a probe fallite, eviction di pod, riavvii di container, scaling, scheduling o problemi dei nodi. Confrontare i timestamp degli eventi con il timestamp di terminazione del container.
Gli eventi sono utili, ma non costituiscono un audit trail completo. Possono scadere e non tutte le cause di terminazione di un pod generano un evento che spieghi chiaramente perché è stato inviato SIGTERM.
Passo 5: controllare l'attività di Deployment e rollout
Stabilire se il container si è arrestato durante un aggiornamento del Deployment o un'altra modifica del workload:
kubectl rollout status deployment/<deployment-name> -n <namespace>kubectl rollout history deployment/<deployment-name> -n <namespace>Ispezionare anche i ReplicaSet durante il troubleshooting di un Deployment. La comparsa di un nuovo ReplicaSet intorno al momento della terminazione è un forte indizio che i vecchi pod venivano sostituiti durante un rollout.
Se l'exit code 143 si verifica solo quando vengono distribuite nuove versioni dell'applicazione, di solito fa parte della normale sostituzione dei pod. La domanda successiva è se quei pod si sono arrestati in modo pulito, senza perdere richieste o lavoro.
Passo 6: verificare eventi di scaling, eviction o dei nodi
Verificare se modifiche delle repliche, autoscaling, node drain o operazioni infrastrutturali coincidono con la terminazione. Per i workloads che usano un HorizontalPodAutoscaler, ispezionarne lo stato attuale e il comportamento recente:
kubectl get hpa -n <namespace>kubectl describe hpa <hpa-name> -n <namespace>Ispezionare anche il nodo che ospitava il pod:
kubectl describe node <node-name>Cercare arresti dei nodi, manutenzione, condizioni di pressure, attività dell'autoscaler o eventi legati all'eviction. Se molti pod non correlati terminano all'incirca nello stesso momento, è più probabile un'operazione a livello di nodo o di cluster che un problema specifico dell'applicazione.
Passo 7: determinare se l'applicazione gestisce correttamente SIGTERM
Infine, verificare come il processo principale dell'applicazione risponde a SIGTERM. Di norma dovrebbe smettere di accettare nuovo lavoro, completare o annullare in sicurezza le operazioni attive, scrivere i dati necessari, chiudere le connessioni esterne e terminare prima della scadenza del grace period di terminazione.
Controllare il grace period configurato per il pod:
kubectl get pod <pod-name> -n <namespace> \ -o jsonpath='{.spec.terminationGracePeriodSeconds}'Verificare inoltre che i segnali raggiungano effettivamente l'applicazione. I container che avviano le applicazioni tramite script shell o process manager configurati in modo errato possono interferire con l'inoltro dei segnali quando l'applicazione non è il PID 1.
Se l'arresto controllato richiede sistematicamente più tempo del periodo disponibile, migliorare il percorso di arresto o aumentare terminationGracePeriodSeconds dove opportuno. Testare l'applicazione direttamente con SIGTERM può confermare che il suo signal handler venga eseguito e termini entro i tempi previsti.
Best practice per prevenire l'exit code 143 in Kubernetes {#best-practices-to-prevent-kubernetes-exit-code-143}
Ecco alcuni dei modi per prevenire l'exit code 143 quando si lavora con Kubernetes.
1. Implementare una gestione corretta di SIGTERM
Le applicazioni dovrebbero gestire esplicitamente SIGTERM e avviare un arresto ordinato all'arrivo del segnale. Un servizio dovrebbe smettere di accettare nuovo lavoro, completare o annullare in sicurezza le richieste attive, chiudere le connessioni, svuotare i dati in buffer e quindi terminare.
Assicurarsi che l'applicazione riceva effettivamente il segnale. Script shell wrapper e process manager possono impedire ai segnali di raggiungere l'applicazione se non li inoltrano correttamente. L'uso di exec in uno script di entrypoint può sostituire la shell con il processo dell'applicazione:
exec /app/my-serviceIn questo modo l'applicazione diventa il PID 1 e i segnali di terminazione del container possono raggiungerla direttamente.
2. Impostare un terminationGracePeriodSeconds adeguato
Impostare terminationGracePeriodSeconds a un valore sufficiente perché l'applicazione completi la normale procedura di arresto. Kubernetes usa 30 secondi per impostazione predefinita, ma potrebbero non bastare per richieste di lunga durata, batch job, consumer di messaggi o applicazioni con operazioni di pulizia consistenti.
Ad esempio:
spec: terminationGracePeriodSeconds: 60Basare il valore sui tempi di arresto osservati, invece di impostare semplicemente un timeout elevato. Le applicazioni dovrebbero comunque terminare il più rapidamente possibile, perché un grace period inutilmente lungo può ritardare rollout, operazioni di scaling e manutenzione dei nodi.
3. Usare un hook preStop quando serve logica di arresto aggiuntiva
Un hook preStop può eseguire logica aggiuntiva prima che il container riceva il normale segnale di arresto. È utile quando l'arresto richiede un comando esplicito, la deregistrazione di un servizio o un'altra operazione esterna al normale handler SIGTERM dell'applicazione.
Ad esempio:
lifecycle: preStop: exec: command: ["/bin/sh", "-c", "/app/prepare-shutdown.sh"]Mantenere l'hook breve e affidabile. Il suo tempo di esecuzione viene conteggiato nel grace period di terminazione del pod, quindi un hook preStop lento riduce il tempo disponibile per l'arresto dell'applicazione dopo la ricezione di SIGTERM.
4. Fare in modo che i worker in background si arrestino in sicurezza
I worker in background hanno bisogno di una gestione della terminazione tanto quanto i servizi HTTP. Quando un worker riceve SIGTERM, dovrebbe di norma smettere di prendere nuovi job e completare quello corrente, oppure restituire il lavoro incompiuto alla coda usando il meccanismo supportato dal sistema di code.
Evitare di uscire immediatamente mentre un job è elaborato solo in parte. A seconda del workload, questo può causare lavoro perso, elaborazioni duplicate, aggiornamenti del database incompleti o uno stato applicativo incoerente.
Per i job di lunga durata, assicurarsi che il grace period di terminazione sia compatibile con i tempi di elaborazione previsti. Dove i job non possono completarsi in modo affidabile entro quel periodo, progettarli in modo che siano ritentabili o riprendibili.
5. Monitorare l'exit code 143 nel suo contesto
Non impostare alert su ogni occorrenza dell'exit code 143. È atteso durante i rolling deployment, l'eliminazione manuale di pod, le operazioni di scale-down, i node drain e altre attività di routine di Kubernetes.
Correlare invece l'exit code 143 con i tassi di riavvio dei pod, l'attività di deployment, gli eventi di Kubernetes, le operazioni sui nodi, gli errori applicativi e le richieste fallite. Terminazioni SIGTERM ripetute senza un'operazione nota del cluster meritano ulteriori indagini.
Monitorare il contesto circostante rende l'exit code 143 utile come segnale diagnostico. Aiuta a distinguere la normale attività del ciclo di vita da probe fallite, workloads instabili, terminazioni di processo impreviste o modifiche infrastrutturali.
FAQ
L'exit code 143 di Kubernetes è un errore? Di solito no. L'exit code 143 significa che il processo principale del container ha ricevuto SIGTERM e si è arrestato. Kubernetes invia questo segnale durante attività normali come rolling update, eliminazione di pod, scale-down e node drain, quindi il codice da solo non indica un guasto.
Qual è la differenza tra exit code 143 ed exit code 137? L'exit code 143 è 128 + 15 e significa che il processo si è arrestato dopo un SIGTERM, che dà all'applicazione la possibilità di arrestarsi in modo controllato. L'exit code 137 è 128 + 9 e significa SIGKILL, che non può essere intercettato. Può verificarsi quando un container supera il grace period di terminazione o viene terminato per esaurimento della memoria.
Quanto attende Kubernetes prima di inviare SIGKILL? Il grace period di terminazione è di 30 secondi per impostazione predefinita e si imposta con terminationGracePeriodSeconds. Un hook preStop viene eseguito all'interno della stessa finestra, quindi un hook lento lascia all'applicazione meno tempo per gestire SIGTERM.
Come scopro chi ha inviato il SIGTERM? Iniziare con kubectl describe pod e con l'ultimo stato di terminazione del container, poi confrontare i timestamp con gli eventi di Kubernetes, la cronologia dei rollout, l'attività dell'HPA e gli eventi dei nodi. Se nulla nel cluster coincide, controllare i log dell'applicazione e del process manager, perché anche uno script, un supervisor o un sidecar possono inviare SIGTERM.
Dovrei impostare alert sull'exit code 143? No, non su ogni occorrenza. Meglio impostare alert sui pattern, come terminazioni SIGTERM ripetute senza rollout, scaling o operazioni note sui nodi, oppure terminazioni che coincidono con richieste fallite o tassi di riavvio in aumento.
Workloads Kubernetes stabili a ogni terminazione con PerfectScale
L'exit code 143 è di solito il segno di una normale attività del ciclo di vita, ma rollout frequenti, scale-down e cambi di nodo rendono più difficile distinguere le terminazioni di routine dai veri problemi di resilienza. PerfectScale for Kubernetes di DoiT offre un'automazione workload-aware che mette la stabilità al primo posto, mantenendo la salute delle applicazioni al centro di ogni raccomandazione di ottimizzazione. Offre ai team platform, SRE e FinOps una visione unificata di salute, prestazioni e costi del cluster, per individuare i problemi di resilienza e dimensionare correttamente i workloads senza bisogno di monitoraggio manuale e riconfigurazioni continue.
Funzionalità chiave di PerfectScale for Kubernetes:
- Rilevamento dei problemi di resilienza: Podfit offre una visione granulare della salute e dei costi del cluster, dando priorità alle aree che richiedono attenzione e aiutando i team a individuare rapidamente risorse sprecate e problemi di resilienza.
- Right-sizing orientato alla stabilità: il right-sizing context-aware calibra le azioni su baseline di prestazioni, pattern di traffico e criticità di business, così l'ottimizzazione non va mai a scapito della salute delle applicazioni.
- Ottimizzazione autonoma dei workloads: raccomandazioni data-driven e workflow di automazione dimensionano i workloads in modo continuo, eliminando il ciclo costante di riconfigurazioni che sottrae tempo all'engineering.
- Insight sulla configurazione degli autoscaler: raccomandazioni concrete aiutano a migliorare le configurazioni di HPA e KEDA, mentre Infrafit contribuisce a massimizzare l'efficacia degli autoscaler di nodi come Karpenter.
- Visibilità sull'utilizzo dei nodi: Infrafit individua la capacità inutilizzata dei nodi e consiglia i nodi giusti per i workloads, a supporto di prestazioni e affidabilità ottimali del cluster.
- Monitoraggio delle risorse a livello di container: monitoraggio di CPU e memoria a livello di singolo container per eliminare gli sprechi e impostare le risorse in base all'utilizzo effettivo.
- Guardrail e policy: definizione di regole di ottimizzazione per criticità del workload e tipo di ambiente, per mantenere protetti i workloads di produzione.
- Visibilità multi-cloud e multi-cluster: intelligence data-driven, applicazione delle policy e azioni di ottimizzazione su qualsiasi numero di cluster e cloud provider, incluso il monitoraggio dell'utilizzo delle GPU.
È pronto a eseguire workloads Kubernetes affidabili ed efficienti sul piano dei costi? Scopra di più su PerfectScale for Kubernetes.