


O que é o Exit Code 143 do Kubernetes?
O Exit Code 143 do Kubernetes indica que um container foi encerrado com sucesso por uma solicitação externa SIGTERM (Sinal 15). Na maioria dos casos, isso não é um erro da aplicação, e sim um sinal de que o Kubernetes está funcionando exatamente como esperado para encerrar um workload de forma graciosa.
Por que isso acontece? O Kubernetes envia um sinal SIGTERM ao processo principal de um pod (PID 1) para pedir que ele conclua as tarefas em andamento, feche as conexões abertas e saia de forma limpa. Entre os gatilhos operacionais mais comuns estão:
- Deployment ou rolling update: o Kubernetes encerra os pods antigos com SIGTERM à medida que os pods substitutos são criados durante um rollout.
- Exclusão manual de pods: excluir um pod inicia o encerramento gracioso e normalmente envia SIGTERM aos seus containers.
- Escalonamento de pods e redução de réplicas: reduzir a escala de um workload encerra as réplicas que não são mais necessárias.
- Drain de node ou eviction de pods: manutenção ou eviction podem encerrar pods para que os workloads sejam movidos para outros nodes.
- Desligamento de node do Kubernetes: o desligamento gracioso de um node pode enviar SIGTERM aos workloads antes que o node seja desligado.
- Falhas em probes de liveness ou startup: probes com falha podem acionar reinicializações de containers que começam com um encerramento gracioso.
- Encerramento pela aplicação ou por um gerenciador de processos: um gerenciador de processos, script, sidecar ou componente da aplicação pode enviar SIGTERM diretamente.
- Autoscaling do cluster ou substituição de nodes: remoção de nodes, upgrades, reparos e mudanças de infraestrutura podem encerrar graciosamente os workloads afetados.
Boas práticas e como corrigir:
- Implemente o tratamento gracioso do SIGTERM: garanta que a aplicação capture o SIGTERM, pare de aceitar novos trabalhos, conclua as limpezas necessárias e saia de forma limpa.
- Defina um terminationGracePeriodSeconds adequado: dê à aplicação tempo suficiente para concluir o procedimento de desligamento antes que o Kubernetes envie o SIGKILL.
- Use um hook preStop quando for necessária lógica adicional de desligamento: execute o cancelamento do registro de serviços ou outras tarefas necessárias antes do encerramento normal do container.
- Faça os workers em segundo plano encerrarem com segurança: pare de aceitar novos jobs e torne o trabalho inacabado passível de repetição ou retomada para evitar processamento perdido ou inconsistente.
- Monitore o exit code 143 em contexto: correlacione os encerramentos com rollouts, escalonamento, operações de nodes, falhas de probes e erros da aplicação, em vez de tratar cada ocorrência como falha.
Este artigo faz parte de uma série sobre troubleshooting no Kubernetes
Neste artigo:
- Como funciona o encerramento de pods no Kubernetes
- Causas comuns do Exit Code 143 no Kubernetes
- Exit Code 143 vs. Exit Code 137 no Kubernetes
- Como diagnosticar o Exit Code 143 no Kubernetes
- Boas práticas para prevenir o Exit Code 143 no Kubernetes
Como funciona o encerramento de pods no Kubernetes
Etapa 1: o Kubernetes envia SIGTERM ao container
Quando o encerramento do pod começa, o kubelet solicita ao runtime de containers que pare os containers. O runtime normalmente envia SIGTERM ao processo principal de cada container. O SIGTERM é o sinal 15 no Linux e solicita um desligamento ordenado, em vez de matar o processo imediatamente.
As aplicações podem registrar um handler de sinal para reagir ao SIGTERM. Por exemplo, um servidor web pode parar de aceitar novas requisições enquanto permite que as requisições em andamento sejam concluídas. Se a aplicação não tratar o sinal explicitamente, seu comportamento padrão de sinais determina como ela será encerrada.
O Kubernetes também pode usar um sinal de parada diferente quando um estiver configurado para o container ou a imagem. No entanto, o SIGTERM é o sinal padrão envolvido na maioria dos desligamentos do Kubernetes e é o motivo pelo qual o exit code 143 é visto com frequência.
Etapa 2: o período de carência de encerramento começa
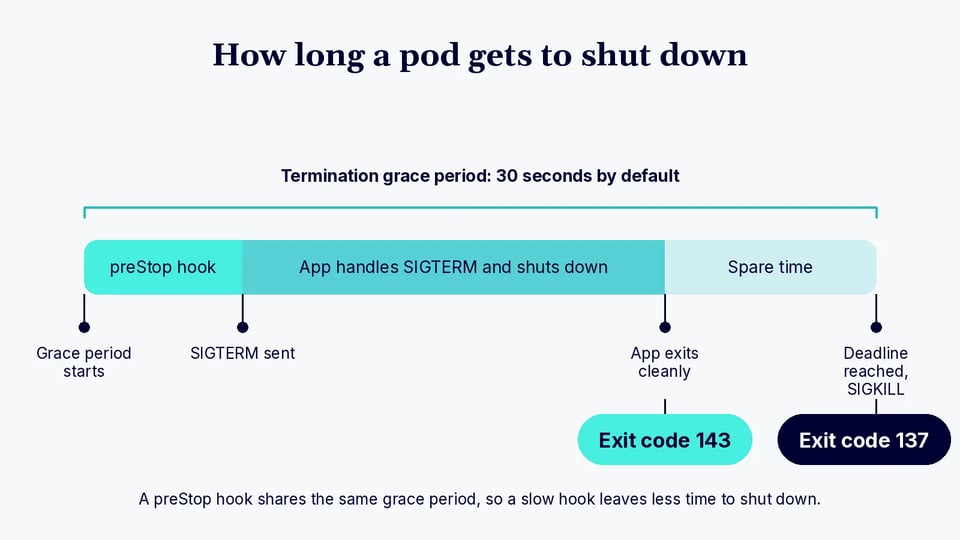
Ao mesmo tempo, o Kubernetes inicia o período de carência de encerramento do pod. Esse período é controlado por terminationGracePeriodSeconds na especificação do pod e tem 30 segundos como padrão. Ele define o tempo disponível para o processo normal de encerramento antes que o Kubernetes force os containers restantes a parar.
Se o container tiver um hook de ciclo de vida preStop, o Kubernetes o executa durante esse período de encerramento antes de solicitar ao runtime que pare o container. O hook pode executar tarefas como notificar outro serviço, aguardar a drenagem do tráfego ou acionar um comportamento de desligamento específico da aplicação.
O hook preStop normalmente não oferece tempo extra de desligamento. Sua execução consome o mesmo período de carência, então um hook demorado pode deixar a aplicação com menos tempo para processar o SIGTERM e concluir sua própria limpeza.
Etapa 3: a aplicação executa um desligamento gracioso
Depois de receber o SIGTERM, a aplicação deve iniciar seu procedimento de desligamento. Um servidor pode parar de aceitar novas conexões, concluir as requisições já em andamento, fechar conexões com bancos de dados, fazer o flush das gravações em buffer e parar os workers em segundo plano.
A lógica de desligamento deve ser concluída antes que o período de carência expire. Aplicações com requisições ou jobs de longa duração podem, portanto, precisar de um valor maior de terminationGracePeriodSeconds. O período configurado deve considerar tanto os hooks de ciclo de vida quanto o pior caso de tempo de desligamento da aplicação.
Se o processo for encerrado em decorrência do SIGTERM, ferramentas de monitoramento e informações de status do container podem reportar o exit code 143. Nesse contexto, o código geralmente indica um desligamento normal iniciado pelo Kubernetes, e não uma falha da aplicação.
Etapa 4: o Kubernetes envia SIGKILL se o container não sair
Se um container continuar em execução quando o prazo de encerramento for atingido, o Kubernetes solicita um desligamento forçado. O runtime de containers então envia SIGKILL, ou sinal 9, ao processo restante. Diferente do SIGTERM, o SIGKILL não pode ser capturado, ignorado nem tratado pela aplicação.
Isso evita que um pod fique preso indefinidamente no estado de encerramento. No entanto, o encerramento forçado pode interromper requisições ativas, deixar trabalho incompleto ou impedir que dados em buffer e o estado da aplicação sejam gravados corretamente.
Um processo finalizado com SIGKILL costuma produzir o exit code 137, porque 128 + 9 = 137. Exit code 137 recorrente durante encerramentos planejados de pods pode, portanto, indicar que o desligamento gracioso da aplicação leva mais tempo do que o período de carência disponível.
Causas comuns do Exit Code 143 no Kubernetes
O exit code 143 indica que o processo do container recebeu SIGTERM e foi encerrado. No Kubernetes, isso geralmente acontece porque a plataforma ou outro processo solicitou intencionalmente que o container parasse. Os eventos do pod e o histórico do workload podem ajudar a identificar qual operação acionou o sinal.
Deployment ou rolling update
Durante um rolling update de Deployment, o Kubernetes cria pods para o novo ReplicaSet e encerra os pods do ReplicaSet antigo. Os containers antigos recebem SIGTERM para que possam encerrar de forma graciosa antes de serem removidos. Ver o exit code 143 durante um rollout planejado, portanto, geralmente é esperado. Ele se torna motivo de preocupação quando o desligamento interrompe requisições ou excede repetidamente o período de carência configurado.
Exclusão manual de pods
Executar kubectl delete pod inicia o processo normal de encerramento do pod. O Kubernetes marca o pod para exclusão e o kubelet eventualmente solicita ao runtime de containers que pare seus containers, normalmente usando SIGTERM. Se o processo principal da aplicação sair por causa desse sinal, o Kubernetes pode registrar o exit code 143. Isso é normal quando o pod foi excluído intencionalmente.
Escalonamento de pods e redução de réplicas
Reduzir a contagem de réplicas de um Deployment, StatefulSet ou outro controlador faz com que o Kubernetes encerre os pods que não são mais necessários. Esses pods passam pelo processo padrão de encerramento gracioso. Por exemplo, reduzir um Deployment de dez réplicas para cinco exige que cinco pods parem. Seus containers podem reportar o exit code 143 após receberem SIGTERM.
Drain de node ou eviction de pods
Fazer o drain de um node normalmente remove (evict) os pods elegíveis para que os workloads possam ser movidos para outro lugar. Os pods removidos são encerrados no node antigo, enquanto seus controladores podem criar pods substitutos em outros nodes disponíveis. Os containers em encerramento recebem os sinais normais de desligamento e podem sair com o código 143. Manutenção de nodes e operações de infraestrutura são razões comuns para ver vários encerramentos desse tipo mais ou menos ao mesmo tempo.
Desligamento de node do Kubernetes
Quando o Kubernetes detecta um desligamento gracioso do sistema operacional e o desligamento gracioso de node está configurado, o kubelet pode encerrar os pods antes que o node seja desligado. Isso dá aos workloads tempo para parar de forma limpa, em vez de desaparecerem imediatamente junto com o node. Containers encerrados durante esse processo podem reportar o exit code 143. Verificar os eventos do node e a atividade de desligamento do host pode distinguir esse caso de falhas no nível da aplicação.
Falhas em probes de liveness ou startup
Falhas repetidas na probe de liveness fazem com que o Kubernetes reinicie o container afetado. Falhas na probe de startup podem produzir o mesmo resultado quando a aplicação não fica saudável dentro das verificações permitidas. Como parte da reinicialização, o kubelet encerra o container, normalmente dando a ele a oportunidade de desligar de forma graciosa. Se o processo for encerrado após receber SIGTERM, o estado anterior do container pode exibir o exit code 143.
Aplicação ou gerenciador de processos enviando SIGTERM
O SIGTERM nem sempre tem origem no Kubernetes. Estes elementos também podem enviar o sinal 15 ao processo principal do container:
- Um shell script
- Um supervisor
- Um gerenciador de processos
- Um sidecar
- Um componente da aplicação
Nessa situação, o Kubernetes apenas observa o encerramento resultante do processo. Os logs da aplicação e do gerenciador de processos são importantes porque os eventos do Kubernetes podem não identificar o remetente original do sinal.
Autoscaling do cluster ou substituição de nodes
Um cluster autoscaler pode remover nodes subutilizados quando a capacidade deixa de ser necessária. Plataformas gerenciadas de Kubernetes também podem substituir nodes durante:
- Upgrades
- Manutenção
- Reparos
- Mudanças de infraestrutura
Os workloads em nodes que estão sendo removidos intencionalmente normalmente passam por drain ou são encerrados de outra forma e reagendados quando apropriado. Containers parados de forma graciosa durante esse processo podem reportar o exit code 143 — nesse caso, a causa subjacente é o evento de infraestrutura, e não um erro da aplicação.
Exit Code 143 vs. Exit Code 137 no Kubernetes
Tanto o exit code 143 quanto o 137 indicam que um container foi encerrado por um sinal do Linux, mas eles representam sinais diferentes. O exit code 143 corresponde ao SIGTERM, enquanto o exit code 137 corresponde ao SIGKILL:
- Exit code 143 é calculado como 128 + 15, em que 15 é o número do sinal SIGTERM. Esse sinal dá à aplicação a chance de realizar um desligamento gracioso. Ele costuma aparecer durante exclusão de pods, rolling updates, escalonamento, drains de nodes e outras operações normais do Kubernetes.
- Exit code 137 é calculado como 128 + 9, em que 9 é o número do sinal SIGKILL. Um processo não consegue capturar nem tratar o SIGKILL, então o encerramento é imediato. O Kubernetes pode usá-lo quando um container não sai antes que seu período de carência de encerramento expire. O exit code 137 também pode ocorrer quando o kernel do Linux mata um processo por uma condição de falta de memória (out-of-memory).
A distinção é útil no diagnóstico. O exit code 143 geralmente aponta para uma solicitação intencional de encerramento, enquanto o exit code 137 indica encerramento forçado. Para o código 137, verifique se o container exibe o motivo OOMKilled e revise o uso e os limites de memória. Se não foi finalizado por OOM, determine se a aplicação excedeu seu período de carência de encerramento.
Como diagnosticar o Exit Code 143 no Kubernetes
Diagnosticar o exit code 143 significa descobrir quem enviou o SIGTERM e por quê. Como o Kubernetes usa esse sinal com frequência durante o gerenciamento normal de workloads, o exit code sozinho não indica uma falha.
Comece pelo status do pod e do container e, em seguida, correlacione o horário do encerramento com logs, eventos, rollouts, atividade de escalonamento e operações de nodes. Verifique também se a aplicação responde corretamente ao receber o SIGTERM.
Etapa 1: inspecione o status do pod
Comece verificando o estado atual e o status detalhado do pod:
kubectl get pod <pod-name> -n <namespace>kubectl describe pod <pod-name> -n <namespace>Procure por reinicializações de containers, condições do pod, eventos recentes e informações de encerramento. kubectl describe pod também pode revelar falhas de probes, atividade de eviction, mudanças de agendamento e outros eventos relacionados ao desligamento.
Se o pod for gerenciado por um Deployment, StatefulSet ou outro controlador, identifique também o seu owner. Isso ajuda a determinar se o encerramento fez parte da atividade normal do controlador.
Etapa 2: verifique o exit code do container e o motivo do encerramento
Inspecione o estado de encerramento atual e anterior do container. Para um container reiniciado, o Kubernetes pode reter detalhes como exit code, motivo, sinal e timestamps:
kubectl get pod <pod-name> -n <namespace> \ -o jsonpath='{.status.containerStatuses[*].lastState.terminated}'Confirme que o exit code registrado é 143. Verifique também o motivo do encerramento e os timestamps startedAt e finishedAt, que podem ser correlacionados com eventos do Kubernetes e logs da aplicação.
Não presuma que o exit code 143 por si só explica a causa. Ele informa que o processo foi encerrado por causa do SIGTERM, mas não qual operação do Kubernetes ou processo externo iniciou o encerramento.
Etapa 3: revise os logs atuais e anteriores do container
Verifique os logs da aplicação em torno do horário do encerramento:
kubectl logs <pod-name> -n <namespace>Se o container tiver reiniciado, inspecione os logs da instância anterior do container:
kubectl logs <pod-name> -n <namespace> --previousProcure por mensagens de desligamento, mensagens de sinal recebido, requisições inacabadas, erros de conexão e exceções da aplicação. Uma sequência limpa — como receber o SIGTERM, parar novos trabalhos, fechar recursos e sair — geralmente indica um encerramento gracioso.
Para pods com vários containers, especifique o container relevante com -c <container-name>.
Etapa 4: inspecione os eventos do Kubernetes
Os eventos do Kubernetes podem fornecer contexto sobre o que aconteceu imediatamente antes do encerramento:
kubectl get events -n <namespace> \ --sort-by=.metadata.creationTimestampProcure por mensagens relacionadas a falhas de probes, eviction de pods, reinicializações de containers, escalonamento, agendamento ou problemas de nodes. Compare os timestamps dos eventos com o timestamp de encerramento do container.
Os eventos são úteis, mas não constituem uma trilha de auditoria completa. Eles podem expirar, e nem toda causa de encerramento de pod gera um evento que explique claramente por que o SIGTERM foi enviado.
Etapa 5: verifique a atividade de Deployment e rollout
Determine se o container parou durante uma atualização de Deployment ou outra mudança no workload:
kubectl rollout status deployment/<deployment-name> -n <namespace>kubectl rollout history deployment/<deployment-name> -n <namespace>Inspecione também os ReplicaSets ao diagnosticar um Deployment. Um novo ReplicaSet surgindo perto do horário do encerramento é um forte indício de que os pods antigos estavam sendo substituídos durante um rollout.
Se o exit code 143 ocorrer apenas quando novas versões da aplicação são implantadas, geralmente faz parte da substituição normal de pods. A próxima pergunta é se esses pods foram desligados de forma limpa, sem derrubar requisições ou perder trabalho.
Etapa 6: verifique eventos de escalonamento, eviction ou nodes
Verifique se mudanças de réplicas, autoscaling, drains de nodes ou operações de infraestrutura coincidem com o encerramento. Para workloads que usam um HorizontalPodAutoscaler, inspecione seu estado atual e o comportamento recente:
kubectl get hpa -n <namespace>kubectl describe hpa <hpa-name> -n <namespace>Inspecione também o node que hospedava o pod:
kubectl describe node <node-name>Procure por desligamentos de nodes, manutenção, condições de pressão, atividade do autoscaler ou eventos relacionados a eviction. Se muitos pods não relacionados forem encerrados aproximadamente ao mesmo tempo, uma operação no nível do node ou do cluster é mais provável do que um problema específico da aplicação.
Etapa 7: determine se a aplicação trata o SIGTERM corretamente
Por fim, verifique como o processo principal da aplicação responde ao SIGTERM. Ele normalmente deve parar de aceitar novos trabalhos, concluir ou cancelar com segurança as operações ativas, fazer o flush dos dados necessários, fechar as conexões externas e sair antes que o período de carência expire.
Verifique o período de carência configurado do pod:
kubectl get pod <pod-name> -n <namespace> \ -o jsonpath='{.spec.terminationGracePeriodSeconds}'Verifique também se os sinais realmente chegam à aplicação. Containers que iniciam aplicações por meio de shell scripts ou de gerenciadores de processos configurados incorretamente podem interferir no encaminhamento de sinais quando a aplicação não é o PID 1.
Se o desligamento gracioso consistentemente levar mais tempo do que o período disponível, melhore o caminho de desligamento ou aumente o terminationGracePeriodSeconds quando apropriado. Testar a aplicação diretamente com SIGTERM pode confirmar que seu handler de sinal é executado e sai dentro do tempo esperado.
Boas práticas para prevenir o Exit Code 143 no Kubernetes {#best-practices-to-prevent-kubernetes-exit-code-143}
Confira algumas maneiras de prevenir o exit code 143 ao trabalhar com Kubernetes.
1. Implemente o tratamento gracioso do SIGTERM
As aplicações devem tratar o SIGTERM explicitamente e iniciar um desligamento ordenado quando o sinal chegar. Um serviço deve parar de aceitar novos trabalhos, concluir ou cancelar com segurança as requisições ativas, fechar conexões, fazer o flush dos dados em buffer e, então, sair.
Garanta que a aplicação realmente receba o sinal. Shell scripts intermediários e gerenciadores de processos podem impedir que os sinais cheguem à aplicação se não os encaminharem corretamente. Usar exec em um script de entrypoint pode substituir o shell pelo processo da aplicação:
exec /app/my-serviceIsso torna a aplicação o PID 1 e permite que os sinais de encerramento do container cheguem diretamente a ela.
2. Defina um terminationGracePeriodSeconds adequado
Defina o terminationGracePeriodSeconds longo o suficiente para que a aplicação conclua seu procedimento normal de desligamento. O Kubernetes usa 30 segundos por padrão, mas isso pode ser insuficiente para requisições de longa duração, jobs em lote, consumidores de mensagens ou aplicações com trabalho de limpeza considerável.
Por exemplo:
spec: terminationGracePeriodSeconds: 60Baseie o valor nos tempos de desligamento observados, em vez de simplesmente definir um timeout grande. As aplicações ainda devem encerrar o mais rápido possível, pois um período de carência desnecessariamente longo pode atrasar rollouts, operações de escalonamento e manutenções de nodes.
3. Use um hook preStop quando for necessária lógica adicional de desligamento
Um hook preStop pode executar lógica adicional antes que o container receba seu sinal normal de parada. Ele é útil quando o desligamento exige um comando explícito, o cancelamento do registro de um serviço ou outra operação fora do handler padrão de SIGTERM da aplicação.
Por exemplo:
lifecycle: preStop: exec: command: ["/bin/sh", "-c", "/app/prepare-shutdown.sh"]Mantenha o hook curto e confiável. Seu tempo de execução é descontado do período de carência do pod, então um hook preStop lento reduz o tempo disponível para a aplicação desligar após receber o SIGTERM.
4. Faça os workers em segundo plano encerrarem com segurança
Workers em segundo plano precisam de tratamento de encerramento tanto quanto os serviços HTTP. Quando um worker recebe o SIGTERM, ele normalmente deve parar de aceitar novos jobs e concluir o job atual ou devolver o trabalho inacabado à fila usando o mecanismo suportado pelo sistema de filas.
Evite sair imediatamente enquanto um job está parcialmente processado. Dependendo do workload, isso pode resultar em trabalho perdido, processamento duplicado, atualizações incompletas no banco de dados ou estado inconsistente da aplicação.
Para jobs de longa duração, garanta que o período de carência seja compatível com os tempos de processamento esperados. Quando os jobs não puderem terminar de forma confiável dentro desse período, projete-os para serem repetíveis ou retomáveis.
5. Monitore o exit code 143 em contexto
Não crie alertas para cada ocorrência do exit code 143. Ele é esperado durante deploys com rolling update, exclusão manual de pods, operações de scale-down, drains de nodes e outras atividades rotineiras do Kubernetes.
Em vez disso, correlacione o exit code 143 com taxas de reinicialização de pods, atividade de deployment, eventos do Kubernetes, operações de nodes, erros da aplicação e requisições com falha. Encerramentos repetidos por SIGTERM sem uma operação conhecida no cluster merecem investigação adicional.
Monitorar o contexto ao redor torna o exit code 143 útil como sinal de diagnóstico. Ele ajuda a distinguir a atividade saudável do ciclo de vida de falhas de probes, workloads instáveis, encerramentos inesperados de processos ou mudanças de infraestrutura.
FAQ
O exit code 143 do Kubernetes é um erro? Geralmente não. O exit code 143 significa que o processo principal do container recebeu SIGTERM e parou. O Kubernetes envia esse sinal durante atividades normais, como rolling updates, exclusão de pods, scale-down e drains de nodes, então o código por si só não indica uma falha.
Qual é a diferença entre o exit code 143 e o exit code 137? O exit code 143 é 128 + 15 e significa que o processo parou após o SIGTERM, que dá à aplicação a chance de desligar de forma graciosa. O exit code 137 é 128 + 9 e significa SIGKILL, que não pode ser capturado. Ele pode ocorrer quando um container estoura seu período de carência de encerramento ou é finalizado por falta de memória.
Quanto tempo o Kubernetes espera antes de enviar o SIGKILL? O período de carência de encerramento é de 30 segundos por padrão e é definido com terminationGracePeriodSeconds. Um hook preStop é executado dentro dessa mesma janela, então um hook lento deixa a aplicação com menos tempo para tratar o SIGTERM.
Como descubro o que enviou o SIGTERM? Comece com kubectl describe pod e o último estado de encerramento do container, depois compare os timestamps com eventos do Kubernetes, histórico de rollouts, atividade do HPA e eventos de nodes. Se nada no cluster coincidir, verifique os logs da aplicação e do gerenciador de processos, já que um script, supervisor ou sidecar também pode enviar SIGTERM.
Devo criar alertas para o exit code 143? Não, não para cada ocorrência. Em vez disso, alerte sobre padrões, como encerramentos repetidos por SIGTERM sem rollout, escalonamento ou operação de node conhecidos, ou encerramentos que coincidam com requisições com falha ou taxas crescentes de reinicialização.
Mantenha seus workloads Kubernetes estáveis em cada encerramento com o PerfectScale
O exit code 143 geralmente é sinal de atividade saudável do ciclo de vida, mas rollouts frequentes, scale-downs e mudanças de nodes dificultam distinguir encerramentos rotineiros de problemas reais de resiliência. O PerfectScale for Kubernetes da DoiT oferece automação sensível aos workloads com uma abordagem que prioriza a estabilidade, mantendo a saúde da aplicação no centro de cada recomendação de otimização. Ele dá às equipes de plataforma, SRE e FinOps uma visão única da saúde, do desempenho e dos custos do cluster, para que possam identificar problemas de resiliência e dimensionar corretamente os workloads sem monitoramento e reconfiguração manuais constantes.
Principais recursos do PerfectScale for Kubernetes:
- Detecção de problemas de resiliência: o Podfit oferece uma visão granular da saúde e dos custos do cluster, priorizando as áreas que precisam de atenção e ajudando as equipes a identificar rapidamente recursos desperdiçados e problemas de resiliência.
- Right-sizing com prioridade na estabilidade: o right-sizing sensível ao contexto adapta as ações com base em baselines de desempenho, padrões de tráfego e criticidade para o negócio, para que a otimização nunca comprometa a saúde da aplicação.
- Otimização autônoma de workloads: recomendações orientadas por dados e fluxos de automação fazem o right-sizing contínuo dos workloads, eliminando o ciclo constante de reconfiguração que consome o tempo da engenharia.
- Insights de configuração de autoscalers: recomendações acionáveis ajudam a melhorar as configurações de HPA e KEDA, enquanto o Infrafit ajuda a maximizar a eficácia de autoscalers de nodes como o Karpenter.
- Visibilidade da utilização dos nodes: o Infrafit identifica capacidade ociosa de nodes e recomenda os nodes certos para seus workloads, garantindo desempenho e confiabilidade máximos do cluster.
- Acompanhamento de recursos no nível do container: monitore CPU e memória no nível do container para eliminar desperdícios e definir recursos com base no uso real.
- Guardrails e políticas: defina regras de otimização por criticidade do workload e tipo de ambiente para manter os workloads de produção protegidos.
- Visibilidade multi-cloud e multi-cluster: obtenha inteligência orientada por dados, aplicação de políticas e ações de otimização em qualquer número de clusters e provedores de nuvem, incluindo o acompanhamento da utilização de GPUs.
Pronto para executar workloads Kubernetes confiáveis e com custos otimizados? Saiba mais sobre o PerfectScale for Kubernetes.