


Un DaemonSet de Kubernetes es un objeto de workload que garantiza que una copia de un pod se ejecute en cada nodo de tu clúster, o en un conjunto específico de nodos que tú elijas. Cuando un nodo se une al clúster, el DaemonSet agrega su pod a ese nodo automáticamente. Cuando un nodo sale, el pod se va con él. Así es como se ejecutan agentes a nivel de nodo, como recolectores de logs, agentes de monitoreo y plugins de red, sin tener que colocar un pod en cada nodo manualmente.
En esta guía aprenderás cómo funcionan los DaemonSets, para qué se usan, en qué se diferencian de otros tipos de workloads, cómo escribir y controlar un DaemonSet, cómo actualizarlo y escalarlo, cómo afectan el costo del clúster, y las buenas prácticas y fallas que conviene conocer.
¿Qué es un DaemonSet de Kubernetes?
Un DaemonSet está diseñado para workloads a nivel de nodo, no para un número fijo de réplicas. Mantiene un pod en cada nodo que coincide con sus reglas de scheduling, y Kubernetes ajusta automáticamente la cantidad de pods a medida que esos nodos cambian.
Ese objetivo es distinto al de un Deployment. Un Deployment ejecuta la cantidad de réplicas que tú eliges y deja que el scheduler las distribuya por el clúster. Un DaemonSet no tiene un número de réplicas. La cantidad de pods equivale a la de nodos coincidentes que tengas, y cambia por sí sola a medida que los nodos entran y salen. Los DaemonSets son objetos con namespace y usan apiVersion: apps/v1, y normalmente un DaemonSet ejecuta un tipo de agente en todos tus nodos.
¿Cómo funcionan los DaemonSets?
Hay dos piezas clave que explican cómo funciona un DaemonSet: el controlador de DaemonSet y el scheduler de Kubernetes. Veamos:
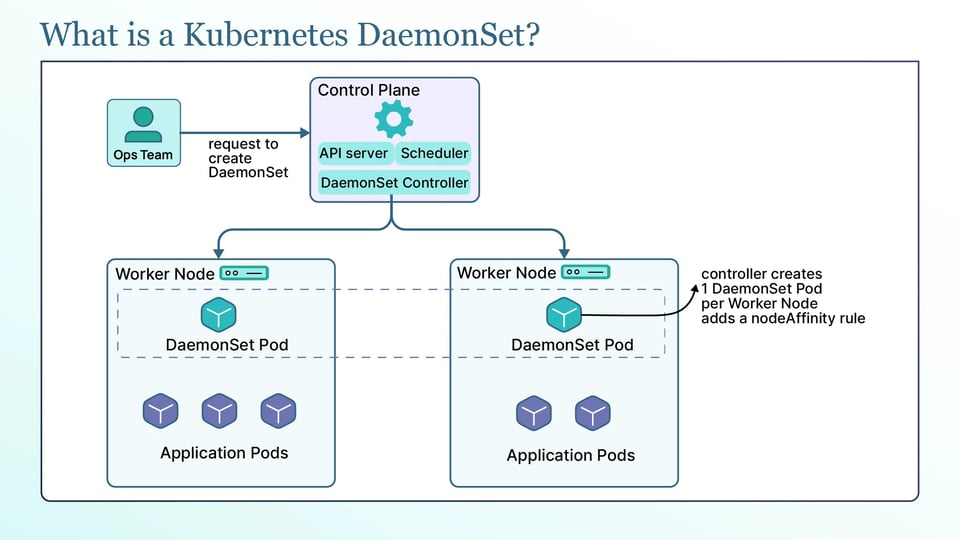
El controlador de DaemonSet observa el clúster de forma continua y mantiene el estado real alineado con lo que definiste. Cuando un nodo nuevo se une, el controlador crea el pod del DaemonSet en ese nodo. Cuando se elimina un nodo, el pod que estaba en él se limpia. Y cuando eliminas el DaemonSet, Kubernetes elimina todos los pods que creó. Nunca le indicas cuántos pods ejecutar; lo deduce del conjunto de nodos coincidentes.
La forma en que se programan los pods de un DaemonSet ha cambiado con el tiempo. Desde Kubernetes 1.12, los pods de un DaemonSet se ubican mediante el scheduler predeterminado, kube-scheduler, igual que cualquier otro pod. El controlador crea un pod por cada nodo elegible y agrega una regla de nodeAffinity que fija cada pod a un nodo específico, y el scheduler luego vincula el pod a ese nodo. Como los maneja el scheduler normal, los pods de un DaemonSet respetan los taints, las tolerations y la prioridad de pods.
Kubernetes también asigna automáticamente a los pods de un DaemonSet un conjunto de tolerations para que un agente de nodo siga ejecutándose cuando el nodo está bajo presión, cubriendo los taints de condición de nodo como not-ready, unreachable, disk-pressure, memory-pressure, pid-pressure, unschedulable y network-unavailable. Un taint que no se tolera automáticamente es el del control plane, y por eso los pods de un DaemonSet no se programan en nodos del control plane a menos que agregues esa toleration tú mismo.
¿Para qué se usan los DaemonSets?
Los DaemonSets se usan para workloads que deben ejecutarse en cada nodo o en un conjunto específico de nodos, en lugar de un número fijo de réplicas. Los ejemplos más comunes son:
a. Agentes de recolección de logs: herramientas como Fluentd y Fluent Bit se ejecutan como DaemonSet para que haya un recolector en cada nodo, que lee los logs de todos los pods de ese nodo y los envía a un almacén central.
b. Agentes de monitoreo y métricas: los exporters a nivel de nodo, como el node-exporter de Prometheus, y los agentes de métricas de GPU como DCGM, se ejecutan por nodo para exponer las métricas de hardware y del sistema operativo de ese nodo.
c. Plugins CNI, proxies de servicio y otros pods de red: los plugins de container network interface que dan red a los pods, como Calico y Cilium, se ejecutan como DaemonSets porque la red debe configurarse en cada nodo. El propio kube-proxy también se ejecuta así.
d. Agentes de almacenamiento, seguridad y hardware: los plugins CSI de nodo para almacenamiento, los agentes de seguridad y cumplimiento, los device plugins de GPU que exponen aceleradores a los pods y otros drivers de nodo se ejecutan como DaemonSets para que la capacidad exista en cada nodo que la necesite.
DaemonSet comparado con otros tipos de workloads de Kubernetes
Los DaemonSets resuelven un problema específico, así que ayuda ver en qué se diferencian de los tipos de workload que quizás uses por defecto. Comparemos:
Frente a un Deployment, la diferencia está en la ubicación y la cantidad. Un Deployment ejecuta N réplicas y el scheduler decide en qué nodos se ubican, lo que conviene para apps sin estado donde no te importa dónde corre cada réplica. Un DaemonSet ejecuta un pod por nodo coincidente y escala con la cantidad de nodos. La regla rápida: si la respuesta a "¿cuántas copias?" es "una en cada nodo", necesitas un DaemonSet; y si es "N copias, en cualquier lugar", necesitas un Deployment.
Frente a un StatefulSet, la diferencia es identidad y almacenamiento. Un StatefulSet da a sus pods nombres estables, despliegue ordenado y sus propios volúmenes persistentes, que es lo que necesitan los sistemas con estado como las bases de datos. Un DaemonSet no ofrece identidad ordenada ni almacenamiento por pod; ofrece cobertura de nodos.
Y frente a los static pods, los bare pods y los contenedores sidecar, la diferencia está en qué gestiona el pod y dónde se ejecuta. Un static pod es gestionado directamente por el kubelet en un nodo, no por el API server, por lo que se usa para arrancar componentes del control plane, no para ejecutar un agente en varios nodos.
Un bare pod es un pod aislado sin nada que lo mantenga vivo, por lo que no se reprograma si falla su nodo. Un contenedor sidecar se ejecuta junto a tu app dentro del mismo pod, una vez por pod de la app, y es la opción correcta cuando el componente auxiliar pertenece a un workload específico y no al nodo. Un DaemonSet es la herramienta cuando quieres exactamente una copia gestionada por nodo.
Anatomía de un manifiesto de DaemonSet
Un manifiesto de DaemonSet se parece mucho a uno de Deployment, con algunas diferencias importantes. Este es uno que ejecuta un agente de logs Fluent Bit en cada nodo:
apiVersion: apps/v1kind: DaemonSetmetadata: name: fluent-bit namespace: loggingspec: selector: matchLabels: app: fluent-bit updateStrategy: type: RollingUpdate rollingUpdate: maxUnavailable: 1 template: metadata: labels: app: fluent-bit spec: containers: - name: fluent-bit image: fluent/fluent-bit:3.1 resources: requests: cpu: 50m memory: 64Mi limits: cpu: 200m memory: 128MiAquí importan algunas reglas. No hay campo replicas, porque la cantidad de nodos determina la cantidad de pods. El selector le dice al DaemonSet qué pods le pertenecen, debe coincidir con las labels de la plantilla de pods y no puede cambiarse después de crear el DaemonSet. El restartPolicy de la plantilla de pods debe ser Always, que además es el valor por defecto, porque un agente de nodo está pensado para ejecutarse de forma continua.
Los agentes de nodo también necesitan acceso al nodo en sí, y lo obtienen mediante algunas configuraciones del pod: hostNetwork: true coloca el pod en la red del nodo, de la que dependen los agentes de red y monitoreo. Los volúmenes hostPath montan un directorio del nodo, que los recolectores de logs usan para leer /var/log. Y hostPID: true permite al pod ver el árbol de procesos del nodo, algo que necesitan algunos agentes de seguridad y monitoreo. Estas configuraciones son potentes, así que úsalas solo donde el agente realmente las requiera.
Cómo controlar en qué nodos se ejecutan los pods de un DaemonSet
Por defecto, un DaemonSet se ejecuta en todos los nodos elegibles, pero muchas veces necesitas limitarlo a un conjunto específico de nodos. Veamos.
Para limitarlo a nodos específicos, agrega un nodeSelector o una node affinity a la plantilla de pods. Un nodeSelector selecciona nodos por label, por ejemplo, para ejecutar un agente solo en nodos con la label disk=ssd. La node affinity hace lo mismo con reglas más expresivas, y te permite filtrar por regiones, tipos de instancia o combinaciones de labels cuando una simple coincidencia de label no basta.
Los taints y tolerations controlan los casos más difíciles; como los pods de un DaemonSet pasan por el scheduler normal, los taints de un nodo los mantienen fuera a menos que el pod los tolere. Por eso los nodos del control plane no reciben pods de DaemonSet por defecto: llevan el taint del control plane, y tienes que agregar una toleration correspondiente para ejecutar tu agente allí. Puedes tolerar todos los taints con una sola toleration general, pero rara vez es lo que quieres, porque elimina la protección que brindan los taints.
Para clústeres mixtos de Linux y Windows, usa un nodeSelector con kubernetes.io/os para que los agentes de Linux se ejecuten solo en nodos Linux y los de Windows solo en nodos Windows.
¿Cómo crear, actualizar y eliminar un DaemonSet?
Un DaemonSet se aplica como cualquier otro objeto de Kubernetes:
kubectl apply -f fluent-bit.yamlkubectl get daemonset -n loggingkubectl rollout status daemonset/fluent-bit -n loggingLa salida de get muestra los valores desired, current, ready y available, que deberían coincidir con tu cantidad de nodos, y rollout status confirma que el despliegue terminó.
La forma en que ocurren las actualizaciones la define la estrategia de actualización. RollingUpdate, la predeterminada, reemplaza los pods de forma gradual entre nodos cuando cambias la plantilla de pods. OnDelete no despliega automáticamente; el controlador solo crea un pod nuevo con la plantilla actualizada después de que eliminas el antiguo a mano, lo que te da control manual total para agentes sensibles.
En un rolling update, dos campos marcan el ritmo. maxUnavailable, que por defecto es 1, define cuántos nodos pueden quedarse sin el pod al mismo tiempo durante la actualización, así que maxUnavailable: 1 actualiza un nodo a la vez. maxSurge, que por defecto es 0 y se volvió estable en Kubernetes 1.25, permite al controlador iniciar el pod nuevo en un nodo antes de eliminar el antiguo, logrando una actualización sin downtime por nodo.
Los dos no pueden habilitarse a la vez: si estableces maxSurge en un valor distinto de cero, maxUnavailable debe ser 0, y ten en cuenta que maxSurge no funciona con hostPort, porque dos pods no pueden vincularse al mismo puerto del host. Puedes revertir una mala actualización igual que con un Deployment, con kubectl rollout undo daemonset/<name>. Para eliminar un DaemonSet, usa kubectl delete daemonset <name>. Esto elimina el DaemonSet y todos los pods que gestiona.
¿Cómo escalar un DaemonSet a cero sin eliminarlo?
Un DaemonSet no tiene campo replicas, así que no puedes escalarlo a cero de la forma habitual. El truco es darle un nodeSelector que ningún nodo cumpla, lo que deja el DaemonSet en su lugar pero no programa ninguno de sus pods:
spec: template: spec: nodeSelector: non-existent-label: "true"Como ningún nodo tiene esa label, el controlador crea cero pods, pero el objeto DaemonSet y su configuración permanecen. Para reactivarlo, elimina el selector o aplica la label a los nodos que quieras. Esto es útil para deshabilitar temporalmente un agente en todo el clúster sin perder su definición.
¿Cómo afectan los DaemonSets el costo del clúster y la capacidad de los nodos?
Los DaemonSets pueden aumentar los costos porque se ejecutan en muchos o en todos los nodos de un clúster:
El punto clave es que los resource requests de un DaemonSet se multiplican por cada nodo del clúster. Si un agente solicita 100m de CPU y 128Mi de memoria, eso se reserva en cada uno de los nodos, así que en un clúster de 200 nodos se reservan 20 CPU y unos 25Gi de memoria antes de que se ejecute cualquiera de tus workloads. Un request que parece diminuto por nodo se convierte en capacidad real a escala de flota.
Esa capacidad reservada también reduce lo que se puede programar por nodo, lo que perjudica el bin-packing. Cada pod de DaemonSet toma una porción de los recursos asignables de cada nodo, así que cuantos más DaemonSets ejecutes, menos espacio queda para los pods de las aplicaciones, y más difícil es empaquetar los workloads de forma compacta. Esto influye directamente en el autoescalado de nodos. Tanto el Cluster Autoscaler como Karpenter consideran la sobrecarga de los DaemonSets al dimensionar los nodos, y como esa sobrecarga es por nodo, los nodos más grandes la manejan con mayor eficiencia: un costo fijo de DaemonSet representa una fracción menor en un nodo grande que en uno pequeño, un factor real en las decisiones de dimensionamiento de nodos.
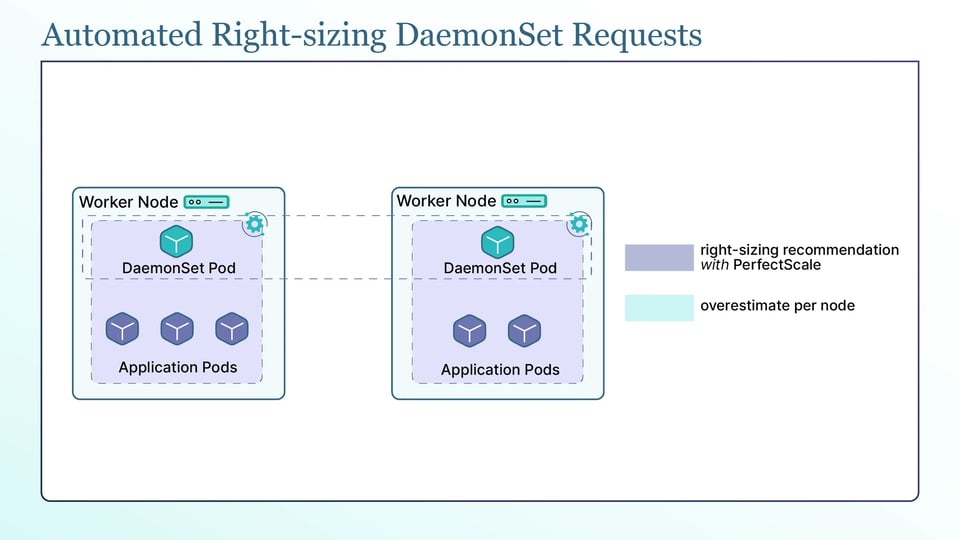
Como el costo se multiplica, el right-sizing de los requests de un DaemonSet importa más que en un Deployment individual. Tienes que dimensionar los requests de cada agente a partir de su uso real, no de un valor por defecto estimado, porque una sobreestimación de 50Mi en un agente se convierte en 10Gi perdidos en 200 nodos.
PerfectScale está pensado exactamente para este problema: su plataforma de gobernanza de Kubernetes observa cómo tus workloads, incluidos los agentes de DaemonSet, usan realmente CPU y memoria, y lo convierte en recomendaciones de right-sizing accionables y automatizadas que puedes aplicar de forma manual o autónoma, para que una sobreestimación por nodo no se multiplique en una gran pérdida en todo el clúster. Equipos como Paramount Pictures y Creditas usan PerfectScale para mantener sus clústeres eficientes, y puedes probarlo o agendar una sesión técnica.
Como complemento, Kubecost y el proyecto open source OpenCost reportan el costo por workload para que veas lo que consumen tus DaemonSets, y Goldilocks y el Vertical Pod Autoscaler en modo recommender sugieren valores de requests a partir del uso observado.
Cómo mantener los pods de un DaemonSet en ejecución durante interrupciones
Los agentes de nodo son workloads que no quieres perder, así que es importante hacerlos resilientes a las interrupciones. Veamos cómo:
Las priority classes son la herramienta principal para esto. Al asignarla a un DaemonSet, la priority class integrada system-node-critical marca sus pods como críticos para el nodo. El scheduler y el kubelet los tratan entonces como de alta prioridad, lo que reduce la probabilidad de que sean desalojados bajo presión de recursos. Esto es apropiado para componentes esenciales a nivel de nodo, como los agentes CNI y de monitoreo.
También es importante entender cómo se comportan los pods de un DaemonSet durante las interrupciones comunes. Bajo presión en el nodo, el kubelet puede desalojar primero los pods de menor prioridad, y por eso la priority class crítica puede ayudar a proteger los agentes importantes.
Durante un node drain, por ejemplo antes de un mantenimiento, los pods de DaemonSet se manejan de forma distinta a los pods normales porque están ligados al nodo. Durante una actualización del clúster, los agentes de DaemonSet se mueven junto con los nodos, así que verifica que la versión del agente sea compatible con la nueva versión de Kubernetes antes de actualizar.
Buenas prácticas para DaemonSets de Kubernetes
Las siguientes buenas prácticas ayudan a mantener los DaemonSets eficientes, confiables y seguros de operar:
a. Limita los DaemonSets a workloads genuinamente a nivel de nodo: recuerda que cada DaemonSet se ejecuta en todos los nodos y multiplica su costo; usa uno solo cuando el workload realmente necesite ejecutarse por nodo. Si un componente auxiliar pertenece a una app específica, un contenedor sidecar es la mejor opción.
b. Define requests y limits de recursos explícitos en cada agente: nunca deberías ejecutar un DaemonSet sin requests y limits. Dada la multiplicación a escala de flota, un agente sin límites o sobredimensionado genera mucha más pérdida que el mismo error en un Deployment individual.
c. Acota las tolerations en lugar de tolerar todos los taints: agrega solo las tolerations que un agente realmente necesita, como la del control plane para un agente que deba ejecutarse allí. Una toleration general de "tolerar todo" elimina la protección que ese taint debe brindar.
d. Despliega las actualizaciones con un maxUnavailable conservador: para agentes de nodo críticos, actualiza despacio, de a uno o pocos nodos a la vez, para que una mala versión del agente no rompa la red o el monitoreo de todo el clúster de golpe. maxSurge: 1 con maxUnavailable: 0 permite una actualización sin downtime por nodo cuando el agente lo soporta.
e. Monitorea numberUnavailable y la duración de los despliegues como señales continuas: tienes que vigilar cuántos pods de DaemonSet están no disponibles y cuánto tardan los despliegues. Un número creciente de pods no disponibles o un despliegue lento es una señal temprana de que un agente está fallando en algunos nodos.
f. Vuelve a revisar la huella de recursos del DaemonSet cada vez que cambie el tamaño del clúster: como el costo escala con la cantidad de nodos, una huella que estaba bien con 20 nodos puede ser significativa con 300. Revisa los resource requests a medida que el clúster crece para que el uso de recursos de los DaemonSets no crezca demasiado.
Solución de fallas comunes en DaemonSets
Estos son los dos tipos de problemas que aparecen con más frecuencia, y cada uno tiene un punto de partida claro:
a. Pods faltantes en nodos específicos y despliegues atascados: si un nodo no tiene el pod del DaemonSet, casi siempre es un tema de scheduling: el nodo tiene un taint que el pod no tolera, o el nodeSelector o la affinity del pod lo excluyen. Ejecuta kubectl describe node <node> para ver sus taints y labels, y kubectl describe pod en un pod de DaemonSet pendiente para ver por qué no se programa. Un despliegue atascado suele deberse a las mismas causas, o a un pod nuevo que no logra pasar a ready, así que revisa los eventos y los logs del pod nuevo.
b. Agentes con OOMKilled y throttling de CPU: los agentes de DaemonSet suelen estar subaprovisionados, por lo que sufren OOMKilled cuando su límite de memoria es demasiado bajo, o throttling de CPU cuando su límite de CPU es demasiado ajustado, sobre todo en nodos ocupados con muchos pods que vigilar. Un agente con OOMKilled muestra OOMKilled y el código de salida 137 en kubectl describe pod. El throttling de CPU aparece en las métricas de throttling de CPU, no en los logs. La solución es definir los requests y limits del agente según su uso real. Como estos recursos se necesitan en cada nodo, es importante dimensionarlos con cuidado.