


Un DaemonSet Kubernetes è un oggetto workload che garantisce l'esecuzione di una copia di un pod su ogni nodo del cluster, o su un insieme di nodi specifico a Sua scelta. Quando un nodo entra nel cluster, il DaemonSet aggiunge automaticamente il proprio pod a quel nodo. Quando un nodo esce dal cluster, il pod viene rimosso insieme a esso. È così che si eseguono agenti a livello di nodo come collector di log, agenti di monitoraggio e plugin di rete, senza dover posizionare manualmente un pod su ciascun nodo.
In questa guida scoprirà come funzionano i DaemonSet, a cosa servono, in cosa si differenziano dagli altri tipi di workload, come scrivere e controllare un DaemonSet, come aggiornarlo e scalarlo, come incidono sui costi del cluster, oltre alle best practice e ai problemi più comuni da conoscere.
Cos'è un DaemonSet Kubernetes?
Un DaemonSet è pensato per workloads a livello di nodo, non per un numero fisso di repliche. Mantiene un pod su ogni nodo che corrisponde alle sue regole di scheduling, e Kubernetes regola automaticamente il numero di pod al variare di quei nodi.
È un obiettivo diverso da quello di un Deployment. Un Deployment esegue il numero di repliche che si sceglie e lascia che lo scheduler le distribuisca nel cluster. Un DaemonSet non ha un numero di repliche: il numero di pod corrisponde ai nodi che soddisfano i criteri e cambia da solo man mano che i nodi vengono aggiunti o rimossi. I DaemonSet sono oggetti con namespace, usano apiVersion: apps/v1 e, di norma, un DaemonSet esegue un solo tipo di agente su tutti i nodi.
Come funzionano i DaemonSet?
Due elementi chiave spiegano il funzionamento di un DaemonSet: il controller del DaemonSet e lo scheduler di Kubernetes. Vediamoli:
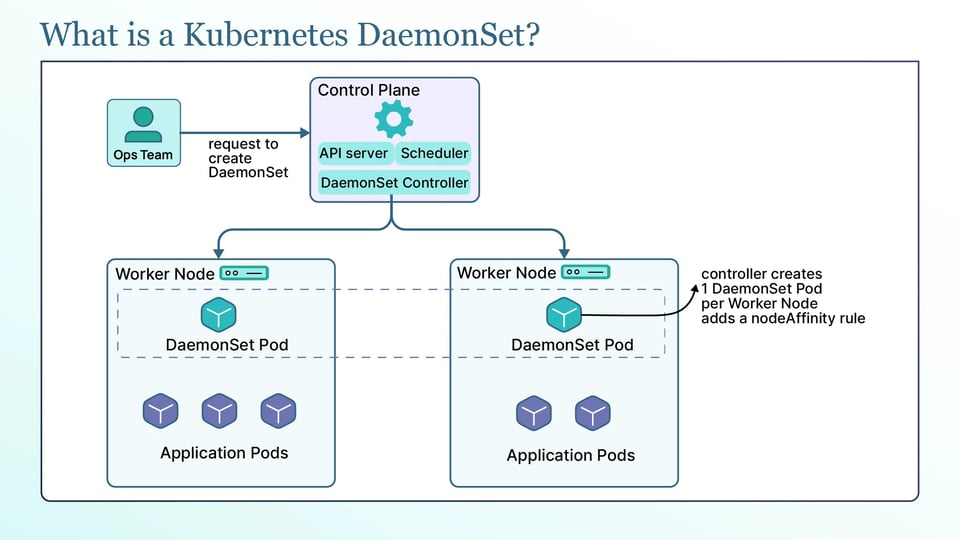
Il controller del DaemonSet osserva continuamente il cluster e mantiene lo stato reale allineato a quanto definito. Quando un nuovo nodo entra nel cluster, il controller crea il pod del DaemonSet su quel nodo. Quando un nodo viene rimosso, il pod che vi era in esecuzione viene eliminato. E quando si elimina il DaemonSet, Kubernetes rimuove tutti i pod che aveva creato. Non si specifica mai quanti pod eseguire: il numero deriva dall'insieme dei nodi corrispondenti.
Il modo in cui i pod dei DaemonSet vengono schedulati è cambiato nel tempo. A partire da Kubernetes 1.12, i pod dei DaemonSet vengono posizionati dallo scheduler predefinito, kube-scheduler, come qualsiasi altro pod. Il controller crea un pod per ogni nodo idoneo e aggiunge una regola nodeAffinity che vincola ciascun pod a un nodo specifico; lo scheduler associa quindi il pod a quel nodo. Poiché a gestirli è lo scheduler standard, i pod dei DaemonSet rispettano taints, tolerations e la priorità dei pod.
Kubernetes assegna inoltre automaticamente ai pod dei DaemonSet una serie di tolerations, così che un agente di nodo continui a funzionare quando un nodo è sotto stress, coprendo i taints legati alle condizioni del nodo come not-ready, unreachable, disk-pressure, memory-pressure, pid-pressure, unschedulable e network-unavailable. Un taint che non viene tollerato automaticamente è quello del control plane: ecco perché i pod dei DaemonSet non finiscono sui nodi del control plane, a meno che non si aggiunga esplicitamente quella toleration.
A cosa servono i DaemonSet?
I DaemonSet sono utilizzati per workloads che devono essere eseguiti su ogni nodo o su un insieme specifico di nodi, anziché con un numero fisso di repliche. Gli esempi più comuni:
a. Agenti di raccolta log: strumenti come Fluentd e Fluent Bit vengono eseguiti come DaemonSet, così su ogni nodo c'è un collector che legge i log di tutti i pod di quel nodo e li invia a un archivio centrale.
b. Agenti di monitoraggio e metriche: exporter a livello di nodo come Prometheus node-exporter e agenti per metriche GPU come DCGM vengono eseguiti su ogni nodo per esporre le metriche hardware e del sistema operativo di quel nodo.
c. Plugin CNI, service proxy e altri pod di rete: i plugin di container network interface che forniscono la rete ai pod, come Calico e Cilium, vengono eseguiti come DaemonSet perché la rete deve essere configurata su ogni nodo. Anche kube-proxy funziona in questo modo.
d. Agenti di storage, sicurezza e hardware: i plugin di nodo CSI per lo storage, gli agenti di sicurezza e conformità, i device plugin GPU che espongono gli acceleratori ai pod e altri driver di nodo vengono tutti eseguiti come DaemonSet, così la funzionalità è presente su ogni nodo che ne ha bisogno.
Il DaemonSet a confronto con gli altri tipi di workload Kubernetes
I DaemonSet risolvono un problema specifico, quindi è utile capire in cosa differiscono dai tipi di workload che si usano di default. Confrontiamoli:
Rispetto a un Deployment, la differenza sta nel posizionamento e nel conteggio. Un Deployment esegue N repliche e lo scheduler decide su quali nodi collocarle, il che è adatto ad app stateless in cui non importa dove giri ciascuna replica. Un DaemonSet esegue un pod per ogni nodo corrispondente e scala con il numero di nodi. La regola rapida: se la risposta a "quante copie?" è "una su ogni nodo", serve un DaemonSet; se è "N copie, ovunque", serve un Deployment.
Rispetto a uno StatefulSet, la differenza è identità e storage. Uno StatefulSet dà ai suoi pod nomi stabili, rollout ordinato e volumi persistenti dedicati, ciò di cui hanno bisogno i sistemi stateful come i database. Un DaemonSet non offre né identità ordinata né storage per pod: offre copertura dei nodi.
E rispetto a pod statici, bare pod e container sidecar, la differenza sta in chi gestisce il pod e dove viene eseguito. Un pod statico è gestito direttamente dal kubelet su un singolo nodo, non dall'API server, quindi viene usato per avviare i componenti del control plane, non per eseguire un agente su più nodi.
Un bare pod è un singolo pod senza nulla che lo mantenga in vita, quindi non viene rischedulato se il suo nodo si guasta. Un container sidecar viene eseguito accanto all'applicazione nello stesso pod, una volta per ogni pod applicativo, ed è la scelta giusta quando il componente ausiliario appartiene a un workload specifico e non al nodo. Il DaemonSet è lo strumento adatto quando si vuole esattamente una copia gestita per nodo.
Anatomia di un manifest DaemonSet
Un manifest DaemonSet assomiglia molto a quello di un Deployment, con alcune differenze importanti. Eccone uno che esegue un agente di log Fluent Bit su ogni nodo:
apiVersion: apps/v1kind: DaemonSetmetadata: name: fluent-bit namespace: loggingspec: selector: matchLabels: app: fluent-bit updateStrategy: type: RollingUpdate rollingUpdate: maxUnavailable: 1 template: metadata: labels: app: fluent-bit spec: containers: - name: fluent-bit image: fluent/fluent-bit:3.1 resources: requests: cpu: 50m memory: 64Mi limits: cpu: 200m memory: 128MiQui contano alcune regole. Non esiste il campo replicas, perché è il numero di nodi a determinare il numero di pod. Il selector indica al DaemonSet quali pod gli appartengono, deve corrispondere alle label nel template del pod e non può essere modificato dopo la creazione del DaemonSet. La restartPolicy del template del pod deve essere Always, che è anche il valore predefinito, perché un agente di nodo è pensato per essere eseguito in modo continuativo.
Gli agenti di nodo hanno anche bisogno di accedere al nodo stesso, cosa che ottengono tramite alcune impostazioni del pod: hostNetwork: true colloca il pod sulla rete del nodo, su cui fanno affidamento gli agenti di rete e di monitoraggio. I volumi hostPath montano una directory del nodo, che i collector di log usano per leggere /var/log. E hostPID: true consente al pod di vedere l'albero dei processi del nodo, necessario ad alcuni agenti di sicurezza e monitoraggio. Sono impostazioni potenti: vanno usate solo dove l'agente ne ha davvero bisogno.
Controllare su quali nodi vengono eseguiti i pod del DaemonSet
Per impostazione predefinita, un DaemonSet viene eseguito su ogni nodo idoneo, ma spesso è necessario limitarlo a un insieme specifico di nodi. Vediamo come.
Per limitarlo a nodi specifici, si aggiunge un nodeSelector o una node affinity al template del pod. Un nodeSelector seleziona i nodi in base alle label, ad esempio eseguendo un agente solo sui nodi etichettati disk=ssd. La node affinity svolge lo stesso compito con regole più espressive, permettendo di selezionare in base a regioni, tipi di istanza o combinazioni di label quando una semplice corrispondenza di label non basta.
Taints e tolerations gestiscono i casi più complessi: poiché i pod dei DaemonSet passano dallo scheduler standard, i taints di un nodo li tengono lontani, a meno che il pod non li tolleri. Ecco perché i nodi del control plane non ricevono pod dei DaemonSet di default: portano il taint del control plane, e per eseguirvi il proprio agente bisogna aggiungere una toleration corrispondente. È possibile tollerare qualsiasi taint con un'unica toleration generica, ma raramente è ciò che si vuole, perché elimina la protezione offerta dai taints.
Per i cluster misti Linux e Windows, usi un nodeSelector con kubernetes.io/os, così gli agenti Linux vengono eseguiti solo sui nodi Linux e quelli Windows solo sui nodi Windows.
Come creare, aggiornare ed eliminare un DaemonSet?
Un DaemonSet si applica come qualsiasi altro oggetto Kubernetes:
kubectl apply -f fluent-bit.yamlkubectl get daemonset -n loggingkubectl rollout status daemonset/fluent-bit -n loggingL'output di get mostra i conteggi desired, current, ready e available, che dovrebbero corrispondere al numero di nodi, mentre rollout status conferma che il rollout è terminato.
Il modo in cui avvengono gli aggiornamenti è definito dalla strategia di aggiornamento. RollingUpdate, quella predefinita, sostituisce gradualmente i pod sui vari nodi quando si modifica il template del pod. OnDelete non esegue il rollout automaticamente: il controller crea un nuovo pod con il template aggiornato solo dopo che quello vecchio è stato eliminato manualmente, garantendo pieno controllo manuale per gli agenti sensibili.
Per un rolling update, due campi ne definiscono il ritmo. maxUnavailable, il cui valore predefinito è 1, indica quanti nodi possono restare senza pod contemporaneamente durante l'aggiornamento: con maxUnavailable: 1 si aggiorna un nodo alla volta. maxSurge, con valore predefinito 0 e stabile da Kubernetes 1.25, consente al controller di avviare il nuovo pod su un nodo prima di rimuovere quello vecchio, ottenendo un aggiornamento senza downtime per singolo nodo.
I due non possono essere attivi contemporaneamente: se si imposta maxSurge a un valore diverso da zero, maxUnavailable deve essere 0; si noti inoltre che maxSurge non funziona con hostPort, perché due pod non possono usare la stessa porta host. Un aggiornamento problematico si può annullare come per un Deployment, con kubectl rollout undo daemonset/<name>. Per eliminare un DaemonSet si usa kubectl delete daemonset <name>: questo rimuove il DaemonSet e tutti i pod che gestisce.
Come scalare un DaemonSet a zero senza eliminarlo?
Un DaemonSet non ha il campo replicas, quindi non è possibile scalarlo a zero nel modo consueto. Il trucco è assegnargli un nodeSelector a cui nessun nodo corrisponde: il DaemonSet resta al suo posto, ma nessuno dei suoi pod viene schedulato:
spec: template: spec: nodeSelector: non-existent-label: "true"Poiché nessun nodo ha quella label, il controller crea zero pod, ma l'oggetto DaemonSet e la sua configurazione rimangono. Per ripristinarlo, rimuova il selector o applichi la label ai nodi desiderati. È utile per disabilitare temporaneamente un agente in tutto il cluster senza perderne la definizione.
Come i DaemonSet incidono sui costi del cluster e sulla capacità dei nodi?
I DaemonSet possono aumentare i costi perché vengono eseguiti su molti o su tutti i nodi di un cluster:
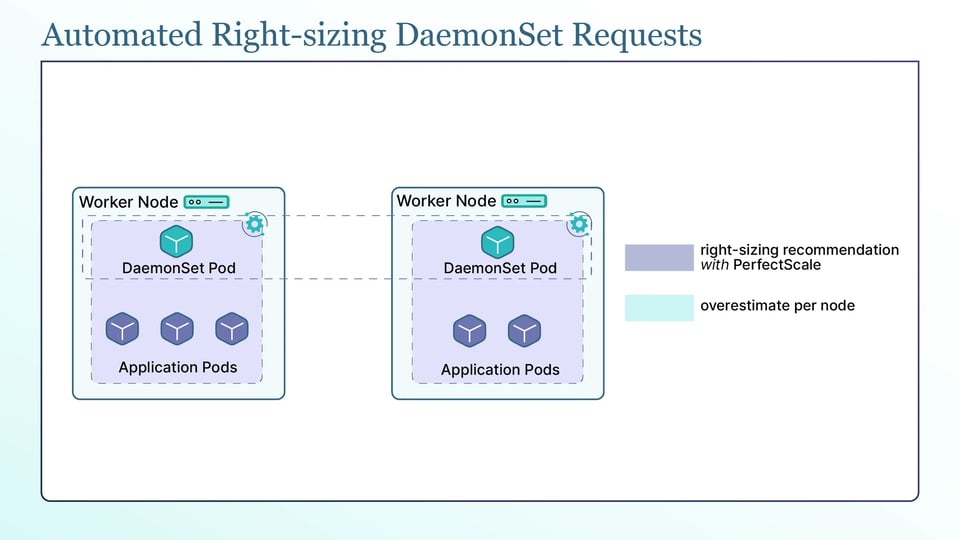
Il punto chiave è che le richieste di risorse di un DaemonSet si moltiplicano per ogni nodo del cluster. Se un agente richiede 100m di CPU e 128Mi di memoria, quella quota è riservata su ogni singolo nodo: in un cluster da 200 nodi si riservano 20 CPU e circa 25Gi di memoria prima ancora che i Suoi workloads vengano eseguiti. Una richiesta che sembra minuscola per singolo nodo si traduce in capacità reale a livello di intera flotta.
Quella capacità riservata riduce inoltre ciò che è schedulabile su ciascun nodo, penalizzando il bin-packing. Ogni pod di un DaemonSet consuma una fetta delle risorse allocabili di ogni nodo: più DaemonSet si eseguono, meno spazio resta per i pod applicativi e più difficile diventa impacchettare i workloads in modo denso. Questo incide direttamente sull'autoscaling dei nodi. Sia il Cluster Autoscaler sia Karpenter tengono conto dell'overhead dei DaemonSet nel dimensionare i nodi e, poiché quell'overhead è per nodo, i nodi più grandi lo gestiscono in modo più efficiente: un costo fisso da DaemonSet pesa meno su un nodo grande che su uno piccolo, un fattore reale nelle decisioni di dimensionamento dei nodi.
Poiché il costo si moltiplica, il right-sizing delle richieste dei DaemonSet conta più che per un singolo Deployment. Le richieste di ogni agente vanno dimensionate sull'uso reale, non su un valore stimato, perché una sovrastima di 50Mi su un singolo agente diventa 10Gi sprecati su 200 nodi.
PerfectScale è costruito esattamente per questo problema: la sua piattaforma di governance Kubernetes osserva come i workloads, agenti DaemonSet inclusi, utilizzano effettivamente CPU e memoria e trasforma questi dati in raccomandazioni di right-sizing concrete e automatizzate, applicabili manualmente o in modo autonomo, così una sovrastima per nodo non si moltiplica in un grande spreco a livello di cluster. Team come Paramount Pictures e Creditas usano PerfectScale per mantenere efficienti i loro cluster: può provarlo o prenotare una sessione tecnica.
Accanto a questo, Kubecost e la soluzione open source OpenCost mostrano i costi per workload, così da vedere quanto consumano i DaemonSet, mentre Goldilocks e il Vertical Pod Autoscaler in modalità recommender suggeriscono valori di richieste basati sull'utilizzo osservato.
Mantenere in esecuzione i pod dei DaemonSet durante le interruzioni
Gli agenti di nodo sono workloads che non si vogliono perdere, quindi è importante renderli resilienti alle interruzioni. Vediamo come:
Le priority class sono lo strumento principale. Assegnando a un DaemonSet la priority class integrata system-node-critical, i suoi pod vengono contrassegnati come critici per il nodo. Lo scheduler e il kubelet li trattano quindi come ad alta priorità, rendendoli meno soggetti a eviction sotto pressione di risorse. È appropriato per componenti essenziali a livello di nodo come i CNI e gli agenti di monitoraggio.
È inoltre importante capire come si comportano i pod dei DaemonSet durante le interruzioni più comuni. Sotto pressione del nodo, il kubelet può effettuare per primo l'eviction dei pod a priorità più bassa, ed è per questo che la priority class critical può aiutare a proteggere gli agenti importanti.
Durante il drain di un nodo, ad esempio prima di una manutenzione, i pod dei DaemonSet vengono gestiti in modo diverso dai pod normali perché sono legati al nodo. Durante un upgrade del cluster, gli agenti DaemonSet si spostano insieme ai nodi: verifichi quindi che la versione dell'agente sia compatibile con la nuova versione di Kubernetes prima di aggiornare.
Best practice per i DaemonSet Kubernetes
Le seguenti best practice aiutano a mantenere i DaemonSet efficienti, affidabili e sicuri da gestire:
a. Limitare i DaemonSet ai workloads davvero a livello di nodo: come noto, ogni DaemonSet viene eseguito su ogni nodo e ne moltiplica il costo; lo usi solo quando il workload deve realmente essere eseguito per nodo. Se un componente ausiliario appartiene a un'app specifica, un container sidecar è la scelta migliore.
b. Impostare richieste e limiti di risorse espliciti su ogni agente: non esegua mai un DaemonSet senza richieste e limiti. Data la moltiplicazione su tutta la flotta, un agente senza vincoli o sovradimensionato spreca molto più dello stesso errore in un singolo Deployment.
c. Definire tolerations mirate invece di tollerare ogni taint: aggiunga solo le tolerations di cui l'agente ha effettivamente bisogno, come quella del control plane per un agente che deve essere eseguito lì. Una toleration generica "tollera tutto" elimina la protezione che quel taint dovrebbe garantire.
d. Distribuire gli aggiornamenti con un maxUnavailable prudente: per gli agenti di nodo critici, aggiorni lentamente, uno o pochi nodi alla volta, così una versione difettosa dell'agente non compromette rete o monitoraggio in tutto il cluster in un colpo solo. maxSurge: 1 con maxUnavailable: 0 offre un aggiornamento senza downtime per nodo, laddove l'agente lo supporta.
e. Monitorare numberUnavailable e la durata dei rollout come segnali continui: tenga d'occhio quanti pod dei DaemonSet non sono disponibili e quanto durano i rollout. Un conteggio di indisponibilità in crescita o un rollout lento è un segnale precoce che un agente sta andando in errore su alcuni nodi.
f. Ricontrollare il footprint di risorse dei DaemonSet a ogni variazione della dimensione del cluster: poiché il costo scala con il numero di nodi, un footprint accettabile con 20 nodi può diventare significativo con 300. Riveda le richieste di risorse man mano che il cluster cresce, così l'utilizzo di risorse dei DaemonSet non aumenta eccessivamente.
Risolvere i problemi più comuni dei DaemonSet
Ecco i due tipi di problemi che si presentano più spesso, ognuno con un chiaro punto di partenza:
a. Pod mancanti su nodi specifici e rollout bloccati: se su un nodo manca il pod del DaemonSet, si tratta quasi sempre di scheduling: il nodo ha un taint che il pod non tollera, oppure il nodeSelector o l'affinity del pod lo escludono. Esegua kubectl describe node <node> per vederne taints e label, e kubectl describe pod su un pod DaemonSet in stato pending per capire perché non viene schedulato. Un rollout bloccato di solito risale alle stesse cause, o a un nuovo pod che non riesce a diventare ready: controlli quindi gli eventi e i log del nuovo pod.
b. Agenti OOMKilled e throttling della CPU: gli agenti dei DaemonSet sono spesso sottodimensionati, quindi vengono OOMKilled quando il loro limite di memoria è troppo basso, oppure subiscono il throttling della CPU quando il loro limite di CPU è troppo stretto, specialmente su nodi carichi con molti pod da osservare. Un agente OOMKilled mostra OOMKilled e l'exit code 137 in kubectl describe pod. Il throttling della CPU compare nelle metriche di throttling della CPU, non nei log. La soluzione è impostare richieste e limiti dell'agente in base al suo utilizzo effettivo. Poiché queste risorse sono necessarie su ogni nodo, è importante dimensionarle con cura.