


Um DaemonSet do Kubernetes é um objeto de workload que garante que uma cópia de um pod seja executada em todos os nós do seu cluster, ou em um conjunto específico de nós que você escolher. Quando um nó entra no cluster, o DaemonSet adiciona seu pod a esse nó automaticamente. Quando um nó sai, o pod vai junto. É assim que você executa agentes em nível de nó, como coletores de logs, agentes de monitoramento e plugins de rede, sem precisar colocar um pod em cada nó manualmente.
Neste guia, você vai aprender como os DaemonSets funcionam, para que servem, como se comparam a outros tipos de workload, como escrever e controlar um DaemonSet, como atualizar e escalar um deles, como eles afetam o custo do cluster e quais boas práticas e falhas você precisa conhecer.
O que é um DaemonSet no Kubernetes?
Um DaemonSet foi projetado para workloads em nível de nó, e não para um número fixo de réplicas. Ele mantém um pod em cada nó que corresponde às suas regras de agendamento, e o Kubernetes ajusta automaticamente a quantidade de pods conforme esses nós mudam.
Esse objetivo é diferente do de um Deployment. Um Deployment executa o número de réplicas que você escolher e deixa o scheduler distribuí-las pelo cluster. Um DaemonSet não tem contagem de réplicas. O número de pods é exatamente o número de nós correspondentes que você tem, e ele muda sozinho conforme os nós entram e saem. DaemonSets são objetos com namespace, usam apiVersion: apps/v1, e um DaemonSet normalmente executa um tipo de agente em todos os seus nós.
Como os DaemonSets funcionam?
Dois elementos importantes explicam como um DaemonSet funciona: o controller do DaemonSet e o scheduler do Kubernetes. Vamos ver cada um:
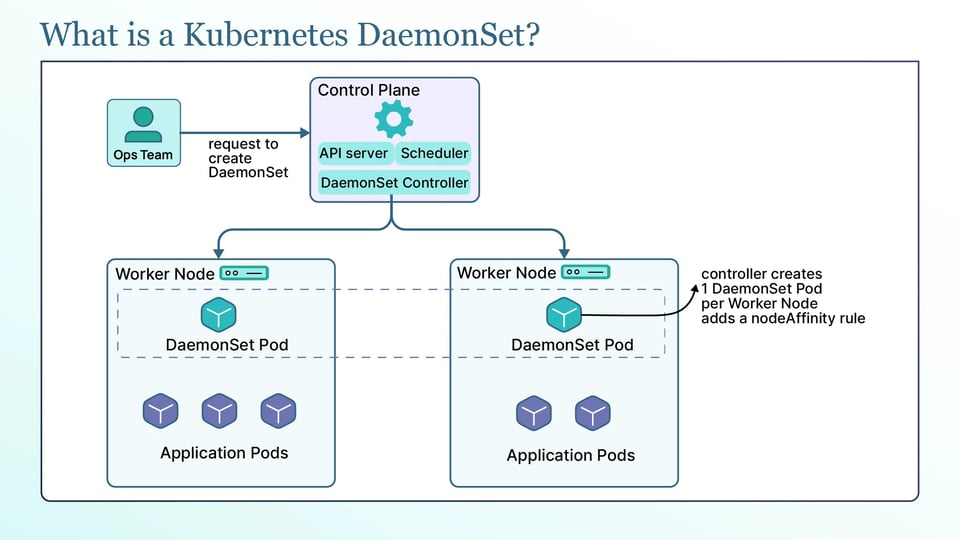
O controller do DaemonSet observa o cluster continuamente e mantém o estado real igual ao que você definiu. Quando um novo nó entra, o controller cria o pod do DaemonSet nesse nó. Quando um nó é removido, o pod que estava nele também é removido. E quando você exclui o DaemonSet, o Kubernetes remove todos os pods que ele criou. Você nunca diz quantos pods executar; ele calcula isso a partir do conjunto de nós correspondentes.
A forma como os pods de DaemonSet são agendados mudou ao longo do tempo. Desde o Kubernetes 1.12, os pods de DaemonSet são posicionados pelo scheduler padrão, kube-scheduler, como qualquer outro pod. O controller cria um pod por nó elegível e adiciona uma regra de nodeAffinity que fixa cada pod a um nó específico, e o scheduler então vincula o pod a esse nó. Como o scheduler normal cuida deles, os pods de DaemonSet respeitam taints, tolerations e prioridade de pods.
O Kubernetes também atribui automaticamente aos pods de DaemonSet um conjunto de tolerations, para que um agente de nó continue rodando quando o nó está sob estresse, cobrindo os taints de condição do nó, como not-ready, unreachable, disk-pressure, memory-pressure, pid-pressure, unschedulable e network-unavailable. Um taint que não é tolerado automaticamente é o taint de control-plane, e é por isso que pods de DaemonSet não são alocados em nós de control-plane, a menos que você mesmo adicione essa toleration.
Para que os DaemonSets são usados?
DaemonSets são usados para workloads que precisam rodar em todos os nós ou em um conjunto específico de nós, e não em um número fixo de réplicas. Os exemplos mais comuns são:
a. Agentes de coleta de logs: ferramentas como Fluentd e Fluent Bit rodam como DaemonSet para que haja um coletor em cada nó, lendo os logs de todos os pods daquele nó e enviando-os para um armazenamento central.
b. Agentes de monitoramento e métricas: exporters em nível de nó, como o node-exporter do Prometheus, e agentes de métricas de GPU, como o DCGM, rodam por nó para expor as métricas de hardware e de sistema operacional daquele nó.
c. Plugins CNI, proxies de serviço e outros pods de rede: os plugins de container network interface que fornecem rede aos pods, como Calico e Cilium, rodam como DaemonSets porque a rede precisa ser configurada em todos os nós. O próprio kube-proxy também roda dessa forma.
d. Agentes de armazenamento, segurança e hardware: plugins de nó CSI para armazenamento, agentes de segurança e conformidade, device plugins de GPU que expõem aceleradores aos pods e outros drivers de nó rodam como DaemonSets para que essa funcionalidade exista em cada nó que precisa dela.
DaemonSet comparado a outros tipos de workload do Kubernetes
Os DaemonSets resolvem um problema específico, então vale a pena ver como eles diferem dos tipos de workload que você talvez use por padrão. Vamos comparar:
Em comparação com um Deployment, a diferença está no posicionamento e na contagem. Um Deployment executa N réplicas e o scheduler decide em quais nós elas ficam, o que é ideal para apps sem estado em que não importa onde cada réplica roda. Um DaemonSet executa um pod por nó correspondente e escala junto com a quantidade de nós. A regra rápida: se a resposta para "quantas cópias?" for "uma em cada nó", você quer um DaemonSet; se for "N cópias, em qualquer lugar", você quer um Deployment.
Em comparação com um StatefulSet, a diferença está em identidade e armazenamento. Um StatefulSet dá aos seus pods nomes estáveis, rollout ordenado e volumes persistentes próprios, que é o que sistemas com estado, como bancos de dados, precisam. Um DaemonSet não oferece identidade ordenada nem armazenamento por pod; ele oferece cobertura de nós.
E em comparação com static pods, pods avulsos e contêineres sidecar, a diferença está em quem gerencia o pod e onde ele roda. Um static pod é gerenciado diretamente pelo kubelet em um único nó, não pelo API server, então é usado para inicializar componentes do control plane, e não para rodar um agente em vários nós.
Um pod avulso é um pod único sem nada que o mantenha vivo, então ele não é reagendado se o nó falhar. Um contêiner sidecar roda ao lado do seu app dentro do mesmo pod, uma vez por pod de aplicação, o que é a escolha certa quando o auxiliar pertence a um workload específico e não ao nó. Um DaemonSet é a ferramenta certa quando você quer exatamente uma cópia gerenciada por nó.
Anatomia de um manifesto de DaemonSet
Um manifesto de DaemonSet se parece muito com o de um Deployment, com algumas diferenças importantes. Aqui está um que executa um agente de logs Fluent Bit em todos os nós:
apiVersion: apps/v1kind: DaemonSetmetadata: name: fluent-bit namespace: loggingspec: selector: matchLabels: app: fluent-bit updateStrategy: type: RollingUpdate rollingUpdate: maxUnavailable: 1 template: metadata: labels: app: fluent-bit spec: containers: - name: fluent-bit image: fluent/fluent-bit:3.1 resources: requests: cpu: 50m memory: 64Mi limits: cpu: 200m memory: 128MiAlgumas regras importam aqui. Não existe o campo replicas, porque a quantidade de nós define o número de pods. O selector diz ao DaemonSet quais pods pertencem a ele, deve corresponder aos labels do template do pod e não pode ser alterado depois que o DaemonSet é criado. O restartPolicy do template do pod deve ser Always, que também é o padrão, porque um agente de nó deve rodar continuamente.
Agentes de nó também precisam de acesso ao próprio nó, o que eles obtêm por meio de algumas configurações do pod: hostNetwork: true coloca o pod na rede do nó, algo de que agentes de rede e de monitoramento dependem. Os volumes hostPath montam um diretório do nó, que coletores de logs usam para ler /var/log. E hostPID: true permite que o pod veja a árvore de processos do nó, algo de que alguns agentes de segurança e monitoramento precisam. Essas configurações são poderosas, então use-as apenas onde o agente realmente precisa delas.
Controlando quais nós executam os pods do DaemonSet
Por padrão, um DaemonSet roda em todos os nós elegíveis, mas muitas vezes você precisa limitá-lo a um conjunto específico de nós. Vamos ver.
Para limitá-lo a nós específicos, adicione um nodeSelector ou node affinity ao template do pod. Um nodeSelector seleciona nós por label, por exemplo, rodando um agente apenas em nós com o label disk=ssd. Node affinity faz o mesmo trabalho com regras mais expressivas, permitindo selecionar por regiões, tipos de instância ou combinações de labels quando uma simples correspondência de label não é suficiente.
Taints e tolerations controlam os casos mais difíceis; como os pods de DaemonSet passam pelo scheduler normal, os taints de um nó os mantêm de fora, a menos que o pod os tolere. É por isso que nós de control plane não recebem pods de DaemonSet por padrão: eles carregam o taint de control-plane, e você precisa adicionar uma toleration correspondente para rodar seu agente lá. Você pode tolerar todos os taints com uma única toleration genérica, mas raramente é isso que você quer, já que isso remove a proteção que os taints oferecem.
Para clusters mistos de Linux e Windows, use um nodeSelector com kubernetes.io/os para que agentes Linux rodem apenas em nós Linux e agentes Windows rodem apenas em nós Windows.
Como criar, atualizar e excluir um DaemonSet?
Você aplica um DaemonSet como qualquer outro objeto do Kubernetes:
kubectl apply -f fluent-bit.yamlkubectl get daemonset -n loggingkubectl rollout status daemonset/fluent-bit -n loggingA saída do get mostra as contagens desired, current, ready e available, que devem corresponder à sua quantidade de nós, e o rollout status confirma que o rollout terminou.
A forma como as atualizações acontecem é definida pela estratégia de atualização. O RollingUpdate, que é o padrão, substitui os pods gradualmente entre os nós quando você altera o template do pod. O OnDelete não faz rollout automaticamente; o controller só cria um novo pod com o template atualizado depois que você exclui o antigo manualmente, o que dá controle manual total para agentes sensíveis.
Em um rolling update, dois campos definem o ritmo. O maxUnavailable, cujo padrão é 1, define quantos nós podem ficar sem o pod ao mesmo tempo durante a atualização, então maxUnavailable: 1 atualiza um nó por vez. O maxSurge, cujo padrão é 0 e que se tornou estável no Kubernetes 1.25, permite que o controller inicie o novo pod em um nó antes de remover o antigo, proporcionando uma atualização sem downtime por nó.
Os dois não podem ser habilitados ao mesmo tempo: se você definir maxSurge com um valor diferente de zero, maxUnavailable deve ser 0, e observe que maxSurge não funciona com hostPort, porque dois pods não podem fazer bind na mesma porta do host. Você pode reverter uma atualização ruim da mesma forma que faria com um Deployment, com kubectl rollout undo daemonset/<name>. Para excluir um DaemonSet, use kubectl delete daemonset <name>. Isso remove o DaemonSet e todos os pods que ele gerencia.
Como escalar um DaemonSet para zero sem excluí-lo?
Um DaemonSet não tem campo replicas, então você não consegue escalá-lo para zero da maneira usual. O truque é dar a ele um nodeSelector que não corresponda a nenhum nó, o que mantém o DaemonSet no lugar, mas não agenda nenhum dos seus pods:
spec: template: spec: nodeSelector: non-existent-label: "true"Como nenhum nó tem esse label, o controller cria zero pods, mas o objeto DaemonSet e sua configuração permanecem. Para reativá-lo, remova o selector ou aplique o label aos nós desejados. Isso é útil para desabilitar temporariamente um agente em todo o cluster sem perder sua definição.
Como os DaemonSets afetam o custo do cluster e a capacidade dos nós?
Os DaemonSets podem aumentar os custos porque rodam em muitos ou em todos os nós de um cluster:
O ponto central é que os requests de recursos de um DaemonSet se multiplicam por todos os nós do cluster. Se um agente solicita 100m de CPU e 128Mi de memória, isso fica reservado em cada nó; em um cluster de 200 nós, isso reserva 20 CPUs e cerca de 25Gi de memória antes de qualquer workload seu rodar. Um request que parece minúsculo por nó vira capacidade real quando somado em toda a frota.
Essa capacidade reservada também reduz o que é agendável por nó, o que prejudica o bin-packing. Cada pod de DaemonSet ocupa uma fatia dos recursos alocáveis de cada nó; quanto mais DaemonSets você roda, menos espaço sobra para os pods de aplicação, e mais difícil fica empacotar os workloads de forma compacta. Isso influencia diretamente o autoscaling de nós. Tanto o Cluster Autoscaler quanto o Karpenter levam em conta o overhead dos DaemonSets ao dimensionar nós, e como esse overhead é por nó, nós maiores lidam com ele de forma mais eficiente: um custo fixo de DaemonSet representa uma parcela menor de um nó grande do que de um nó pequeno, o que é um fator real nas decisões de dimensionamento de nós.
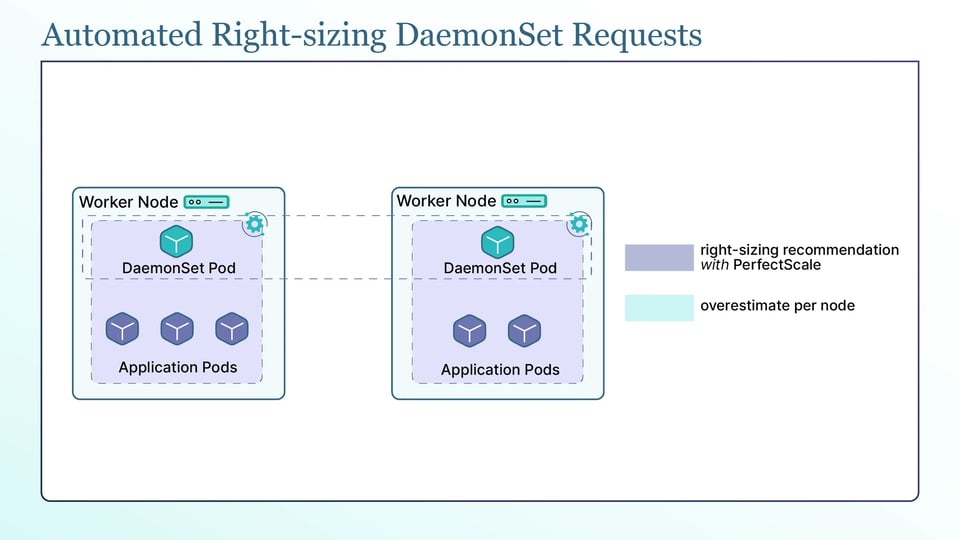
Como o custo é multiplicado, o right-sizing dos requests do DaemonSet importa mais do que em um único Deployment. Você precisa dimensionar os requests de cada agente a partir do uso real, e não de um padrão estimado, já que uma superestimativa de 50Mi em um agente vira 10Gi desperdiçados em 200 nós.
A PerfectScale foi criada exatamente para esse problema: sua plataforma de governança de Kubernetes observa como seus workloads, incluindo os agentes de DaemonSet, realmente usam CPU e memória e transforma isso em recomendações de right-sizing acionáveis e automatizadas, que você pode aplicar manualmente ou de forma autônoma, para que uma superestimativa por nó não se multiplique em um grande desperdício em todo o cluster. Equipes como Paramount Pictures e Creditas usam a PerfectScale para manter seus clusters eficientes, e você pode experimentar ou agendar uma sessão técnica.
Além dela, o Kubecost e o OpenCost, de código aberto, mostram os custos por workload para que você veja o que seus DaemonSets consomem, e o Goldilocks e o Vertical Pod Autoscaler em modo de recomendação sugerem valores de request com base no uso observado.
Mantendo os pods do DaemonSet em execução durante interrupções
Agentes de nó são workloads que você não quer perder, então é importante torná-los resilientes a interrupções. Vamos ver como:
Priority classes são a principal ferramenta para isso. Quando você atribui a um DaemonSet a priority class integrada system-node-critical, seus pods são marcados como críticos para o nó. O scheduler e o kubelet então os tratam como de alta prioridade, tornando-os menos propensos a sofrer eviction sob pressão de recursos. Isso é apropriado para componentes essenciais em nível de nó, como CNI e agentes de monitoramento.
Também é importante entender como os pods de DaemonSet se comportam durante interrupções comuns. Sob pressão no nó, o kubelet pode remover primeiro os pods de menor prioridade, e é por isso que a priority class crítica pode ajudar a proteger agentes importantes.
Durante um drain de nó, como antes de uma manutenção, os pods de DaemonSet são tratados de forma diferente dos pods comuns, porque estão vinculados ao nó. Durante um upgrade do cluster, os agentes de DaemonSet acompanham os nós, então verifique se a versão do agente é compatível com a nova versão do Kubernetes antes de atualizar.
Boas práticas de DaemonSet no Kubernetes
As boas práticas a seguir podem ajudar a manter os DaemonSets eficientes, confiáveis e seguros de operar:
a. Limite os DaemonSets a workloads genuinamente em nível de nó: como você já sabe, todo DaemonSet roda em todos os nós e multiplica seu custo; use um apenas quando o workload realmente precisar rodar por nó. Se um auxiliar pertence a um app específico, um contêiner sidecar é a melhor opção.
b. Defina requests e limits de recursos explícitos em cada agente: você nunca deve rodar um DaemonSet sem requests e limits. Dada a multiplicação em toda a frota, um agente sem limites ou superdimensionado desperdiça muito mais do que o mesmo erro em um único Deployment.
c. Restrinja as tolerations em vez de tolerar todos os taints: adicione apenas as tolerations de que o agente realmente precisa, como a toleration de control-plane para um agente que precisa rodar lá. Uma toleration genérica de "tolerar tudo" remove a proteção que o taint deveria oferecer.
d. Faça o rollout de atualizações com um maxUnavailable conservador: para agentes de nó críticos, atualize devagar, um ou poucos nós por vez, para que uma versão ruim do agente não quebre a rede ou o monitoramento de todo o cluster de uma vez. maxSurge: 1 com maxUnavailable: 0 proporciona uma atualização sem downtime por nó onde o agente oferecer suporte a isso.
e. Acompanhe numberUnavailable e a duração dos rollouts como sinais contínuos: você precisa monitorar quantos pods de DaemonSet estão indisponíveis e quanto tempo os rollouts levam. Uma contagem crescente de indisponíveis ou um rollout lento é um sinal precoce de que um agente está falhando em alguns nós.
f. Reavalie o footprint de recursos do DaemonSet sempre que o tamanho do cluster mudar: como o custo escala com a quantidade de nós, um footprint que era aceitável com 20 nós pode ser significativo com 300. Revise os requests de recursos conforme o cluster cresce, para que o uso de recursos dos DaemonSets não cresça demais.
Solucionando falhas comuns de DaemonSets
Estes são os dois tipos de problemas que aparecem com mais frequência, e cada um tem um ponto de partida claro:
a. Pods ausentes em nós específicos e rollouts travados: se um nó não tem o pod do DaemonSet, quase sempre é uma questão de agendamento: o nó tem um taint que o pod não tolera, ou o nodeSelector ou a affinity do pod o exclui. Execute kubectl describe node <node> para ver os taints e labels do nó, e kubectl describe pod em um pod de DaemonSet pendente para ver por que ele não é agendado. Um rollout travado geralmente tem as mesmas causas, ou um novo pod que não consegue ficar pronto, então verifique os eventos e os logs do novo pod.
b. Agentes com OOMKilled e throttling de CPU: agentes de DaemonSet costumam ser subdimensionados, então sofrem OOMKilled quando o limite de memória é baixo demais, ou throttling de CPU quando o limite de CPU é apertado demais, especialmente em nós ocupados com muitos pods para observar. Um agente com OOMKilled mostra OOMKilled e código de saída 137 no kubectl describe pod. O throttling de CPU aparece nas métricas de throttling de CPU, e não nos logs. A correção é definir os requests e limits do agente com base no uso real. Como esses recursos são necessários em todos os nós, é importante dimensioná-los com cuidado.