


Kubernetes DaemonSetは、クラスター内のすべてのノード、または指定した特定のノード群でPodのコピーを1つずつ実行することを保証するワークロードオブジェクトです。ノードがクラスターに参加すると、DaemonSetは自動的にそのノードにPodを追加します。ノードが離脱すると、Podも一緒に削除されます。ログコレクター、モニタリングエージェント、ネットワークプラグインといったノードレベルのエージェントを、各ノードへ手動でPodを配置することなく実行できるのは、この仕組みのおかげです。
本ガイドでは、DaemonSetの仕組み、用途、他のワークロードタイプとの比較、DaemonSetの書き方と制御方法、更新とスケーリングの方法、クラスターコストへの影響、そして知っておくべきベストプラクティスと障害について解説します。
Kubernetes DaemonSetとは?
DaemonSetは、固定数のレプリカではなく、ノードレベルのワークロードのために設計されています。スケジューリングルールに一致するすべてのノードにPodを1つずつ維持し、ノードの増減に応じてKubernetesが自動的にPod数を調整します。
これはDeploymentとは異なる目的です。Deploymentは指定した数のレプリカを実行し、スケジューラーがそれらをクラスター全体に分散配置します。DaemonSetにはレプリカ数がありません。Pod数は一致するノードの数によって決まり、ノードの増減に伴って自動的に変化します。DaemonSetはNamespaceに属するオブジェクトで、apiVersion: apps/v1を使用し、通常1つのDaemonSetは1種類のエージェントをノード全体で実行します。
DaemonSetの仕組み
DaemonSetの動作を理解するうえで重要な要素が2つあります。DaemonSetコントローラーとKubernetesスケジューラーです。順に見ていきましょう。
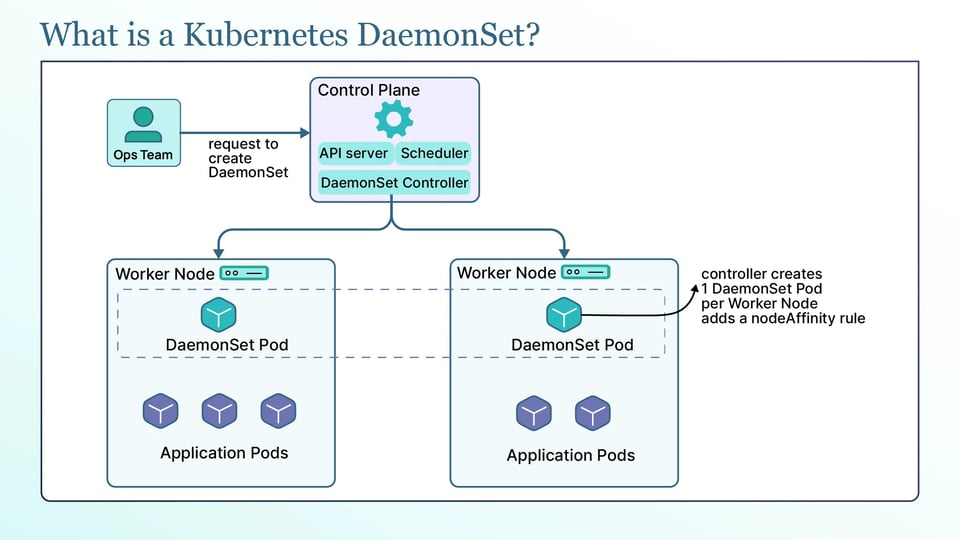
DaemonSetコントローラーはクラスターを継続的に監視し、実際の状態を定義した内容と一致させ続けます。新しいノードが参加すると、コントローラーはそのノードにDaemonSetのPodを作成します。ノードが削除されると、そのノード上のPodもクリーンアップされます。そしてDaemonSetを削除すると、Kubernetesは作成したすべてのPodを削除します。実行するPod数を指定する必要はなく、一致するノードの集合から自動的に導き出されます。
DaemonSet Podのスケジューリング方法は、バージョンを重ねる中で変化してきました。Kubernetes 1.12以降、DaemonSet Podは他のPodと同様にデフォルトスケジューラーであるkube-schedulerによって配置されます。コントローラーは対象ノードごとにPodを1つ作成し、各Podを特定のノードに固定するnodeAffinityルールを追加します。その後、スケジューラーがPodをそのノードにバインドします。通常のスケジューラーが処理するため、DaemonSet PodはTaint、Toleration、Podの優先度に従って動作します。
また、ノードに負荷がかかっている状況でもノードエージェントが動作し続けられるよう、KubernetesはDaemonSet Podに一連のTolerationを自動的に付与します。これはnot-ready、unreachable、disk-pressure、memory-pressure、pid-pressure、unschedulable、network-unavailableといったノード状態のTaintをカバーします。自動的に許容されないTaintの1つがコントロールプレーンのTaintであり、これが、自分でTolerationを追加しない限りDaemonSet Podがコントロールプレーンノードに配置されない理由です。
DaemonSetの用途
DaemonSetは、固定数のレプリカではなく、すべてのノードまたは特定のノード群で実行する必要のあるワークロードに使用されます。代表的な例は次のとおりです。
a. ログ収集エージェント:FluentdやFluent BitのようなツールはDaemonSetとして実行され、各ノードにコレクターを1つ配置します。そのノード上のすべてのPodのログを読み取り、中央のストアへ転送します。
b. モニタリング・メトリクスエージェント:Prometheus node-exporterのようなノードレベルのエクスポーターや、DCGMのようなGPUメトリクスエージェントはノードごとに実行され、そのノードのハードウェアとOSのメトリクスを公開します。
c. CNIプラグイン、サービスプロキシ、その他のネットワーク関連Pod:CalicoやCiliumなど、Podにネットワークを提供するコンテナネットワークインターフェースプラグインは、すべてのノードでネットワークを設定する必要があるためDaemonSetとして実行されます。kube-proxy自体もこの方式で動作します。
d. ストレージ、セキュリティ、ハードウェアエージェント:ストレージ用のCSIノードプラグイン、セキュリティ・コンプライアンスエージェント、アクセラレーターをPodに公開するGPUデバイスプラグイン、その他のノードドライバーはすべてDaemonSetとして実行され、必要とする各ノードでその機能を利用できるようにします。
DaemonSetと他のKubernetesワークロードタイプの比較
DaemonSetは特定の課題を解決するものなので、普段使うワークロードタイプとの違いを理解しておくと役立ちます。比較してみましょう。
Deploymentと比較すると、違いは配置と数にあります。DeploymentはN個のレプリカを実行し、どのノードに配置するかはスケジューラーが決めるため、各レプリカの実行場所を気にしないステートレスアプリに適しています。DaemonSetは一致するノードごとにPodを1つ実行し、ノード数に合わせてスケールします。簡単な判断基準として、「コピーは何個必要か?」に対する答えが「すべてのノードに1つ」ならDaemonSet、「N個をどこでも」ならDeploymentです。
StatefulSetと比較すると、違いはアイデンティティとストレージにあります。StatefulSetはPodに安定した名前、順序付きロールアウト、専用の永続ボリュームを提供します。これはデータベースのようなステートフルシステムに必要な機能です。DaemonSetは順序付きのアイデンティティもPodごとのストレージも提供しません。提供するのは、ノード全体のカバレッジです。
静的Pod、単体のPod、サイドカーコンテナと比較すると、違いはPodを管理する主体と実行場所にあります。静的PodはAPIサーバーではなく1つのノード上のkubeletが直接管理するため、複数ノードでエージェントを実行するのではなく、コントロールプレーンコンポーネントのブートストラップに使われます。
単体のPodはそれを維持する仕組みを持たない単独のPodであり、ノードに障害が発生しても再スケジュールされません。サイドカーコンテナは同じPod内でアプリと並んで動作し、アプリPodごとに1つ実行されます。ヘルパーがノードではなく特定のワークロードに属する場合はこちらが適切です。ノードごとに管理されたコピーをちょうど1つだけ実行したい場合こそ、DaemonSetの出番です。
DaemonSetマニフェストの構成
DaemonSetのマニフェストはDeploymentとよく似ていますが、いくつか重要な違いがあります。以下は、すべてのノードでFluent Bitログエージェントを実行する例です。
apiVersion: apps/v1kind: DaemonSetmetadata: name: fluent-bit namespace: loggingspec: selector: matchLabels: app: fluent-bit updateStrategy: type: RollingUpdate rollingUpdate: maxUnavailable: 1 template: metadata: labels: app: fluent-bit spec: containers: - name: fluent-bit image: fluent/fluent-bit:3.1 resources: requests: cpu: 50m memory: 64Mi limits: cpu: 200m memory: 128Miここではいくつかのルールが重要です。replicasフィールドは存在しません。Pod数はノード数によって決まるためです。selectorはDaemonSetが所有するPodを指定するもので、Podテンプレートのラベルと一致する必要があり、DaemonSet作成後に変更することはできません。PodテンプレートのrestartPolicyはAlways(これはデフォルト値でもあります)でなければなりません。ノードエージェントは継続的に動作することを前提としているためです。
ノードエージェントはノード自体へのアクセスも必要とし、いくつかのPod設定を通じてそれを実現します。hostNetwork: trueはPodをノードのネットワークに配置するもので、ネットワーク系やモニタリング系のエージェントが依存しています。hostPathボリュームはノードのディレクトリをマウントするもので、ログコレクターが/var/logを読み取るために使用します。そしてhostPID: trueはPodがノードのプロセスツリーを参照できるようにするもので、一部のセキュリティ・モニタリングエージェントに必要です。これらの設定は強力なので、エージェントが本当に必要とする場合にのみ使用してください。
DaemonSet Podを実行するノードの制御
デフォルトでは、DaemonSetは対象となるすべてのノードで実行されますが、特定のノード群に限定したい場合もよくあります。見ていきましょう。
特定のノードに限定するには、PodテンプレートにnodeSelectorまたはノードアフィニティを追加します。nodeSelectorはラベルでノードを照合します。たとえば、disk=ssdとラベル付けされたノードでのみエージェントを実行する、といった使い方です。ノードアフィニティはより表現力の高いルールで同じ役割を果たし、単純なラベル照合では不十分な場合に、リージョン、インスタンスタイプ、ラベルの組み合わせで照合できます。
TaintとTolerationは、より難しいケースを制御します。DaemonSet Podは通常のスケジューラーを経由するため、Podが許容しない限り、ノードのTaintによって配置が阻止されます。デフォルトでコントロールプレーンノードにDaemonSet Podが配置されないのはこのためです。これらのノードにはコントロールプレーンのTaintが付与されているため、そこでエージェントを実行するには対応するTolerationを追加する必要があります。包括的なTolerationを1つ設定すればすべてのTaintを許容できますが、Taintが提供する保護を無効化してしまうため、それが望ましいケースはほとんどありません。
LinuxとWindowsが混在するクラスターでは、kubernetes.io/osを使ったnodeSelectorを設定し、LinuxエージェントはLinuxノードのみ、WindowsエージェントはWindowsノードのみで実行されるようにします。
DaemonSetの作成・更新・削除の方法
DaemonSetは他のKubernetesオブジェクトと同様にapplyで適用します。
kubectl apply -f fluent-bit.yamlkubectl get daemonset -n loggingkubectl rollout status daemonset/fluent-bit -n logginggetの出力にはdesired、current、ready、availableの数が表示され、これらはノード数と一致しているはずです。rollout statusでロールアウトの完了を確認できます。
更新の挙動は更新戦略で決まります。デフォルトのRollingUpdateは、Podテンプレートを変更するとノード間で段階的にPodを置き換えます。OnDeleteは自動的にはロールアウトしません。古いPodを手動で削除した後にのみ、コントローラーが更新後のテンプレートで新しいPodを作成します。これにより、扱いに注意が必要なエージェントを完全に手動で制御できます。
ローリングアップデートでは、2つのフィールドがペースを決めます。maxUnavailable(デフォルトは1)は、更新中に同時にPodが存在しなくてもよいノード数で、maxUnavailable: 1なら1ノードずつ更新されます。maxSurge(デフォルトは0、Kubernetes 1.25で安定版になりました)は、古いPodを削除する前にそのノード上で新しいPodを起動できるようにし、ノード単位でダウンタイムゼロの更新を実現します。
この2つは同時に有効化できません。maxSurgeをゼロ以外の値に設定する場合、maxUnavailableは0でなければなりません。また、maxSurgeはhostPortと併用できない点にも注意してください。2つのPodが同じホストポートにバインドすることはできないためです。問題のある更新は、Deploymentと同じようにkubectl rollout undo daemonset/<name>でロールバックできます。DaemonSetを削除するにはkubectl delete daemonset <name>を使用します。これにより、DaemonSetと管理下のすべてのPodが削除されます。
DaemonSetを削除せずにゼロへスケールダウンする方法
DaemonSetにはreplicasフィールドがないため、通常の方法でゼロにスケールすることはできません。コツは、どのノードにも一致しないnodeSelectorを設定することです。これによりDaemonSetは残したまま、Podは1つもスケジュールされなくなります。
spec: template: spec: nodeSelector: non-existent-label: "true"そのラベルを持つノードは存在しないため、コントローラーはPodを1つも作成しませんが、DaemonSetオブジェクトとその設定は残ります。元に戻すには、セレクターを削除するか、対象ノードにそのラベルを付与します。定義を失うことなく、クラスター全体でエージェントを一時的に無効化したい場合に便利です。
DaemonSetがクラスターコストとノード容量に与える影響
DaemonSetはクラスター内の多数または全ノードで実行されるため、コストを増加させる可能性があります。
重要なポイントは、DaemonSetのリソースリクエストがクラスター内のすべてのノードに掛け算で効いてくることです。エージェントがCPU 100m、メモリ128Miをリクエストすると、それがすべてのノードで予約されます。つまり200ノードのクラスターでは、自分のワークロードを1つも実行しないうちに、20 CPUと約25Giのメモリが予約される計算です。ノード単位では小さく見えるリクエストも、フリート規模では無視できない容量になります。
この予約された容量は各ノードでスケジュール可能なリソースも減らすため、ビンパッキングの効率を悪化させます。すべてのDaemonSet Podは各ノードの割り当て可能リソースの一部を消費するため、DaemonSetを増やすほどアプリケーションPodのための余地が減り、ワークロードを高密度に詰め込むことが難しくなります。これはノードのオートスケーリングにも直結します。Cluster AutoscalerとKarpenterはどちらも、ノードのサイズを決定する際にDaemonSetのオーバーヘッドを考慮します。このオーバーヘッドはノード単位で発生するため、大きなノードのほうが効率的に処理できます。固定のDaemonSetコストは、小さなノードよりも大きなノードのほうが占める割合が小さくなるため、ノードサイズの決定における実質的な考慮要素となるのです。
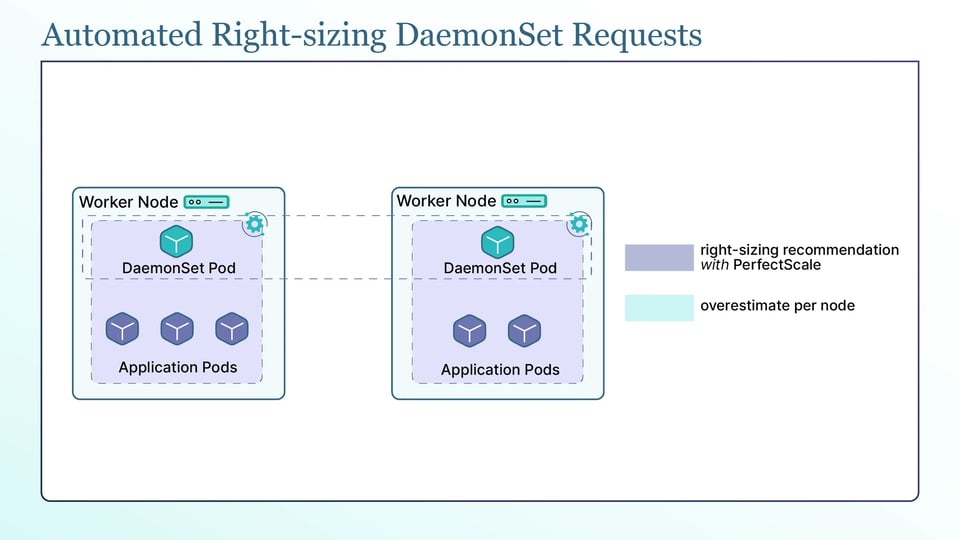
コストが掛け算で膨らむため、DaemonSetリクエストのライトサイジングは、単一のDeploymentの場合よりも重要になります。推測によるデフォルト値ではなく、実際の使用量に基づいて各エージェントのリクエストをサイジングする必要があります。1つのエージェントで50Miの過大見積もりがあれば、200ノードでは10Giの無駄になるからです。
PerfectScaleは、まさにこの課題のために作られています。PerfectScaleのKubernetesガバナンスプラットフォームは、DaemonSetエージェントを含むワークロードが実際にCPUとメモリをどのように使用しているかを監視し、手動でも自律的にも適用できる、実用的で自動化されたライトサイジングの推奨事項に変換します。これにより、ノード単位の過大見積もりがクラスター全体の大きな無駄に膨れ上がることを防ぎます。Paramount PicturesやCreditasといったチームがPerfectScaleを活用してクラスターを効率的に保っています。今すぐ試してみることも、テクニカルセッションを予約することもできます。
あわせて、KubecostやオープンソースのOpenCostはワークロード別のコストをレポートするため、DaemonSetの消費量を可視化できます。また、GoldilocksやレコメンダーモードのVertical Pod Autoscalerは、観測された使用量からリクエスト値を提案してくれます。
中断発生時にDaemonSet Podを動かし続ける
ノードエージェントは失いたくないワークロードなので、中断に対する耐性を持たせることが重要です。その方法を見ていきましょう。
優先度クラスがそのための主要なツールです。DaemonSetに組み込みのsystem-node-critical優先度クラスを割り当てると、そのPodはノードにとってクリティカルなものとしてマークされます。スケジューラーとkubeletはそれらを高優先度として扱うため、リソース逼迫時に退避されにくくなります。CNIやモニタリングエージェントなど、必須のノードレベルコンポーネントに適した設定です。
一般的な中断時にDaemonSet Podがどのように振る舞うかを理解することも重要です。ノードに負荷がかかると、kubeletは優先度の低いPodから先に退避させる可能性があります。重要なエージェントを保護するうえでクリティカルな優先度クラスが役立つのはこのためです。
メンテナンス前などのノードのドレイン時には、DaemonSet Podはノードに紐付いているため、通常のPodとは異なる扱いを受けます。クラスターのアップグレード時には、DaemonSetエージェントはノードと一緒に移行するため、アップグレード前にエージェントのバージョンが新しいKubernetesバージョンと互換性があることを確認してください。
Kubernetes DaemonSetのベストプラクティス
以下のベストプラクティスは、DaemonSetを効率的かつ信頼性高く、安全に運用するのに役立ちます。
a. DaemonSetは本当にノードレベルのワークロードに限定する:すべてのDaemonSetはすべてのノードで実行され、コストが掛け算で増えていきます。ワークロードが本当にノード単位での実行を必要とする場合にのみ使用してください。ヘルパーが特定のアプリに属する場合は、サイドカーコンテナのほうが適しています。
b. すべてのエージェントに明示的なリソースリクエストとリミットを設定する:リクエストとリミットなしでDaemonSetを実行してはいけません。フリート全体に掛け算で効くため、無制限あるいは過大なエージェントは、単一のDeploymentでの同じミスよりもはるかに大きな無駄を生みます。
c. すべてのTaintを許容するのではなく、Tolerationの範囲を絞る:コントロールプレーンで実行する必要があるエージェントに対するコントロールプレーンのTolerationなど、エージェントが実際に必要とするTolerationだけを追加してください。「すべてを許容する」包括的なTolerationは、Taintが提供するはずの保護を無効化してしまいます。
d. 控えめなmaxUnavailableで更新をロールアウトする:重要なノードエージェントは、1ノードまたは少数のノードずつゆっくり更新し、問題のあるエージェントバージョンがクラスター全体のネットワークやモニタリングを一度に壊さないようにします。エージェントが対応していれば、maxSurge: 1とmaxUnavailable: 0の組み合わせで、ノード単位のダウンタイムゼロ更新が可能です。
e. numberUnavailableとロールアウト所要時間を継続的なシグナルとして追跡する:利用不可のDaemonSet Podの数と、ロールアウトにかかる時間を監視する必要があります。利用不可数の増加やロールアウトの遅延は、一部のノードでエージェントが失敗している早期の兆候です。
f. クラスターサイズが変わるたびにDaemonSetのリソースフットプリントを再確認する:コストはノード数に比例して増えるため、20ノードでは問題なかったフットプリントも300ノードでは無視できなくなります。クラスターの成長に合わせてリソースリクエストを見直し、DaemonSetのリソース使用量が膨らみすぎないようにしましょう。
よくあるDaemonSet障害のトラブルシューティング
最も頻繁に発生する問題は次の2種類で、それぞれ明確な調査の出発点があります。
a. 特定のノードにPodが存在しない、ロールアウトが止まる:ノードにDaemonSet Podが存在しない場合、原因はほぼ必ずスケジューリングです。ノードにPodが許容しないTaintが付いているか、PodのnodeSelectorやアフィニティがそのノードを対象外にしています。kubectl describe node <node>でノードのTaintとラベルを確認し、PendingのDaemonSet Podに対してkubectl describe podを実行して、スケジュールされない理由を確認します。ロールアウトが止まる場合も、通常は同じ原因か、新しいPodがReadyになれないことが原因なので、イベントと新しいPodのログを確認してください。
b. OOMKilledされるエージェントとCPUスロットリング:DaemonSetエージェントはリソースが不足しがちで、メモリリミットが低すぎるとOOMKilledになり、CPUリミットが厳しすぎるとCPUスロットリングが発生します。監視対象のPodが多い高負荷なノードでは特に顕著です。OOMKilledされたエージェントは、kubectl describe podでOOMKilledと終了コード137を示します。CPUスロットリングはログではなく、CPUスロットリングのメトリクスに現れます。対処法は、実際の使用量に基づいてエージェントのリクエストとリミットを設定することです。これらのリソースはすべてのノードで必要になるため、慎重にサイジングすることが重要です。