


Ein Kubernetes DaemonSet ist ein Workload-Objekt, das sicherstellt, dass auf jedem Node Ihres Clusters – oder auf einer von Ihnen gewählten Gruppe von Nodes – eine Kopie eines Pods läuft. Tritt ein Node dem Cluster bei, platziert das DaemonSet seinen Pod automatisch auf diesem Node. Verlässt ein Node den Cluster, verschwindet der Pod mit ihm. Auf diese Weise betreiben Sie Node-Level-Agents wie Log-Collectors, Monitoring-Agents und Netzwerk-Plugins, ohne Pods manuell auf jedem einzelnen Node platzieren zu müssen.
In diesem Guide erfahren Sie, wie DaemonSets funktionieren, wofür sie eingesetzt werden, wie sie sich von anderen Workload-Typen unterscheiden, wie Sie ein DaemonSet schreiben und steuern, wie Sie es aktualisieren und skalieren, wie sie sich auf die Clusterkosten auswirken – und welche Best Practices und typischen Fehlerbilder Sie kennen sollten.
Was ist ein Kubernetes DaemonSet?
Ein DaemonSet ist für Node-Level-Workloads gedacht, nicht für eine feste Anzahl von Replicas. Es hält auf jedem Node, der seinen Scheduling-Regeln entspricht, genau einen Pod, und Kubernetes passt die Pod-Anzahl automatisch an, wenn sich diese Nodes ändern.
Das ist ein anderes Ziel als bei einem Deployment. Ein Deployment betreibt eine von Ihnen festgelegte Anzahl von Replicas und lässt den Scheduler diese im Cluster verteilen. Ein DaemonSet hat keine Replica-Anzahl. Die Zahl der Pods entspricht der Zahl der passenden Nodes und ändert sich von selbst, wenn Nodes hinzukommen oder wegfallen. DaemonSets sind Namespace-gebundene Objekte, verwenden apiVersion: apps/v1, und ein DaemonSet betreibt üblicherweise eine Art von Agent über alle Ihre Nodes hinweg.
Wie funktionieren DaemonSets?
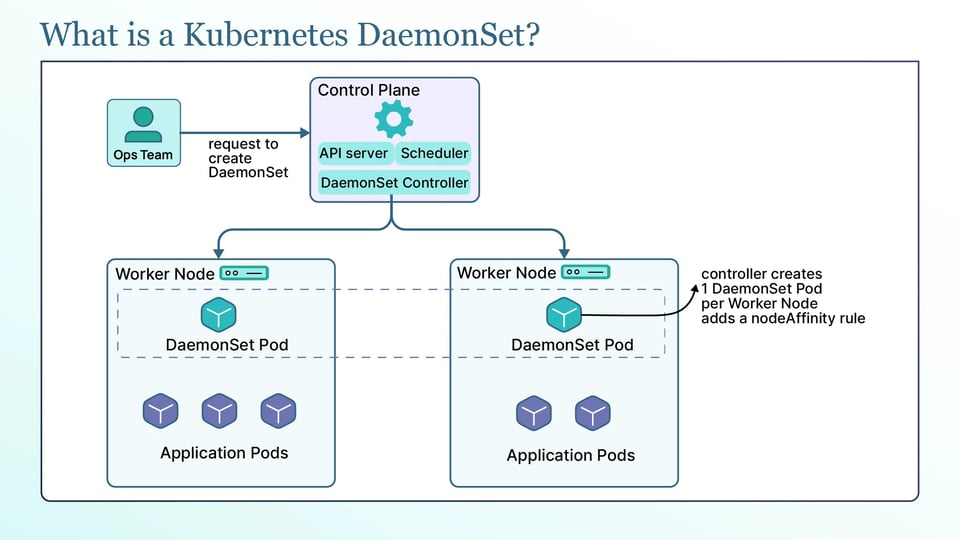
Zwei Komponenten erklären, wie ein DaemonSet funktioniert: der DaemonSet-Controller und der Kubernetes-Scheduler. Schauen wir sie uns an:
Der DaemonSet-Controller beobachtet das Cluster kontinuierlich und hält den Ist-Zustand mit Ihrer Definition synchron. Tritt ein neuer Node bei, erstellt der Controller den Pod des DaemonSets auf diesem Node. Wird ein Node entfernt, wird der Pod darauf aufgeräumt. Und wenn Sie das DaemonSet löschen, entfernt Kubernetes alle von ihm erstellten Pods. Sie geben nie an, wie viele Pods laufen sollen – die Anzahl ergibt sich aus der Menge der passenden Nodes.
Die Art, wie DaemonSet-Pods eingeplant werden, hat sich im Laufe der Zeit geändert. Seit Kubernetes 1.12 werden DaemonSet-Pods vom Standard-Scheduler kube-scheduler platziert – genau wie jeder andere Pod. Der Controller erstellt pro geeignetem Node einen Pod und fügt eine nodeAffinity-Regel hinzu, die jeden Pod an einen bestimmten Node bindet; der Scheduler bindet den Pod anschließend an diesen Node. Weil der reguläre Scheduler sie verarbeitet, respektieren DaemonSet-Pods Taints, Tolerations und Pod-Priorität.
Kubernetes gibt DaemonSet-Pods außerdem automatisch eine Reihe von Tolerations mit, damit ein Node-Agent auch dann weiterläuft, wenn ein Node unter Last steht. Abgedeckt sind die Node-Condition-Taints wie not-ready, unreachable, disk-pressure, memory-pressure, pid-pressure, unschedulable und network-unavailable. Ein Taint, der nicht automatisch toleriert wird, ist der Control-Plane-Taint – deshalb landen DaemonSet-Pods nur dann auf Control-Plane-Nodes, wenn Sie diese Toleration selbst hinzufügen.
Wofür werden DaemonSets eingesetzt?
DaemonSets werden für Workloads verwendet, die auf jedem Node oder auf einer bestimmten Gruppe von Nodes laufen müssen – nicht als feste Anzahl von Replicas. Die gängigen Beispiele:
a. Log-Collection-Agents: Tools wie Fluentd und Fluent Bit laufen als DaemonSet, sodass auf jedem Node ein Collector die Logs aller Pods dieses Nodes liest und an einen zentralen Speicher weiterleitet.
b. Monitoring- und Metrik-Agents: Node-Level-Exporter wie der Prometheus node-exporter sowie GPU-Metrik-Agents wie DCGM laufen pro Node, um dessen Hardware- und OS-Metriken bereitzustellen.
c. CNI-Plugins, Service-Proxies und andere Netzwerk-Pods: Die Container-Network-Interface-Plugins, die Pods das Networking bereitstellen – etwa Calico und Cilium –, laufen als DaemonSets, weil das Networking auf jedem Node eingerichtet werden muss. kube-proxy selbst läuft ebenfalls auf diese Weise.
d. Storage-, Security- und Hardware-Agents: CSI-Node-Plugins für Storage, Security- und Compliance-Agents, GPU-Device-Plugins, die Beschleuniger für Pods verfügbar machen, sowie andere Node-Treiber laufen alle als DaemonSets, damit die Funktionalität auf jedem Node vorhanden ist, der sie benötigt.
DaemonSet im Vergleich mit anderen Kubernetes-Workload-Typen
DaemonSets lösen ein spezifisches Problem – es hilft also zu sehen, wie sie sich von den Workload-Typen unterscheiden, die Sie standardmäßig einsetzen. Vergleichen wir:
Im Vergleich zu einem Deployment liegt der Unterschied in Platzierung und Anzahl. Ein Deployment betreibt N Replicas, und der Scheduler entscheidet, auf welchen Nodes sie landen – passend für zustandslose Apps, bei denen es egal ist, wo jede Replica läuft. Ein DaemonSet betreibt einen Pod pro passendem Node und skaliert mit der Node-Anzahl. Die Faustregel: Lautet die Antwort auf "Wie viele Kopien?" "eine auf jedem Node", brauchen Sie ein DaemonSet; lautet sie "N Kopien, egal wo", ein Deployment.
Im Vergleich zu einem StatefulSet liegt der Unterschied in Identität und Storage. Ein StatefulSet gibt seinen Pods stabile Namen, ein geordnetes Rollout und eigene Persistent Volumes – genau das, was zustandsbehaftete Systeme wie Datenbanken brauchen. Ein DaemonSet bietet weder geordnete Identität noch Storage pro Pod; es bietet Node-Abdeckung.
Und im Vergleich zu Static Pods, einzelnen Pods und Sidecar-Containern liegt der Unterschied darin, wer den Pod verwaltet und wo er läuft. Ein Static Pod wird direkt vom kubelet auf einem Node verwaltet, nicht vom API-Server, und dient daher dem Bootstrapping von Control-Plane-Komponenten – nicht dem Betrieb eines Agents über mehrere Nodes hinweg.
Ein einzelner Pod ohne Controller wird nicht neu eingeplant, wenn sein Node ausfällt. Ein Sidecar-Container läuft neben Ihrer App im selben Pod, einmal pro App-Pod – die richtige Wahl, wenn der Helfer zu einem bestimmten Workload gehört und nicht zum Node. Ein DaemonSet ist das Werkzeug der Wahl, wenn Sie genau eine verwaltete Kopie pro Node wollen.
Aufbau eines DaemonSet-Manifests
Ein DaemonSet-Manifest sieht einem Deployment sehr ähnlich – mit einigen wichtigen Unterschieden. Hier eines, das einen Fluent-Bit-Log-Agent auf jedem Node betreibt:
apiVersion: apps/v1kind: DaemonSetmetadata: name: fluent-bit namespace: loggingspec: selector: matchLabels: app: fluent-bit updateStrategy: type: RollingUpdate rollingUpdate: maxUnavailable: 1 template: metadata: labels: app: fluent-bit spec: containers: - name: fluent-bit image: fluent/fluent-bit:3.1 resources: requests: cpu: 50m memory: 64Mi limits: cpu: 200m memory: 128MiEinige Regeln sind hier wichtig. Es gibt kein replicas-Feld, weil die Node-Anzahl die Zahl der Pods bestimmt. Der selector legt fest, welche Pods dem DaemonSet gehören; er muss zu den Labels im Pod-Template passen und kann nach dem Erstellen des DaemonSets nicht mehr geändert werden. Die restartPolicy des Pod-Templates muss Always sein – das ist auch der Standard –, weil ein Node-Agent dauerhaft laufen soll.
Node-Agents brauchen zudem Zugriff auf den Node selbst, den sie über einige Pod-Einstellungen erhalten: hostNetwork: true bindet den Pod an das Netzwerk des Nodes, worauf Networking- und Monitoring-Agents angewiesen sind. hostPath-Volumes mounten ein Verzeichnis des Nodes, was Log-Collectors zum Lesen von /var/log nutzen. Und hostPID: true lässt den Pod den Prozessbaum des Nodes sehen, was manche Security- und Monitoring-Agents benötigen. Diese Einstellungen sind mächtig – nutzen Sie sie also nur dort, wo der Agent sie wirklich braucht.
Steuern, auf welchen Nodes DaemonSet-Pods laufen
Standardmäßig läuft ein DaemonSet auf jedem geeigneten Node, oft müssen Sie es aber auf eine bestimmte Gruppe von Nodes begrenzen. Schauen wir uns das an.
Um es auf bestimmte Nodes zu begrenzen, fügen Sie dem Pod-Template einen nodeSelector oder eine Node Affinity hinzu. Ein nodeSelector matcht Nodes anhand von Labels, etwa um einen Agent nur auf Nodes mit dem Label disk=ssd laufen zu lassen. Node Affinity erledigt dieselbe Aufgabe mit ausdrucksstärkeren Regeln und erlaubt Matches auf Regionen, Instance-Typen oder Label-Kombinationen, wenn ein einfacher Label-Match nicht ausreicht.
Taints und Tolerations steuern die schwierigeren Fälle: Weil DaemonSet-Pods den regulären Scheduler durchlaufen, halten die Taints eines Nodes sie fern, sofern der Pod sie nicht toleriert. Deshalb erhalten Control-Plane-Nodes standardmäßig keinen DaemonSet-Pod: Sie tragen den Control-Plane-Taint, und Sie müssen eine passende Toleration hinzufügen, um Ihren Agent dort laufen zu lassen. Sie können mit einer einzigen pauschalen Toleration jeden Taint tolerieren – das ist aber selten das, was Sie wollen, denn es hebt den Schutz auf, den Taints bieten.
Für gemischte Linux-Windows-Cluster verwenden Sie einen nodeSelector mit kubernetes.io/os, damit Linux-Agents nur auf Linux-Nodes und Windows-Agents nur auf Windows-Nodes laufen.
Wie erstellt, aktualisiert und löscht man ein DaemonSet?
Ein DaemonSet wenden Sie wie jedes andere Kubernetes-Objekt an:
kubectl apply -f fluent-bit.yamlkubectl get daemonset -n loggingkubectl rollout status daemonset/fluent-bit -n loggingDie get-Ausgabe zeigt die Werte für desired, current, ready und available, die Ihrer Node-Anzahl entsprechen sollten, und rollout status bestätigt, dass das Rollout abgeschlossen ist.
Wie Updates ablaufen, bestimmt die Update-Strategie. RollingUpdate, der Standard, ersetzt Pods schrittweise über die Nodes hinweg, wenn Sie das Pod-Template ändern. OnDelete rollt nicht automatisch aus; der Controller erstellt einen neuen Pod mit dem aktualisierten Template erst, nachdem Sie den alten manuell gelöscht haben – das gibt Ihnen volle manuelle Kontrolle für sensible Agents.
Bei einem Rolling Update bestimmen zwei Felder das Tempo. maxUnavailable (Standard: 1) legt fest, auf wie vielen Nodes der Pod während des Updates gleichzeitig fehlen darf; maxUnavailable: 1 aktualisiert also einen Node nach dem anderen. maxSurge (Standard: 0, stabil seit Kubernetes 1.25) erlaubt dem Controller, den neuen Pod auf einem Node zu starten, bevor der alte entfernt wird – ein Update ohne Ausfallzeit pro Node.
Beide können nicht gleichzeitig aktiv sein: Wenn Sie maxSurge auf einen Wert ungleich null setzen, muss maxUnavailable 0 sein. Beachten Sie außerdem, dass maxSurge nicht mit hostPort funktioniert, weil zwei Pods nicht denselben Host-Port binden können. Ein fehlerhaftes Update rollen Sie wie bei einem Deployment zurück, mit kubectl rollout undo daemonset/<name>. Zum Löschen eines DaemonSets verwenden Sie kubectl delete daemonset <name>. Das entfernt das DaemonSet und alle von ihm verwalteten Pods.
Wie skaliert man ein DaemonSet auf null, ohne es zu löschen?
Ein DaemonSet hat kein replicas-Feld, Sie können es also nicht auf dem üblichen Weg auf null skalieren. Der Trick: Geben Sie ihm einen nodeSelector, auf den kein Node passt – das DaemonSet bleibt bestehen, aber keiner seiner Pods wird eingeplant:
spec: template: spec: nodeSelector: non-existent-label: "true"Weil kein Node dieses Label trägt, erstellt der Controller null Pods, das DaemonSet-Objekt und seine Konfiguration bleiben aber erhalten. Um es wieder zu aktivieren, entfernen Sie den Selector oder setzen das Label auf die gewünschten Nodes. Das ist nützlich, um einen Agent clusterweit vorübergehend zu deaktivieren, ohne seine Definition zu verlieren.
Wie beeinflussen DaemonSets Clusterkosten und Node-Kapazität?
DaemonSets können die Kosten erhöhen, weil sie auf vielen oder allen Nodes eines Clusters laufen:
Der zentrale Punkt: Die Resource Requests eines DaemonSets multiplizieren sich über jeden Node im Cluster. Fordert ein Agent 100m CPU und 128Mi Speicher an, ist das auf jedem einzelnen Node reserviert – in einem Cluster mit 200 Nodes also 20 CPUs und rund 25Gi Speicher, bevor auch nur einer Ihrer Workloads läuft. Ein Request, der pro Node winzig wirkt, summiert sich über die gesamte Flotte zu echter Kapazität.
Diese reservierte Kapazität reduziert außerdem, was pro Node einplanbar ist, und verschlechtert das Bin-Packing. Jeder DaemonSet-Pod beansprucht einen Teil der allokierbaren Ressourcen jedes Nodes; je mehr DaemonSets Sie betreiben, desto weniger Platz bleibt für Anwendungs-Pods – und desto schwieriger wird es, Workloads dicht zu packen. Das wirkt sich direkt auf das Node-Autoscaling aus. Sowohl der Cluster Autoscaler als auch Karpenter berücksichtigen den DaemonSet-Overhead bei der Node-Dimensionierung – und weil dieser Overhead pro Node anfällt, gehen größere Nodes effizienter damit um: Fixe DaemonSet-Kosten machen an einem großen Node einen kleineren Anteil aus als an einem kleinen, was eine reale Größe bei Node-Sizing-Entscheidungen ist.
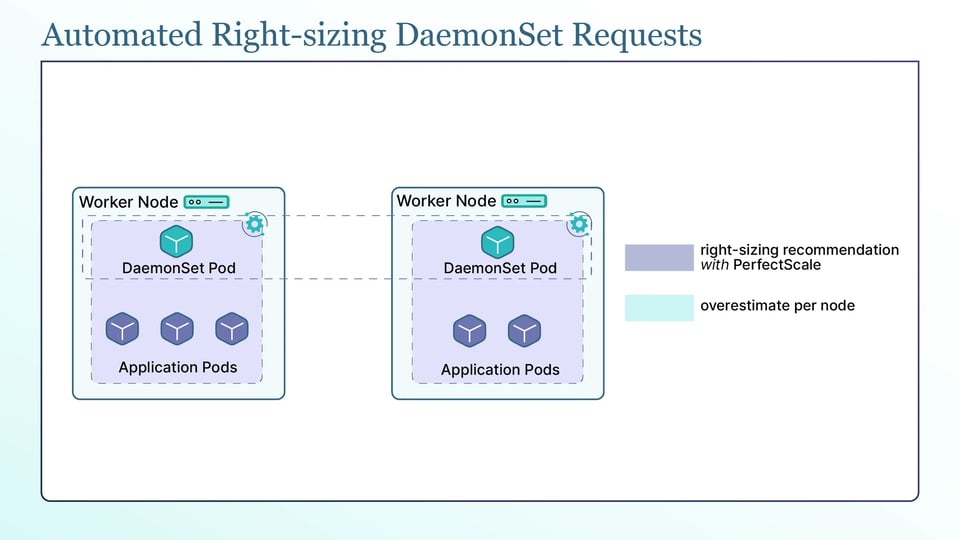
Weil sich die Kosten multiplizieren, ist Right-Sizing der DaemonSet-Requests wichtiger als bei einem einzelnen Deployment. Sie müssen die Requests jedes Agents anhand seiner tatsächlichen Nutzung dimensionieren statt anhand geratener Standardwerte – denn eine Überschätzung von 50Mi bei einem einzigen Agent wird über 200 Nodes zu 10Gi Verschwendung.
PerfectScale ist genau für dieses Problem gebaut: Die Kubernetes-Governance-Plattform beobachtet, wie Ihre Workloads – DaemonSet-Agents eingeschlossen – CPU und Speicher tatsächlich nutzen, und macht daraus umsetzbare, automatisierte Right-Sizing-Empfehlungen, die Sie manuell oder autonom anwenden können. So multipliziert sich eine Überschätzung pro Node nicht zu massiver clusterweiter Verschwendung. Teams wie Paramount Pictures und Creditas setzen auf PerfectScale, um ihre Cluster effizient zu halten – probieren Sie es aus oder buchen Sie eine technische Session.
Daneben zeigen Kubecost und das Open-Source-Tool OpenCost die Kosten pro Workload, sodass Sie sehen, was Ihre DaemonSets verbrauchen, und Goldilocks sowie der Vertical Pod Autoscaler im Recommender-Modus schlagen Request-Werte auf Basis der beobachteten Nutzung vor.
DaemonSet-Pods bei Störungen am Laufen halten
Node-Agents sind Workloads, die Sie nicht verlieren wollen – machen Sie sie daher widerstandsfähig gegen Störungen. So gehen Sie vor:
Priority Classes sind das wichtigste Werkzeug dafür. Weisen Sie einem DaemonSet die integrierte Priority Class system-node-critical zu, markiert diese seine Pods als kritisch für den Node. Scheduler und kubelet behandeln sie dann mit hoher Priorität, wodurch sie bei Ressourcenknappheit seltener verdrängt (evicted) werden. Das ist für essenzielle Node-Level-Komponenten wie CNI- und Monitoring-Agents angemessen.
Wichtig ist außerdem zu verstehen, wie sich DaemonSet-Pods bei typischen Störungen verhalten. Bei Node Pressure kann das kubelet Pods mit niedrigerer Priorität zuerst verdrängen – deshalb kann die kritische Priority Class helfen, wichtige Agents zu schützen.
Bei einem Node Drain, etwa vor Wartungsarbeiten, werden DaemonSet-Pods anders behandelt als reguläre Pods, weil sie an den Node gebunden sind. Bei einem Cluster-Upgrade ziehen DaemonSet-Agents mit den Nodes um – prüfen Sie also vor dem Upgrade, ob die Agent-Version mit der neuen Kubernetes-Version kompatibel ist.
Best Practices für Kubernetes DaemonSets
Die folgenden Best Practices helfen dabei, DaemonSets effizient, zuverlässig und sicher zu betreiben:
a. Begrenzen Sie DaemonSets auf echte Node-Level-Workloads: Jedes DaemonSet läuft auf jedem Node und multipliziert seine Kosten – setzen Sie eines nur ein, wenn der Workload wirklich pro Node laufen muss. Gehört ein Helfer zu einer bestimmten App, ist ein Sidecar-Container die bessere Wahl.
b. Setzen Sie bei jedem Agent explizite Resource Requests und Limits: Betreiben Sie ein DaemonSet nie ohne Requests und Limits. Durch die Multiplikation über die Flotte verschwendet ein unbegrenzter oder überdimensionierter Agent weit mehr als derselbe Fehler in einem einzelnen Deployment.
c. Halten Sie Tolerations eng gefasst, statt jeden Taint zu tolerieren: Fügen Sie nur die Tolerations hinzu, die ein Agent tatsächlich braucht – etwa die Control-Plane-Toleration für einen Agent, der dort laufen muss. Eine pauschale "Alles tolerieren"-Toleration hebt den Schutz auf, den der Taint bieten soll.
d. Rollen Sie Updates mit einem konservativen maxUnavailable aus: Aktualisieren Sie kritische Node-Agents langsam, einen oder wenige Nodes gleichzeitig, damit eine fehlerhafte Agent-Version nicht auf einen Schlag Networking oder Monitoring im gesamten Cluster lahmlegt. maxSurge: 1 mit maxUnavailable: 0 ermöglicht ein Update ohne Ausfallzeit pro Node, sofern der Agent das unterstützt.
e. Beobachten Sie numberUnavailable und die Rollout-Dauer als laufende Signale: Behalten Sie im Blick, wie viele DaemonSet-Pods nicht verfügbar sind und wie lange Rollouts dauern. Ein steigender Unavailable-Wert oder ein langsames Rollout ist ein frühes Zeichen dafür, dass ein Agent auf einigen Nodes fehlschlägt.
f. Prüfen Sie den Ressourcen-Fußabdruck des DaemonSets bei jeder Änderung der Clustergröße neu: Weil die Kosten mit der Node-Anzahl skalieren, kann ein Fußabdruck, der bei 20 Nodes unproblematisch war, bei 300 Nodes erheblich ins Gewicht fallen. Überprüfen Sie die Resource Requests, wenn das Cluster wächst, damit der Ressourcenverbrauch der DaemonSets nicht übermäßig zunimmt.
Troubleshooting typischer DaemonSet-Fehler
Die folgenden zwei Problemklassen treten am häufigsten auf – und für beide gibt es einen klaren Startpunkt:
a. Fehlende Pods auf bestimmten Nodes und hängende Rollouts: Hat ein Node keinen DaemonSet-Pod, liegt es fast immer am Scheduling: Der Node trägt einen Taint, den der Pod nicht toleriert, oder der nodeSelector bzw. die Affinity des Pods schließt ihn aus. Führen Sie kubectl describe node <node> aus, um Taints und Labels zu sehen, und kubectl describe pod auf einem DaemonSet-Pod im Status Pending, um zu sehen, warum er nicht eingeplant wird. Ein hängendes Rollout hat meist dieselben Ursachen – oder einen neuen Pod, der nicht ready wird; prüfen Sie daher die Events und die Logs des neuen Pods.
b. OOMKilled-Agents und CPU-Throttling: DaemonSet-Agents sind häufig zu knapp dimensioniert – sie werden OOMKilled, wenn ihr Memory-Limit zu niedrig ist, oder CPU-throttled, wenn ihr CPU-Limit zu eng gesetzt ist – vor allem auf stark ausgelasteten Nodes mit vielen zu überwachenden Pods. Ein OOMKilled-Agent zeigt OOMKilled und Exit-Code 137 in kubectl describe pod. CPU-Throttling zeigt sich in den CPU-Throttling-Metriken, nicht in den Logs. Die Lösung: Setzen Sie Requests und Limits des Agents auf Basis seiner tatsächlichen Nutzung. Weil diese Ressourcen auf jedem Node benötigt werden, ist eine sorgfältige Dimensionierung entscheidend.