


Un DaemonSet Kubernetes est un objet de workload qui garantit qu'une copie d'un pod s'exécute sur chaque nœud de votre cluster, ou sur un ensemble spécifique de nœuds de votre choix. Lorsqu'un nœud rejoint le cluster, le DaemonSet y ajoute automatiquement son pod. Lorsqu'un nœud quitte le cluster, le pod disparaît avec lui. C'est ainsi que vous exécutez des agents au niveau des nœuds, comme les collecteurs de logs, les agents de monitoring et les plugins réseau, sans avoir à placer manuellement un pod sur chaque nœud.
Dans ce guide, vous découvrirez comment fonctionnent les DaemonSets, à quoi ils servent, en quoi ils diffèrent des autres types de workloads, comment écrire et contrôler un DaemonSet, comment le mettre à jour et le faire évoluer, leur impact sur le coût du cluster, ainsi que les bonnes pratiques et les pannes à connaître.
Qu'est-ce qu'un DaemonSet Kubernetes ?
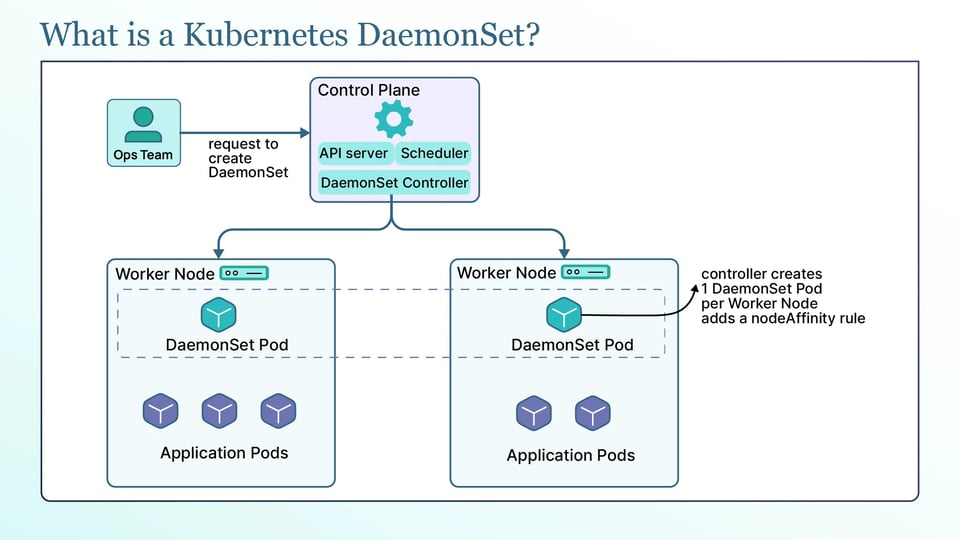
Un DaemonSet est conçu pour les workloads au niveau des nœuds plutôt que pour un nombre fixe de réplicas. Il maintient un pod sur chaque nœud correspondant à ses règles de scheduling, et Kubernetes ajuste automatiquement le nombre de pods à mesure que ces nœuds évoluent.
C'est un objectif différent de celui d'un Deployment. Un Deployment exécute le nombre de réplicas que vous choisissez et laisse le scheduler les répartir dans le cluster. Un DaemonSet n'a pas de nombre de réplicas. Le nombre de pods correspond au nombre de nœuds éligibles, et il évolue de lui-même au gré des arrivées et départs de nœuds. Les DaemonSets sont des objets namespacés utilisant apiVersion: apps/v1, et un DaemonSet exécute généralement un seul type d'agent sur l'ensemble de vos nœuds.
Comment fonctionnent les DaemonSets ?
Deux éléments essentiels expliquent le fonctionnement d'un DaemonSet : le contrôleur DaemonSet et le scheduler Kubernetes. Voyons cela de plus près :
Le contrôleur DaemonSet surveille en permanence le cluster et maintient l'état réel conforme à ce que vous avez défini. Lorsqu'un nouveau nœud rejoint le cluster, le contrôleur y crée le pod du DaemonSet. Lorsqu'un nœud est retiré, le pod qui s'y trouve est supprimé. Et lorsque vous supprimez le DaemonSet, Kubernetes supprime tous les pods qu'il a créés. Vous ne lui indiquez jamais combien de pods exécuter : il le déduit de l'ensemble des nœuds correspondants.
La façon dont les pods DaemonSet sont schedulés a évolué au fil du temps. Depuis Kubernetes 1.12, les pods DaemonSet sont placés par le scheduler par défaut, kube-scheduler, comme n'importe quel autre pod. Le contrôleur crée un pod par nœud éligible et ajoute une règle nodeAffinity qui épingle chaque pod à un nœud spécifique ; le scheduler lie ensuite le pod à ce nœud. Comme ils passent par le scheduler standard, les pods DaemonSet respectent les taints, les tolerations et la priorité des pods.
Kubernetes ajoute aussi automatiquement aux pods DaemonSet un ensemble de tolerations afin qu'un agent de nœud continue de fonctionner lorsque le nœud est sous pression, couvrant les taints liées à l'état du nœud comme not-ready, unreachable, disk-pressure, memory-pressure, pid-pressure, unschedulable et network-unavailable. Une taint qui n'est pas tolérée automatiquement est celle du control plane, ce qui explique pourquoi les pods DaemonSet n'atterrissent pas sur les nœuds du control plane, sauf si vous ajoutez vous-même cette toleration.
À quoi servent les DaemonSets ?
Les DaemonSets sont utilisés pour les workloads qui doivent s'exécuter sur chaque nœud ou sur un ensemble spécifique de nœuds, plutôt qu'avec un nombre fixe de réplicas. Les exemples courants :
a. Agents de collecte de logs : des outils comme Fluentd et Fluent Bit s'exécutent en DaemonSet afin qu'il y ait un collecteur sur chaque nœud, qui lit les logs de tous les pods du nœud et les envoie vers un stockage central.
b. Agents de monitoring et de métriques : les exporteurs au niveau nœud comme le node-exporter de Prometheus, et les agents de métriques GPU comme DCGM, s'exécutent par nœud pour exposer les métriques matérielles et système de ce nœud.
c. Plugins CNI, proxys de service et autres pods réseau : les plugins d'interface réseau de conteneurs qui fournissent le réseau aux pods, comme Calico et Cilium, s'exécutent en DaemonSets, car le réseau doit être configuré sur chaque nœud. kube-proxy fonctionne d'ailleurs de la même manière.
d. Agents de stockage, de sécurité et matériels : les plugins de nœud CSI pour le stockage, les agents de sécurité et de conformité, les device plugins GPU qui exposent les accélérateurs aux pods et les autres drivers de nœud s'exécutent tous en DaemonSets afin que la fonctionnalité soit présente sur chaque nœud qui en a besoin.
Le DaemonSet comparé aux autres types de workloads Kubernetes
Les DaemonSets résolvent un problème précis ; il est donc utile de voir en quoi ils diffèrent des types de workloads que vous utilisez peut-être par défaut. Comparons :
Par rapport à un Deployment, la différence tient au placement et au nombre. Un Deployment exécute N réplicas et le scheduler décide sur quels nœuds ils atterrissent, ce qui convient aux applications stateless où l'emplacement de chaque réplica importe peu. Un DaemonSet exécute un pod par nœud correspondant et évolue avec le nombre de nœuds. La règle simple : si la réponse à combien de copies ? est une sur chaque nœud, il vous faut un DaemonSet ; si c'est N copies, n'importe où, il vous faut un Deployment.
Par rapport à un StatefulSet, la différence tient à l'identité et au stockage. Un StatefulSet donne à ses pods des noms stables, un déploiement ordonné et leurs propres volumes persistants, ce dont ont besoin les systèmes stateful comme les bases de données. Un DaemonSet n'offre ni identité ordonnée ni stockage par pod ; il offre une couverture des nœuds.
Et par rapport aux pods statiques, aux pods isolés et aux conteneurs sidecar, la différence réside dans ce qui gère le pod et où il s'exécute. Un pod statique est géré directement par le kubelet sur un seul nœud, et non par l'API server ; il sert donc à amorcer les composants du control plane plutôt qu'à exécuter un agent sur plusieurs nœuds.
Un pod isolé est un pod seul, sans rien pour le maintenir en vie ; il n'est donc pas reschedulé si son nœud tombe en panne. Un conteneur sidecar s'exécute aux côtés de votre application dans le même pod, une fois par pod applicatif, ce qui est le bon choix lorsque l'auxiliaire appartient à un workload spécifique plutôt qu'au nœud. Le DaemonSet est l'outil à utiliser quand vous voulez exactement une copie gérée par nœud.
Anatomie d'un manifeste DaemonSet
Un manifeste DaemonSet ressemble beaucoup à celui d'un Deployment, avec quelques différences importantes. En voici un qui exécute un agent de logs Fluent Bit sur chaque nœud :
apiVersion: apps/v1kind: DaemonSetmetadata: name: fluent-bit namespace: loggingspec: selector: matchLabels: app: fluent-bit updateStrategy: type: RollingUpdate rollingUpdate: maxUnavailable: 1 template: metadata: labels: app: fluent-bit spec: containers: - name: fluent-bit image: fluent/fluent-bit:3.1 resources: requests: cpu: 50m memory: 64Mi limits: cpu: 200m memory: 128MiQuelques règles comptent ici. Il n'y a pas de champ replicas, car c'est le nombre de nœuds qui détermine le nombre de pods. Le selector indique au DaemonSet quels pods lui appartiennent ; il doit correspondre aux labels du template de pod et ne peut plus être modifié après la création du DaemonSet. Le restartPolicy du template de pod doit être Always, qui est aussi la valeur par défaut, car un agent de nœud est censé fonctionner en continu.
Les agents de nœud ont également besoin d'accéder au nœud lui-même, ce qu'ils obtiennent via quelques paramètres de pod : hostNetwork: true place le pod sur le réseau du nœud, dont dépendent les agents réseau et de monitoring. Les volumes hostPath montent un répertoire du nœud, utilisé par les collecteurs de logs pour lire /var/log. Et hostPID: true permet au pod de voir l'arborescence des processus du nœud, ce dont certains agents de sécurité et de monitoring ont besoin. Ces paramètres sont puissants : ne les utilisez que là où l'agent en a réellement besoin.
Contrôler quels nœuds exécutent les pods DaemonSet
Par défaut, un DaemonSet s'exécute sur chaque nœud éligible, mais vous devez souvent le limiter à un ensemble spécifique de nœuds. Voyons comment.
Pour le limiter à certains nœuds, ajoutez un nodeSelector ou une affinité de nœud au template de pod. Un nodeSelector sélectionne les nœuds par label, par exemple pour exécuter un agent uniquement sur les nœuds étiquetés disk=ssd. L'affinité de nœud remplit le même rôle avec des règles plus expressives, en permettant de cibler des régions, des types d'instances ou des combinaisons de labels lorsqu'une simple correspondance de label ne suffit pas.
Les taints et tolerations gèrent les cas plus délicats ; comme les pods DaemonSet passent par le scheduler standard, les taints d'un nœud les tiennent à l'écart, sauf si le pod les tolère. C'est pourquoi les nœuds du control plane ne reçoivent aucun pod DaemonSet par défaut : ils portent la taint du control plane, et vous devez ajouter une toleration correspondante pour y exécuter votre agent. Vous pouvez tolérer toutes les taints avec une seule toleration globale, mais c'est rarement souhaitable, car cela supprime la protection qu'offrent les taints.
Pour les clusters mixtes Linux et Windows, utilisez un nodeSelector avec kubernetes.io/os afin que les agents Linux s'exécutent uniquement sur les nœuds Linux et les agents Windows uniquement sur les nœuds Windows.
Comment créer, mettre à jour et supprimer un DaemonSet ?
Vous appliquez un DaemonSet comme n'importe quel autre objet Kubernetes :
kubectl apply -f fluent-bit.yamlkubectl get daemonset -n loggingkubectl rollout status daemonset/fluent-bit -n loggingLa sortie de get affiche les compteurs desired, current, ready et available, qui doivent correspondre à votre nombre de nœuds, et rollout status confirme que le déploiement est terminé.
Le déroulement des mises à jour est défini par la stratégie de mise à jour. RollingUpdate, la valeur par défaut, remplace les pods progressivement sur les nœuds lorsque vous modifiez le template de pod. OnDelete ne déploie rien automatiquement : le contrôleur ne crée un nouveau pod avec le template mis à jour qu'après suppression manuelle de l'ancien, ce qui vous donne un contrôle manuel total pour les agents sensibles.
Pour un rolling update, deux champs fixent le rythme. maxUnavailable, dont la valeur par défaut est 1, correspond au nombre de nœuds pouvant être privés du pod simultanément pendant la mise à jour ; ainsi, maxUnavailable: 1 met à jour un nœud à la fois. maxSurge, dont la valeur par défaut est 0 et qui est stable depuis Kubernetes 1.25, permet au contrôleur de démarrer le nouveau pod sur un nœud avant de retirer l'ancien, pour une mise à jour sans interruption sur chaque nœud.
Les deux ne peuvent pas être activés en même temps : si vous définissez maxSurge à une valeur non nulle, maxUnavailable doit être à 0, et notez que maxSurge ne fonctionne pas avec hostPort, car deux pods ne peuvent pas se lier au même port hôte. Vous pouvez annuler une mise à jour défectueuse comme pour un Deployment, avec kubectl rollout undo daemonset/<name>. Pour supprimer un DaemonSet, utilisez kubectl delete daemonset <name>. Cela supprime le DaemonSet et tous les pods qu'il gère.
Comment réduire un DaemonSet à zéro sans le supprimer ?
Un DaemonSet n'a pas de champ replicas, vous ne pouvez donc pas le ramener à zéro de la manière habituelle. L'astuce consiste à lui donner un nodeSelector qu'aucun nœud ne satisfait, ce qui laisse le DaemonSet en place sans scheduler aucun de ses pods :
spec: template: spec: nodeSelector: non-existent-label: "true"Comme aucun nœud ne porte ce label, le contrôleur crée zéro pod, mais l'objet DaemonSet et sa configuration subsistent. Pour le réactiver, retirez le selector ou appliquez le label aux nœuds voulus. C'est utile pour désactiver temporairement un agent dans tout le cluster sans perdre sa définition.
Impact des DaemonSets sur le coût du cluster et la capacité des nœuds
Les DaemonSets peuvent faire grimper les coûts, car ils s'exécutent sur de nombreux nœuds du cluster, voire sur tous :
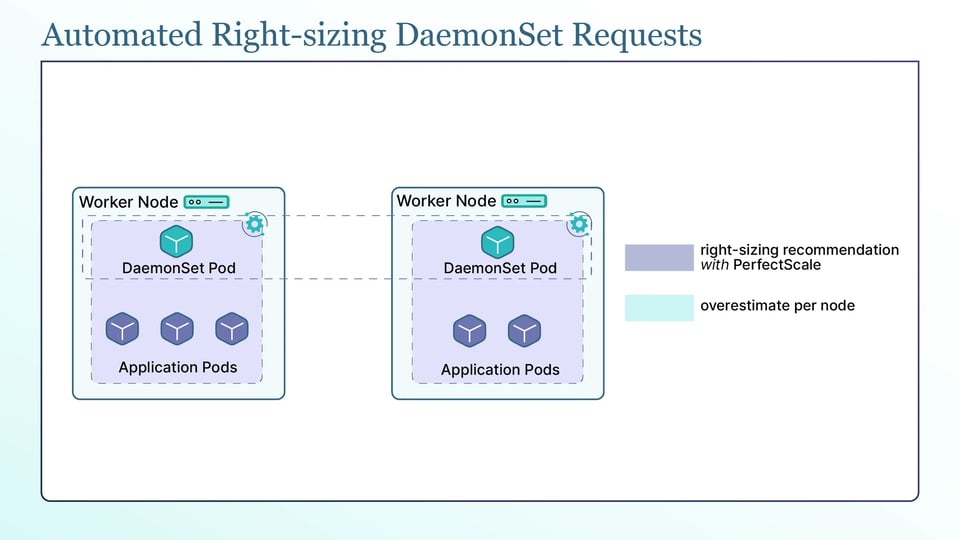
Le point clé : les requests de ressources d'un DaemonSet se multiplient sur chaque nœud du cluster. Si un agent demande 100m de CPU et 128Mi de mémoire, cette quantité est réservée sur chaque nœud ; sur un cluster de 200 nœuds, cela réserve 20 CPU et environ 25Gi de mémoire avant même que vos workloads ne s'exécutent. Une request qui paraît minuscule par nœud finit par représenter une capacité bien réelle à l'échelle du parc.
Cette capacité réservée réduit aussi ce qui reste schedulable sur chaque nœud, ce qui nuit au bin-packing. Chaque pod DaemonSet prélève une part des ressources allouables de chaque nœud : plus vous exécutez de DaemonSets, moins il reste de place pour les pods applicatifs, et plus il est difficile de densifier les workloads. Cela alimente directement l'autoscaling des nœuds. Le Cluster Autoscaler comme Karpenter tiennent compte de la surcharge des DaemonSets lorsqu'ils dimensionnent les nœuds, et comme cette surcharge s'applique par nœud, les nœuds plus grands la gèrent plus efficacement : un coût de DaemonSet fixe représente une part plus faible d'un grand nœud que d'un petit, ce qui pèse réellement dans les décisions de dimensionnement des nœuds.
Le coût étant multiplié, le right-sizing des requests d'un DaemonSet compte davantage que pour un Deployment isolé. Vous devez dimensionner les requests de chaque agent à partir de son usage réel plutôt que d'une valeur par défaut estimée : une surestimation de 50Mi sur un agent devient 10Gi gaspillés sur 200 nœuds.
PerfectScale est conçu exactement pour ce problème : sa plateforme de gouvernance Kubernetes observe comment vos workloads, agents DaemonSet compris, utilisent réellement le CPU et la mémoire, et en tire des recommandations de right-sizing concrètes et automatisées, à appliquer manuellement ou de façon autonome, afin qu'une surestimation par nœud ne se transforme pas en gaspillage massif à l'échelle du cluster. Des équipes comme Paramount Pictures et Creditas utilisent PerfectScale pour maintenir l'efficacité de leurs clusters ; vous pouvez l'essayer ou réserver une session technique.
En complément, Kubecost et l'outil open source OpenCost ventilent les coûts par workload pour visualiser ce que consomment vos DaemonSets, tandis que Goldilocks et le Vertical Pod Autoscaler en mode recommender suggèrent des valeurs de requests à partir de l'usage observé.
Maintenir les pods DaemonSet en fonctionnement pendant les perturbations
Les agents de nœud sont des workloads que vous ne voulez pas perdre ; il est donc important de les rendre résilients aux perturbations. Voyons comment :
Les priority classes sont l'outil principal. Lorsque vous assignez à un DaemonSet la priority class intégrée system-node-critical, ses pods sont marqués comme critiques pour le nœud. Le scheduler et le kubelet les traitent alors comme hautement prioritaires, ce qui réduit le risque d'éviction en cas de pression sur les ressources. C'est approprié pour les composants essentiels au niveau du nœud, comme les agents CNI et de monitoring.
Il est aussi important de comprendre le comportement des pods DaemonSet lors des perturbations courantes. En cas de pression sur le nœud, le kubelet peut évincer d'abord les pods de moindre priorité, d'où l'intérêt de la priority class critique pour protéger les agents importants.
Lors d'un drain de nœud, par exemple avant une maintenance, les pods DaemonSet sont traités différemment des pods classiques, car ils sont liés au nœud. Lors d'une mise à niveau du cluster, les agents DaemonSet suivent les nœuds ; vérifiez donc la compatibilité de la version de l'agent avec la nouvelle version de Kubernetes avant de procéder à la mise à niveau.
Bonnes pratiques pour les DaemonSets Kubernetes
Les bonnes pratiques suivantes aident à garder des DaemonSets efficaces, fiables et sûrs à exploiter :
a. Réservez les DaemonSets aux véritables workloads au niveau du nœud : chaque DaemonSet s'exécute sur chaque nœud et multiplie son coût ; n'en utilisez un que lorsque le workload doit réellement s'exécuter par nœud. Si un auxiliaire appartient à une application spécifique, un conteneur sidecar est mieux adapté.
b. Définissez des requests et limits explicites sur chaque agent : n'exécutez jamais un DaemonSet sans requests ni limits. Compte tenu de la multiplication à l'échelle du parc, un agent sans borne ou surdimensionné gaspille bien plus que la même erreur dans un Deployment isolé.
c. Limitez strictement les tolerations au lieu de tolérer toutes les taints : ajoutez uniquement les tolerations dont un agent a réellement besoin, comme la toleration du control plane pour un agent qui doit s'y exécuter. Une toleration globale tout tolérer supprime la protection que la taint est censée fournir.
d. Déployez les mises à jour avec un maxUnavailable prudent : pour les agents de nœud critiques, mettez à jour lentement, un ou quelques nœuds à la fois, afin qu'une version défectueuse de l'agent ne casse pas d'un coup le réseau ou le monitoring de tout le cluster. maxSurge: 1 avec maxUnavailable: 0 offre une mise à jour sans interruption par nœud lorsque l'agent le permet.
e. Suivez numberUnavailable et la durée des rollouts comme signaux continus : surveillez le nombre de pods DaemonSet indisponibles et la durée des déploiements. Un nombre d'indisponibles en hausse ou un rollout lent est un signe précoce qu'un agent échoue sur certains nœuds.
f. Réévaluez l'empreinte des DaemonSets à chaque changement de taille du cluster : le coût évoluant avec le nombre de nœuds, une empreinte acceptable à 20 nœuds peut devenir significative à 300. Revoyez les requests de ressources à mesure que le cluster grandit afin que la consommation des DaemonSets reste maîtrisée.
Résoudre les pannes courantes des DaemonSets
Voici les deux types de problèmes les plus fréquents, chacun avec un point de départ clair :
a. Pods absents sur certains nœuds et rollouts bloqués : si un nœud n'a pas de pod DaemonSet, c'est presque toujours une question de scheduling : le nœud porte une taint que le pod ne tolère pas, ou le nodeSelector ou l'affinité du pod l'exclut. Exécutez kubectl describe node <node> pour voir ses taints et labels, et kubectl describe pod sur un pod DaemonSet en attente pour comprendre pourquoi il ne se schedule pas. Un rollout bloqué remonte généralement aux mêmes causes, ou à un nouveau pod qui ne parvient pas à passer ready ; vérifiez donc les événements et les logs du nouveau pod.
b. Agents OOMKilled et throttling CPU : les agents DaemonSet sont souvent sous-provisionnés : ils se font OOMKilled quand leur limite mémoire est trop basse, ou subissent un throttling CPU quand leur limite CPU est trop serrée, surtout sur des nœuds chargés avec de nombreux pods à surveiller. Un agent OOMKilled affiche OOMKilled et le code de sortie 137 dans kubectl describe pod. Le throttling CPU apparaît dans les métriques de throttling CPU plutôt que dans les logs. La solution consiste à définir les requests et limits de l'agent en fonction de son usage réel. Ces ressources étant nécessaires sur chaque nœud, il est important de les dimensionner avec soin.