


El CPU throttling en Kubernetes ocurre cuando un contenedor alcanza su límite de CPU y el kernel de Linux lo frena en lugar de terminarlo. El contenedor se pausa durante períodos cortos, por lo que corre más lento de lo que podría. Lo confuso es que esto puede pasar mientras tus dashboards muestran que el pod usa muy poca CPU en promedio, y eso es lo que convierte al throttling en uno de los problemas de rendimiento más difíciles de diagnosticar.
En esta guía aprenderás qué es el CPU throttling, cómo funcionan los requests y limits de CPU, cómo el scheduler CFS de Linux aplica los límites de CPU, cómo afecta el throttling al rendimiento de las aplicaciones, cuáles son sus causas más comunes, cómo detectarlo y cómo solucionarlo.
¿Qué es el CPU throttling en Kubernetes?
El CPU throttling ocurre cuando un contenedor intenta usar más CPU de la que permite su límite configurado. El kernel de Linux le impide usar más CPU una vez que agota la cuota disponible para el período actual. A diferencia de la memoria, donde superar el límite puede hacer que el contenedor sea terminado, superar un límite de CPU por lo general ralentiza el contenedor en lugar de matarlo.
Lo importante es entender que el throttling se aplica en períodos cortos de CPU, por lo que puede no verse con claridad en los promedios de CPU que muestran la mayoría de los dashboards. Un pod puede parecer casi inactivo en un promedio de un minuto y aun así sufrir CPU throttling con frecuencia. Esa brecha entre lo que muestran tus métricas y lo que experimenta tu aplicación es una de las razones por las que el CPU throttling puede ser difícil de detectar.
¿Cómo funcionan los requests y limits de CPU en Kubernetes?
El CPU throttling en Kubernetes lo provocan los límites de CPU, así que conviene entender primero la diferencia entre requests y limits.
Un request de CPU es lo que el contenedor necesita para ser programado. El scheduler lo usa para encontrar un nodo con suficiente CPU libre y reserva esa cantidad para el pod. Internamente, un request se convierte en un CPU share (o weight, en cgroup v2), que decide cómo se reparte la CPU cuando varios contenedores compiten en un nodo saturado. Un request nunca causa throttling. Solo le garantiza al contenedor su parte justa cuando hay contención en el nodo.
Un límite de CPU es un tope estricto sobre cuánto tiempo de CPU puede usar el contenedor, y es lo que causa el throttling. El container runtime convierte el límite en una cuota de CFS, y una vez que el contenedor la consume, el kernel le aplica throttling. Así que los requests tienen que ver con la programación y el reparto justo, mientras que los limits establecen un tope, y solo el tope produce throttling.
resources: requests: cpu: 250m limits: cpu: "1"Cómo configures los requests y limits también determina la clase de Quality of Service (QoS) del pod, que Kubernetes usa cuando debe desalojar pods bajo presión en el nodo. Un pod es Guaranteed cuando cada contenedor tiene requests de CPU y memoria iguales a sus limits, Burstable cuando hay requests configurados pero por debajo de los limits, y BestEffort cuando no hay requests ni limits en absoluto. La QoS afecta principalmente el orden de desalojo, pero los pods Guaranteed con límites de CPU en números enteros también pueden obtener núcleos dedicados, algo que veremos más adelante como una forma de evitar el throttling.
¿Cómo aplica el scheduler CFS de Linux los límites de CPU?
El kernel aplica los límites de CPU con el Completely Fair Scheduler (CFS), y entender su modelo explica casi todos los casos de throttling. CFS trabaja en períodos que se repiten, y el período es de 100 milisegundos por defecto (cpu.cfs_period_us). Tu límite de CPU se convierte en una cuota de tiempo de CPU por período. Un límite de 500m le da al contenedor 50 ms de tiempo de CPU cada 100 ms, y un límite de 2 le da 200 ms cada 100 ms, ya que el trabajo puede ejecutarse en dos núcleos a la vez. Cuando el contenedor agota su cuota antes de que termine el período, el kernel lo frena y pausa todos los hilos del contenedor hasta que comienza el siguiente período, incluso si al nodo le sobra CPU inactiva.
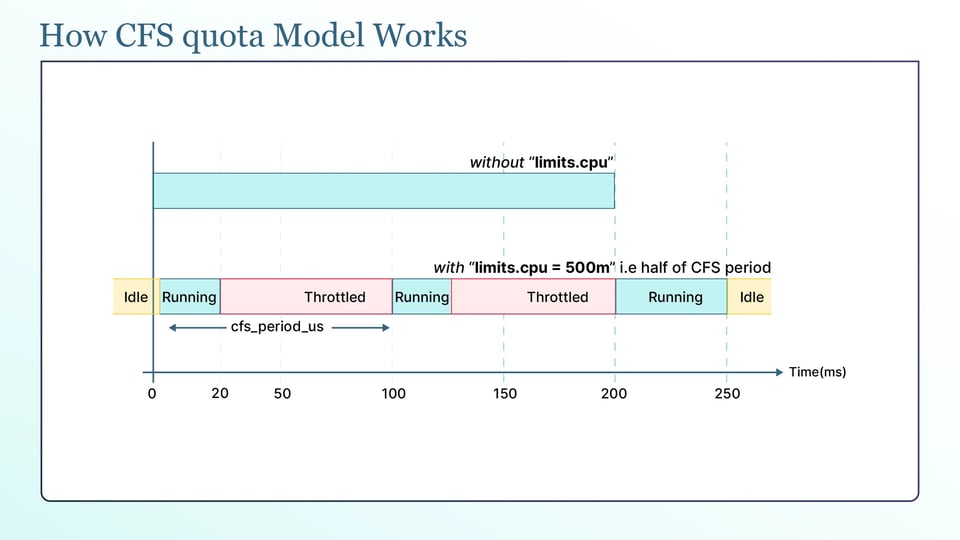
Por eso las aplicaciones multihilo sufren throttling antes de lo que la gente espera. Un contenedor con un límite de 2 y, digamos, diez hilos activos puede quemar sus 200 ms de cuota en los primeros 20 ms del período al ejecutar los diez hilos en diez núcleos a la vez. Todos quedan entonces pausados durante los 80 ms restantes. El uso promedio de CPU puede verse normal, mientras la aplicación experimenta ralentizaciones repetidas.
Dónde se almacena el límite depende de la versión de cgroup. En cgroup v1, los valores viven en cpu.cfs_period_us y cpu.cfs_quota_us. En cgroup v2, se combinan en un solo archivo, cpu.max, que registra la cuota y el período juntos. Hoy la mayoría de los clústeres usa cgroup v2, que es el valor por defecto desde Kubernetes 1.25 y en las distribuciones modernas de Linux.
Otro dato importante: durante años, el kernel de Linux tuvo un bug en la cuota de CFS por el cual la cuota no utilizada de un núcleo expiraba en lugar de reutilizarse, así que las aplicaciones con muchos hilos sufrían throttling incluso cuando usaban bastante menos que su límite. Este throttling fantasma se corrigió en el kernel 5.4 y se incorporó vía backport a la serie estable 4.19. Si todavía ves throttling intenso en workloads bien configurados, revisa la versión del kernel del nodo, porque un kernel muy antiguo puede ser la causa.
¿Cómo afecta el CPU throttling al rendimiento de tu aplicación?
El throttling es difícil de notar. Suele manifestarse de tres maneras:
a. La primera es la latencia de cola (tail latency), es decir, que las solicitudes más lentas tardan más de lo habitual. Cuando un contenedor sufre throttling, algunas solicitudes deben esperar tiempo de CPU antes de poder procesarse. Esto puede aumentar la latencia p99, incluso cuando el uso promedio de CPU se ve bajo. El resultado son respuestas lentas aun con un gráfico de CPU aparentemente tranquilo.
Diagrama 2 - "Promedio bajo, pero con throttling."
b. La segunda son las fallas de probes. Un contenedor con throttling puede ser demasiado lento para responder a tiempo su liveness o readiness probe, así que Kubernetes lo marca como no saludable y lo reinicia. El reinicio parece un crash, pero la causa real es que el contenedor no pudo obtener CPU cuando llegó el probe.
c. La tercera es el arranque lento. Las aplicaciones en JVM y Go suelen hacer trabajo intensivo de CPU al iniciar, como la compilación JIT o el precalentamiento de cachés. Un límite de CPU ajustado frena precisamente esta fase, así que el contenedor tarda mucho más en estar listo, lo que a su vez puede hacer fallar también el startup o readiness probe.
Causas comunes de CPU throttling en clústeres de Kubernetes
La mayoría de los problemas de CPU throttling proviene de las siguientes causas:
a. Límites de CPU demasiado cerca del pico de uso: si un límite es apenas mayor que lo que un contenedor necesita en sus picos normales, los picos breves de CPU pueden alcanzar el límite y provocar throttling. Un ejemplo común son los límites configurados hace meses con base en un uso anterior.
b. Runtimes que dimensionan sus thread pools según los núcleos del nodo y no según el límite del contenedor: históricamente, muchos runtimes de lenguajes contaban los núcleos de CPU del nodo, no el límite del contenedor, y creaban muchos más hilos de trabajo de los que el contenedor podía ejecutar. Un runtime en un nodo de 64 núcleos con un límite de 2 CPU podía iniciar decenas de hilos, quemar la cuota casi al instante y quedar frenado el resto de cada período. Las versiones de Go anteriores a 1.25 y las JVM más antiguas funcionaban así, usando GOMAXPROCS y la configuración ActiveProcessorCount de la JVM.
c. Sidecars y contenedores init que compiten por CPU: cada contenedor de un pod tiene su propio límite, pero comparten el nodo, y un sidecar ocupado, como un proxy de logging o de mesh, puede competir con el contenedor principal. Si sus límites se configuran sin considerar al otro, uno puede sufrir throttling mientras el otro se ejecuta.
d. Sobreasignación del nodo y vecinos ruidosos: Kubernetes permite que la suma de los límites de CPU de todos los contenedores de un nodo supere la capacidad real de CPU del nodo. Esto funciona cuando los workloads usan la CPU en momentos distintos. Sin embargo, si varios workloads se activan al mismo tiempo, o un vecino ruidoso consume demasiada CPU, el nodo puede sobrecargarse. Esto aumenta la contención de CPU y puede ralentizar los contenedores, incluso si no han alcanzado sus propios límites de CPU.
¿Cómo detectar el CPU throttling?
No puedes ver el throttling con kubectl top, que solo muestra el uso de CPU. Necesitas los contadores de throttling del kernel, y hay dos que importan.
container_cpu_cfs_periods_total es el número total de períodos de CFS por los que ha pasado el contenedor, y container_cpu_cfs_throttled_periods_total indica en cuántos de esos períodos sufrió throttling.
Un tercero, container_cpu_cfs_throttled_seconds_total, te dice el tiempo total transcurrido en throttling. Provienen del kubelet a través de cAdvisor, y los contadores en bruto también se pueden leer en el archivo cpu.stat del contenedor.
El número que hay que vigilar es el porcentaje de throttling, que se obtiene dividiendo los períodos con throttling entre el total de períodos. En PromQL:
rate(container_cpu_cfs_throttled_periods_total[5m]) / rate(container_cpu_cfs_periods_total[5m]) * 100Ponlo en un dashboard de Grafana por contenedor y configura una alerta para cuando se mantenga alto. Para un servicio sensible a la latencia, incluso un pequeño porcentaje de períodos con throttling basta para perjudicar el p99, así que un umbral de alerta de pocos puntos porcentuales es razonable. Los workloads batch toleran mucho más.
El throttling también afecta silenciosamente el autoescalado. El Horizontal Pod Autoscaler escala según la utilización de CPU, que es el uso frente al request. Cuando un contenedor sufre throttling, su uso queda acotado por su límite, así que el número que lee el HPA ya no refleja la demanda real. El resultado es que el HPA puede escalar en el momento equivocado o en la cantidad equivocada, otra razón para corregir el throttling en lugar de escalar para esquivarlo.
¿Cómo solucionar el CPU throttling en Kubernetes?
La solución correcta depende del workload. Estos son los enfoques más útiles:
a. Sube el límite de CPU, o elimínalo, y decide por workload: si un contenedor realmente necesita más CPU que su límite, súbelo para cubrir su pico real. Para servicios sensibles a la latencia, muchos equipos eliminan por completo el límite de CPU, ya que un contenedor sin límite no tiene cuota que agotar y no puede sufrir throttling, mientras que su request sigue garantizándole una parte justa. Conserva los límites donde necesites un comportamiento predecible y repetible, como en testing, y considera eliminarlos donde la latencia importa más.
b. Ajusta requests y limits con base en percentiles de uso observado: no adivines. Debes mirar el uso real del contenedor a lo largo del tiempo y dimensionar el request en torno a su uso típico y el límite en torno a su pico, usando el P95 o P99 en lugar del promedio, para que los picos normales no sufran throttling.
c. Redimensiona la CPU de pods en ejecución con el resize in-place: el redimensionamiento in-place de pods es GA desde Kubernetes 1.35, así que puedes cambiar el request y el límite de CPU de un contenedor en ejecución sin recrear el pod. Se hace a través del subrecurso resize del pod, y los cambios de CPU se aplican sin reinicio. Esto hace que corregir un workload con throttling sea mucho menos disruptivo que el antiguo método de borrar y recrear.
kubectl patch pod <name> --subresource resize --patch \ '{"spec":{"containers":[{"name":"app","resources":{"limits":{"cpu":"1"}}}]}}'d. Habilita CFS burst para absorber picos cortos: el CFS burst es una funcionalidad del kernel de Linux (kernel 5.14 y posteriores, en cgroup v2) que permite a un contenedor acumular cuota no utilizada y gastarla durante un pico breve, superando momentáneamente su límite sin subirlo de forma permanente. Encaja con workloads que sufren throttling por ráfagas breves y no por carga sostenida. Ten en cuenta que Kubernetes todavía no lo expone de forma nativa, así que se habilita configurando cpu.max.burst directamente en el cgroup o mediante una herramienta como Koordinator que lo configura desde una anotación del pod.
e. Fija núcleos con la política estática del CPU Manager para pods críticos en latencia: para pods que son a la vez intensivos en CPU y sensibles a la latencia, la política estática del CPU Manager del kubelet (--cpu-manager-policy=static) le da a un pod Guaranteed con un límite de CPU en número entero sus propios núcleos dedicados. El pod se ejecuta entonces en esos núcleos sin competir por tiempo de CPU, lo que evita el throttling de CFS para ese workload. La contrapartida es que los núcleos quedan reservados incluso cuando el pod está inactivo, así que úsala solo donde una latencia baja y consistente lo justifique.
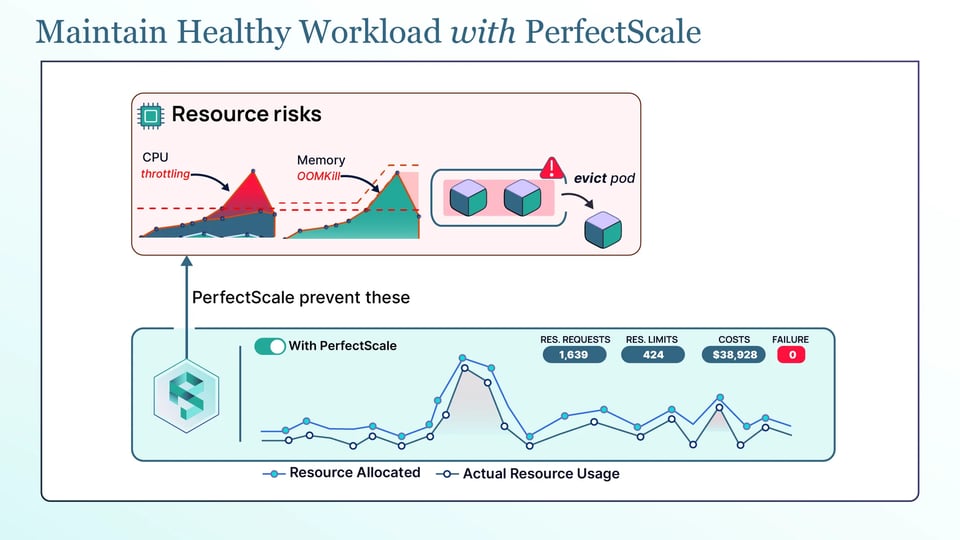
f. Automatiza el right-sizing continuo en lugar de ajustar a mano: el uso de CPU cambia con el tiempo, así que un límite que era correcto el trimestre pasado puede empezar a provocar throttling hoy. En lugar de revisar cpu.stat a mano, automatízalo. Aquí es donde PerfectScale ayuda: su plataforma de gobernanza de Kubernetes observa cómo tus workloads usan realmente la CPU y la memoria, junto con las señales de throttling, y lo convierte en recomendaciones de right-sizing accionables y automatizadas para requests y limits que puedes aplicar de forma manual o autónoma. Tus pods se mantienen dimensionados según lo que realmente necesitan, sin throttling y sin sobreaprovisionamiento. Equipos como Paramount Pictures y Creditas usan PerfectScale para mantener sus clústeres eficientes, y puedes probarlo o agendar una sesión técnica.
Buenas prácticas frente al CPU throttling en Kubernetes
Estas son las buenas prácticas que deberías seguir:
a. Configura siempre requests de CPU y trata los límites de CPU como opcionales: el request es lo que protege tu workload porque garantiza CPU y ubica bien el pod. Así que configúralo en todos los contenedores y decide los límites caso por caso en lugar de añadirlos por defecto.
b. Mantén los límites de CPU dentro de un múltiplo pequeño del request: cuando uses un límite, no lo pongas muy por encima del request, porque oculta la demanda real, ni justo en el request, porque frena ante cualquier pico. Un múltiplo pequeño por encima del request deja margen para las ráfagas normales.
c. Alinea la concurrencia de la aplicación con el límite de CPU del contenedor: tienes que hacer que el runtime conozca su límite para que no dimensione los thread pools según los núcleos del nodo. En Go 1.25 y posteriores, el runtime lee automáticamente el límite de CPU del contenedor. Java 11 y posteriores usa UseContainerSupport, mientras que otros runtimes pueden requerir configurar el número de hilos manualmente. Esto puede reducir el throttling en muchos workloads.
d. Aplica políticas de límites distintas a los workloads sensibles a la latencia y a los batch: tienen necesidades opuestas. Los servicios sensibles a la latencia se benefician de límites holgados o de no tener límite, para que nunca sufran throttling a mitad de una solicitud, mientras que los jobs batch pueden correr con límites firmes porque un poco de throttling solo hace que tarden más.
e. Escala horizontalmente sobre requests bien dimensionados en lugar de inflar límites: cuando un workload necesita más capacidad, agrega réplicas con base en requests de CPU precisos en lugar de simplemente aumentar el límite de CPU. Esto reparte el workload entre pods y le da al HPA una señal de utilización de CPU más útil.