


KubernetesのCPUスロットリングは、コンテナがCPUリミットに達した際に、Linuxカーネルがコンテナを強制終了する代わりに動作を遅くすることで発生します。コンテナは短い時間だけ一時停止されるため、本来の速度よりも遅く動作します。厄介なのは、ダッシュボード上ではPodの平均CPU使用率が非常に低く見えていても、この現象が起こり得ることです。これこそが、スロットリングを診断が難しいパフォーマンス問題のひとつにしている理由です。
本ガイドでは、CPUスロットリングとは何か、CPUリクエストとリミットの仕組み、Linux CFSスケジューラがCPUリミットを適用する仕組み、スロットリングがアプリケーションパフォーマンスに与える影響、よくある原因、検出方法、そして解決方法を解説します。
KubernetesのCPUスロットリングとは?
CPUスロットリングは、コンテナが設定されたリミットを超えてCPUを使用しようとしたときに発生します。現在の期間で利用可能なクォータに達すると、Linuxカーネルはそれ以上のCPU使用を制限します。メモリの場合はリミット超過によってコンテナが強制終了されることがありますが、CPUリミットの超過は基本的にコンテナを終了させるのではなく、動作を遅くします。
理解しておくべき重要な点は、スロットリングは短いCPU期間単位で適用されるため、多くのダッシュボードが表示する平均CPU値には明確に現れない可能性があるということです。1分間の平均ではほぼアイドル状態に見えるPodでも、頻繁にCPUスロットリングを受けていることがあります。メトリクスが示す値とアプリケーションが実際に体感している状況とのこのギャップこそが、CPUスロットリングの検出を難しくする要因のひとつです。
KubernetesにおけるCPUリクエストとリミットの仕組み
KubernetesのCPUスロットリングはCPUリミットによって引き起こされるため、まずリクエストとリミットの違いを理解しておくと役立ちます。
CPUリクエストは、コンテナがスケジュールされるために必要とする量です。スケジューラはこれを使って十分な空きCPUを持つノードを探し、その量をPodのために確保します。内部的には、リクエストはCPUシェア(cgroup v2ではウェイト)となり、負荷の高いノードで複数のコンテナが競合する際のCPU配分を決定します。リクエストがスロットリングを引き起こすことはありません。ノードで競合が発生したときに、コンテナに公平な取り分を保証するだけです。
CPUリミットは、コンテナが使用できるCPU時間の上限(ハードキャップ)であり、これがスロットリングの原因です。コンテナランタイムはリミットをCFSクォータに変換し、コンテナがそのクォータを使い切るとカーネルがスロットリングを行います。つまり、リクエストはスケジューリングと公平な分配のためのもの、リミットは上限を設けるためのものであり、スロットリングを引き起こすのは上限だけです。
resources: requests: cpu: 250m limits: cpu: "1"リクエストとリミットの設定方法は、PodのQuality of Service(QoS)クラスも決定します。QoSクラスは、ノードに負荷がかかった際にKubernetesがPodを退避させる順序を決めるために使われます。すべてのコンテナでCPUとメモリのリクエストがリミットと等しい場合はGuaranteed、リクエストが設定されているがリミットより低い場合はBurstable、リクエストもリミットも一切設定されていない場合はBestEffortになります。QoSは主に退避の順序に影響しますが、整数のCPUリミットを持つGuaranteed Podは専用コアを割り当てられることもあり、これは後述するスロットリング回避策のひとつです。
Linux CFSスケジューラはどのようにCPUリミットを適用するのか?
カーネルはCompletely Fair Scheduler(CFS)によってCPUリミットを適用しており、そのモデルを理解すれば、ほぼすべてのスロットリングのケースを説明できます。CFSは繰り返される期間(period)単位で動作し、期間はデフォルトで100ミリ秒です(cpu.cfs_period_us)。CPUリミットは、期間ごとのCPU時間クォータに変換されます。500mのリミットなら100msごとに50msのCPU時間が与えられ、2のリミットなら100msごとに200msが与えられます。処理は2つのコアで同時に実行できるためです。コンテナが期間の終わりを迎える前にクォータを使い切ると、カーネルはコンテナをスロットリングし、次の期間が始まるまでコンテナ内のすべてのスレッドを一時停止します。ノードにアイドル状態のCPUが残っていても例外ではありません。
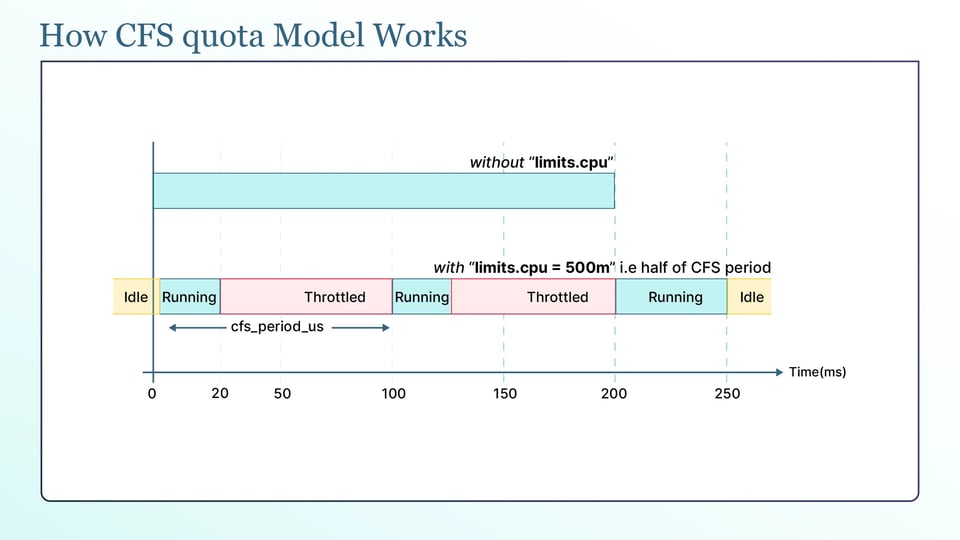
これが、マルチスレッドアプリケーションが予想より早くスロットリングされる理由です。リミットが2で、たとえば10個のビジースレッドを持つコンテナは、10個のスレッドを10コアで同時に実行することで、期間の最初の20msで200msのクォータを使い切ってしまいます。その後、残りの80msの間、すべてのスレッドが一時停止されます。平均CPU使用率は正常に見えても、アプリケーションは繰り返し遅延に見舞われるのです。
リミットが保存される場所はcgroupのバージョンによって異なります。cgroup v1では、値はcpu.cfs_period_usとcpu.cfs_quota_usに格納されます。cgroup v2ではcpu.maxという1つのファイルにまとめられ、クォータと期間が一緒に記述されます。cgroup v2はKubernetes 1.25以降および最新のLinuxディストリビューションでデフォルトとなっており、今日ではほとんどのクラスタで使われています。
もうひとつ知っておくべき重要な点があります。Linuxカーネルには長年、あるコアで未使用となったクォータが再利用されずに失効してしまうCFSクォータのバグが存在しており、スレッド数の多いアプリケーションはリミットを大きく下回る使用量でもスロットリングされていました。このファントムスロットリングはカーネル5.4で修正され、4.19の安定版シリーズにもバックポートされています。適切に設定されたワークロードで依然として激しいスロットリングが見られる場合は、ノードのカーネルバージョンを確認してください。非常に古いカーネルが原因である可能性があります。
CPUスロットリングはアプリケーションのパフォーマンスにどう影響するのか?
スロットリングは気づきにくいものです。通常、次の3つの形で現れます。
a. 1つ目はテールレイテンシです。つまり、最も遅いリクエストが通常より時間がかかるようになります。コンテナがスロットリングされると、一部のリクエストは処理される前にCPU時間を待たなければなりません。これにより、平均CPU使用率が低く見えていてもp99レイテンシが増加することがあります。結果として、CPUグラフは落ち着いて見えるのに、レスポンスは遅くなります。
図2 - 「平均は低いのに、スロットリングされている」
b. 2つ目はプローブの失敗です。スロットリングされたコンテナは、LivenessプローブやReadinessプローブに時間内に応答できないほど遅くなることがあり、Kubernetesはそれを異常と判断して再起動します。再起動はクラッシュのように見えますが、本当の原因は、プローブが届いたときにコンテナがCPUを確保できなかったことです。
c. 3つ目は起動の遅延です。JVMやGoのアプリケーションは、JITコンパイルやキャッシュのウォームアップなど、起動時にCPU負荷の高い処理を行うことがよくあります。厳しいCPUリミットはまさにこのフェーズをスロットリングするため、コンテナが準備完了になるまでの時間が大幅に延び、その結果、StartupプローブやReadinessプローブが失敗することにもつながります。
KubernetesクラスタにおけるCPUスロットリングのよくある原因
CPUスロットリングの問題のほとんどは、次の原因によるものです。
a. CPUリミットがピーク使用量に近すぎる:リミットが、通常のピーク時にコンテナが必要とする量よりわずかに高いだけの場合、短いCPUスパイクがリミットに達してスロットリングを引き起こすことがあります。数か月前の使用状況に基づいて設定されたリミットがそのまま残っているケースが典型例です。
b. ランタイムがコンテナのリミットではなくノードのコア数からスレッドプールのサイズを決める:多くの言語ランタイムは従来、コンテナのリミットではなくノードのCPUコア数を参照し、コンテナが実行を許可されている数をはるかに超えるワーカースレッドを作成していました。64コアのノード上で2 CPUのリミットを持つランタイムは、数十のスレッドを起動し、クォータをほぼ瞬時に使い果たし、毎期間の残り時間をスロットリングされたまま過ごすことになりかねません。1.25より前のGoや古いJVMはこのように動作しており、GOMAXPROCSやJVMのActiveProcessorCount設定が関係します。
c. サイドカーコンテナやInitコンテナによるCPUの奪い合い:Pod内の各コンテナはそれぞれリミットを持ちますが、ノードは共有しているため、ロギングやメッシュプロキシなど負荷の高いサイドカーはメインコンテナと競合することがあります。互いを考慮せずにリミットを設定すると、一方が実行されている間にもう一方がスロットリングされる可能性があります。
d. ノードのオーバーコミットとノイジーネイバー:Kubernetesでは、ノード上のすべてのコンテナのCPUリミットの合計が、ノードの実際のCPU容量を超えることが許されています。ワークロードが異なるタイミングでCPUを使う場合は問題なく機能します。しかし、複数のワークロードが同時に忙しくなったり、ノイジーネイバーが過剰にCPUを使用したりすると、ノードが過負荷になることがあります。その結果CPUの競合が増加し、コンテナが自身のCPUリミットに達していなくても遅くなる可能性があります。
CPUスロットリングの検出方法
kubectl topではスロットリングは確認できません。表示されるのはCPU使用量だけです。必要なのはカーネルのスロットルカウンタで、重要なものは2つあります。
container_cpu_cfs_periods_totalはコンテナが経過したCFS期間の合計数、container_cpu_cfs_throttled_periods_totalはそのうちスロットリングされた期間の数です。
3つ目のcontainer_cpu_cfs_throttled_seconds_totalは、スロットリングされた合計時間を示します。これらはcAdvisor経由でkubeletから取得され、生のカウンタはコンテナのcpu.statファイルからも読み取れます。
注視すべき数値はスロットル率、つまりスロットリングされた期間を全期間で割った値です。PromQLでは次のようになります。
rate(container_cpu_cfs_throttled_periods_total[5m]) / rate(container_cpu_cfs_periods_total[5m]) * 100これをコンテナごとにGrafanaのダッシュボードに表示し、高い状態が続いたらアラートを出すようにしましょう。レイテンシに敏感なサービスでは、スロットリングされた期間が数パーセントあるだけでp99に悪影響が出るため、アラートのしきい値は1桁台前半が妥当です。バッチ処理のワークロードは、それよりはるかに高い値でも許容できます。
スロットリングは、気づかないうちにオートスケーリングにも影響を及ぼします。Horizontal Pod AutoscalerはCPU使用率、つまりリクエストに対する使用量に基づいてスケールします。コンテナがスロットリングされると、使用量はリミットで頭打ちになるため、HPAが読み取る数値は実際の需要を反映しなくなります。その結果、HPAが誤ったタイミングや誤った量でスケールする可能性があり、これもスケールで回避するのではなくスロットリング自体を解消すべき理由のひとつです。
Kubernetes CPUスロットリングの解決方法
適切な解決方法はワークロードによって異なります。特に有効なアプローチを紹介します。
a. CPUリミットを引き上げる、または撤廃し、ワークロードごとに判断する:コンテナが本当にリミット以上のCPUを必要としている場合は、実際のピークをカバーできるようリミットを引き上げます。レイテンシに敏感なサービスでは、CPUリミットを完全に撤廃するチームも多くあります。リミットのないコンテナには使い切るクォータが存在しないためスロットリングされることがなく、リクエストによって公平な取り分は引き続き保証されるからです。テストなど予測可能で再現性のある挙動が必要な場面ではリミットを維持し、レイテンシが最も重要な場面では撤廃を検討してください。
b. 実測した使用量パーセンタイルに基づいてリクエストとリミットをライトサイジングする:推測で決めてはいけません。コンテナの実際の使用量を時系列で確認し、リクエストは平常時の使用量、リミットはピークに合わせてサイズを決めます。その際は平均値ではなくP95やP99を使い、通常のスパイクがスロットリングされないようにします。
c. In-place Pod Resizeで稼働中のPodのCPUをリサイズする:In-place Pod ResizeはKubernetes 1.35でGAとなり、Podを再作成せずに稼働中のコンテナのCPUリクエストとリミットを変更できます。Podのresizeサブリソースを通じて実行し、CPUの変更は再起動なしで適用されます。これにより、スロットリングされたワークロードの修正は、従来の削除・再作成に比べてはるかに影響の少ないものになります。
kubectl patch pod <name> --subresource resize --patch \ '{"spec":{"containers":[{"name":"app","resources":{"limits":{"cpu":"1"}}}]}}'d. CFSバーストを有効にして短いスパイクを吸収する:CFSバーストはLinuxカーネルの機能(カーネル5.14以降、cgroup v2)で、コンテナが未使用のクォータを蓄積し、短いスパイク時にそれを消費できるようにします。リミットを恒久的に引き上げることなく、一時的にリミットを超えられるのです。持続的な負荷ではなく短時間のバーストによってスロットリングされるワークロードに適しています。なお、Kubernetesはこの機能をまだネイティブには公開していないため、cgroupのcpu.max.burstを直接設定するか、Podアノテーションから設定できるKoordinatorのようなツールを使って有効化します。
e. レイテンシが極めて重要なPodにはCPU Managerのstaticポリシーでコアを固定する:CPU負荷が高く、かつレイテンシに敏感なPodには、kubeletのstatic CPU Managerポリシー(--cpu-manager-policy=static)を使うことで、整数のCPUリミットを持つGuaranteed Podに専用コアを割り当てられます。そのPodはCPU時間の奪い合いなしにそれらのコア上で動作するため、そのワークロードではCFSスロットリングを回避できます。トレードオフとして、Podがアイドル状態でもコアは予約されたままになるため、一貫した低レイテンシに見合う場面でのみ使用してください。
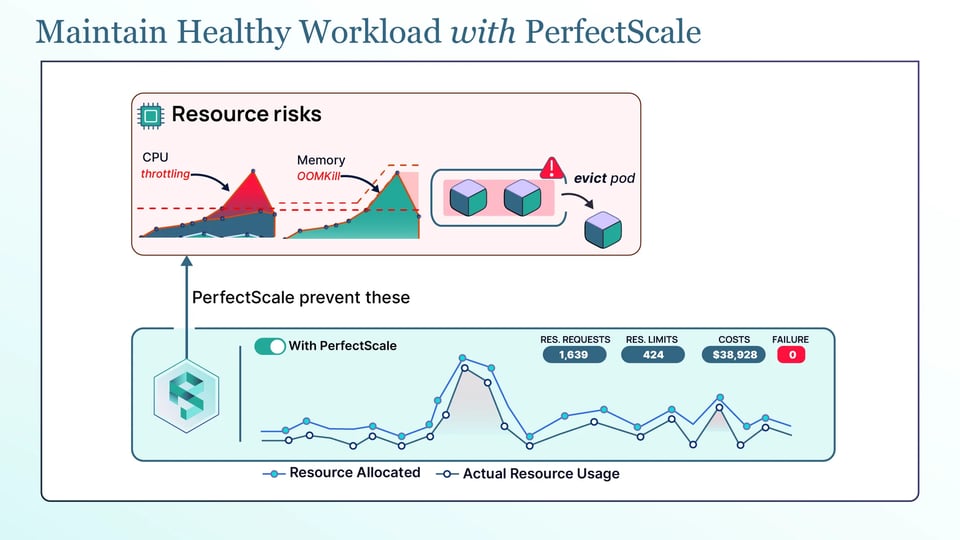
f. 手動チューニングではなく継続的なライトサイジングを自動化する:CPU使用量は時間とともに変化するため、前四半期には適切だったリミットが今日はスロットリングを引き起こすことがあります。cpu.statを手作業で何度も確認するのではなく、自動化しましょう。ここで役立つのがPerfectScaleです。そのKubernetesガバナンスプラットフォームは、ワークロードが実際にCPUとメモリをどう使っているかをスロットリングのシグナルとともに監視し、そこからリクエストとリミットに対する実行可能なライトサイジングの推奨を自動生成します。適用は手動でも自律的にも行えます。Podは本当に必要なサイズに保たれ、スロットリングも過剰プロビジョニングも発生しません。Paramount PicturesやCreditasといったチームがPerfectScaleを使ってクラスタを効率的に保っています。ぜひお試しいただくか、技術セッションをご予約ください。
Kubernetes CPUスロットリングのベストプラクティス
以下は従うべきベストプラクティスです。
a. CPUリクエストは常に設定し、CPUリミットは必須ではないと考える:リクエストはCPUを保証し、Podを適切に配置するため、ワークロードを守る役割を果たします。すべてのコンテナに設定し、リミットはデフォルトで付けるのではなくケースバイケースで判断しましょう。
b. CPUリミットはリクエストの数倍以内に抑える:リミットを使う場合、リクエストよりはるかに高く設定すると実際の需要が見えなくなり、リクエストちょうどに設定するとわずかなスパイクでもスロットリングされます。リクエストに少し余裕を持たせた程度の値にすることで、通常のバーストに対応できます。
c. アプリケーションの並行処理をコンテナのCPUリミットに合わせる:ランタイムがノードのコア数に基づいてスレッドプールのサイズを決めないよう、リミットを認識させる必要があります。Go 1.25以降では、ランタイムがコンテナのCPUリミットを自動的に読み取ります。Java 11以降はUseContainerSupportを使用し、その他のランタイムではスレッド数の手動設定が必要な場合があります。これにより、多くのワークロードでスロットリングを削減できます。
d. レイテンシに敏感なワークロードとバッチワークロードには異なるリミットポリシーを適用する:両者のニーズは正反対です。レイテンシに敏感なサービスは緩いリミットまたはリミットなしにすることで、リクエスト処理中にスロットリングされることがなくなります。一方、バッチジョブは多少のスロットリングで処理時間が延びるだけなので、厳格なリミットで運用できます。
e. リミットを水増しするのではなく、適切にサイジングされたリクエストに基づいて水平スケールする:ワークロードにより多くのキャパシティが必要な場合は、単にCPUリミットを引き上げるのではなく、正確なCPUリクエストに基づいてレプリカを追加します。これによりワークロードがPod間に分散され、HPAにはより有用なCPU使用率のシグナルが提供されます。