


Il CPU throttling in Kubernetes si verifica quando un container raggiunge il proprio limite di CPU e il kernel Linux lo rallenta invece di terminarlo. Il container viene messo in pausa per brevi intervalli di tempo e gira quindi più lentamente di quanto vorrebbe. L'aspetto che crea più confusione è che questo può accadere mentre le dashboard mostrano un utilizzo medio di CPU molto basso per il pod, ed è proprio questo a rendere il throttling uno dei problemi di performance più difficili da diagnosticare.
In questa guida vedremo cos'è il CPU throttling, come funzionano request e limiti di CPU, come lo scheduler CFS di Linux applica i limiti di CPU, in che modo il throttling incide sulle prestazioni delle applicazioni, quali sono le cause più comuni, come rilevarlo e come risolverlo.
Che cos'è il CPU throttling in Kubernetes?
Il CPU throttling si verifica quando un container tenta di usare più CPU di quanto consenta il limite configurato. Il kernel Linux impedisce al container di utilizzare ulteriore CPU una volta esaurita la quota disponibile per il periodo corrente. A differenza della memoria, dove il superamento del limite può causare la terminazione del container, superare un limite di CPU in genere rallenta il container invece di terminarlo.
La cosa importante da capire è che il throttling viene applicato su brevi periodi di CPU, quindi può non emergere chiaramente nei valori medi di CPU visualizzati dalla maggior parte delle dashboard. Un pod può sembrare quasi inattivo su una media di un minuto e subire comunque un CPU throttling frequente. Questo divario tra ciò che le metriche mostrano e ciò che l'applicazione subisce realmente è uno dei motivi per cui il CPU throttling può essere difficile da rilevare.
Come funzionano request e limiti di CPU in Kubernetes?
Il CPU throttling in Kubernetes è causato dai limiti di CPU, quindi è utile capire prima la differenza tra request e limiti.
Una request di CPU è ciò di cui il container ha bisogno per essere schedulato. Lo scheduler la usa per trovare un nodo con CPU libera a sufficienza e riserva quella quantità per il pod. Dietro le quinte, una request diventa una CPU share (o weight, in cgroup v2), che determina come la CPU viene suddivisa quando più container competono su un nodo sotto carico. Una request non causa mai throttling: garantisce soltanto al container la sua quota equa quando c'è contesa sul nodo.
Un limite di CPU è un tetto rigido al tempo di CPU che il container può usare, ed è ciò che causa il throttling. Il container runtime converte il limite in una quota CFS e, una volta che il container ha consumato quella quota, il kernel lo sottopone a throttling. In sintesi, le request riguardano lo scheduling e la condivisione equa, i limiti riguardano il tetto massimo, e solo il tetto provoca throttling.
resources: requests: cpu: 250m limits: cpu: "1"Il modo in cui si impostano request e limiti determina anche la classe di Quality of Service (QoS) del pod, che Kubernetes usa quando deve effettuare l'eviction dei pod in caso di pressione sul nodo. Un pod è Guaranteed quando ogni container ha request di CPU e memoria uguali ai limiti, Burstable quando le request sono impostate ma inferiori ai limiti, e BestEffort quando non sono impostati né request né limiti. La QoS incide principalmente sull'ordine di eviction, ma i pod Guaranteed con limiti di CPU a numero intero possono anche ottenere core dedicati, un aspetto che riprenderemo più avanti come modo per evitare il throttling.
Come applica i limiti di CPU lo scheduler CFS di Linux?
Il kernel applica i limiti di CPU tramite il Completely Fair Scheduler (CFS), e comprenderne il modello spiega quasi tutti i casi di throttling. Il CFS opera in periodi che si ripetono; il periodo predefinito è di 100 millisecondi (cpu.cfs_period_us). Il limite di CPU viene convertito in una quota di tempo CPU per periodo. Un limite di 500m dà al container 50 ms di tempo CPU ogni 100 ms, mentre un limite di 2 ne concede 200 ms ogni 100 ms, dato che il lavoro può essere eseguito su due core contemporaneamente. Quando il container esaurisce la quota prima della fine del periodo, il kernel lo mette in throttling, sospendendo ogni thread del container fino all'inizio del periodo successivo, anche se il nodo ha CPU inattiva a disposizione.
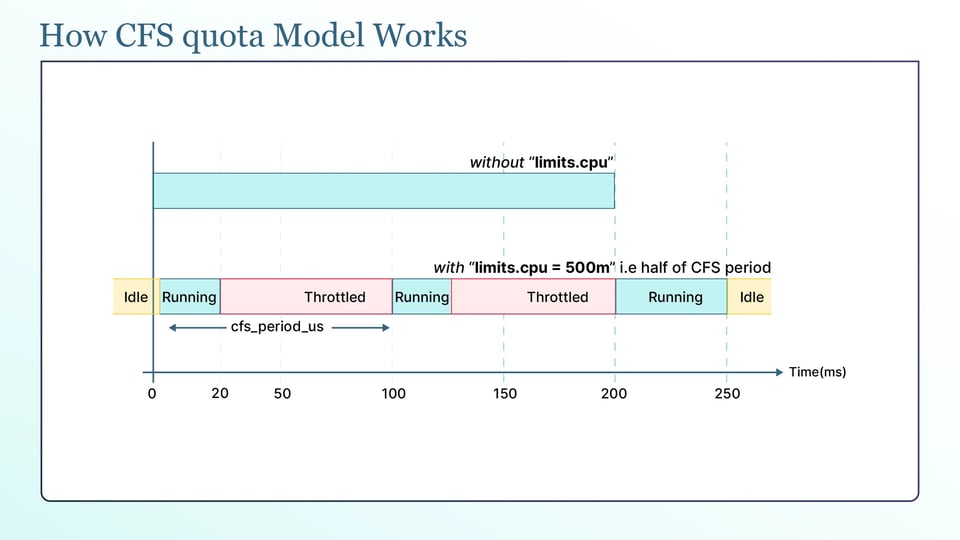
È per questo che le applicazioni multi-thread subiscono il throttling prima di quanto ci si aspetti. Un container con un limite di 2 e, ad esempio, dieci thread attivi può bruciare i suoi 200 ms di quota nei primi 20 ms del periodo eseguendo tutti e dieci i thread su dieci core contemporaneamente. Tutti vengono quindi sospesi per i restanti 80 ms. L'utilizzo medio della CPU può sembrare normale, mentre l'applicazione subisce rallentamenti ripetuti.
La posizione in cui il limite viene memorizzato dipende dalla versione di cgroup. In cgroup v1, i valori risiedono in cpu.cfs_period_us e cpu.cfs_quota_us. In cgroup v2 sono combinati in un unico file, cpu.max, che contiene quota e periodo insieme. Oggi la maggior parte dei cluster usa cgroup v2, che è il default da Kubernetes 1.25 e sulle distribuzioni Linux moderne.
Un'altra cosa importante da sapere è che per anni il kernel Linux ha avuto un bug della quota CFS per cui la quota inutilizzata di un core scadeva invece di essere riutilizzata, così le applicazioni con molti thread subivano throttling anche quando usavano ben meno del loro limite. Questo throttling fantasma è stato corretto nel kernel 5.4, e il fix è stato oggetto di backport nella serie stabile 4.19. Se si osserva ancora un throttling intenso su workloads ben configurati, conviene verificare la versione del kernel del nodo, perché un kernel molto vecchio può essere la causa.
Quali effetti ha il CPU throttling sulle prestazioni delle applicazioni?
Il throttling è difficile da notare. Di solito si manifesta in tre modi:
a. Il primo è la tail latency, ovvero il fatto che le richieste più lente impiegano più tempo del solito. Quando un container è in throttling, alcune richieste devono attendere tempo di CPU prima di poter essere elaborate. Questo può aumentare la latenza p99 anche quando l'utilizzo medio della CPU sembra basso. Il risultato sono risposte lente pur con un grafico della CPU apparentemente tranquillo.
Diagramma 2 - "Media bassa, throttling comunque presente."
b. Il secondo sono i fallimenti dei probe. Un container in throttling può essere troppo lento nel rispondere in tempo al proprio liveness o readiness probe, così Kubernetes lo contrassegna come non integro e lo riavvia. Il riavvio sembra un crash, ma la vera causa è che il container non ha potuto ottenere CPU quando è arrivato il probe.
c. Il terzo è l'avvio lento. Le applicazioni JVM e Go spesso eseguono operazioni intensive di CPU all'avvio, come la compilazione JIT o il warm-up delle cache. Un limite di CPU stringente mette in throttling proprio questa fase, così il container impiega molto più tempo a diventare pronto, il che può a sua volta far fallire anche lo startup o il readiness probe.
Cause comuni di CPU throttling nei cluster Kubernetes
La maggior parte dei problemi di CPU throttling deriva dalle seguenti cause:
a. Limiti di CPU impostati troppo vicini al picco di utilizzo: se un limite è solo leggermente superiore a quanto serve al container durante i picchi normali, brevi picchi di CPU possono raggiungere il limite e causare throttling. Un esempio frequente sono i limiti impostati mesi prima sulla base di un utilizzo ormai superato.
b. Runtime che dimensionano i thread pool sui core del nodo invece che sul limite del container: molti runtime di linguaggio storicamente contavano i core CPU del nodo, non il limite del container, e creavano molti più worker thread di quanti il container potesse eseguirne. Un runtime su un nodo a 64 core con un limite di 2 CPU potrebbe avviare decine di thread, bruciare la quota quasi istantaneamente e restare in throttling per il resto di ogni periodo. Le versioni di Go precedenti alla 1.25 e le JVM più datate funzionavano così, usando GOMAXPROCS e l'impostazione ActiveProcessorCount della JVM.
c. Sidecar e init container in competizione per la CPU: ogni container di un pod ha il proprio limite, ma tutti condividono il nodo, e un sidecar molto attivo, come un proxy di logging o di mesh, può competere con il container principale. Se i loro limiti vengono impostati senza tenere conto l'uno dell'altro, uno può finire in throttling mentre l'altro è in esecuzione.
d. Overcommitment del nodo e noisy neighbor: Kubernetes consente che la somma dei limiti di CPU di tutti i container su un nodo superi la capacità CPU effettiva del nodo. Funziona quando i workloads usano la CPU in momenti diversi. Tuttavia, se più workloads diventano attivi contemporaneamente, o un noisy neighbor usa troppa CPU, il nodo può sovraccaricarsi. Questo aumenta la contesa di CPU e può rallentare i container anche se non hanno raggiunto i propri limiti di CPU.
Come rilevare il CPU throttling?
Il throttling non è visibile con kubectl top, che mostra solo l'utilizzo di CPU. Servono i contatori di throttling del kernel, e ce ne sono due che contano davvero.
container_cpu_cfs_periods_total è il numero totale di periodi CFS attraversati dal container, mentre container_cpu_cfs_throttled_periods_total indica in quanti di quei periodi è stato in throttling.
Un terzo, container_cpu_cfs_throttled_seconds_total, indica il tempo totale trascorso in throttling. Questi dati provengono dal kubelet tramite cAdvisor, e i contatori grezzi sono leggibili anche nel file cpu.stat del container.
Il numero da tenere d'occhio è la percentuale di throttling, ovvero i periodi in throttling divisi per i periodi totali. In PromQL:
rate(container_cpu_cfs_throttled_periods_total[5m]) / rate(container_cpu_cfs_periods_total[5m]) * 100Questa query va inserita in una dashboard Grafana per ogni container, con un alert quando resta alta. Per un servizio sensibile alla latenza, bastano pochi punti percentuali di periodi in throttling per compromettere la p99, quindi una soglia di alert nell'ordine di poche unità percentuali è ragionevole. I workloads batch possono tollerarne molto di più.
Il throttling incide silenziosamente anche sull'autoscaling. L'Horizontal Pod Autoscaler scala in base all'utilizzo di CPU, ovvero l'uso rapportato alla request. Quando un container è in throttling, il suo utilizzo resta bloccato al limite, quindi il valore letto dall'HPA non riflette più la domanda reale. Il risultato è che l'HPA può scalare al momento sbagliato o nella misura sbagliata: un motivo in più per risolvere il throttling anziché aggirarlo scalando.
Come risolvere il CPU throttling in Kubernetes?
La soluzione giusta dipende dal workload. Ecco gli approcci più utili:
a. Aumentare il limite di CPU, o rimuoverlo, decidendo workload per workload: se un container ha davvero bisogno di più CPU rispetto al suo limite, conviene alzare il limite in modo da coprire il picco effettivo. Per i servizi sensibili alla latenza, molti team rimuovono del tutto il limite di CPU, dato che un container senza limite non ha alcuna quota da esaurire e non può subire throttling, mentre la sua request continua a garantirgli una quota equa. I limiti vanno mantenuti dove serve un comportamento prevedibile e ripetibile, ad esempio in fase di test, e vale la pena valutarne la rimozione dove la latenza conta di più.
b. Dimensionare correttamente request e limiti a partire dai percentili di utilizzo osservato: niente supposizioni. Bisogna analizzare l'utilizzo reale del container nel tempo e dimensionare la request sull'utilizzo tipico e il limite sul picco, usando il P95 o il P99 invece della media, così i picchi normali non finiscono in throttling.
c. Ridimensionare la CPU sui pod in esecuzione con l'in-place pod resize: l'in-place pod resize è GA da Kubernetes 1.35, quindi è possibile modificare request e limite di CPU di un container in esecuzione senza ricreare il pod. Si interviene tramite il subresource resize del pod, e le modifiche di CPU vengono applicate senza riavvio. Correggere un workload in throttling diventa così molto meno invasivo rispetto al vecchio approccio di eliminazione e ricreazione.
kubectl patch pod <name> --subresource resize --patch \ '{"spec":{"containers":[{"name":"app","resources":{"limits":{"cpu":"1"}}}]}}'d. Abilitare il CFS burst per assorbire i picchi brevi: il CFS burst è una funzionalità del kernel Linux (kernel 5.14 e successivi, su cgroup v2) che consente a un container di accumulare quota inutilizzata e spenderla durante un picco breve, superando temporaneamente il proprio limite senza alzarlo in modo permanente. È indicato per i workloads che subiscono throttling a causa di burst brevi anziché di carico sostenuto. Va tenuto presente che Kubernetes non lo espone ancora in modo nativo, quindi si abilita impostando cpu.max.burst direttamente sul cgroup oppure tramite uno strumento come Koordinator che lo imposta a partire da un'annotazione del pod.
e. Assegnare core dedicati con la policy static del CPU Manager per i pod in cui la latenza è critica: per i pod che sono al tempo stesso ad alto consumo di CPU e sensibili alla latenza, la policy static del CPU Manager del kubelet (--cpu-manager-policy=static) assegna core dedicati a uso esclusivo a un pod Guaranteed con un limite di CPU a numero intero. Il pod viene quindi eseguito su quei core senza competere per il tempo di CPU, evitando il throttling CFS per quel workload. Il compromesso è che i core restano riservati anche quando il pod è inattivo, quindi va usata solo dove una latenza bassa e costante lo giustifica.
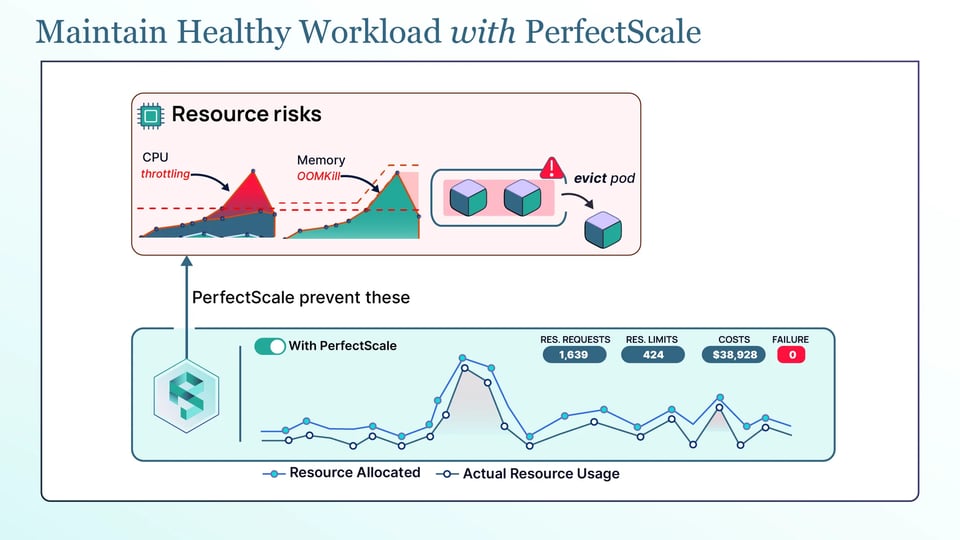
f. Automatizzare il right-sizing continuo invece di intervenire manualmente: l'utilizzo di CPU cambia nel tempo, quindi un limite corretto nell'ultimo trimestre può iniziare a causare throttling oggi. Invece di ricontrollare cpu.stat a mano, conviene automatizzare. È qui che PerfectScale entra in gioco: la sua piattaforma di governance per Kubernetes osserva come i workloads utilizzano realmente CPU e memoria, insieme ai segnali di throttling, e trasforma questi dati in raccomandazioni di right-sizing concrete e automatizzate per request e limiti, applicabili manualmente o in modo autonomo. I pod restano dimensionati su ciò di cui hanno realmente bisogno, senza throttling e senza over-provisioning. Team come Paramount Pictures e Creditas usano PerfectScale per mantenere efficienti i loro cluster: può provarlo o prenotare una sessione tecnica.
Best practice per il CPU throttling in Kubernetes
Ecco le best practice da seguire:
a. Impostare sempre le request di CPU e considerare i limiti di CPU come opzionali: la request è ciò che protegge il workload, perché garantisce CPU e assicura un posizionamento corretto del pod. Va quindi impostata su ogni container, valutando i limiti caso per caso invece di aggiungerli di default.
b. Mantenere i limiti di CPU entro un piccolo multiplo delle request: quando si usa un limite, non va impostato molto al di sopra della request, perché nasconde la domanda reale, né esattamente alla request, perché mette in throttling qualsiasi picco. Un piccolo multiplo sopra la request lascia spazio ai burst normali.
c. Allineare la concorrenza dell'applicazione al limite di CPU del container: bisogna rendere il runtime consapevole del suo limite, in modo che non dimensioni i thread pool sui core del nodo. In Go 1.25 e versioni successive, il runtime legge automaticamente il limite di CPU del container. Java 11 e versioni successive usa UseContainerSupport, mentre altri runtime possono richiedere la configurazione manuale del numero di thread. Questo può ridurre il throttling per molti workloads.
d. Applicare policy di limite diverse ai workloads sensibili alla latenza e a quelli batch: hanno esigenze opposte. I servizi sensibili alla latenza traggono vantaggio da limiti generosi o dall'assenza di limite, così non subiscono mai throttling a metà richiesta, mentre i job batch possono girare con limiti rigidi, perché un po' di throttling li rende soltanto più lenti.
e. Scalare orizzontalmente su request dimensionate correttamente invece di gonfiare i limiti: quando un workload ha bisogno di più capacità, conviene aggiungere repliche sulla base di request di CPU accurate anziché limitarsi ad aumentare il limite di CPU. In questo modo il carico si distribuisce tra i pod e l'HPA riceve un segnale di utilizzo della CPU più utile.