


O CPU throttling no Kubernetes acontece quando um container atinge seu limite de CPU e o kernel do Linux o desacelera em vez de encerrá-lo. O container é pausado por curtos períodos de tempo e, por isso, roda mais devagar do que gostaria. A parte confusa é que isso pode acontecer enquanto seus dashboards mostram o pod usando muito pouca CPU na média — e é justamente isso que torna o throttling um dos problemas de performance mais difíceis de diagnosticar.
Neste guia, você vai aprender o que é CPU throttling, como funcionam requests e limits de CPU, como o scheduler CFS do Linux aplica os limites de CPU, como o throttling afeta a performance da aplicação, quais são as causas mais comuns, como detectá-lo e como corrigi-lo.
O que é CPU throttling no Kubernetes?
O CPU throttling acontece quando um container tenta usar mais CPU do que o limite configurado permite. O kernel do Linux impede o container de usar mais CPU assim que ele atinge a cota disponível para o período atual. Diferentemente da memória, em que exceder o limite pode fazer o container ser encerrado, exceder um limite de CPU geralmente deixa o container mais lento em vez de terminá-lo.
O importante é entender que o throttling é aplicado em períodos curtos de CPU, então ele pode não aparecer claramente nos valores médios de CPU que a maioria dos dashboards exibe. Um pod pode parecer quase ocioso em uma média de um minuto e ainda assim sofrer throttling de CPU com frequência. Essa distância entre o que suas métricas mostram e o que sua aplicação experimenta na prática é um dos motivos que tornam o CPU throttling difícil de detectar.
Como funcionam requests e limits de CPU no Kubernetes?
O CPU throttling no Kubernetes é causado pelos limites de CPU, então vale a pena primeiro entender a diferença entre requests e limits.
Um request de CPU é o que o container precisa para ser agendado. O scheduler o usa para encontrar um nó com CPU livre suficiente e reserva essa quantidade para o pod. Por baixo dos panos, um request vira um CPU share (ou weight, no cgroup v2), que define como a CPU é dividida quando vários containers competem em um nó ocupado. Um request nunca causa throttling. Ele apenas garante ao container sua fatia justa quando há contenção no nó.
Um limite de CPU é um teto rígido de quanto tempo de CPU o container pode usar — e é ele que causa o throttling. O runtime do container transforma o limite em uma cota do CFS e, assim que o container consome essa cota, o kernel aplica o throttling. Ou seja: requests servem para agendamento e compartilhamento justo, limits servem para impor um teto, e apenas o teto causa throttling.
resources: requests: cpu: 250m limits: cpu: "1"A forma como você define requests e limits também determina a classe de Quality of Service (QoS) do pod, que o Kubernetes usa quando precisa remover pods sob pressão no nó. Um pod é Guaranteed quando todos os containers têm requests de CPU e memória iguais aos seus limits, Burstable quando os requests estão definidos mas são menores que os limits, e BestEffort quando nenhum request ou limit foi definido. A QoS afeta principalmente a ordem de eviction, mas pods Guaranteed com limites de CPU em números inteiros também podem receber núcleos dedicados — algo que aparece mais adiante como uma forma de evitar o throttling.
Como o scheduler CFS do Linux aplica os limites de CPU?
O kernel aplica os limites de CPU com o Completely Fair Scheduler (CFS), e entender esse modelo explica quase todos os casos de throttling. O CFS funciona em períodos que se repetem, e o período padrão é de 100 milissegundos (cpu.cfs_period_us). Seu limite de CPU é convertido em uma cota de tempo de CPU por período. Um limite de 500m dá ao container 50ms de tempo de CPU a cada 100ms, e um limite de 2 dá 200ms a cada 100ms, já que o trabalho pode rodar em dois núcleos ao mesmo tempo. Quando o container esgota sua cota antes do fim do período, o kernel aplica o throttling, pausando todas as threads do container até o início do próximo período — mesmo que o nó tenha CPU ociosa sobrando.
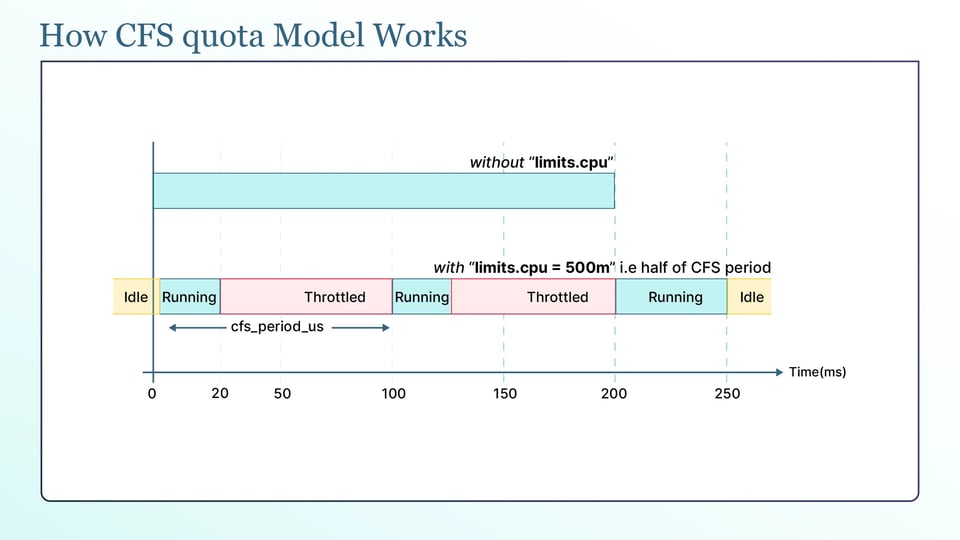
É por isso que aplicações multi-threaded sofrem throttling mais cedo do que se espera. Um container com limite de 2 e, digamos, dez threads ativas pode queimar seus 200ms de cota nos primeiros 20ms do período ao rodar as dez threads em dez núcleos simultaneamente. Todas elas ficam então pausadas pelos 80ms restantes. O uso médio de CPU pode parecer normal, enquanto a aplicação sofre lentidão repetidamente.
Onde o limite é armazenado depende da versão do cgroup. No cgroup v1, os valores ficam em cpu.cfs_period_us e cpu.cfs_quota_us. No cgroup v2, eles são combinados em um único arquivo, cpu.max, escrito como cota e período juntos. Hoje, a maioria dos clusters usa cgroup v2, que é o padrão desde o Kubernetes 1.25 e nas distribuições Linux modernas.
Mais um ponto importante: por anos, o kernel do Linux teve um bug na cota do CFS em que a cota não utilizada de um núcleo expirava em vez de ser reaproveitada, fazendo com que aplicações com muitas threads sofressem throttling mesmo usando bem menos que o limite. Esse throttling fantasma foi corrigido no kernel 5.4 e recebeu backport para a série estável 4.19. Se você ainda vê throttling intenso em workloads bem configurados, verifique a versão do kernel do nó, porque um kernel muito antigo pode ser a causa.
O que o CPU throttling faz com a performance da aplicação?
O throttling é difícil de perceber. Ele costuma aparecer de três formas:
a. A primeira é a latência de cauda, ou seja, as requisições mais lentas demoram mais que o normal. Quando um container sofre throttling, algumas requisições precisam esperar por tempo de CPU antes de serem processadas. Isso pode aumentar a latência p99, mesmo quando o uso médio de CPU parece baixo. O resultado são respostas lentas mesmo com um gráfico de CPU aparentemente tranquilo.
Diagrama 2 - "Média baixa, mas ainda com throttling."
b. A segunda são falhas de probe. Um container sob throttling pode demorar demais para responder ao seu liveness ou readiness probe dentro do prazo, fazendo o Kubernetes marcá-lo como não saudável e reiniciá-lo. O restart parece um crash, mas a causa real é que o container não conseguiu CPU quando o probe chegou.
c. A terceira é a inicialização lenta. Aplicações em JVM e Go costumam fazer trabalho pesado de CPU na inicialização, como compilação JIT ou aquecimento de caches. Um limite de CPU apertado aplica throttling exatamente nessa fase, fazendo o container demorar muito mais para ficar pronto, o que pode fazer o startup ou readiness probe falhar também.
Causas comuns de CPU throttling em clusters Kubernetes
A maioria dos problemas de CPU throttling vem das seguintes causas:
a. Limites de CPU definidos muito próximos do uso de pico: se um limite é apenas um pouco maior do que o container precisa nos picos normais, oscilações rápidas de CPU podem atingir o limite e causar throttling. Limites definidos meses atrás com base em um padrão de uso antigo são um exemplo comum.
b. Runtimes que dimensionam thread pools pelos núcleos do nó, e não pelo limite do container: historicamente, muitos runtimes de linguagem contavam os núcleos de CPU do nó, e não o limite do container, criando muito mais worker threads do que o container podia executar. Um runtime em um nó de 64 núcleos com limite de 2 CPUs poderia iniciar dezenas de threads, esgotar a cota quase instantaneamente e ficar em throttling pelo resto de cada período. Versões do Go anteriores à 1.25 e JVMs mais antigas funcionavam assim, usando as configurações GOMAXPROCS e ActiveProcessorCount da JVM.
c. Sidecars e init containers competindo por CPU: cada container de um pod tem seu próprio limite, mas todos compartilham o nó, e um sidecar ocupado, como um proxy de logging ou de mesh, pode competir com o container principal. Se os limites forem definidos sem levar um ao outro em conta, um pode sofrer throttling enquanto o outro roda.
d. Overcommitment do nó e vizinhos barulhentos: o Kubernetes permite que a soma dos limites de CPU de todos os containers em um nó seja maior que a capacidade real de CPU do nó. Isso funciona quando os workloads usam CPU em momentos diferentes. Porém, se vários workloads ficam ocupados ao mesmo tempo, ou um vizinho barulhento consome CPU demais, o nó pode ficar sobrecarregado. Isso aumenta a disputa por CPU e pode deixar containers mais lentos, mesmo que eles não tenham atingido seus próprios limites de CPU.
Como detectar o CPU throttling?
Você não consegue ver o throttling com kubectl top, que mostra apenas o uso de CPU. Você precisa dos contadores de throttle do kernel — e há dois que importam.
container_cpu_cfs_periods_total é o número total de períodos do CFS pelos quais o container passou, e container_cpu_cfs_throttled_periods_total é em quantos desses períodos ele sofreu throttling.
Um terceiro, container_cpu_cfs_throttled_seconds_total, informa o tempo total em throttling. Essas métricas vêm do kubelet via cAdvisor, e os contadores brutos também podem ser lidos no arquivo cpu.stat do container.
O número a acompanhar é o percentual de throttling, que é a divisão dos períodos com throttling pelo total de períodos. Em PromQL:
rate(container_cpu_cfs_throttled_periods_total[5m]) / rate(container_cpu_cfs_periods_total[5m]) * 100Coloque isso em um dashboard do Grafana por container e crie um alerta para quando o valor permanecer alto. Para um serviço sensível a latência, mesmo uma pequena porcentagem de períodos com throttling já basta para prejudicar o p99, então um limiar de alerta baixo, de poucos por cento, é razoável. Workloads em batch toleram muito mais.
O throttling também afeta silenciosamente o autoscaling. O Horizontal Pod Autoscaler escala com base na utilização de CPU, que é o uso em relação ao request. Quando um container sofre throttling, seu uso fica travado no limite, então o número que o HPA lê deixa de refletir a demanda real. O resultado é que o HPA pode escalar na hora errada ou na quantidade errada — mais um motivo para corrigir o throttling em vez de escalar para contorná-lo.
Como corrigir o CPU throttling no Kubernetes?
A correção certa depende do workload. Estas são as abordagens mais úteis:
a. Aumente o limite de CPU, ou remova-o, e decida por workload: se um container realmente precisa de mais CPU do que seu limite, aumente o limite para cobrir o pico real. Para serviços sensíveis a latência, muitos times removem o limite de CPU por completo, já que um container sem limite não tem cota a esgotar e não pode sofrer throttling, enquanto seu request continua garantindo uma fatia justa. Mantenha limites onde você precisa de comportamento previsível e repetível, como em testes, e considere removê-los onde a latência é o que mais importa.
b. Faça right-sizing de requests e limits com base em percentis de uso observado: não chute. Analise o uso real do container ao longo do tempo e dimensione o request pelo uso típico e o limite pelo pico, usando P95 ou P99 em vez da média, para que picos normais não sofram throttling.
c. Redimensione a CPU de pods em execução com o in-place pod resize: o in-place pod resize está em GA desde o Kubernetes 1.35, então você pode alterar o request e o limite de CPU de um container em execução sem recriar o pod. Isso é feito pelo subresource resize do pod, e mudanças de CPU são aplicadas sem restart. Corrigir um workload em throttling fica muito menos disruptivo do que o antigo processo de deletar e recriar.
kubectl patch pod <name> --subresource resize --patch \ '{"spec":{"containers":[{"name":"app","resources":{"limits":{"cpu":"1"}}}]}}'d. Ative o CFS burst para absorver picos curtos: o CFS burst é um recurso do kernel do Linux (kernel 5.14 em diante, no cgroup v2) que permite ao container acumular cota não utilizada e gastá-la durante um pico curto, ultrapassando brevemente seu limite sem elevá-lo de forma permanente. Ele serve para workloads que sofrem throttling por rajadas breves, e não por carga sustentada. Atenção: o Kubernetes ainda não expõe isso nativamente, então você o habilita definindo cpu.max.burst diretamente no cgroup ou por meio de uma ferramenta como o Koordinator, que o configura a partir de uma annotation do pod.
e. Fixe núcleos com a política estática do CPU Manager para pods com latência crítica: para pods que são ao mesmo tempo intensivos em CPU e sensíveis a latência, a política estática do CPU Manager do kubelet (--cpu-manager-policy=static) dá a um pod Guaranteed com limite de CPU em número inteiro seus próprios núcleos dedicados. O pod então roda nesses núcleos sem competir por tempo de CPU, o que evita o throttling do CFS para esse workload. O trade-off é que os núcleos ficam reservados mesmo quando o pod está ocioso, então use isso apenas onde latência baixa e consistente realmente compensa.
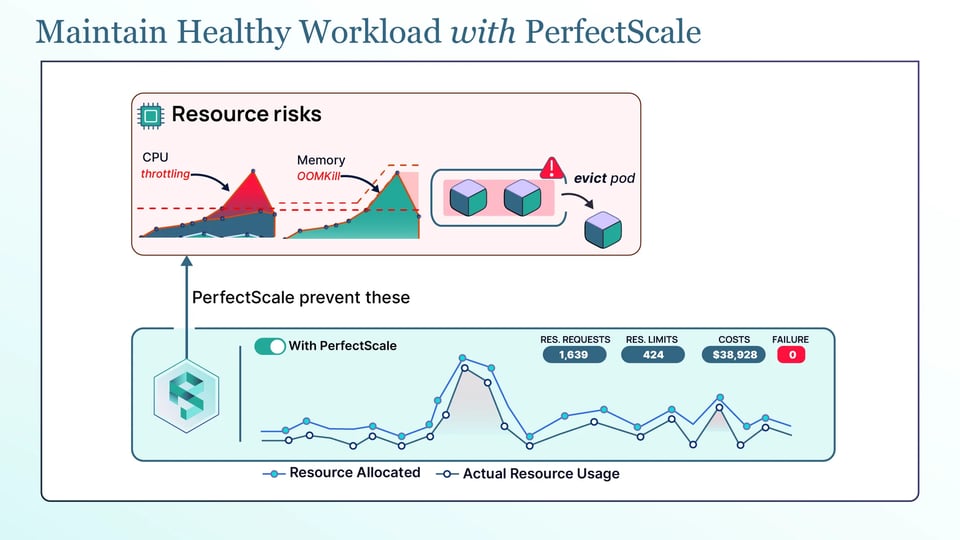
f. Automatize o right-sizing contínuo em vez de ajustar na mão: o uso de CPU muda com o tempo, então um limite que estava certo no trimestre passado pode começar a causar throttling hoje. Em vez de reconferir o cpu.stat manualmente, automatize. É aqui que o PerfectScale ajuda: sua plataforma de governança de Kubernetes observa como seus workloads realmente usam CPU e memória, junto com os sinais de throttling, e transforma isso em recomendações acionáveis e automatizadas de right-sizing para requests e limits, que você pode aplicar manualmente ou de forma autônoma. Seus pods permanecem dimensionados para o que realmente precisam, sem throttling e sem over-provisioning. Times como Paramount Pictures e Creditas usam o PerfectScale para manter seus clusters eficientes — experimente ou agende uma sessão técnica.
Boas práticas de CPU throttling no Kubernetes
Estas são as boas práticas que você deve seguir:
a. Sempre defina requests de CPU e trate limites de CPU como opcionais: o request é o que protege seu workload, porque garante CPU e posiciona bem o pod. Portanto, defina-o em todos os containers e decida sobre limits caso a caso, em vez de adicioná-los por padrão.
b. Mantenha os limites de CPU dentro de um múltiplo pequeno dos requests: quando usar um limite, não o defina muito acima do request, o que esconde a demanda real, nem exatamente no request, o que causa throttling em qualquer pico. Um múltiplo pequeno acima do request deixa espaço para rajadas normais.
c. Alinhe a concorrência da aplicação com o limite de CPU do container: você precisa fazer o runtime reconhecer seu limite para que ele não dimensione thread pools com base nos núcleos do nó. No Go 1.25 em diante, o runtime lê automaticamente o limite de CPU do container. O Java 11 em diante usa UseContainerSupport, enquanto outros runtimes podem exigir que a quantidade de threads seja configurada manualmente. Isso pode reduzir o throttling em muitos workloads.
d. Aplique políticas de limite diferentes para workloads sensíveis a latência e em batch: eles têm necessidades opostas. Serviços sensíveis a latência se beneficiam de limites folgados ou de nenhum limite, para nunca sofrerem throttling no meio de uma requisição, enquanto jobs em batch podem rodar com limites rígidos, porque um pouco de throttling só os faz demorar mais.
e. Escale horizontalmente com base em requests bem dimensionados, em vez de inflar limites: quando um workload precisa de mais capacidade, adicione réplicas com base em requests de CPU precisos, em vez de simplesmente aumentar o limite de CPU. Isso distribui o workload entre os pods e dá ao HPA um sinal de utilização de CPU mais útil.