


Kubernetes CPU Throttling tritt auf, wenn ein Container sein CPU-Limit erreicht und der Linux-Kernel ihn ausbremst, statt ihn zu beenden. Der Container wird immer wieder für kurze Zeiträume pausiert und läuft dadurch langsamer, als er eigentlich könnte. Das Verwirrende daran: All das kann passieren, während Ihre Dashboards im Durchschnitt nur eine sehr geringe CPU-Nutzung des Pods anzeigen – genau das macht Throttling zu einem der am schwierigsten zu diagnostizierenden Performance-Probleme.
In diesem Leitfaden erfahren Sie, was CPU Throttling ist, wie CPU-Requests und -Limits funktionieren, wie der Linux-CFS-Scheduler CPU-Limits durchsetzt, wie sich Throttling auf die Anwendungsperformance auswirkt, welche Ursachen typisch sind und wie Sie Throttling erkennen und beheben.
Was ist Kubernetes CPU Throttling?
CPU Throttling tritt auf, wenn ein Container versucht, mehr CPU zu nutzen, als sein konfiguriertes Limit erlaubt. Sobald der Container sein verfügbares Kontingent für die aktuelle Periode ausgeschöpft hat, unterbindet der Linux-Kernel jede weitere CPU-Nutzung. Anders als beim Arbeitsspeicher, wo das Überschreiten des Limits zum Beenden des Containers führen kann, wird ein Container beim Überschreiten des CPU-Limits in der Regel nur verlangsamt und nicht beendet.
Wichtig zu verstehen: Throttling wird über kurze CPU-Perioden durchgesetzt und ist daher in den durchschnittlichen CPU-Werten, die die meisten Dashboards anzeigen, oft kaum sichtbar. Ein Pod kann im Ein-Minuten-Durchschnitt nahezu untätig wirken und trotzdem häufig gedrosselt werden. Diese Lücke zwischen dem, was Ihre Metriken zeigen, und dem, was Ihre Anwendung tatsächlich erlebt, ist einer der Gründe, warum CPU Throttling so schwer zu erkennen ist.
Wie funktionieren CPU-Requests und -Limits in Kubernetes?
Kubernetes CPU Throttling wird durch CPU-Limits verursacht. Deshalb lohnt es sich, zunächst den Unterschied zwischen Requests und Limits zu verstehen.
Ein CPU-Request gibt an, was der Container für das Scheduling benötigt. Der Scheduler nutzt ihn, um einen Node mit ausreichend freier CPU zu finden, und reserviert diese Menge für den Pod. Unter der Haube wird ein Request in einen CPU-Share (bzw. ein Gewicht in cgroup v2) übersetzt, der bestimmt, wie die CPU aufgeteilt wird, wenn mehrere Container auf einem ausgelasteten Node konkurrieren. Ein Request verursacht niemals Throttling. Er garantiert dem Container lediglich seinen fairen Anteil, wenn der Node unter Last steht.
Ein CPU-Limit ist eine harte Obergrenze für die CPU-Zeit, die der Container nutzen darf – und genau dieses Limit verursacht Throttling. Die Container-Runtime übersetzt das Limit in eine CFS-Quota, und sobald der Container diese Quota aufgebraucht hat, drosselt ihn der Kernel. Requests regeln also Scheduling und faire Verteilung, Limits setzen eine Obergrenze – und nur diese Obergrenze drosselt.
resources: requests: cpu: 250m limits: cpu: "1"Wie Sie Requests und Limits setzen, bestimmt außerdem die Quality-of-Service-Klasse (QoS) des Pods, die Kubernetes heranzieht, wenn es Pods bei Ressourcenknappheit auf dem Node verdrängen muss. Ein Pod ist Guaranteed, wenn bei jedem Container die CPU- und Memory-Requests gleich den Limits sind, Burstable, wenn Requests gesetzt, aber niedriger als die Limits sind, und BestEffort, wenn weder Requests noch Limits gesetzt sind. QoS beeinflusst vor allem die Eviction-Reihenfolge, aber Guaranteed-Pods mit ganzzahligen CPU-Limits können zusätzlich dedizierte Cores erhalten – darauf kommen wir später zurück, denn das ist eine Möglichkeit, Throttling zu vermeiden.
Wie setzt der Linux-CFS-Scheduler CPU-Limits durch?
Der Kernel setzt CPU-Limits mit dem Completely Fair Scheduler (CFS) durch, und wer dessen Modell versteht, kann fast jeden Throttling-Fall erklären. CFS arbeitet in sich wiederholenden Perioden, die standardmäßig 100 Millisekunden lang sind (cpu.cfs_period_us). Ihr CPU-Limit wird in eine Quota an CPU-Zeit pro Periode übersetzt. Ein Limit von 500m gibt dem Container 50 ms CPU-Zeit pro 100 ms, ein Limit von 2 gibt ihm 200 ms pro 100 ms, da die Arbeit gleichzeitig auf zwei Cores laufen kann. Verbraucht der Container seine Quota vor Ende der Periode, drosselt ihn der Kernel und pausiert jeden Thread im Container bis zum Beginn der nächsten Periode – selbst wenn der Node noch freie CPU-Kapazität hat.
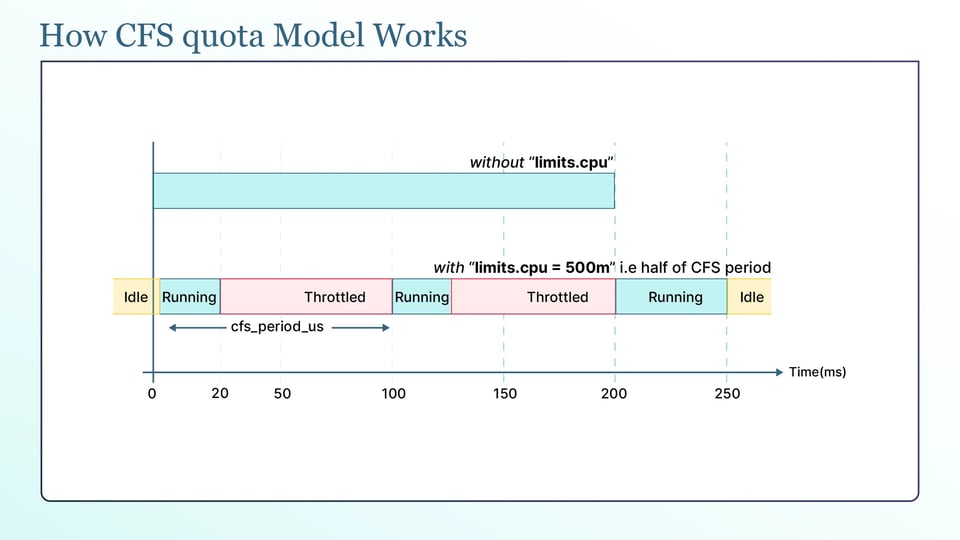
Deshalb werden Multithread-Anwendungen früher gedrosselt, als viele erwarten. Ein Container mit einem Limit von 2 und beispielsweise zehn aktiven Threads kann seine 200 ms Quota bereits in den ersten 20 ms der Periode verbrauchen, wenn alle zehn Threads gleichzeitig auf zehn Cores laufen. Anschließend werden alle für die verbleibenden 80 ms pausiert. Die durchschnittliche CPU-Nutzung kann dabei völlig normal aussehen, während die Anwendung wiederholt ausgebremst wird.
Wo das Limit gespeichert ist, hängt von der cgroup-Version ab. In cgroup v1 liegen die Werte in cpu.cfs_period_us und cpu.cfs_quota_us. In cgroup v2 sind sie in einer einzigen Datei zusammengefasst, cpu.max, in der Quota und Periode gemeinsam stehen. Die meisten Cluster nutzen heute cgroup v2, das seit Kubernetes 1.25 und auf modernen Linux-Distributionen Standard ist.
Wichtig zu wissen ist außerdem: Der Linux-Kernel hatte jahrelang einen CFS-Quota-Bug, bei dem ungenutzte Quota eines Cores verfiel, statt wiederverwendet zu werden. Anwendungen mit vielen Threads wurden dadurch gedrosselt, obwohl sie deutlich unter ihrem Limit lagen. Dieses Phantom-Throttling wurde in Kernel 5.4 behoben und in die stabile 4.19-Serie zurückportiert. Wenn Sie bei gut konfigurierten Workloads weiterhin starkes Throttling sehen, prüfen Sie die Kernel-Version des Nodes – ein sehr alter Kernel kann die Ursache sein.
Wie wirkt sich CPU Throttling auf die Anwendungsperformance aus?
Throttling ist schwer zu bemerken. Es zeigt sich in der Regel auf drei Arten:
a. Erstens: Tail-Latenz – die langsamsten Requests dauern länger als üblich. Wird ein Container gedrosselt, müssen manche Requests auf CPU-Zeit warten, bevor sie verarbeitet werden können. Das kann die p99-Latenz erhöhen, selbst wenn die durchschnittliche CPU-Nutzung niedrig aussieht. Das Ergebnis: langsame Antworten trotz eines unauffälligen CPU-Graphen.
Diagramm 2 - "Niedriger Durchschnitt, trotzdem gedrosselt."
b. Zweitens: fehlgeschlagene Probes. Ein gedrosselter Container kann zu langsam sein, um seine Liveness- oder Readiness-Probe rechtzeitig zu beantworten. Kubernetes stuft ihn dann als unhealthy ein und startet ihn neu. Der Neustart sieht aus wie ein Crash, doch die eigentliche Ursache ist, dass der Container keine CPU bekam, als die Probe eintraf.
c. Drittens: langsamer Start. JVM- und Go-Anwendungen leisten beim Start oft CPU-intensive Arbeit, etwa JIT-Kompilierung oder das Aufwärmen von Caches. Ein knapp bemessenes CPU-Limit drosselt genau diese Phase, sodass der Container deutlich länger braucht, bis er bereit ist – was dann wiederum die Startup- oder Readiness-Probe fehlschlagen lassen kann.
Häufige Ursachen für CPU Throttling in Kubernetes-Clustern
Die meisten CPU-Throttling-Probleme haben folgende Ursachen:
a. CPU-Limits zu knapp an der Spitzenlast: Liegt ein Limit nur geringfügig über dem, was ein Container bei normalen Lastspitzen benötigt, können schon kurze CPU-Spikes das Limit erreichen und Throttling auslösen. Ein typisches Beispiel sind Limits, die vor Monaten auf Basis älterer Nutzungsdaten gesetzt wurden.
b. Runtimes, die Thread-Pools nach den Node-Cores statt nach dem Container-Limit dimensionieren: Viele Sprach-Runtimes zählten historisch die CPU-Cores des Nodes und nicht das Limit des Containers und erzeugten dadurch weit mehr Worker-Threads, als der Container ausführen durfte. Eine Runtime auf einem Node mit 64 Cores und einem Limit von 2 CPUs kann Dutzende Threads starten, die Quota fast sofort verbrauchen und für den Rest jeder Periode gedrosselt werden. Go-Versionen vor 1.25 und ältere JVMs verhielten sich so – Stichwort GOMAXPROCS und die JVM-Einstellung ActiveProcessorCount.
c. Sidecar- und Init-Container, die um CPU konkurrieren: Jeder Container in einem Pod hat sein eigenes Limit, aber alle teilen sich den Node. Ein ausgelasteter Sidecar wie ein Logging- oder Mesh-Proxy kann mit dem Hauptcontainer konkurrieren. Werden die Limits gesetzt, ohne einander zu berücksichtigen, kann der eine gedrosselt werden, während der andere läuft.
d. Node-Overcommitment und Noisy Neighbors: Kubernetes erlaubt, dass die Summe der CPU-Limits aller Container auf einem Node höher ist als dessen tatsächliche CPU-Kapazität. Das funktioniert, solange die Workloads ihre CPU zu unterschiedlichen Zeiten nutzen. Werden jedoch mehrere Workloads gleichzeitig aktiv oder beansprucht ein Noisy Neighbor zu viel CPU, kann der Node überlastet werden. Das erhöht die CPU-Konkurrenz und kann Container verlangsamen, selbst wenn diese ihr eigenes CPU-Limit noch gar nicht erreicht haben.
Wie erkennt man CPU Throttling?
Mit kubectl top sehen Sie Throttling nicht – es zeigt nur die CPU-Nutzung. Sie brauchen die Throttle-Zähler des Kernels, und davon sind zwei entscheidend.
container_cpu_cfs_periods_total ist die Gesamtzahl der CFS-Perioden, die der Container durchlaufen hat, und container_cpu_cfs_throttled_periods_total gibt an, in wie vielen dieser Perioden er gedrosselt wurde.
Ein dritter Zähler, container_cpu_cfs_throttled_seconds_total, zeigt die insgesamt gedrosselte Zeit. Diese Werte liefert das kubelet über cAdvisor; die Rohzähler lassen sich auch direkt in der cpu.stat-Datei des Containers auslesen.
Die entscheidende Kennzahl ist der Throttle-Prozentsatz: die gedrosselten Perioden geteilt durch alle Perioden. In PromQL:
rate(container_cpu_cfs_throttled_periods_total[5m]) / rate(container_cpu_cfs_periods_total[5m]) * 100Legen Sie diese Kennzahl pro Container auf ein Grafana-Dashboard und lassen Sie sich alarmieren, wenn sie dauerhaft hoch bleibt. Bei einem latenzsensitiven Service reichen schon wenige Prozent gedrosselter Perioden, um die p99-Latenz zu verschlechtern – ein Alarmschwellenwert im niedrigen einstelligen Bereich ist daher sinnvoll. Batch-Workloads vertragen deutlich mehr.
Throttling beeinflusst auch das Autoscaling – und zwar unbemerkt. Der Horizontal Pod Autoscaler skaliert anhand der CPU-Auslastung, also der Nutzung im Verhältnis zum Request. Wird ein Container gedrosselt, ist seine Nutzung auf sein Limit gedeckelt, sodass der Wert, den der HPA liest, nicht mehr den tatsächlichen Bedarf widerspiegelt. Die Folge: Der HPA kann zum falschen Zeitpunkt oder im falschen Umfang skalieren – ein weiterer Grund, Throttling zu beheben, statt es durch Skalierung zu umgehen.
Wie behebt man Kubernetes CPU Throttling?
Die richtige Lösung hängt vom Workload ab. Hier sind die nützlichsten Ansätze:
a. CPU-Limit erhöhen oder entfernen – und pro Workload entscheiden: Wenn ein Container tatsächlich mehr CPU benötigt, als sein Limit erlaubt, erhöhen Sie das Limit so, dass es die reale Spitzenlast abdeckt. Bei latenzsensitiven Services entfernen viele Teams das CPU-Limit komplett: Ein Container ohne Limit hat keine Quota, die er aufbrauchen könnte, und kann daher nicht gedrosselt werden, während sein Request ihm weiterhin einen fairen Anteil garantiert. Behalten Sie Limits dort, wo Sie vorhersehbares, reproduzierbares Verhalten brauchen – etwa beim Testen – und erwägen Sie ihre Entfernung dort, wo Latenz am wichtigsten ist.
b. Requests und Limits anhand beobachteter Nutzungsperzentile dimensionieren: Raten Sie nicht. Betrachten Sie die tatsächliche Nutzung des Containers über einen längeren Zeitraum und richten Sie den Request an der typischen Nutzung und das Limit an der Spitzenlast aus – und zwar anhand von P95 oder P99 statt des Durchschnitts, damit normale Spikes nicht gedrosselt werden.
c. CPU laufender Pods per In-Place Pod Resize anpassen: In-Place Pod Resize ist seit Kubernetes 1.35 GA. Damit können Sie CPU-Request und -Limit eines laufenden Containers ändern, ohne den Pod neu zu erstellen. Das geschieht über die resize-Subresource des Pods, und CPU-Änderungen werden ohne Neustart wirksam. Das macht die Behebung eines gedrosselten Workloads deutlich weniger disruptiv als das frühere Löschen und Neuerstellen.
kubectl patch pod <name> --subresource resize --patch \ '{"spec":{"containers":[{"name":"app","resources":{"limits":{"cpu":"1"}}}]}}'d. CFS Burst aktivieren, um kurze Spikes abzufedern: CFS Burst ist ein Feature des Linux-Kernels (ab Kernel 5.14, mit cgroup v2), mit dem ein Container ungenutzte Quota ansparen und bei einem kurzen Spike ausgeben kann – er darf kurzzeitig über sein Limit hinausgehen, ohne dass das Limit dauerhaft erhöht wird. Das passt zu Workloads, die durch kurze Bursts statt durch anhaltende Last gedrosselt werden. Beachten Sie, dass Kubernetes dies noch nicht nativ unterstützt: Sie aktivieren es entweder, indem Sie cpu.max.burst direkt auf der cgroup setzen, oder über ein Tool wie Koordinator, das den Wert anhand einer Pod-Annotation setzt.
e. Cores mit der statischen CPU-Manager-Policy für latenzkritische Pods fest zuweisen: Für Pods, die sowohl CPU-intensiv als auch latenzsensitiv sind, weist die statische CPU-Manager-Policy des kubelet (--cpu-manager-policy=static) einem Guaranteed-Pod mit ganzzahligem CPU-Limit eigene dedizierte Cores zu. Der Pod läuft dann auf diesen Cores, ohne um CPU-Zeit zu konkurrieren, wodurch CFS-Throttling für diesen Workload entfällt. Der Nachteil: Die Cores bleiben auch reserviert, wenn der Pod untätig ist. Nutzen Sie diese Option also nur dort, wo konstant niedrige Latenz den Preis wert ist.
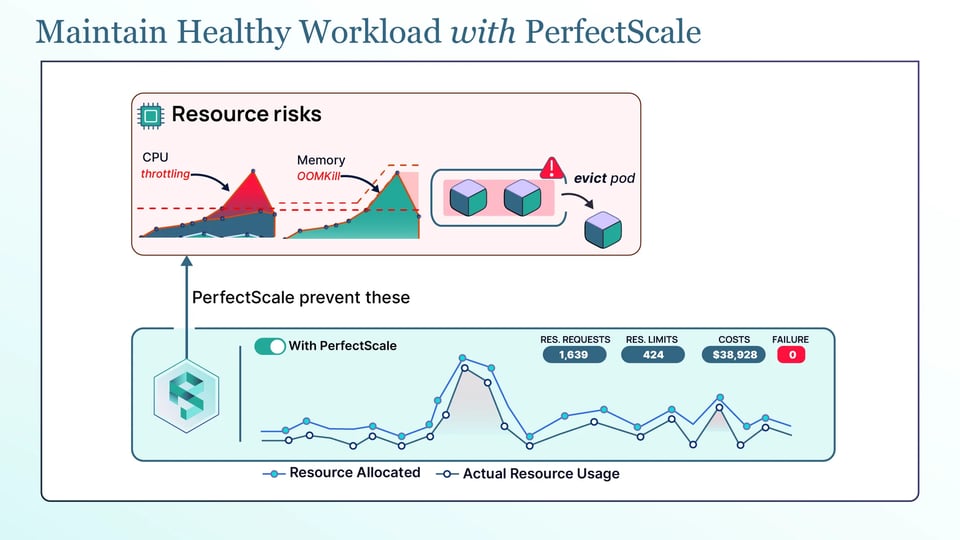
f. Kontinuierliches Right-Sizing automatisieren, statt von Hand nachzujustieren: Die CPU-Nutzung ändert sich mit der Zeit – ein Limit, das im letzten Quartal passte, kann heute drosseln. Statt cpu.stat immer wieder manuell zu prüfen, automatisieren Sie den Prozess. Genau hier hilft PerfectScale: Die Kubernetes-Governance-Plattform beobachtet, wie Ihre Workloads CPU und Arbeitsspeicher tatsächlich nutzen – inklusive Throttling-Signalen – und leitet daraus umsetzbare, automatisierte Right-Sizing-Empfehlungen für Requests und Limits ab, die Sie manuell oder autonom anwenden können. Ihre Pods bleiben so dimensioniert, wie sie es wirklich brauchen – ohne Throttling und ohne Over-Provisioning. Teams wie Paramount Pictures und Creditas setzen auf PerfectScale, um ihre Cluster effizient zu halten. Probieren Sie es aus oder buchen Sie eine technische Session.
Best Practices gegen Kubernetes CPU Throttling
Diese Best Practices sollten Sie befolgen:
a. Setzen Sie immer CPU-Requests und behandeln Sie CPU-Limits als optional: Der Request schützt Ihren Workload, weil er CPU garantiert und den Pod sinnvoll platziert. Setzen Sie ihn daher bei jedem Container und entscheiden Sie über Limits von Fall zu Fall, statt sie standardmäßig zu vergeben.
b. Halten Sie CPU-Limits bei einem kleinen Vielfachen des Requests: Wenn Sie ein Limit setzen, wählen Sie es weder weit über dem Request – das verschleiert den tatsächlichen Bedarf – noch direkt am Request, denn dann drosselt jeder Spike. Ein kleines Vielfaches über dem Request lässt Raum für normale Bursts.
c. Stimmen Sie die Anwendungs-Concurrency auf das CPU-Limit des Containers ab: Die Runtime muss ihr Limit kennen, damit sie Thread-Pools nicht anhand der Node-Cores dimensioniert. Ab Go 1.25 liest die Runtime das CPU-Limit des Containers automatisch aus. Java 11 und neuer nutzt UseContainerSupport, bei anderen Runtimes muss die Thread-Anzahl gegebenenfalls manuell konfiguriert werden. Das kann Throttling für viele Workloads reduzieren.
d. Wenden Sie unterschiedliche Limit-Strategien für latenzsensitive und Batch-Workloads an: Sie haben gegensätzliche Anforderungen. Latenzsensitive Services profitieren von großzügigen Limits oder gar keinem Limit, damit sie nie mitten in einem Request gedrosselt werden, während Batch-Jobs mit festen Limits laufen können – etwas Throttling verlängert dort lediglich die Laufzeit.
e. Skalieren Sie horizontal auf Basis korrekt dimensionierter Requests, statt Limits aufzublähen: Braucht ein Workload mehr Kapazität, fügen Sie Replicas auf Basis präziser CPU-Requests hinzu, statt einfach das CPU-Limit zu erhöhen. Das verteilt die Last auf mehrere Pods und liefert dem HPA ein aussagekräftigeres CPU-Auslastungssignal.