


Le CPU throttling dans Kubernetes se produit lorsqu'un conteneur atteint sa limite CPU et que le noyau Linux le ralentit au lieu de le tuer. Le conteneur est mis en pause pendant de courtes périodes et s'exécute donc plus lentement qu'il ne le voudrait. Le plus déroutant, c'est que cela peut arriver alors que vos dashboards affichent une utilisation CPU moyenne très faible pour le pod, ce qui fait du throttling l'un des problèmes de performance les plus difficiles à diagnostiquer.
Dans ce guide, vous découvrirez ce qu'est le CPU throttling, comment fonctionnent les requests et les limites CPU, comment le scheduler CFS de Linux applique les limites CPU, comment le throttling affecte les performances applicatives, quelles en sont les causes courantes, comment le détecter et comment le corriger.
Qu'est-ce que le CPU throttling dans Kubernetes ?
Le CPU throttling se produit lorsqu'un conteneur tente d'utiliser plus de CPU que sa limite configurée ne l'autorise. Le noyau Linux empêche le conteneur de consommer davantage de CPU dès qu'il atteint le quota disponible pour la période en cours. Contrairement à la mémoire, où le dépassement de la limite peut entraîner l'arrêt du conteneur, le dépassement d'une limite CPU ralentit généralement le conteneur au lieu de le terminer.
L'essentiel à comprendre : le throttling est appliqué sur de courtes périodes CPU et peut donc ne pas apparaître clairement dans les moyennes affichées par la plupart des dashboards. Un pod peut sembler presque inactif sur une moyenne d'une minute tout en subissant un throttling CPU fréquent. Cet écart entre ce que montrent vos métriques et ce que vit réellement votre application est l'une des raisons pour lesquelles le CPU throttling peut être difficile à détecter.
Comment fonctionnent les requests et les limites CPU dans Kubernetes ?
Le CPU throttling dans Kubernetes est causé par les limites CPU ; il est donc utile de comprendre d'abord la différence entre requests et limites.
Une request CPU correspond à ce dont le conteneur a besoin pour être planifié. Le scheduler l'utilise pour trouver un nœud disposant de suffisamment de CPU libre et réserve cette quantité pour le pod. En interne, une request devient une part de CPU (ou un poids, avec cgroup v2), qui détermine la répartition du CPU lorsque plusieurs conteneurs se disputent un nœud chargé. Une request ne provoque jamais de throttling : elle garantit simplement au conteneur sa juste part en cas de contention sur le nœud.
Une limite CPU est un plafond strict sur le temps CPU que le conteneur peut consommer, et c'est elle qui provoque le throttling. Le runtime de conteneur convertit la limite en quota CFS, et dès que le conteneur a consommé ce quota, le noyau le throttle. En résumé : les requests concernent la planification et le partage équitable, les limites le plafonnement — et seul le plafond throttle.
resources: requests: cpu: 250m limits: cpu: "1"La manière dont vous définissez requests et limites détermine aussi la classe de Quality of Service (QoS) du pod, que Kubernetes utilise lorsqu'il doit évincer des pods en cas de pression sur le nœud. Un pod est Guaranteed lorsque chaque conteneur a des requests CPU et mémoire égales à ses limites, Burstable lorsque des requests sont définies mais inférieures aux limites, et BestEffort lorsqu'aucune request ni limite n'est définie. La QoS influe surtout sur l'ordre d'éviction, mais les pods Guaranteed avec des limites CPU en nombres entiers peuvent aussi obtenir des cœurs dédiés, un point qui reviendra plus loin comme moyen d'éviter le throttling.
Comment le scheduler CFS de Linux applique-t-il les limites CPU ?
Le noyau applique les limites CPU via le Completely Fair Scheduler (CFS), et comprendre son fonctionnement explique presque tous les cas de throttling. Le CFS fonctionne par périodes répétées, de 100 millisecondes par défaut (cpu.cfs_period_us). Votre limite CPU est convertie en un quota de temps CPU par période. Une limite de 500m accorde au conteneur 50 ms de temps CPU toutes les 100 ms, et une limite de 2 lui accorde 200 ms toutes les 100 ms, puisque le travail peut s'exécuter sur deux cœurs en parallèle. Lorsque le conteneur épuise son quota avant la fin de la période, le noyau le throttle : tous les threads du conteneur sont mis en pause jusqu'au début de la période suivante, même si le nœud dispose de CPU inutilisé.
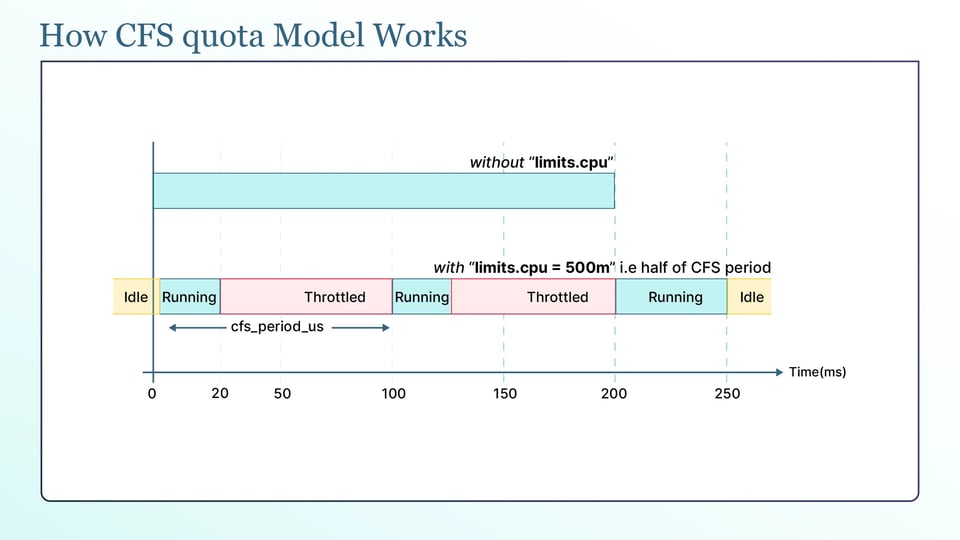
C'est pourquoi les applications multi-threads sont throttlées plus tôt qu'on ne s'y attend. Un conteneur avec une limite de 2 et, disons, dix threads actifs peut consommer ses 200 ms de quota dans les 20 premières millisecondes de la période en exécutant ses dix threads sur dix cœurs à la fois. Tous sont ensuite mis en pause pendant les 80 ms restantes. L'utilisation CPU moyenne peut sembler normale, alors que l'application subit des ralentissements répétés.
L'emplacement de la limite dépend de la version de cgroup. Avec cgroup v1, les valeurs résident dans cpu.cfs_period_us et cpu.cfs_quota_us. Avec cgroup v2, elles sont regroupées dans un seul fichier, cpu.max, qui contient à la fois le quota et la période. La plupart des clusters utilisent aujourd'hui cgroup v2, valeur par défaut depuis Kubernetes 1.25 et sur les distributions Linux modernes.
Autre point important : pendant des années, le noyau Linux a souffert d'un bug de quota CFS où le quota inutilisé d'un cœur expirait au lieu d'être réutilisé, si bien que les applications fortement multi-threads étaient throttlées alors même qu'elles restaient bien en dessous de leur limite. Ce throttling fantôme a été corrigé dans le noyau 5.4 et rétroporté dans la série stable 4.19. Si vous observez encore un throttling important sur des workloads correctement configurés, vérifiez la version du noyau du nœud : un noyau très ancien peut en être la cause.
Quels sont les effets du CPU throttling sur les performances applicatives ?
Le throttling est difficile à repérer. Il se manifeste généralement de trois façons :
a. La première est la latence de queue (tail latency) : les requêtes les plus lentes prennent plus de temps que d'habitude. Lorsqu'un conteneur est throttlé, certaines requêtes doivent attendre du temps CPU avant d'être traitées. Cela peut augmenter la latence p99, même lorsque l'utilisation CPU moyenne semble faible. Résultat : des réponses lentes malgré un graphique CPU en apparence calme.
Diagramme 2 - Moyenne faible, throttling quand même.
b. La deuxième concerne les échecs de probes. Un conteneur throttlé peut être trop lent pour répondre à temps à sa liveness probe ou à sa readiness probe ; Kubernetes le marque alors comme défaillant et le redémarre. Le redémarrage ressemble à un crash, mais la véritable cause est que le conteneur n'a pas pu obtenir de CPU au moment de la probe.
c. La troisième est un démarrage lent. Les applications JVM et Go effectuent souvent un travail intensif en CPU au démarrage, comme la compilation JIT ou le préchauffage des caches. Une limite CPU serrée throttle précisément cette phase : le conteneur met beaucoup plus de temps à devenir prêt, ce qui peut ensuite faire échouer la startup probe ou la readiness probe.
Causes courantes du CPU throttling dans les clusters Kubernetes
La plupart des problèmes de CPU throttling proviennent des causes suivantes :
a. Des limites CPU trop proches des pics d'utilisation : si une limite n'est que légèrement supérieure à ce dont un conteneur a besoin lors de ses pics habituels, de brèves pointes de CPU peuvent atteindre la limite et provoquer du throttling. Des limites définies il y a plusieurs mois sur la base d'une utilisation passée en sont un exemple courant.
b. Des runtimes qui dimensionnent leurs pools de threads sur les cœurs du nœud plutôt que sur la limite du conteneur : de nombreux runtimes comptaient historiquement les cœurs CPU du nœud, et non la limite du conteneur, et créaient bien plus de threads de travail que le conteneur n'était autorisé à en exécuter. Un runtime sur un nœud de 64 cœurs avec une limite de 2 CPU peut démarrer des dizaines de threads, épuiser le quota presque instantanément et rester throttlé pour le reste de chaque période. Les versions de Go antérieures à 1.25 et les anciennes JVM fonctionnaient ainsi, via GOMAXPROCS et le paramètre ActiveProcessorCount de la JVM.
c. Des sidecars et conteneurs init en concurrence pour le CPU : chaque conteneur d'un pod a sa propre limite, mais ils partagent le nœud, et un sidecar très sollicité, comme un proxy de logging ou de mesh, peut concurrencer le conteneur principal. Si leurs limites sont définies sans tenir compte les unes des autres, l'un peut être throttlé pendant que l'autre s'exécute.
d. Surallocation du nœud et voisins bruyants : Kubernetes autorise la somme des limites CPU de tous les conteneurs d'un nœud à dépasser la capacité CPU réelle du nœud. Cela fonctionne lorsque les workloads consomment du CPU à des moments différents. Mais si plusieurs workloads deviennent actifs en même temps, ou si un voisin bruyant consomme trop de CPU, le nœud peut se retrouver surchargé. La contention CPU augmente et peut ralentir des conteneurs, même s'ils n'ont pas atteint leur propre limite CPU.
Comment détecter le CPU throttling ?
Impossible de voir le throttling avec kubectl top, qui n'affiche que l'utilisation CPU. Il vous faut les compteurs de throttling du noyau, et deux d'entre eux sont essentiels.
container_cpu_cfs_periods_total indique le nombre total de périodes CFS traversées par le conteneur, et container_cpu_cfs_throttled_periods_total le nombre de ces périodes durant lesquelles il a été throttlé.
Un troisième, container_cpu_cfs_throttled_seconds_total, indique le temps total passé en throttling. Ces métriques proviennent du kubelet via cAdvisor, et les compteurs bruts sont également lisibles dans le fichier cpu.stat du conteneur.
Le chiffre à surveiller est le pourcentage de throttling, soit le nombre de périodes throttlées divisé par le nombre total de périodes. En PromQL :
rate(container_cpu_cfs_throttled_periods_total[5m]) / rate(container_cpu_cfs_periods_total[5m]) * 100Affichez cette métrique par conteneur sur un dashboard Grafana et déclenchez une alerte lorsqu'elle reste élevée. Pour un service sensible à la latence, quelques pour cent de périodes throttlées suffisent à dégrader la p99 : un seuil d'alerte de quelques pour cent seulement est donc raisonnable. Les workloads batch en tolèrent beaucoup plus.
Le throttling fausse aussi discrètement l'autoscaling. Le Horizontal Pod Autoscaler se base sur l'utilisation CPU, c'est-à-dire la consommation rapportée à la request. Lorsqu'un conteneur est throttlé, sa consommation est plafonnée à sa limite : le chiffre lu par le HPA ne reflète donc plus la demande réelle. Le HPA peut ainsi déclencher un scaling au mauvais moment ou dans de mauvaises proportions — une raison de plus de corriger le throttling plutôt que de le contourner par le scaling.
Comment corriger le CPU throttling dans Kubernetes ?
La bonne solution dépend du workload. Voici les approches les plus utiles :
a. Augmentez la limite CPU, ou supprimez-la, au cas par cas : si un conteneur a réellement besoin de plus de CPU que sa limite, augmentez la limite pour couvrir son pic réel. Pour les services sensibles à la latence, de nombreuses équipes suppriment entièrement la limite CPU : un conteneur sans limite n'a pas de quota à épuiser et ne peut pas être throttlé, tandis que sa request lui garantit toujours une part équitable. Conservez les limites là où vous avez besoin d'un comportement prévisible et reproductible, comme en environnement de test, et envisagez de les supprimer là où la latence est critique.
b. Ajustez requests et limites à partir des percentiles d'utilisation observés : ne devinez pas. Analysez l'utilisation réelle du conteneur dans le temps et dimensionnez la request autour de son usage habituel et la limite autour de son pic, en vous basant sur le P95 ou le P99 plutôt que sur la moyenne, afin que les pics normaux ne soient pas throttlés.
c. Redimensionnez le CPU des pods en cours d'exécution grâce au resize in-place : le redimensionnement in-place des pods est GA depuis Kubernetes 1.35 ; vous pouvez donc modifier la request et la limite CPU d'un conteneur en cours d'exécution sans recréer le pod. Cela passe par la sous-ressource resize du pod, et les modifications CPU s'appliquent sans redémarrage. Corriger un workload throttlé devient ainsi bien moins perturbant que l'ancienne méthode de suppression et recréation.
kubectl patch pod <name> --subresource resize --patch \ '{"spec":{"containers":[{"name":"app","resources":{"limits":{"cpu":"1"}}}]}}'d. Activez le CFS burst pour absorber les pics courts : le CFS burst est une fonctionnalité du noyau Linux (noyau 5.14 et ultérieur, avec cgroup v2) qui permet à un conteneur d'accumuler du quota inutilisé et de le dépenser lors d'un pic bref, en dépassant temporairement sa limite sans l'augmenter de façon permanente. Elle convient aux workloads throttlés par de brèves rafales plutôt que par une charge soutenue. Notez que Kubernetes ne l'expose pas encore nativement : vous l'activez soit en définissant cpu.max.burst directement sur le cgroup, soit via un outil comme Koordinator qui le configure à partir d'une annotation de pod.
e. Épinglez des cœurs avec la politique statique du CPU Manager pour les pods critiques en latence : pour les pods à la fois gourmands en CPU et sensibles à la latence, la politique statique du CPU Manager du kubelet (--cpu-manager-policy=static) attribue des cœurs dédiés à un pod Guaranteed dont la limite CPU est un nombre entier. Le pod s'exécute alors sur ces cœurs sans concurrence pour le temps CPU, ce qui évite le throttling CFS pour ce workload. En contrepartie, les cœurs restent réservés même lorsque le pod est inactif : utilisez cette approche uniquement lorsqu'une latence faible et constante le justifie.
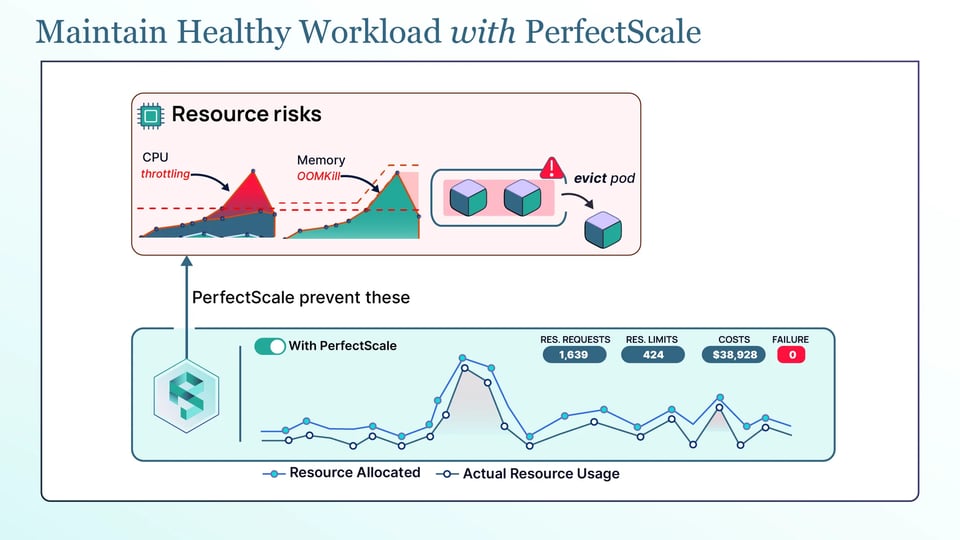
f. Automatisez le right-sizing en continu plutôt que d'ajuster à la main : l'utilisation CPU évolue dans le temps, et une limite adaptée le trimestre dernier peut provoquer du throttling aujourd'hui. Plutôt que de revérifier cpu.stat manuellement, automatisez. C'est là que PerfectScale entre en jeu : sa plateforme de gouvernance Kubernetes observe la consommation réelle de CPU et de mémoire de vos workloads, ainsi que les signaux de throttling, et les transforme en recommandations de right-sizing concrètes et automatisées pour les requests et les limites, que vous pouvez appliquer manuellement ou de manière autonome. Vos pods restent dimensionnés au plus juste, sans throttling ni surprovisionnement. Des équipes comme Paramount Pictures et Creditas utilisent PerfectScale pour maintenir l'efficacité de leurs clusters — vous pouvez l'essayer ou réserver une session technique.
Bonnes pratiques contre le CPU throttling dans Kubernetes
Voici les bonnes pratiques à suivre :
a. Définissez toujours des requests CPU et considérez les limites CPU comme optionnelles : la request protège votre workload, car elle garantit du CPU et place correctement le pod. Définissez-la donc sur chaque conteneur et décidez des limites au cas par cas plutôt que de les ajouter par défaut.
b. Maintenez les limites CPU dans un petit multiple des requests : lorsque vous utilisez une limite, ne la fixez ni très au-dessus de la request, ce qui masque la demande réelle, ni exactement au niveau de la request, ce qui throttle à la moindre pointe. Un petit multiple au-dessus de la request laisse de la marge pour les pics normaux.
c. Alignez le niveau de concurrence de l'application sur la limite CPU du conteneur : faites en sorte que le runtime connaisse sa limite afin qu'il ne dimensionne pas ses pools de threads selon les cœurs du nœud. À partir de Go 1.25, le runtime lit automatiquement la limite CPU du conteneur. Java 11 et ultérieur utilise UseContainerSupport, tandis que d'autres runtimes peuvent nécessiter une configuration manuelle du nombre de threads. Cela peut réduire le throttling pour de nombreux workloads.
d. Appliquez des politiques de limites différentes aux workloads sensibles à la latence et aux workloads batch : leurs besoins sont opposés. Les services sensibles à la latence bénéficient de limites souples, voire d'aucune limite, pour ne jamais être throttlés en pleine requête, tandis que les jobs batch peuvent tourner avec des limites strictes : un peu de throttling les rend simplement plus longs.
e. Scalez horizontalement sur des requests bien dimensionnées plutôt que de gonfler les limites : lorsqu'un workload a besoin de plus de capacité, ajoutez des replicas sur la base de requests CPU précises plutôt que d'augmenter simplement la limite CPU. La charge est ainsi répartie entre les pods et le HPA reçoit un signal d'utilisation CPU plus fiable.