
PerfectScale
Karpenter v1.14: novedades y cómo actualizar
Soporte para DRA, una nueva API CapacityBuffer y una política de consolidación Balanced: esto es lo nuevo en Karpenter v1.14, cómo actualizar y qué está realmente listo para producción.
Esta página también está disponible en English, Deutsch, Français, Italiano, 日本語 y Português.


TLDR;
Karpenter v1.14, lanzado el 11 de julio de 2026, incorpora tres funciones: soporte de Dynamic Resource Allocation (DRA) para la programación de GPUs y aceleradores, una API CapacityBuffer en alpha para reservar capacidad extra en los nodos y una nueva política de consolidación Balanced que pondera el ahorro de costos frente a la disrupción de los pods. La consolidación Balanced es un campo estable y seguro para usar en producción; el soporte de DRA y CapacityBuffer todavía están en etapa temprana y conviene probarlos primero en staging.
Karpenter v1.14: novedades y cómo actualizar
Karpenter v1.14 es la versión más reciente del autoescalador de nodos de Kubernetes. Incorpora tres novedades principales: soporte para Dynamic Resource Allocation (DRA), una nueva API CapacityBuffer para capacidad de reserva y una nueva política de consolidación Balanced. Dos de ellas todavía están en etapa temprana. El soporte de DRA aún no es GA en Karpenter, y CapacityBuffer está en alpha y desactivada por defecto.
Ambos repositorios de Karpenter publicaron la v1.14.0 el 11 de julio de 2026: el proyecto principal y el proveedor de AWS.
En este artículo te explicamos qué hace cada una, cómo actualizar y qué puedes usar en producción hoy.
Hay un hilo conductor en esta versión. El equipo de Karpenter sabe que la confiabilidad y la disponibilidad son la prioridad cuando ajustas el autoescalado. Nadie quiere ahorrar costos a cambio de una caída del servicio. Tanto la nueva política de consolidación Balanced como CapacityBuffer se diseñaron con esto en mente. Una ahorra costos sin mover nodos que no puedes darte el lujo de perder. La otra mantiene capacidad de reserva lista para que los pods no esperen. Es el mismo enfoque de costos —con la confiabilidad como prioridad— que PerfectScale ha aplicado desde el inicio.
¿Qué hay de nuevo en Karpenter v1.14?
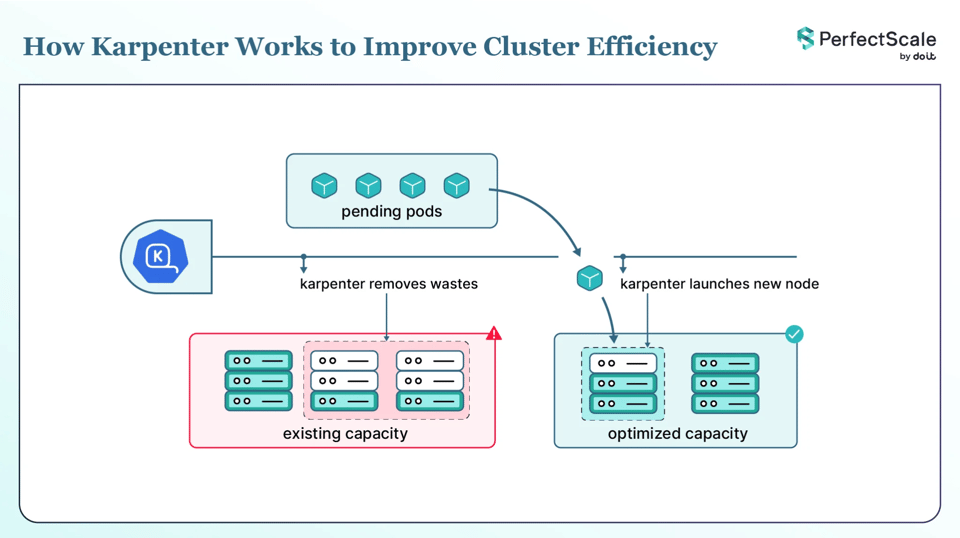
Karpenter lanza nodos cuando los pods no se pueden programar y los elimina cuando ya no se necesitan. La v1.14 no cambia esa función. Hace que Karpenter sea más inteligente con los workloads de GPU y hardware, te da una forma de mantener nodos de reserva listos y agrega una manera menos agresiva de ahorrar costos.
Tres cambios destacan en esta versión:
a. Soporte de DRA: Karpenter ahora lee la solicitud DRA de un pod cuando elige un nodo. Esto importa sobre todo para workloads de GPU y otro hardware.
b. CapacityBuffer: puedes mantener nodos de reserva listos para que los pods arranquen de inmediato. Esta función está en alpha.
c. Consolidación Balanced: una nueva política que elimina un nodo solo cuando el costo ahorrado justifica la disrupción.
Soporte de DRA en Karpenter v1.14
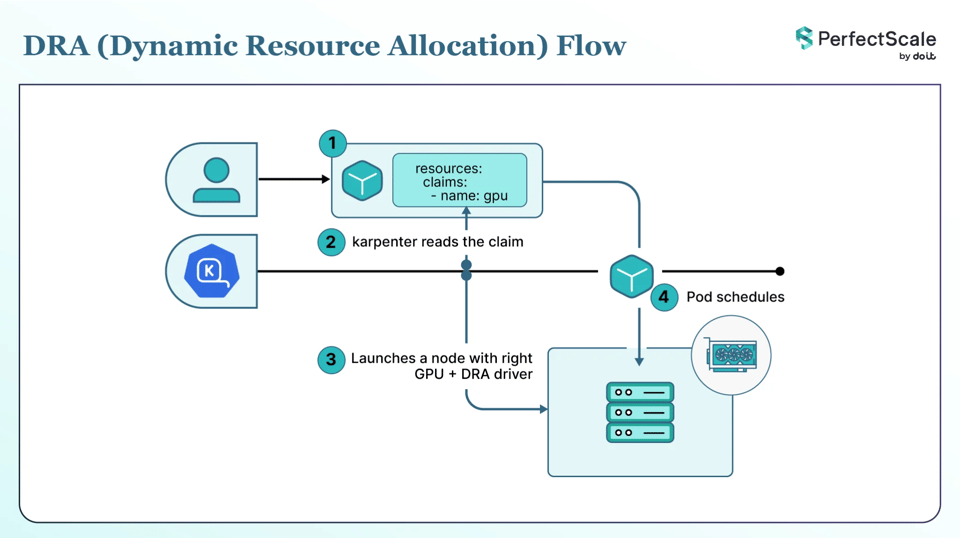
DRA es el mecanismo de Kubernetes para solicitar hardware especializado, como GPUs y otros aceleradores. En lugar de pedir un número fijo como nvidia.com/gpu: 1, el pod describe el dispositivo que necesita con un ResourceClaim y el scheduler elige el dispositivo concreto. Cada nodo necesita un driver de DRA para tu hardware. DRA es GA en Kubernetes desde la v1.34 y viene activado por defecto a partir de esa versión.
Antes de la v1.14, Karpenter no leía estas solicitudes DRA al planificar nodos nuevos. Así, un pod que necesitaba una GPU vía DRA podía quedarse atascado, porque Karpenter no lanzaba un nodo capaz de ejecutarlo. Para sortearlo, tenías que dirigir esos pods a los nodos correctos por tu cuenta, con un nodeSelector o node affinity, igual que se enrutan los pods de GPU con el modelo antiguo de device plugin. Karpenter sí lee esos valores, pero no podía leer el claim de DRA por sí solo. La v1.14 agrega un asignador de DRA. Karpenter ahora lee la solicitud DRA del pod y la usa para elegir el nodo correcto. También maneja dispositivos compartidos y divisibles, lo que ayuda cuando varios pods comparten un acelerador.
No necesitas activarlo: viene activado por defecto. Para que Karpenter ignore las solicitudes DRA, configura el flag --ignore-dra-requests. Pero esto todavía está en etapa temprana. Si ejecutas workloads de GPU o aceleradores con DRA, pruébalo primero en staging. También necesitas Kubernetes 1.34 o posterior y un driver de DRA para tu hardware. En la referencia de configuración tienes los detalles del flag.
CapacityBuffer de Karpenter: mantén nodos de reserva listos
Los nodos nuevos tardan en arrancar y unirse al clúster. Para workloads con picos o que no pueden esperar, esa demora sale cara. Los pods quedan pendientes y tu servicio no logra escalar a tiempo para atender el tráfico. CapacityBuffer te permite mantener algo de capacidad de reserva lista, para que los pods se programen de inmediato en lugar de esperar un nodo nuevo.
Funciona con pods virtuales que actúan como marcadores de posición. Estos pods solo existen dentro de la planificación de Karpenter. Nunca son pods reales en tu clúster. Hacen que Karpenter mantenga nodos de reserva listos y se reponen solos cuando tus pods reales ocupan el espacio de reserva.
Defines el tamaño de la capacidad de reserva de una de dos formas:
- podTemplateRef: apunta a un PodTemplate que describe una unidad del buffer y luego define replicas y/o limits.
- scalableRef: apunta a un Deployment, StatefulSet o ReplicaSet y luego define un porcentaje para que la capacidad de reserva acompañe a ese workload.
Aquí tienes un buffer fijo de cinco unidades:
yaml
apiVersion: autoscaling.x-k8s.io/v1alpha1kind: CapacityBuffermetadata: name: web-app-buffer namespace: defaultspec: provisioningStrategy: "buffer.x-k8s.io/active-capacity" podTemplateRef: name: web-buffer-template replicas: 5 limits: cpu: "20" memory: "40Gi"O, para que la capacidad de reserva acompañe a un workload, apunta a un Deployment y define un porcentaje. Esto mantiene la capacidad del buffer en el 20% de las réplicas del Deployment api-service, así la capacidad de reserva crece y se reduce a medida que ese Deployment escala:
yaml
apiVersion: autoscaling.x-k8s.io/v1alpha1kind: CapacityBuffermetadata: name: api-service-buffer namespace: defaultspec: scalableRef: apiGroup: apps kind: Deployment name: api-service percentage: 20Cuando defines más de uno de estos valores, la cantidad final es min(max(replicas, percentage), limits). Es decir, replicas y percentage se combinan tomando el mayor, y limits pone un tope al resultado.
Hay algo que debes saber sobre la limpieza de nodos. Karpenter no eliminará un nodo por considerarlo vacío si aloja capacidad del buffer. Los pods virtuales del buffer impiden que cuente como vacío y Karpenter lo marca con el motivo Node has buffer pods. El resto de los tipos de limpieza sigue funcionando, y cualquier nodo de reemplazo debe seguir teniendo espacio para los pods del buffer, así que la capacidad de reserva siempre se mantiene completa.
CapacityBuffer está en alpha y desactivado por defecto. Se activa con el feature gate CapacityBuffer=true. Se agregó en la v1.13, y la v1.14 avanzó su API interna y sumó métricas de estado, pero sigue en alpha y la API puede cambiar. Pruébalo primero en un clúster de pruebas. Recuerda también que la capacidad de reserva cuesta dinero, porque pagas por nodos que están ociosos. Dimensiónala según el pico real que necesitas.
Consolidación Balanced: la nueva política de consolidación de Karpenter
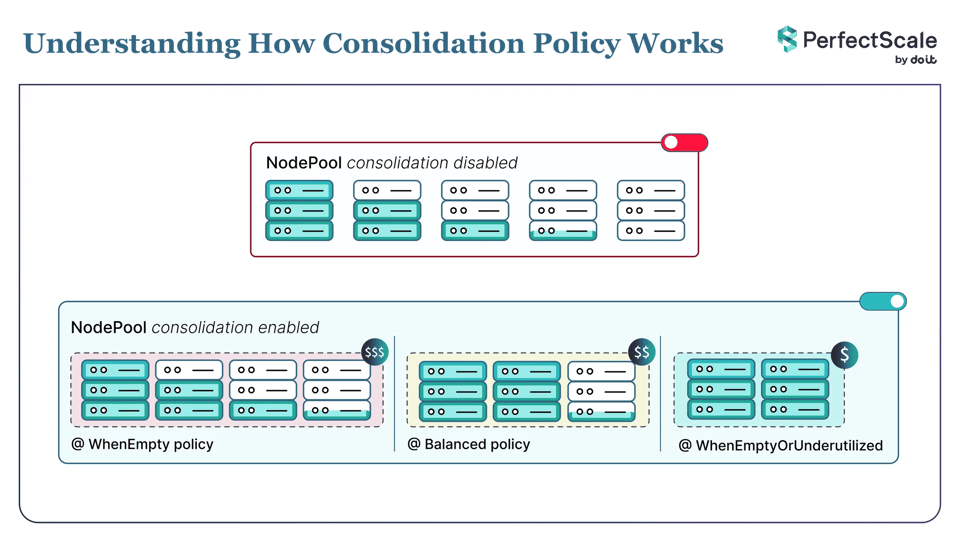
La consolidación es la forma en que Karpenter te ahorra dinero. Elimina nodos vacíos y compacta o reemplaza los que están subutilizados. La controlas con el campo consolidationPolicy de un NodePool. La v1.14 agrega una tercera opción, Balanced, así que ahora tienes tres:
| consolidationPolicy | Qué nodos considera | Cuándo elegirla |
|---|---|---|
| WhenEmpty | Solo nodos vacíos | Quieres el comportamiento más cauteloso y eliminar nodos solo cuando ya no ejecutan nada. |
| Balanced | Nodos donde el costo ahorrado justifica la disrupción de los pods | Quieres la mayor parte del ahorro sin mover nodos por ganancias pequeñas y marginales. |
| WhenEmptyOrUnderutilized | Cualquier nodo que se pueda eliminar o reemplazar para reducir costos | Quieres el costo más bajo y puedes aceptar la disrupción de pods que implica. |
Balanced puntúa cada acción de consolidación. Pondera cuánto costo ahorra la acción frente a cuánta disrupción de pods causa, y actúa solo cuando el ahorro justifica la disrupción. Por defecto cada pod cuenta igual, así que la disrupción es básicamente la cantidad de pods que se moverían. Los pods que cuestan más mover pueden pesar más. Por ejemplo, los pods de mayor prioridad cuentan como más disruptivos, así que es menos probable que se elimine su nodo.
Puedes ver por qué Karpenter tomó cada decisión. Una acción aprobada emite un evento ConsolidationApproved con la puntuación y los porcentajes de ahorro y disrupción. Karpenter también exporta las métricas karpenter_consolidation_score y karpenter_consolidation_moves_total, y registra las decisiones con --log-level debug.
Para usarla, define la política en tu NodePool:
yaml
apiVersion: karpenter.sh/v1kind: NodePoolmetadata: name: defaultspec: disruption: consolidationPolicy: BalancedUsa Balanced cuando WhenEmptyOrUnderutilized genera buenos ahorros pero mueve nodos con demasiada frecuencia, y WhenEmpty deja demasiada pérdida. Se ubica en el punto medio. Karpenter sigue eliminando los nodos vacíos y claramente subutilizados, pero omite los movimientos pequeños donde el ahorro no vale la pena. Esta es la única función nueva de la v1.14 que es un campo estable sin feature gate, así que puedes probarla con confianza. Actívala primero en un solo NodePool y observa los eventos y las métricas. Si no tienes claro qué política conviene a cada NodePool, PerfectScale te recomienda la política de consolidación correcta a partir de los datos reales de tus workloads, para que no tengas que adivinar.
Otros cambios en Karpenter v1.14
Algunos cambios menores que vale la pena conocer:
a. Tipos de instancia EC2 en vista previa (AWS): el proveedor de AWS ahora puede usar tipos de instancia EC2 que todavía están en vista previa, así puedes probar nuevas generaciones de instancias antes de su disponibilidad general.
b. Selección de nodos que considera los DaemonSets: Karpenter ahora verifica los requisitos de tipo de instancia de un DaemonSet al elegir un nodo, para que el nodo realmente pueda ejecutar tus DaemonSets.
c. Menos rotación en nodos nuevos: consolidateAfter ahora también aplica a los nodos de reemplazo creados durante la consolidación, así un nodo recién creado no se elimina de inmediato otra vez.
d. Etiqueta de zona en las métricas: las métricas de ciclo de vida de nodos y NodeClaims ahora incluyen una etiqueta de zona, lo que facilita el monitoreo por zona.
La lista completa está en las notas de la versión v1.14.0.
Cómo actualizar a Karpenter v1.14
Karpenter v1.14 funciona con Kubernetes 1.30 a 1.36. Esta es la matriz de compatibilidad:
| Kubernetes | 1.30 | 1.31 | 1.32 | 1.33 | 1.34 | 1.35 | 1.36 |
|---|---|---|---|---|---|---|---|
| Karpenter | >= 0.37 | >= 1.0.5 | >= 1.2 | >= 1.5 | >= 1.6 | >= 1.9 | >= 1.13 |
La v1.14.0 es una versión estable, y las versiones estables son las únicas recomendadas para producción.
Karpenter se instala desde un registro OCI público con Helm. Ten en cuenta que la versión del chart es 1.14.0 sin la v, mientras que el tag de Git es v1.14.0.
bash
helm upgrade --install karpenter oci://public.ecr.aws/karpenter/karpenter \ --version "1.14.0" \ --namespace "kube-system" --create-namespace \ --set "settings.clusterName=${CLUSTER_NAME}" \ --set "settings.interruptionQueue=${CLUSTER_NAME}" \ --set controller.resources.requests.cpu=1 \ --set controller.resources.requests.memory=1Gi \ --set controller.resources.limits.cpu=1 \ --set controller.resources.limits.memory=1Gi \ --waitPuedes verificar el chart firmado con cosign antes de instalarlo.
Lee la guía de actualización antes de actualizar, porque Karpenter lista los cambios incompatibles de cada versión menor. Aplica los CRDs de la nueva versión y luego actualiza el controlador. Avanzar una versión menor a la vez es el camino más seguro.
¿Está Karpenter v1.14 listo para producción?
En resumen, esto es lo que puedes usar con confianza hoy:
| Función | Qué hace | Madurez en v1.14 | Por defecto | Cómo controlarla |
|---|---|---|---|---|
| Asignador de DRA | Karpenter lee los claims de DRA (GPU/aceleradores) de un pod al elegir un nodo | Aún no es GA en Karpenter | Activado | Desactívalo con --ignore-dra-requests |
| CapacityBuffer | Mantiene capacidad de reserva lista para una programación instantánea | Alpha | Desactivado | Actívalo con el feature gate CapacityBuffer=true |
| Consolidación Balanced | Nueva política de consolidación que equilibra el ahorro frente a la disrupción | Campo estable | Opt-in por NodePool | Define consolidationPolicy: Balanced |
En resumen, puedes probar la consolidación Balanced en producción con confianza. Empieza con un solo NodePool. El soporte de DRA y CapacityBuffer todavía están en etapa temprana, así que mantenlos en pruebas o staging hasta que los hayas validado con tus propios workloads.
Optimiza el costo y el rendimiento de Karpenter con PerfectScale by DoiT
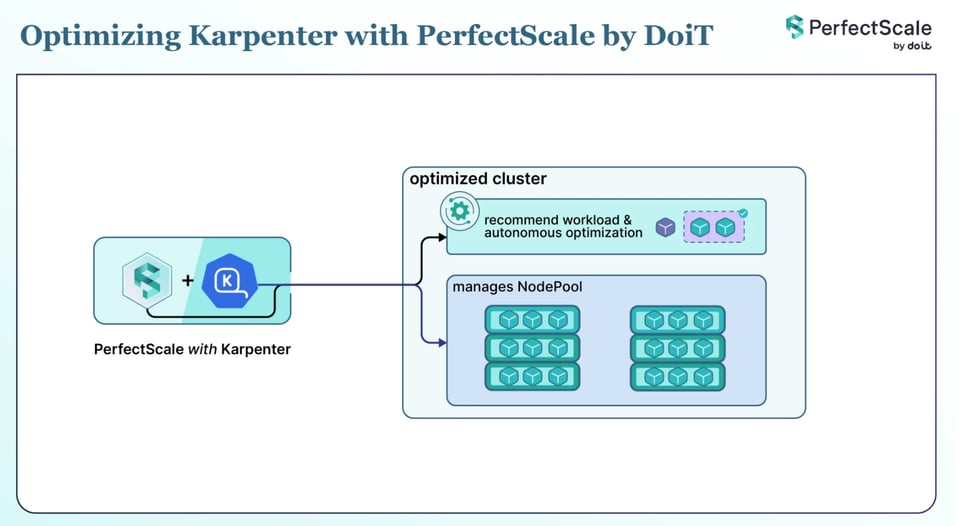
Karpenter y PerfectScale cumplen funciones distintas, y funcionan muy bien juntos. Karpenter trabaja a nivel de nodo: agrega y elimina nodos. PerfectScale trabaja a nivel de pod: observa tus workloads y convierte el uso real en recomendaciones de right-sizing que puedes aplicar de forma manual o autónoma. PerfectScale no reemplaza a Karpenter; lo ayuda a tomar mejores decisiones al elegir nodos.
Esto ayuda de dos maneras, y ambas importan más después de la v1.14:
- Ajusta primero los pods con right-sizing, para que Karpenter elija los nodos correctos. Karpenter lanza nodos según las solicitudes de CPU y memoria de tus pods. Si esas solicitudes están mal, Karpenter lanza los nodos equivocados. PerfectScale define los requests y limits a partir del uso real, así los números que lee Karpenter son correctos.
- Elige la configuración correcta del NodePool con datos reales. PerfectScale lee tu configuración de Karpenter y tus workloads y propone cambios: qué política de consolidación encaja, un retraso de consolidación (
consolidateAfter), más flexibilidad de instancias entre generación, familia y categoría, y límites de NodePool que están cerca de su tope. Ahora que Balanced es una opción, PerfectScale puede decirte qué política conviene a cada NodePool en lugar de adivinar. También señala los pods que no se pueden desalojar, que bloquean la consolidación con cualquier política, para que puedas corregirlos.
Equipos como Paramount Pictures y Creditas usan PerfectScale para mantener sus clústeres bien dimensionados y sus costos bajos. Regístrate o agenda una demo para ver PerfectScale en tu propio clúster.