
PerfectScale
Karpenter v1.14 : les nouveautés et comment mettre à niveau
Support DRA, nouvelle API CapacityBuffer et politique de consolidation Balanced : voici les nouveautés de Karpenter v1.14, comment effectuer la mise à niveau et ce qui est réellement prêt pour la production.
Cette page est également disponible en English, Deutsch, Español, Italiano, 日本語 et Português.


TLDR;
Karpenter v1.14, publié le 11 juillet 2026, ajoute trois fonctionnalités : le support de la Dynamic Resource Allocation (DRA) pour le scheduling des GPU et accélérateurs, une API CapacityBuffer en alpha pour réserver de la capacité de nœud disponible, et une nouvelle politique de consolidation Balanced qui met en balance les économies réalisées et la perturbation des pods. La consolidation Balanced est un champ stable et peut être utilisée en production sans risque ; le support DRA et CapacityBuffer n'en sont encore qu'à leurs débuts et méritent d'être testés d'abord en staging.
Karpenter v1.14 : les nouveautés et comment mettre à niveau
Karpenter v1.14 est la dernière version de l'autoscaler de nœuds Kubernetes. Elle apporte trois nouveautés principales : le support de la Dynamic Resource Allocation (DRA), une nouvelle API CapacityBuffer pour la capacité de réserve, et une nouvelle politique de consolidation Balanced. Deux d'entre elles n'en sont qu'à leurs débuts. Le support DRA n'est pas encore en GA dans Karpenter, et CapacityBuffer est en alpha et désactivée par défaut.
Les deux dépôts Karpenter ont publié la v1.14.0 le 11 juillet 2026 : le projet core et le provider AWS.
Cet article explique ce que fait chaque fonctionnalité, comment effectuer la mise à niveau et ce que vous pouvez utiliser en production dès aujourd'hui.
Un fil rouge traverse cette version. L'équipe Karpenter sait que la fiabilité et la disponibilité sont des priorités lorsque vous ajustez l'autoscaling. Personne ne veut réduire ses coûts au prix d'une interruption de service. La nouvelle politique de consolidation Balanced comme CapacityBuffer ont été conçues dans cet esprit. L'une réduit les coûts sans déplacer les nœuds que vous ne pouvez pas vous permettre de perdre. L'autre maintient de la capacité de réserve prête à l'emploi pour que les pods n'attendent pas. C'est exactement cette approche des coûts, où la fiabilité prime, que PerfectScale adopte depuis le premier jour.
Les nouveautés de Karpenter v1.14
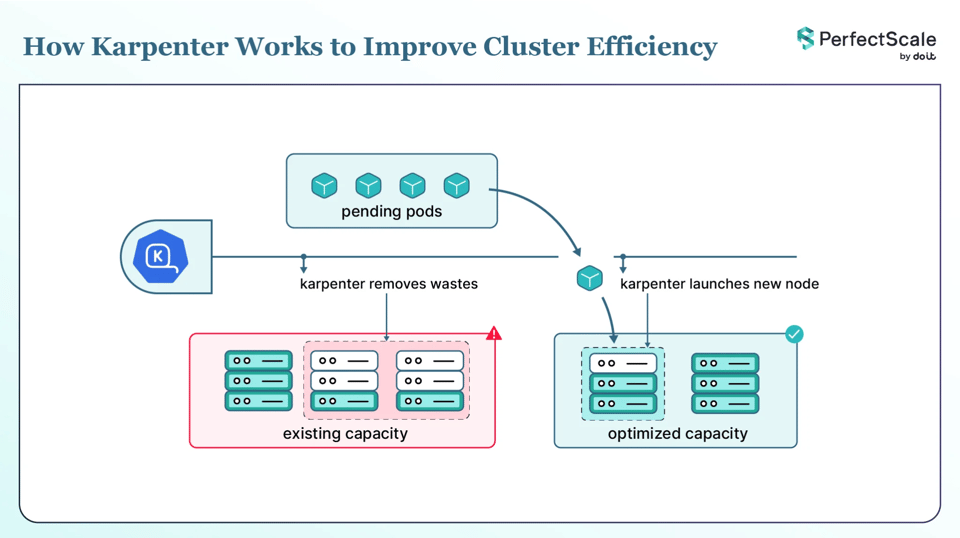
Karpenter lance des nœuds lorsque des pods ne peuvent pas être schedulés, et supprime les nœuds devenus inutiles. La v1.14 ne change rien à cette mission. Elle rend Karpenter plus intelligent pour les workloads GPU et matériels, vous permet de garder des nœuds de réserve prêts, et ajoute une manière plus mesurée de réduire les coûts.
Trois changements se démarquent dans cette version :
a. Support DRA : Karpenter lit désormais la demande DRA d'un pod lorsqu'il choisit un nœud. C'est surtout important pour les workloads GPU et les autres workloads matériels.
b. CapacityBuffer : vous pouvez garder des nœuds de réserve prêts pour que les pods démarrent immédiatement. Cette fonctionnalité est en alpha.
c. Consolidation Balanced : une nouvelle politique qui ne supprime un nœud que lorsque l'économie réalisée vaut la perturbation.
Le support DRA dans Karpenter v1.14
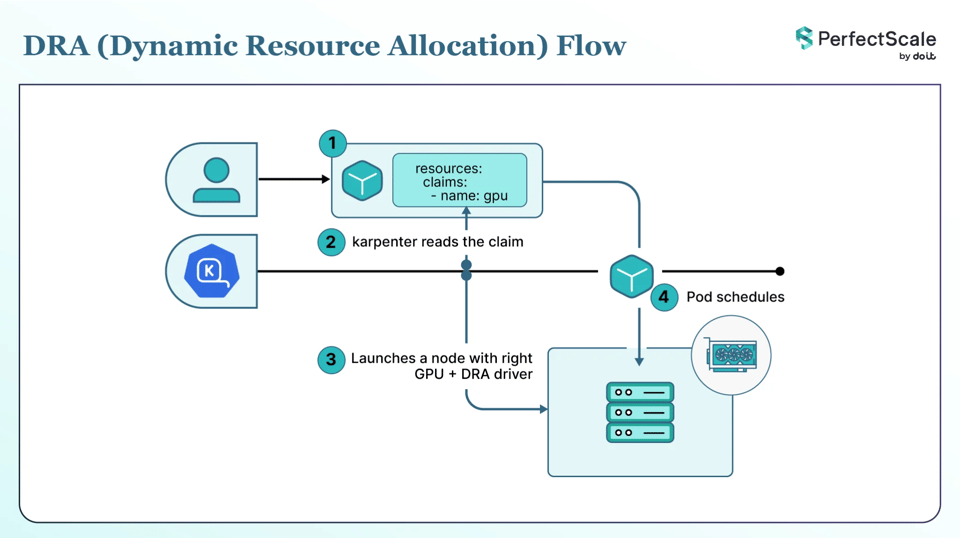
DRA est un mécanisme Kubernetes pour demander du matériel spécialisé comme des GPU et d'autres accélérateurs. Au lieu de demander un nombre fixe comme nvidia.com/gpu: 1, un pod décrit le périphérique dont il a besoin avec un ResourceClaim, et le scheduler choisit le périphérique réel. Chaque nœud a besoin d'un driver DRA pour votre matériel. DRA est en GA dans Kubernetes depuis la v1.34 et est activé par défaut à partir de cette version.
Avant la v1.14, Karpenter ne lisait pas ces demandes DRA lorsqu'il planifiait de nouveaux nœuds. Un pod qui avait besoin d'un GPU via DRA pouvait donc rester bloqué, car Karpenter ne lançait pas de nœud capable de l'exécuter. Pour contourner ce problème, vous deviez router ces pods vous-même vers les bons nœuds, avec un nodeSelector ou une node affinity, de la même façon que les pods GPU sont routés avec l'ancien modèle de device plugin. Karpenter lit ces informations, mais il ne pouvait pas lire le claim DRA de lui-même. La v1.14 ajoute un allocateur DRA. Karpenter lit désormais la demande DRA du pod et s'en sert pour choisir le bon nœud. Il gère aussi les périphériques partagés et divisibles, ce qui est utile lorsque plusieurs pods se partagent un accélérateur.
Vous n'avez rien à activer. La fonctionnalité est activée par défaut. Pour que Karpenter ignore les demandes DRA, utilisez le flag --ignore-dra-requests. Mais tout cela reste récent. Si vous exécutez des workloads GPU ou accélérateurs avec DRA, testez d'abord en staging. Vous avez également besoin de Kubernetes 1.34 ou ultérieur et d'un driver DRA pour votre matériel. La référence des paramètres détaille ce flag.
Karpenter CapacityBuffer : gardez des nœuds de réserve prêts
Les nouveaux nœuds mettent du temps à démarrer et à rejoindre le cluster. Pour les workloads soumis à des pics ou qui ne peuvent pas attendre, ce délai est pénalisant. Les pods restent en attente, et votre service ne peut pas monter en charge à temps pour absorber le trafic. CapacityBuffer vous permet de garder de la capacité de réserve prête, pour que les pods soient schedulés immédiatement au lieu d'attendre un nouveau nœud.
Le mécanisme repose sur des pods virtuels de substitution. Ces pods n'existent que dans la planification de Karpenter. Ce ne sont jamais de vrais pods dans votre cluster. Ils obligent Karpenter à garder des nœuds de réserve prêts, et ils se reconstituent d'eux-mêmes lorsque vos vrais pods utilisent l'espace de réserve.
Vous définissez la taille de la capacité de réserve de deux façons :
- podTemplateRef : pointez vers un PodTemplate qui décrit une unité de buffer, puis définissez replicas et/ou limits.
- scalableRef : pointez vers un Deployment, StatefulSet ou ReplicaSet, puis définissez un pourcentage pour que la capacité de réserve suive ce workload.
Voici un buffer fixe de cinq unités :
yaml
apiVersion: autoscaling.x-k8s.io/v1alpha1kind: CapacityBuffermetadata: name: web-app-buffer namespace: defaultspec: provisioningStrategy: "buffer.x-k8s.io/active-capacity" podTemplateRef: name: web-buffer-template replicas: 5 limits: cpu: "20" memory: "40Gi"Ou, pour que la capacité de réserve suive un workload, pointez vers un Deployment et définissez un pourcentage. Cette configuration maintient la capacité du buffer à 20 % des replicas du Deployment api-service, de sorte que la capacité de réserve augmente et diminue au rythme de ce Deployment :
yaml
apiVersion: autoscaling.x-k8s.io/v1alpha1kind: CapacityBuffermetadata: name: api-service-buffer namespace: defaultspec: scalableRef: apiGroup: apps kind: Deployment name: api-service percentage: 20Lorsque vous définissez plusieurs de ces valeurs, la valeur finale est min(max(replicas, percentage), limits). Replicas et percentage sont donc combinés en retenant la plus grande valeur, et limits plafonne le résultat.
Il y a une chose à savoir sur le nettoyage des nœuds. Karpenter ne supprimera pas un nœud en tant que nœud vide s'il héberge de la capacité de buffer. Les pods de buffer virtuels l'empêchent de compter comme vide, et Karpenter le marque avec la raison Node has buffer pods. Tous les autres types de nettoyage continuent de s'exécuter, et tout nœud de remplacement doit toujours pouvoir accueillir les pods de buffer, de sorte que la capacité de réserve reste au niveau requis.
CapacityBuffer est en alpha et désactivée par défaut. Vous l'activez avec la feature gate CapacityBuffer=true. Elle a été introduite en v1.13, et la v1.14 a fait évoluer son API interne et ajouté des métriques de statut, mais elle reste en alpha et l'API peut changer. Essayez-la d'abord sur un cluster de test. N'oubliez pas non plus que la capacité de réserve a un coût, car vous payez des nœuds inactifs. Dimensionnez-la selon le pic réel dont vous avez besoin.
Consolidation Balanced : la nouvelle politique de consolidation de Karpenter
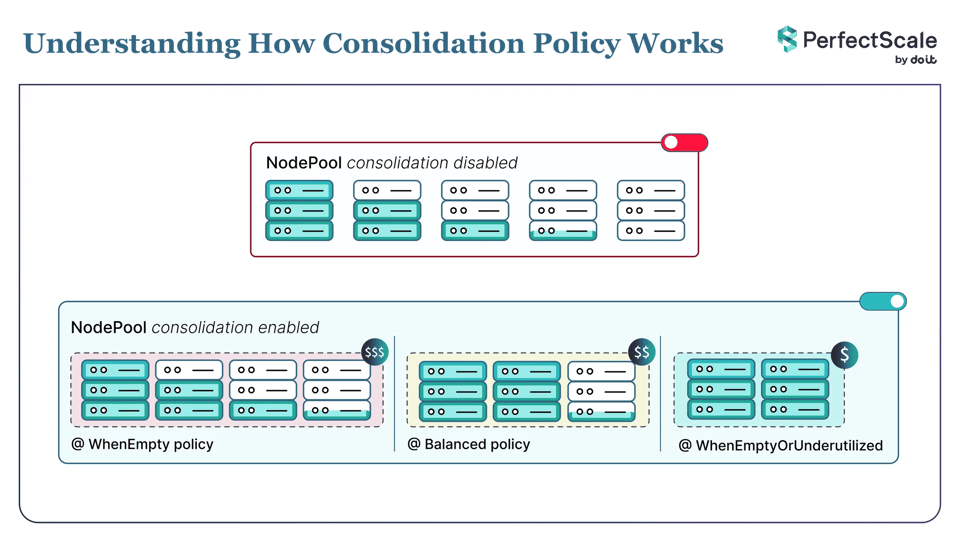
La consolidation est le moyen par lequel Karpenter vous fait économiser. Il supprime les nœuds vides et regroupe ou remplace les nœuds sous-utilisés. Vous la contrôlez avec le champ consolidationPolicy d'un NodePool. La v1.14 ajoute un troisième choix, Balanced, ce qui porte le total à trois :
| consolidationPolicy | Nœuds pris en compte | À choisir quand |
|---|---|---|
| WhenEmpty | Uniquement les nœuds vides | Vous voulez le comportement le plus prudent et ne supprimer les nœuds que lorsqu'ils n'exécutent plus rien. |
| Balanced | Les nœuds où l'économie réalisée vaut la perturbation des pods | Vous voulez l'essentiel des économies sans déplacer des nœuds pour des gains marginaux. |
| WhenEmptyOrUnderutilized | Tout nœud pouvant être supprimé ou remplacé pour réduire les coûts | Vous voulez le coût le plus bas et acceptez la perturbation des pods que cela implique. |
Balanced attribue un score à chaque action de consolidation. Elle met en balance l'économie générée par l'action et la perturbation des pods qu'elle provoque, et n'agit que lorsque l'économie est suffisamment importante par rapport à la perturbation. Par défaut, chaque pod compte de la même façon : la perturbation correspond donc essentiellement au nombre de pods à déplacer. Les pods plus coûteux à déplacer peuvent peser davantage. Par exemple, les pods à priorité plus élevée comptent comme plus perturbants, et leur nœud a donc moins de chances d'être supprimé.
Vous pouvez comprendre chaque décision de Karpenter. Une action approuvée émet un événement ConsolidationApproved avec le score et les pourcentages d'économie et de perturbation. Karpenter exporte aussi les métriques karpenter_consolidation_score et karpenter_consolidation_moves_total, et journalise les décisions avec --log-level debug.
Pour l'utiliser, définissez la politique sur votre NodePool :
yaml
apiVersion: karpenter.sh/v1kind: NodePoolmetadata: name: defaultspec: disruption: consolidationPolicy: BalancedUtilisez Balanced lorsque WhenEmptyOrUnderutilized génère de bonnes économies mais déplace les nœuds trop souvent, et que WhenEmpty laisse trop de gaspillage. Elle se situe entre les deux. Karpenter supprime toujours les nœuds vides et clairement sous-utilisés, mais évite les petits déplacements où l'économie n'en vaut pas la peine. C'est la seule nouveauté de la v1.14 qui soit un champ stable sans feature gate : vous pouvez donc l'essayer sans risque. Activez-la d'abord sur un seul NodePool et surveillez les événements et les métriques. Si vous hésitez sur la politique à appliquer à chaque NodePool, PerfectScale recommande la bonne politique de consolidation à partir des données réelles de vos workloads, pour ne plus avoir à deviner.
Autres changements de Karpenter v1.14
Quelques changements plus modestes à noter :
a. Types d'instances EC2 en preview (AWS) : le provider AWS peut désormais utiliser des types d'instances EC2 encore en preview, ce qui vous permet d'essayer les nouvelles générations d'instances avant leur disponibilité générale.
b. Choix de nœud tenant compte des DaemonSets : Karpenter vérifie désormais les besoins en type d'instance d'un DaemonSet lorsqu'il choisit un nœud, afin que le nœud puisse réellement exécuter vos DaemonSets.
c. Moins de churn sur les nouveaux nœuds : consolidateAfter s'applique désormais aussi aux nœuds de remplacement créés lors de la consolidation, pour qu'un nœud tout neuf ne soit pas supprimé dans la foulée.
d. Label de zone sur les métriques : les métriques de cycle de vie des nœuds et des NodeClaims incluent désormais un label de zone, ce qui facilite le monitoring par zone.
La liste complète figure dans les notes de version v1.14.0.
Comment mettre à niveau vers Karpenter v1.14
Karpenter v1.14 fonctionne avec Kubernetes 1.30 à 1.36. Voici la matrice de compatibilité :
| Kubernetes | 1.30 | 1.31 | 1.32 | 1.33 | 1.34 | 1.35 | 1.36 |
|---|---|---|---|---|---|---|---|
| Karpenter | >= 0.37 | >= 1.0.5 | >= 1.2 | >= 1.5 | >= 1.6 | >= 1.9 | >= 1.13 |
La v1.14.0 est une version stable, et seules les versions stables sont recommandées pour la production.
Karpenter s'installe depuis un registre OCI public avec Helm. Notez que la version du chart est 1.14.0 sans v, tandis que le tag Git est v1.14.0.
bash
helm upgrade --install karpenter oci://public.ecr.aws/karpenter/karpenter \ --version "1.14.0" \ --namespace "kube-system" --create-namespace \ --set "settings.clusterName=${CLUSTER_NAME}" \ --set "settings.interruptionQueue=${CLUSTER_NAME}" \ --set controller.resources.requests.cpu=1 \ --set controller.resources.requests.memory=1Gi \ --set controller.resources.limits.cpu=1 \ --set controller.resources.limits.memory=1Gi \ --waitVous pouvez vérifier le chart signé avec cosign avant l'installation.
Lisez le guide de mise à niveau avant de procéder, car Karpenter documente les breaking changes de chaque version mineure. Appliquez les CRD de la nouvelle version, puis mettez à niveau le controller. Monter d'une version mineure à la fois est la voie la plus sûre.
Karpenter v1.14 est-il prêt pour la production ?
Voici, en résumé, ce à quoi vous pouvez vous fier aujourd'hui :
| Fonctionnalité | Ce qu'elle fait | Maturité en v1.14 | Par défaut | Comment la contrôler |
|---|---|---|---|---|
| Allocateur DRA | Karpenter lit les claims DRA (GPU/accélérateur) d'un pod lorsqu'il choisit un nœud | Pas encore en GA dans Karpenter | Activé | Désactivez avec --ignore-dra-requests |
| CapacityBuffer | Garde de la capacité de réserve prête pour un scheduling instantané | Alpha | Désactivé | Activez avec la feature gate CapacityBuffer=true |
| Consolidation Balanced | Nouvelle politique de consolidation qui met en balance économies et perturbation | Champ stable | Opt-in par NodePool | Définissez consolidationPolicy: Balanced |
La consolidation Balanced peut donc être essayée en production sans risque. Commencez par un seul NodePool. Le support DRA et CapacityBuffer n'en sont encore qu'à leurs débuts : gardez-les en test ou en staging tant que vous n'y avez pas fait tourner vos propres workloads.
Optimisez les coûts et les performances de Karpenter avec PerfectScale by DoiT
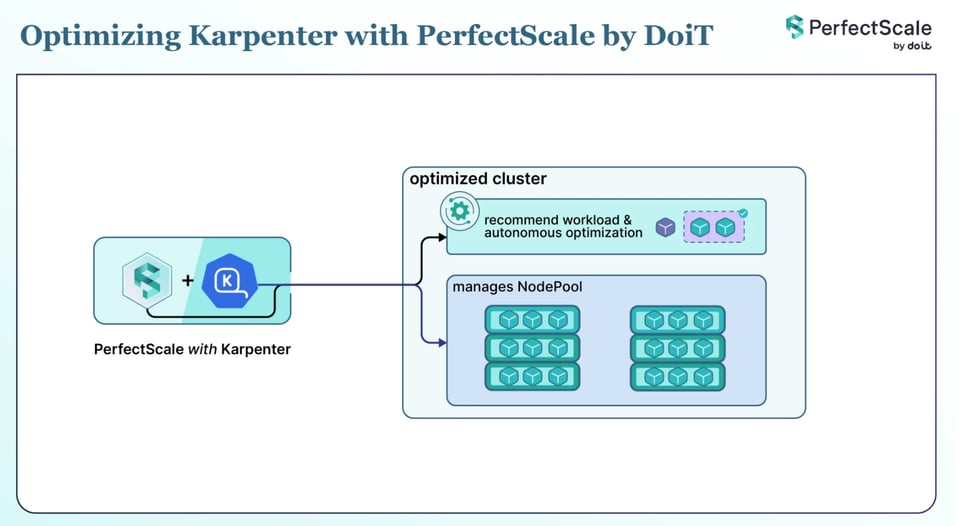
Karpenter et PerfectScale remplissent des rôles différents, et ils fonctionnent très bien ensemble. Karpenter agit au niveau du nœud. Il ajoute et supprime des nœuds. PerfectScale agit au niveau du pod. Il observe vos workloads et transforme l'utilisation réelle en recommandations de right-sizing que vous pouvez appliquer manuellement ou de façon autonome. PerfectScale ne remplace pas Karpenter. Il aide Karpenter à faire de meilleurs choix de nœuds.
Cela vous aide de deux façons, toutes deux encore plus importantes depuis la v1.14 :
- Commencez par le right-sizing des pods, pour que Karpenter choisisse les bons nœuds. Karpenter lance des nœuds en fonction des requests CPU et mémoire de vos pods. Si ces requests sont fausses, Karpenter lance les mauvais nœuds. PerfectScale définit les requests et les limits à partir de l'utilisation réelle, pour que les chiffres lus par Karpenter soient corrects.
- Choisissez les bons paramètres de NodePool à partir de données réelles. PerfectScale analyse votre configuration Karpenter et vos workloads, puis recommande des changements : la politique de consolidation adaptée, un délai de consolidation (
consolidateAfter), davantage de flexibilité d'instances selon la génération, la famille et la catégorie, et les limites de NodePool proches de leur plafond. Maintenant que Balanced est une option, PerfectScale peut vous indiquer quelle politique convient à chaque NodePool au lieu de deviner. Il signale aussi les pods non évictables, qui bloquent la consolidation quelle que soit la politique, pour que vous puissiez les corriger.
Des équipes comme Paramount Pictures et Creditas utilisent PerfectScale pour garder leurs clusters correctement dimensionnés et leurs coûts maîtrisés. Créez un compte ou réservez une démo pour voir PerfectScale à l'œuvre sur votre propre cluster.