
PerfectScale
Karpenter v1.14: Das ist neu – und so gelingt das Upgrade
DRA-Support, eine neue CapacityBuffer-API und die Balanced-Consolidation-Policy – hier erfahren Sie, was in Karpenter v1.14 neu ist, wie Sie upgraden und was wirklich produktionsreif ist.
Diese Seite ist auch in English, Español, Français, Italiano, 日本語 und Português verfügbar.


TLDR;
Karpenter v1.14, veröffentlicht am 11. Juli 2026, bringt drei Features: Dynamic-Resource-Allocation-Support (DRA) für GPU- und Accelerator-Scheduling, eine Alpha-CapacityBuffer-API zum Vorhalten freier Node-Kapazität und eine neue Balanced-Consolidation-Policy, die Kosteneinsparungen gegen Pod-Disruption abwägt. Balanced Consolidation ist ein stabiles Feld und produktionsreif; DRA-Support und CapacityBuffer befinden sich noch in einem frühen Stadium und sollten zunächst in Staging getestet werden.
Karpenter v1.14: Was ist neu und wie gelingt das Upgrade
Karpenter v1.14 ist das neueste Release des Kubernetes-Node-Autoscalers. Es bringt drei zentrale Neuerungen: Support für Dynamic Resource Allocation (DRA), eine neue CapacityBuffer-API für Reservekapazität und eine neue Balanced-Consolidation-Policy. Zwei davon sind noch in einem frühen Stadium: Der DRA-Support ist in Karpenter noch nicht GA, und CapacityBuffer ist Alpha und standardmäßig deaktiviert.
Beide Karpenter-Repos haben v1.14.0 am 11. Juli 2026 veröffentlicht: das Core-Projekt und der AWS-Provider.
Dieser Beitrag erklärt, was die einzelnen Features leisten, wie Sie upgraden und was Sie heute bedenkenlos in Produktion einsetzen können.
Ein roter Faden zieht sich durch dieses Release: Das Karpenter-Team weiß, dass Zuverlässigkeit und Verfügbarkeit an erster Stelle stehen, wenn Sie Autoscaling feinjustieren. Niemand will Kosten sparen und dafür einen Serviceausfall riskieren. Sowohl die neue Balanced-Consolidation-Policy als auch CapacityBuffer sind mit genau diesem Gedanken entwickelt. Die Policy spart Kosten, ohne Nodes zu verschieben, auf die Sie nicht verzichten können. Der Buffer hält Reservekapazität bereit, damit Pods nicht warten müssen. Genau diesen Reliability-first-Ansatz bei den Kosten verfolgt PerfectScale von Anfang an.
Was ist neu in Karpenter v1.14?
Karpenter startet Nodes, wenn Pods nicht eingeplant werden können, und entfernt Nodes, sobald sie nicht mehr gebraucht werden. Daran ändert v1.14 nichts. Das Release macht Karpenter schlauer im Umgang mit GPU- und Hardware-Workloads, gibt Ihnen eine Möglichkeit, Reserve-Nodes bereitzuhalten, und bringt einen schonenderen Weg, Kosten zu sparen.
Drei Änderungen stechen in diesem Release hervor:
a. DRA-Support: Karpenter berücksichtigt jetzt die DRA-Anforderung eines Pods bei der Node-Auswahl. Das ist vor allem für GPU- und andere Hardware-Workloads relevant.
b. CapacityBuffer: Sie können Reserve-Nodes bereithalten, damit Pods sofort starten. Dieses Feature ist Alpha.
c. Balanced Consolidation: eine neue Policy, die einen Node nur dann entfernt, wenn die Kostenersparnis die Disruption rechtfertigt.
DRA-Support in Karpenter v1.14
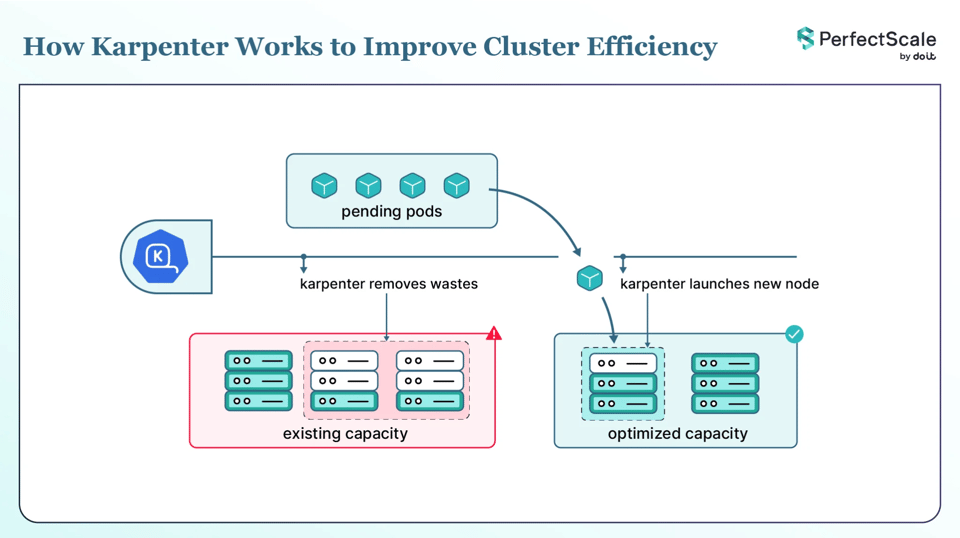
DRA ist der Kubernetes-Mechanismus, um spezielle Hardware wie GPUs und andere Acceleratoren anzufordern. Statt eine feste Anzahl wie nvidia.com/gpu: 1 anzufragen, beschreibt ein Pod das benötigte Gerät mit einem ResourceClaim, und der Scheduler wählt das konkrete Gerät aus. Jeder Node benötigt einen DRA-Treiber für Ihre Hardware. DRA ist seit Kubernetes v1.34 GA und ab dieser Version standardmäßig aktiviert.
Vor v1.14 hat Karpenter diese DRA-Anforderungen bei der Planung neuer Nodes nicht berücksichtigt. Ein Pod, der eine GPU über DRA benötigte, konnte deshalb hängen bleiben, weil Karpenter keinen Node startete, auf dem er laufen konnte. Als Workaround mussten Sie diese Pods selbst per nodeSelector oder Node-Affinity auf die richtigen Nodes lenken – so, wie GPU-Pods im älteren Device-Plugin-Modell geroutet werden. Diese Angaben liest Karpenter zwar, den DRA-Claim konnte es aber nicht eigenständig auswerten. v1.14 ergänzt einen DRA-Allocator. Karpenter liest jetzt die DRA-Anforderung des Pods und nutzt sie, um den passenden Node auszuwählen. Auch geteilte und aufteilbare Geräte werden unterstützt, was hilft, wenn sich mehrere Pods einen Accelerator teilen.
Sie müssen nichts aktivieren – das Feature ist standardmäßig eingeschaltet. Damit Karpenter DRA-Anforderungen ignoriert, setzen Sie das Flag --ignore-dra-requests. Das Feature ist allerdings noch jung. Wenn Sie GPU- oder Accelerator-Workloads mit DRA betreiben, testen Sie es zuerst in Staging. Außerdem benötigen Sie Kubernetes 1.34 oder neuer sowie einen DRA-Treiber für Ihre Hardware. Die Details zum Flag finden Sie in der Settings-Referenz.
Karpenter CapacityBuffer: Reserve-Nodes bereithalten
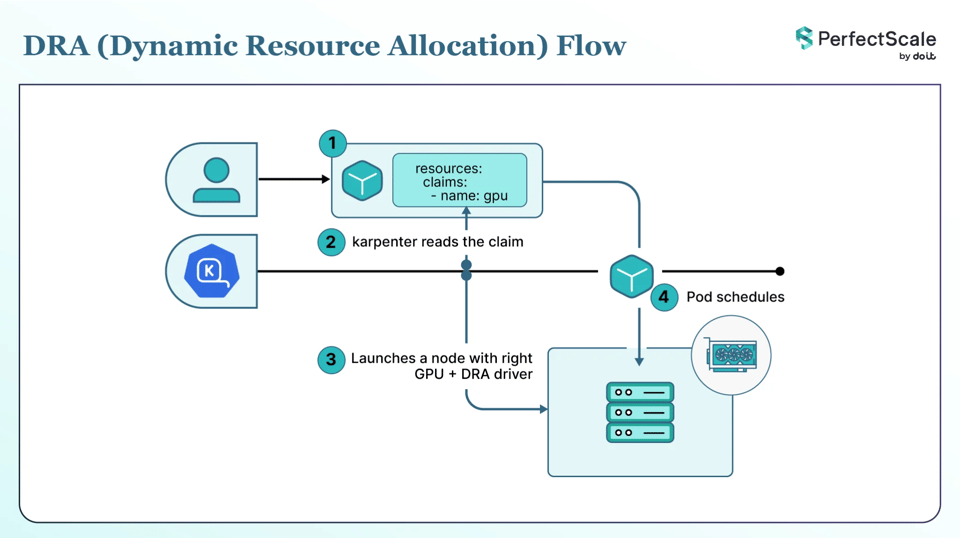
Neue Nodes brauchen Zeit, um zu starten und dem Cluster beizutreten. Für Workloads mit Lastspitzen oder ohne Toleranz für Wartezeiten ist diese Verzögerung ein echtes Problem. Pods bleiben pending, und Ihr Service kann nicht rechtzeitig hochskalieren, um den Traffic zu bedienen. Mit CapacityBuffer halten Sie Reservekapazität bereit, sodass Pods sofort eingeplant werden, statt auf einen neuen Node zu warten.
Das funktioniert über virtuelle Platzhalter-Pods. Diese Pods existieren nur in Karpenters Planung – sie werden nie zu echten Pods in Ihrem Cluster. Sie sorgen dafür, dass Karpenter Reserve-Nodes bereithält, und füllen sich automatisch wieder auf, wenn Ihre echten Pods die freie Kapazität nutzen.
Die Größe der Reservekapazität legen Sie auf einem von zwei Wegen fest:
- podTemplateRef: Verweisen Sie auf ein PodTemplate, das einen Buffer-Baustein beschreibt, und setzen Sie dann replicas und/oder limits.
- scalableRef: Verweisen Sie auf ein Deployment, StatefulSet oder ReplicaSet und setzen Sie einen Prozentsatz, damit die Reservekapazität mit diesem Workload Schritt hält.
So sieht ein fester Buffer mit fünf Bausteinen aus:
yaml
apiVersion: autoscaling.x-k8s.io/v1alpha1kind: CapacityBuffermetadata: name: web-app-buffer namespace: defaultspec: provisioningStrategy: "buffer.x-k8s.io/active-capacity" podTemplateRef: name: web-buffer-template replicas: 5 limits: cpu: "20" memory: "40Gi"Oder Sie koppeln die Reservekapazität an einen Workload: Verweisen Sie auf ein Deployment und setzen Sie einen Prozentsatz. So bleibt die Buffer-Kapazität bei 20 % der Replicas des api-service-Deployments – die Reservekapazität wächst und schrumpft also mit diesem Deployment:
yaml
apiVersion: autoscaling.x-k8s.io/v1alpha1kind: CapacityBuffermetadata: name: api-service-buffer namespace: defaultspec: scalableRef: apiGroup: apps kind: Deployment name: api-service percentage: 20Wenn Sie mehrere dieser Werte setzen, ergibt sich die finale Anzahl aus min(max(replicas, percentage), limits). Replicas und Prozentsatz werden also kombiniert, indem der größere Wert genommen wird, und limits deckelt das Ergebnis.
Einen Punkt zur Node-Bereinigung sollten Sie kennen: Karpenter stuft einen Node nicht als leer ein und entfernt ihn nicht, solange er Buffer-Kapazität hält. Die virtuellen Buffer-Pods verhindern, dass er als leer zählt, und Karpenter markiert ihn mit dem Grund Node has buffer pods. Alle anderen Bereinigungsarten laufen weiter, und jeder Ersatz-Node muss die Buffer-Pods weiterhin aufnehmen können, sodass die Reservekapazität erhalten bleibt.
CapacityBuffer ist Alpha und standardmäßig deaktiviert. Sie aktivieren es mit dem Feature-Gate CapacityBuffer=true. Eingeführt wurde es in v1.13; v1.14 hat die interne API weiterentwickelt und Status-Metriken ergänzt, aber es bleibt Alpha, und die API kann sich noch ändern. Probieren Sie es zuerst in einem Test-Cluster aus. Bedenken Sie außerdem: Reservekapazität kostet Geld, denn Sie zahlen für Nodes, die ungenutzt laufen. Dimensionieren Sie sie auf den Burst, den Sie tatsächlich brauchen.
Balanced Consolidation: Karpenters neue Consolidation-Policy
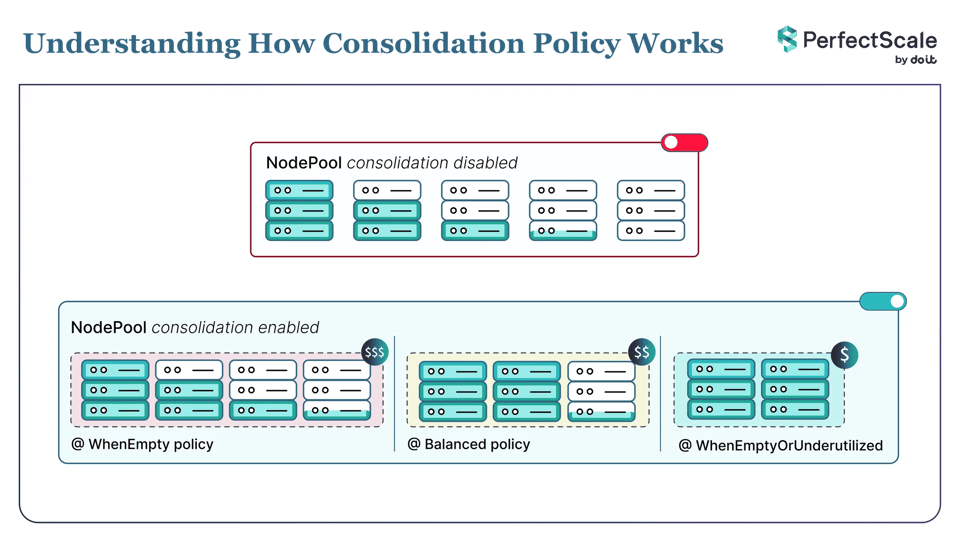
Über die Konsolidierung spart Karpenter Ihnen Geld: Es entfernt leere Nodes und verdichtet oder ersetzt schlecht ausgelastete. Gesteuert wird das über das Feld consolidationPolicy in einem NodePool. v1.14 ergänzt eine dritte Option, Balanced, sodass Sie jetzt drei zur Auswahl haben:
| consolidationPolicy | Welche Nodes betrachtet werden | Wann Sie sie wählen sollten |
|---|---|---|
| WhenEmpty | Nur leere Nodes | Sie wollen das vorsichtigste Verhalten und entfernen Nodes erst, wenn nichts mehr darauf läuft. |
| Balanced | Nodes, bei denen die Kostenersparnis die Pod-Disruption rechtfertigt | Sie wollen den Großteil der Einsparungen, ohne Nodes für kleine, marginale Gewinne zu verschieben. |
| WhenEmptyOrUnderutilized | Jeder Node, der zur Kostensenkung entfernt oder ersetzt werden kann | Sie wollen die niedrigsten Kosten und nehmen die dafür nötige Pod-Disruption in Kauf. |
Balanced bewertet jede Konsolidierungsaktion mit einem Score. Es wägt ab, wie viel Kosten die Aktion spart und wie viel Pod-Disruption sie verursacht, und handelt nur, wenn die Ersparnis die Disruption aufwiegt. Standardmäßig zählt jeder Pod gleich, die Disruption entspricht also im Wesentlichen der Anzahl der Pods, die verschoben würden. Pods, deren Verschiebung teurer ist, können stärker gewichtet werden. Pods mit höherer Priorität zählen zum Beispiel als disruptiver, sodass ihr Node seltener entfernt wird.
Sie können nachvollziehen, warum Karpenter sich jeweils so entschieden hat. Eine genehmigte Aktion löst ein ConsolidationApproved-Event mit dem Score sowie den Prozentwerten für Ersparnis und Disruption aus. Karpenter exportiert außerdem die Metriken karpenter_consolidation_score und karpenter_consolidation_moves_total und protokolliert die Entscheidungen bei --log-level debug.
Zur Nutzung setzen Sie die Policy in Ihrem NodePool:
yaml
apiVersion: karpenter.sh/v1kind: NodePoolmetadata: name: defaultspec: disruption: consolidationPolicy: BalancedNutzen Sie Balanced, wenn WhenEmptyOrUnderutilized zwar gut spart, aber zu oft Nodes verschiebt, und WhenEmpty zu viel ungenutzte Kapazität stehen lässt. Balanced liegt in der Mitte. Karpenter entfernt weiterhin leere und klar unterausgelastete Nodes, überspringt aber die kleinen Aktionen, bei denen sich die Ersparnis nicht lohnt. Das ist das einzige neue Feature in v1.14, das ein stabiles Feld ohne Feature-Gate ist – Sie können es also bedenkenlos ausprobieren. Aktivieren Sie es zuerst für einen NodePool und beobachten Sie Events und Metriken. Wenn Sie unsicher sind, welche Policy zu welchem NodePool passt: PerfectScale empfiehlt die passende Consolidation-Policy auf Basis Ihrer echten Workload-Daten, damit Sie nicht raten müssen.
Weitere Änderungen in Karpenter v1.14
Einige kleinere Änderungen, die Sie kennen sollten:
a. EC2-Preview-Instance-Typen (AWS): Der AWS-Provider kann jetzt EC2-Instance-Typen nutzen, die noch in der Preview sind. So können Sie neue Instance-Generationen ausprobieren, bevor sie allgemein verfügbar sind.
b. Node-Auswahl mit Blick auf DaemonSets: Karpenter prüft jetzt die Instance-Typ-Anforderungen eines DaemonSets bei der Node-Auswahl, damit der Node Ihre DaemonSets auch tatsächlich ausführen kann.
c. Weniger Churn bei neuen Nodes: consolidateAfter gilt jetzt auch für Ersatz-Nodes, die während der Konsolidierung entstehen, sodass ein frischer Node nicht sofort wieder entfernt wird.
d. Zone-Label bei Metriken: Lifecycle-Metriken für Nodes und NodeClaims enthalten jetzt ein Zone-Label, was das Monitoring pro Zone erleichtert.
Die vollständige Liste finden Sie in den Release Notes zu v1.14.0.
So upgraden Sie auf Karpenter v1.14
Karpenter v1.14 unterstützt Kubernetes 1.30 bis 1.36. Hier die Support-Matrix:
| Kubernetes | 1.30 | 1.31 | 1.32 | 1.33 | 1.34 | 1.35 | 1.36 |
|---|---|---|---|---|---|---|---|
| Karpenter | >= 0.37 | >= 1.0.5 | >= 1.2 | >= 1.5 | >= 1.6 | >= 1.9 | >= 1.13 |
v1.14.0 ist ein Stable-Release, und nur Stable-Releases werden für den Produktionseinsatz empfohlen.
Karpenter wird per Helm aus einer öffentlichen OCI-Registry installiert. Beachten Sie: Die Chart-Version lautet 1.14.0 ohne v, der Git-Tag dagegen v1.14.0.
bash
helm upgrade --install karpenter oci://public.ecr.aws/karpenter/karpenter \ --version "1.14.0" \ --namespace "kube-system" --create-namespace \ --set "settings.clusterName=${CLUSTER_NAME}" \ --set "settings.interruptionQueue=${CLUSTER_NAME}" \ --set controller.resources.requests.cpu=1 \ --set controller.resources.requests.memory=1Gi \ --set controller.resources.limits.cpu=1 \ --set controller.resources.limits.memory=1Gi \ --waitVor der Installation können Sie das signierte Chart mit cosign verifizieren.
Lesen Sie vor dem Upgrade den Upgrade-Guide, denn Karpenter listet für jede Minor-Version alle Breaking Changes auf. Spielen Sie zuerst die CRDs der neuen Version ein und upgraden Sie dann den Controller. Am sichersten ist es, immer nur eine Minor-Version auf einmal zu erhöhen.
Ist Karpenter v1.14 produktionsreif?
Hier die kurze Antwort, worauf Sie sich heute verlassen können:
| Feature | Was es tut | Reifegrad in v1.14 | Standard | So steuern Sie es |
|---|---|---|---|---|
| DRA-Allocator | Karpenter berücksichtigt die DRA-Claims (GPU/Accelerator) eines Pods bei der Node-Auswahl | In Karpenter noch nicht GA | An | Deaktivieren mit --ignore-dra-requests |
| CapacityBuffer | Hält Reservekapazität für sofortiges Scheduling bereit | Alpha | Aus | Aktivieren mit dem Feature-Gate CapacityBuffer=true |
| Balanced Consolidation | Neue Consolidation-Policy, die Einsparungen gegen Disruption abwägt | Stabiles Feld | Opt-in pro NodePool | consolidationPolicy: Balanced setzen |
Balanced Consolidation können Sie also bedenkenlos in Produktion ausprobieren. Starten Sie mit einem NodePool. DRA-Support und CapacityBuffer sind noch in einem frühen Stadium – lassen Sie beide in Test oder Staging, bis Sie Ihre eigenen Workloads damit durchgetestet haben.
Karpenter-Kosten und -Performance optimieren mit PerfectScale by DoiT
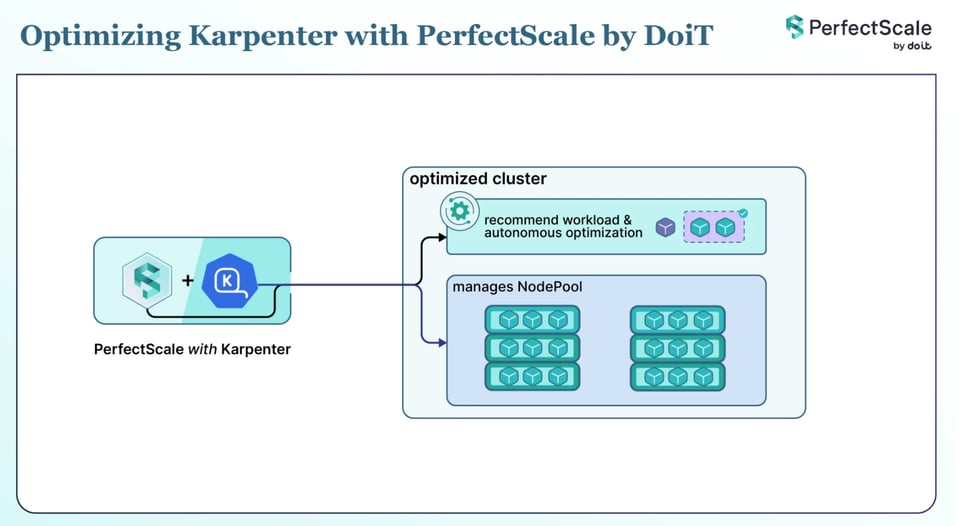
Karpenter und PerfectScale erledigen unterschiedliche Aufgaben – und arbeiten gut zusammen. Karpenter arbeitet auf Node-Ebene: Es fügt Nodes hinzu und entfernt sie. PerfectScale arbeitet auf Pod-Ebene: Es beobachtet Ihre Workloads und macht aus der realen Nutzung Right-Sizing-Empfehlungen, die Sie manuell oder autonom anwenden können. PerfectScale ersetzt Karpenter nicht. Es hilft Karpenter, bessere Node-Entscheidungen zu treffen.
Das hilft in zweierlei Hinsicht, und beides ist nach v1.14 noch wichtiger:
- Zuerst die Pods per Right-Sizing anpassen, damit Karpenter die richtigen Nodes wählt. Karpenter startet Nodes auf Basis der CPU- und Memory-Requests Ihrer Pods. Sind diese Requests falsch, startet Karpenter die falschen Nodes. PerfectScale setzt Requests und Limits auf Basis der realen Nutzung, sodass die Zahlen, die Karpenter liest, stimmen.
- Die richtigen NodePool-Einstellungen aus echten Daten ableiten. PerfectScale analysiert Ihr Karpenter-Setup und Ihre Workloads und empfiehlt Änderungen: welche Consolidation-Policy passt, eine Konsolidierungsverzögerung (
consolidateAfter), mehr Instance-Flexibilität über Generation, Familie und Kategorie hinweg sowie NodePool-Limits, die nahe an ihrer Obergrenze liegen. Jetzt, wo Balanced zur Auswahl steht, kann PerfectScale Ihnen sagen, welche Policy zu welchem NodePool passt – statt zu raten. Es markiert außerdem Pods, die nicht evicted werden können und die Konsolidierung unter jeder Policy blockieren, damit Sie sie beheben können.
Teams wie Paramount Pictures und Creditas nutzen PerfectScale, um ihre Cluster passend dimensioniert und ihre Kosten niedrig zu halten. Registrieren Sie sich oder buchen Sie eine Demo, um PerfectScale auf Ihrem eigenen Cluster zu erleben.