


TLDR;
2026年7月11日にリリースされたKarpenter v1.14では、3つの機能が追加されました。GPUやアクセラレーターのスケジューリングに対応するDynamic Resource Allocation(DRA)サポート、ノードの予備容量を確保するアルファ版のCapacityBuffer API、そしてコスト削減効果とPodの中断を天秤にかける新しいBalancedコンソリデーションポリシーです。Balancedコンソリデーションは安定版のフィールドで、本番環境でも安全に利用できます。DRAサポートとCapacityBufferはまだ初期段階のため、まずステージング環境で検証するのがおすすめです。
Karpenter v1.14:新機能とアップグレード方法
Karpenter v1.14は、Kubernetesノードオートスケーラーの最新リリースです。主な追加点は3つ。Dynamic Resource Allocation(DRA)のサポート、予備容量のための新しいCapacityBuffer API、そして新しいBalancedコンソリデーションポリシーです。このうち2つはまだ初期段階です。DRAサポートはKarpenterではまだGAではなく、CapacityBufferはアルファ版でデフォルトでは無効です。
2026年7月11日、Karpenterの2つのリポジトリ(コアプロジェクトとAWSプロバイダー)でv1.14.0がリリースされました。
本記事では、それぞれの機能の内容、アップグレード方法、そして現時点で本番環境に安全に導入できるものを解説します。
今回のリリースには一貫したテーマがあります。Karpenterチームは、オートスケーリングをチューニングする際に信頼性と可用性が最重要であることを理解しています。サービス障害と引き換えにコストを削減したい人はいません。新しいBalancedコンソリデーションポリシーもCapacityBufferも、この考え方に基づいて設計されています。前者は、失うわけにはいかないノードを動かすことなくコストを削減し、後者は予備容量を確保してPodを待たせません。これは、PerfectScaleが当初から採用してきた、信頼性を最優先するコスト最適化のアプローチと同じものです。
Karpenter v1.14の新機能
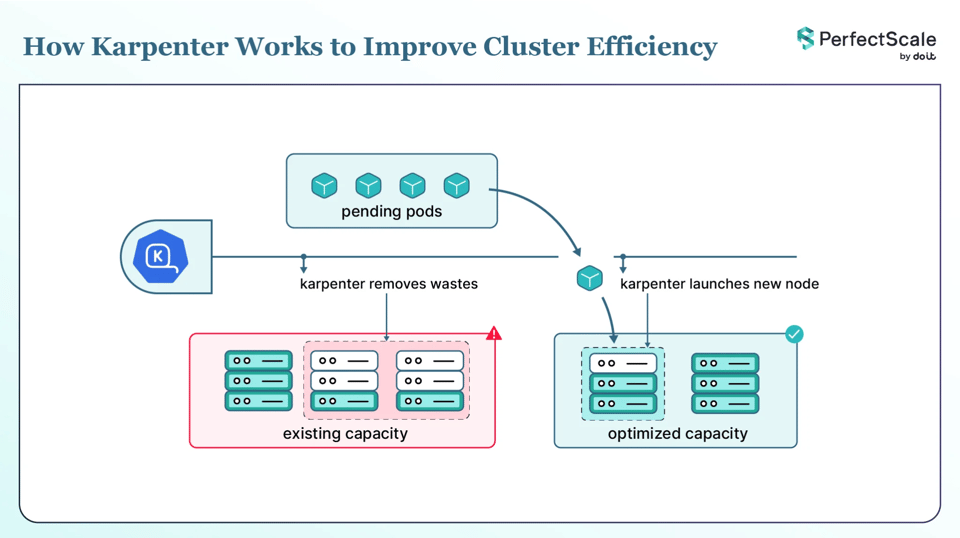
Karpenterは、Podがスケジュールできないときにノードを起動し、不要になったノードを削除します。v1.14でもこの役割は変わりません。変わったのは、GPUやハードウェアのワークロードに対してより賢くなったこと、予備ノードを確保する手段が加わったこと、そしてより穏やかなコスト削減方法が追加されたことです。
このリリースで注目すべき変更は3つあります。
a. DRAサポート:Karpenterがノードを選ぶ際にPodのDRAリクエストを読み取るようになりました。GPUなどのハードウェアワークロードで特に重要です。
b. CapacityBuffer:予備ノードを常に用意しておくことで、Podをすぐに起動できます。こちらはアルファ版です。
c. Balancedコンソリデーション:削減できるコストが中断に見合う場合にのみノードを削除する新しいポリシーです。
Karpenter v1.14のDRAサポート
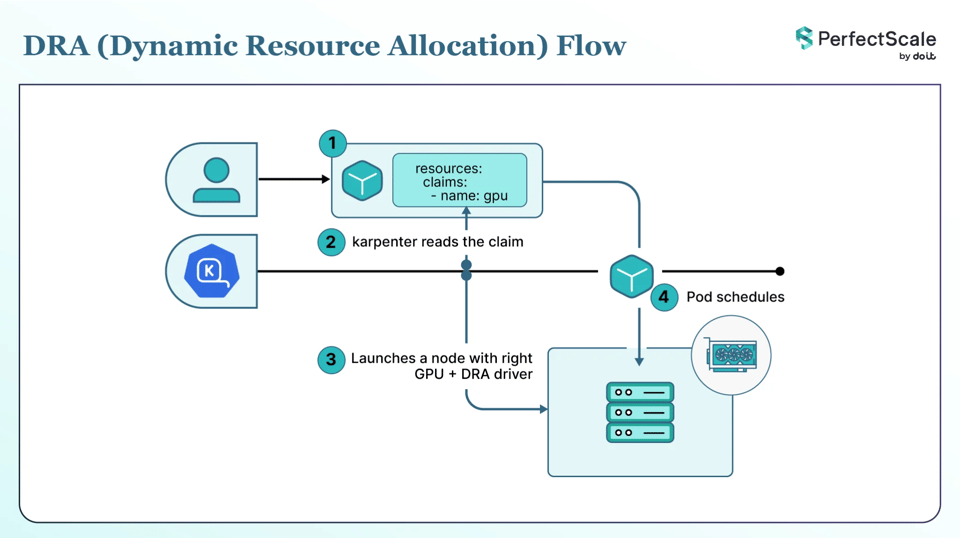
DRAは、GPUをはじめとするアクセラレーターなどの特殊なハードウェアを要求するためのKubernetesの仕組みです。nvidia.com/gpu: 1のように固定数を指定する代わりに、PodはResourceClaimで必要なデバイスを記述し、スケジューラーが実際のデバイスを選択します。各ノードには対象ハードウェア用のDRAドライバーが必要です。DRAはKubernetes v1.34でGAとなり、同バージョン以降はデフォルトで有効です。
v1.14より前のKarpenterは、新しいノードを計画する際にこれらのDRAリクエストを読み取っていませんでした。そのため、DRA経由でGPUを必要とするPodは、それを実行できるノードをKarpenterが起動しないためにスケジュールされないまま止まってしまうことがありました。回避策として、旧来のデバイスプラグインモデルでGPU Podを振り分けるのと同じように、nodeSelectorやnode affinityを使って自分で適切なノードへ振り分ける必要がありました。Karpenterはそれらを読み取れますが、DRAクレーム自体を読み取ることはできなかったのです。v1.14ではDRAアロケーターが追加されました。KarpenterはPodのDRAリクエストを読み取り、それをもとに適切なノードを選択します。共有デバイスや分割可能なデバイスにも対応しており、複数のPodが1つのアクセラレーターを共有する場合に役立ちます。
この機能を有効化する必要はありません。デフォルトで有効です。KarpenterにDRAリクエストを無視させたい場合は、--ignore-dra-requestsフラグを設定してください。ただし、この機能はまだ初期段階です。DRAでGPUやアクセラレーターのワークロードを実行している場合は、まずステージング環境で試してください。また、Kubernetes 1.34以降と、対象ハードウェア用のDRAドライバーが必要です。フラグの詳細はSettingsリファレンスを参照してください。
Karpenter CapacityBuffer:予備ノードを常に確保
新しいノードが起動してクラスターに参加するまでには時間がかかります。スパイクが発生するワークロードや待てないワークロードにとって、この遅延は痛手です。PodはPendingのままとなり、トラフィックをさばくためのスケールアップが間に合いません。CapacityBufferを使えば、あらかじめ予備容量を確保しておけるため、新しいノードを待つことなくPodをすぐにスケジュールできます。
この機能は仮想のプレースホルダーPodで動作します。これらのPodはKarpenterの計画の中にのみ存在し、クラスター内に実際のPodとして作られることはありません。仮想PodによってKarpenterは予備ノードを維持し、実際のPodが予備スペースを使用すると自動的に補充されます。
予備容量のサイズは、次の2つの方法のいずれかで指定します。
- podTemplateRef: バッファ1単位を表すPodTemplateを指定し、replicasやlimitsを設定します。
- scalableRef: Deployment、StatefulSet、またはReplicaSetを指定し、パーセンテージを設定して予備容量をそのワークロードに連動させます。
以下は5単位の固定バッファの例です。
yaml
apiVersion: autoscaling.x-k8s.io/v1alpha1kind: CapacityBuffermetadata: name: web-app-buffer namespace: defaultspec: provisioningStrategy: "buffer.x-k8s.io/active-capacity" podTemplateRef: name: web-buffer-template replicas: 5 limits: cpu: "20" memory: "40Gi"あるいは、予備容量をワークロードに連動させるには、Deploymentを指定してパーセンテージを設定します。以下の例では、バッファ容量をapi-service Deploymentのレプリカ数の20%に保つため、そのDeploymentのスケールに合わせて予備容量が増減します。
yaml
apiVersion: autoscaling.x-k8s.io/v1alpha1kind: CapacityBuffermetadata: name: api-service-buffer namespace: defaultspec: scalableRef: apiGroup: apps kind: Deployment name: api-service percentage: 20これらを複数設定した場合、最終的な数はmin(max(replicas, percentage), limits)となります。つまり、replicasとpercentageは大きい方が採用され、limitsが上限として機能します。
ノードのクリーンアップについて1つ知っておくべきことがあります。Karpenterは、バッファ容量を保持しているノードを「空」として削除しません。仮想バッファPodがあることで空とはカウントされず、KarpenterはNode has buffer podsという理由でマークします。それ以外のクリーンアップはすべて通常どおり実行されますが、代替ノードもバッファPodを収容できる必要があるため、予備容量は常に維持されます。
CapacityBufferはアルファ版で、デフォルトでは無効です。CapacityBuffer=trueフィーチャーゲートで有効化します。v1.13で追加され、v1.14では内部APIが更新されてステータスメトリクスが追加されましたが、依然としてアルファ版であり、APIは変更される可能性があります。まずはテストクラスターで試してください。また、予備容量にはコストがかかることも忘れないでください。アイドル状態のノードにも料金が発生するため、実際に必要なバーストに合わせてサイズを設定しましょう。
Balancedコンソリデーション:Karpenterの新しいコンソリデーションポリシー
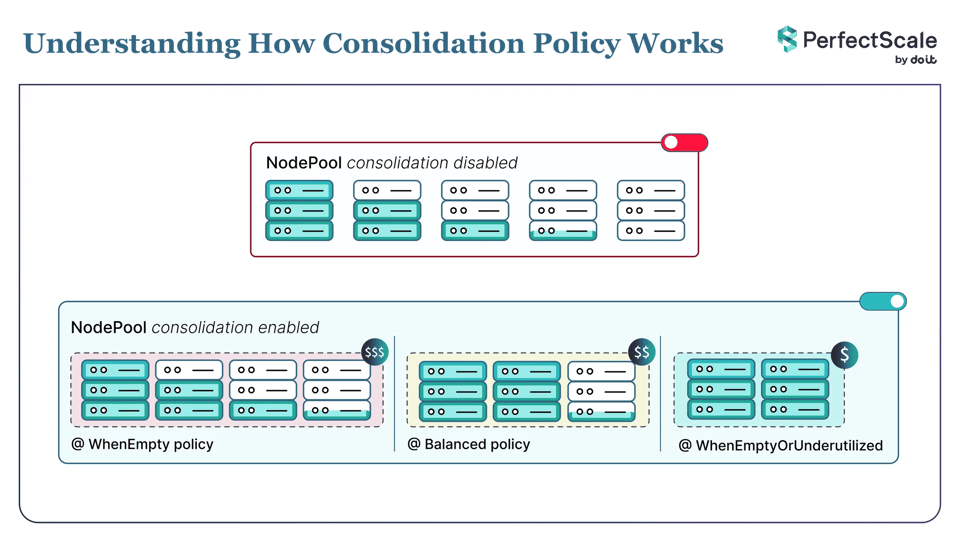
コンソリデーションは、Karpenterがコストを削減する仕組みです。空のノードを削除し、使用率の低いノードを集約または置き換えます。NodePoolのconsolidationPolicyフィールドで制御します。v1.14では3つ目の選択肢としてBalancedが追加され、選択肢は次の3つになりました。
| consolidationPolicy | 対象となるノード | 選ぶべき場面 |
|---|---|---|
| WhenEmpty | 空のノードのみ | 最も慎重な動作を望み、何も実行されていないノードだけを削除したい場合。 |
| Balanced | コスト削減がPodの中断に見合うノード | わずかな削減のためにノードを動かすことなく、削減効果の大部分を得たい場合。 |
| WhenEmptyOrUnderutilized | コスト削減のために削除または置き換え可能なあらゆるノード | コストを最小限に抑えたい場合で、それに伴うPodの中断を許容できるとき。 |
Balancedは、各コンソリデーションアクションをスコアリングします。アクションによる削減額とPodの中断量を比較し、中断に見合うだけの削減がある場合にのみ実行します。デフォルトでは各Podは同じ重みでカウントされるため、中断量は基本的に移動するPodの数となります。移動コストの高いPodはより大きくカウントされます。たとえば、優先度の高いPodはより中断度が高いとみなされるため、そのノードは削除されにくくなります。
Karpenterがなぜその判断をしたのかも確認できます。承認されたアクションは、スコアと削減率・中断率を含むConsolidationApprovedイベントを発行します。Karpenterはkarpenter_consolidation_scoreとkarpenter_consolidation_moves_totalのメトリクスもエクスポートし、--log-level debugで判断内容をログに出力します。
利用するには、NodePoolでポリシーを設定します。
yaml
apiVersion: karpenter.sh/v1kind: NodePoolmetadata: name: defaultspec: disruption: consolidationPolicy: BalancedWhenEmptyOrUnderutilizedでは削減効果は高いもののノードの移動が多すぎ、WhenEmptyでは無駄が多く残りすぎる──そんな場合にBalancedを使いましょう。Balancedはその中間に位置します。Karpenterは空のノードや明らかに使用率の低いノードは引き続き削除しますが、削減効果が見合わない小さな移動はスキップします。これはv1.14の新機能の中で唯一、フィーチャーゲート不要の安定版フィールドであり、安心して試せます。まず1つのNodePoolで有効化し、イベントとメトリクスを確認してください。どのポリシーが各NodePoolに合うかわからない場合は、PerfectScaleが実際のワークロードデータから最適なコンソリデーションポリシーを推奨するため、推測に頼る必要はありません。
Karpenter v1.14のその他の変更点
注目すべき小さな変更がいくつかあります。
a. EC2プレビューインスタンスタイプ(AWS):AWSプロバイダーがプレビュー段階のEC2インスタンスタイプを利用できるようになり、一般提供前に新しいインスタンス世代を試せます。
b. DaemonSetを考慮したノード選択:Karpenterがノードを選ぶ際にDaemonSetのインスタンスタイプ要件を確認するようになり、選ばれたノードで確実にDaemonSetを実行できます。
c. 新規ノードの入れ替わり抑制:consolidateAfterがコンソリデーション中に作成された代替ノードにも適用されるようになり、作られたばかりのノードがすぐに再び削除されることがなくなりました。
d. メトリクスのゾーンラベル:ノードとNodeClaimのライフサイクルメトリクスにゾーンラベルが含まれるようになり、ゾーン単位のモニタリングが容易になりました。
完全なリストはv1.14.0リリースノートを参照してください。
Karpenter v1.14へのアップグレード方法
Karpenter v1.14はKubernetes 1.30〜1.36で動作します。サポートマトリクスは次のとおりです。
| Kubernetes | 1.30 | 1.31 | 1.32 | 1.33 | 1.34 | 1.35 | 1.36 |
|---|---|---|---|---|---|---|---|
| Karpenter | >= 0.37 | >= 1.0.5 | >= 1.2 | >= 1.5 | >= 1.6 | >= 1.9 | >= 1.13 |
v1.14.0は安定版リリースであり、本番環境で推奨されるのは安定版リリースのみです。
Karpenterは、Helmを使ってパブリックなOCIレジストリからインストールします。チャートのバージョンはvなしの1.14.0、Gitタグはv1.14.0である点に注意してください。
bash
helm upgrade --install karpenter oci://public.ecr.aws/karpenter/karpenter \ --version "1.14.0" \ --namespace "kube-system" --create-namespace \ --set "settings.clusterName=${CLUSTER_NAME}" \ --set "settings.interruptionQueue=${CLUSTER_NAME}" \ --set controller.resources.requests.cpu=1 \ --set controller.resources.requests.memory=1Gi \ --set controller.resources.limits.cpu=1 \ --set controller.resources.limits.memory=1Gi \ --waitインストール前に、cosignで署名付きチャートを検証できます。
Karpenterはマイナーバージョンごとに破壊的変更を一覧にしているため、アップグレード前に必ずアップグレードガイドを読んでください。新バージョンのCRDを適用してから、コントローラーをアップグレードします。マイナーバージョンを1つずつ上げていくのが最も安全な方法です。
Karpenter v1.14は本番環境で使えるか
現時点で信頼できる機能を簡潔にまとめます。
| 機能 | 内容 | v1.14での成熟度 | デフォルト | 制御方法 |
|---|---|---|---|---|
| DRAアロケーター | Karpenterがノード選択時にPodのDRA(GPU/アクセラレーター)クレームを読み取る | Karpenterではまだ非GA | 有効 | --ignore-dra-requestsで無効化 |
| CapacityBuffer | 即時スケジューリングのために予備容量を確保 | アルファ版 | 無効 | CapacityBuffer=trueフィーチャーゲートで有効化 |
| Balancedコンソリデーション | 削減効果と中断のバランスを取る新しいコンソリデーションポリシー | 安定版フィールド | NodePoolごとにオプトイン | consolidationPolicy: Balancedを設定 |
つまり、Balancedコンソリデーションは本番環境で試しても安全です。まず1つのNodePoolから始めましょう。DRAサポートとCapacityBufferはまだ初期段階のため、自社のワークロードで十分に検証するまでは、テスト環境またはステージング環境にとどめてください。
PerfectScale by DoiTでKarpenterのコストとパフォーマンスを最適化
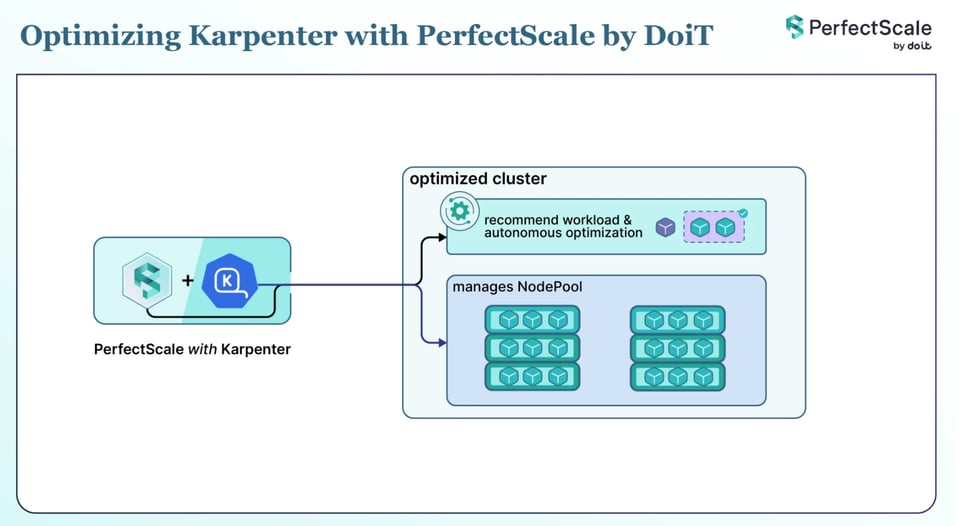
KarpenterとPerfectScaleは異なる役割を担っており、相性よく連携します。Karpenterはノードレベルで動作し、ノードの追加と削除を行います。PerfectScaleはPodレベルで動作し、ワークロードを監視して実際の使用状況をライトサイジングの推奨事項へと変換します。推奨は手動でも自律的にも適用できます。PerfectScaleはKarpenterの代替ではなく、Karpenterがより良いノード選択を行えるよう支援するものです。
これが役立つポイントは2つあり、v1.14以降はどちらも一層重要になります。
- まずPodをライトサイジングし、Karpenterが適切なノードを選べるようにする。 Karpenterは、PodのCPUおよびメモリのリクエストに基づいてノードを起動します。リクエストが間違っていれば、Karpenterは間違ったノードを起動してしまいます。PerfectScaleは実際の使用状況からリクエストとリミットを設定するため、Karpenterが読み取る数値が正確になります。
- 実データから最適なNodePool設定を選ぶ。 PerfectScaleはKarpenterの構成とワークロードを読み取り、変更を推奨します。適切なコンソリデーションポリシー、コンソリデーションの遅延(
consolidateAfter)、世代・ファミリー・カテゴリーをまたぐインスタンスの柔軟性の向上、上限に近づいているNodePoolのlimitsなどです。Balancedが選択肢に加わった今、PerfectScaleは推測に頼ることなく、各NodePoolに合うポリシーを提示できます。また、どのポリシーでもコンソリデーションを妨げる退避できないPodを検出し、修正できるようにします。
Paramount PicturesやCreditasといったチームは、PerfectScaleを活用してクラスターを常に適切なサイズに保ち、コストを抑えています。サインアップするか、デモを予約して、ご自身のクラスターでPerfectScaleをお試しください。