
PerfectScale
Karpenter v1.14: o que mudou e como fazer o upgrade
Suporte a DRA, uma nova API CapacityBuffer e a política de consolidação Balanced — veja o que há de novo no Karpenter v1.14, como fazer o upgrade e o que realmente está pronto para produção.
Esta página também está disponível em English, Deutsch, Español, Français, Italiano e 日本語.


TLDR;
O Karpenter v1.14, lançado em 11/07/2026, adiciona três recursos: suporte a Dynamic Resource Allocation (DRA) para agendamento de GPUs e aceleradores, a API CapacityBuffer em alpha para reservar capacidade extra de nós e uma nova política de consolidação Balanced, que coloca na balança a economia de custos e a interrupção dos pods. A consolidação Balanced é um campo estável e pode ser usada em produção com segurança; o suporte a DRA e o CapacityBuffer ainda estão em estágio inicial e é melhor testá-los primeiro em staging.
Karpenter v1.14: o que mudou e como fazer o upgrade
O Karpenter v1.14 é a versão mais recente do autoscaler de nós do Kubernetes. Ele adiciona três coisas principais: suporte a Dynamic Resource Allocation (DRA), uma nova API CapacityBuffer para capacidade extra e uma nova política de consolidação Balanced. Duas delas ainda estão em estágio inicial. O suporte a DRA ainda não é GA no Karpenter, e o CapacityBuffer está em alpha e vem desativado por padrão.
Os dois repositórios do Karpenter lançaram a v1.14.0 em 11 de julho de 2026: o projeto core e o provider da AWS.
Este post explica o que cada recurso faz, como fazer o upgrade e o que já é seguro usar em produção.
Há um tema comum nesta versão. O time do Karpenter sabe que confiabilidade e disponibilidade são prioridade quando você ajusta o autoscaling. Ninguém quer economizar ao custo de uma indisponibilidade do serviço. Tanto a nova política de consolidação Balanced quanto o CapacityBuffer foram criados com isso em mente. Um economiza sem mexer em nós que você não pode se dar ao luxo de perder. O outro mantém capacidade extra pronta para que os pods não fiquem esperando. É a mesma abordagem de custo com confiabilidade em primeiro lugar que o PerfectScale adota desde o início.
O que há de novo no Karpenter v1.14?
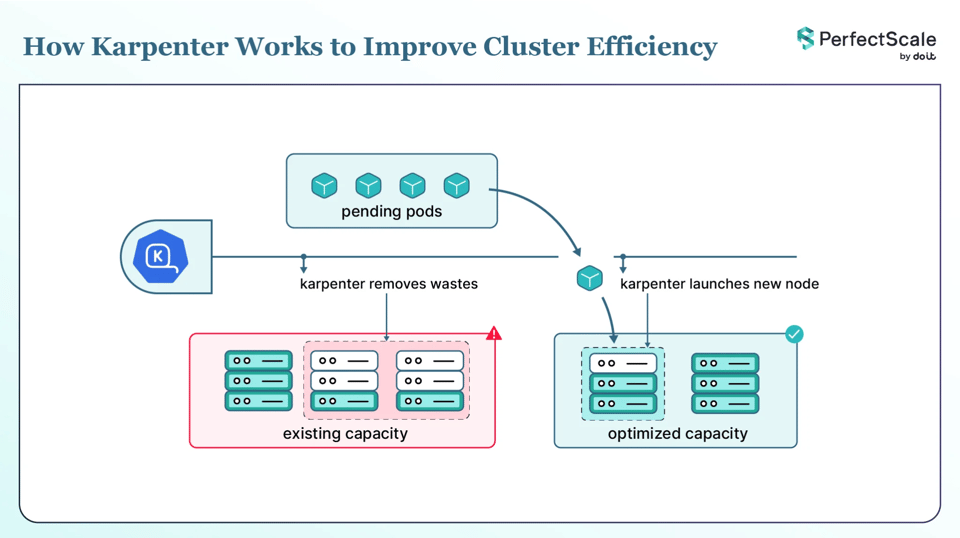
O Karpenter cria nós quando os pods não conseguem ser agendados e remove nós quando eles não são mais necessários. A v1.14 não muda esse trabalho. Ela torna o Karpenter mais inteligente com workloads de GPU e hardware, oferece uma forma de manter nós extras prontos e adiciona um jeito mais suave de economizar.
Três mudanças se destacam nesta versão:
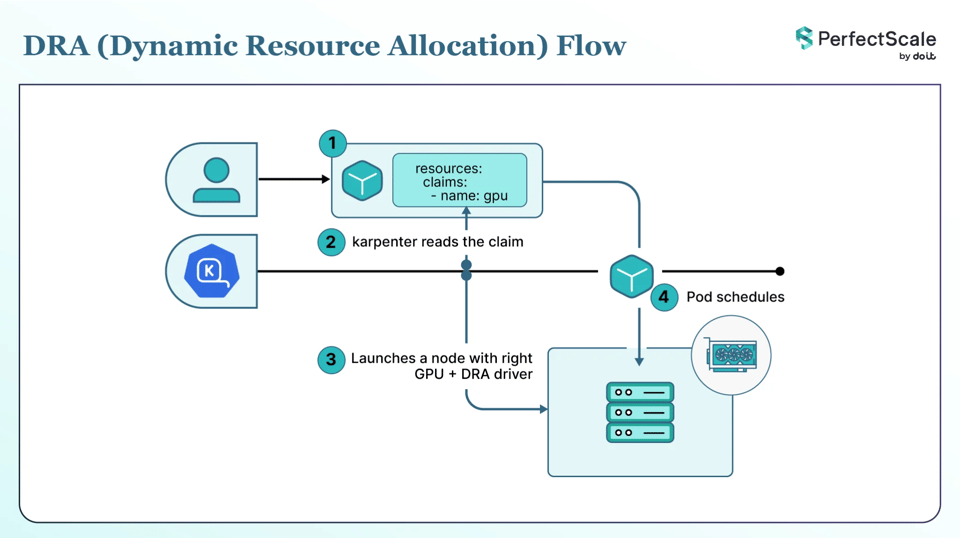
a. Suporte a DRA: o Karpenter agora lê a solicitação DRA de um pod ao escolher um nó. Isso importa principalmente para workloads com GPU e outros hardwares.
b. CapacityBuffer: você pode manter nós extras prontos para que os pods iniciem imediatamente. Este recurso está em alpha.
c. Consolidação Balanced: uma nova política que só remove um nó quando o custo economizado compensa a interrupção.
Suporte a DRA no Karpenter v1.14
O DRA é a forma do Kubernetes de solicitar hardware especial, como GPUs e outros aceleradores. Em vez de pedir um número fixo como nvidia.com/gpu: 1, o pod descreve o dispositivo de que precisa com um ResourceClaim, e o scheduler escolhe o dispositivo em si. Cada nó precisa de um driver DRA para o seu hardware. O DRA é GA no Kubernetes desde a v1.34 e vem ativado por padrão a partir dessa versão.
Antes da v1.14, o Karpenter não lia essas solicitações DRA ao planejar novos nós. Assim, um pod que precisasse de uma GPU via DRA podia ficar travado, porque o Karpenter não criava um nó capaz de executá-lo. Para contornar isso, você tinha que direcionar esses pods para os nós certos manualmente, com um nodeSelector ou node affinity, do mesmo jeito que pods de GPU são roteados no modelo mais antigo de device plugin. O Karpenter lê esses campos, mas não conseguia ler o claim DRA por conta própria. A v1.14 adiciona um alocador DRA. Agora o Karpenter lê a solicitação DRA do pod e a usa para escolher o nó certo. Ele também lida com dispositivos compartilhados e divisíveis, o que ajuda quando alguns pods compartilham o mesmo acelerador.
Você não precisa ativar nada. O recurso vem ligado por padrão. Para fazer o Karpenter ignorar solicitações DRA, defina a flag --ignore-dra-requests. Mas isso ainda está em estágio inicial. Se você executa workloads de GPU ou aceleradores com DRA, teste primeiro em staging. Você também precisa do Kubernetes 1.34 ou superior e de um driver DRA para o seu hardware. A referência de Settings tem os detalhes da flag.
CapacityBuffer no Karpenter: mantenha nós extras prontos
Novos nós levam tempo para iniciar e entrar no cluster. Para workloads com picos ou que não podem esperar, esse atraso sai caro. Os pods ficam pendentes, e o seu serviço não escala a tempo de atender o tráfego. O CapacityBuffer permite manter uma capacidade extra pronta, para que os pods sejam agendados imediatamente em vez de esperar por um novo nó.
Ele funciona com pods virtuais de reserva (placeholders). Esses pods existem apenas no planejamento do Karpenter. Eles nunca são pods reais no seu cluster. Eles fazem o Karpenter manter nós extras prontos e se reabastecem sozinhos quando os seus pods reais usam o espaço extra.
Você define o tamanho da capacidade extra de duas formas:
- podTemplateRef: aponte para um PodTemplate que descreve uma unidade de buffer e defina replicas e/ou limits.
- scalableRef: aponte para um Deployment, StatefulSet ou ReplicaSet e defina um percentual para manter a capacidade extra acompanhando esse workload.
Veja um buffer fixo de cinco unidades:
yaml
apiVersion: autoscaling.x-k8s.io/v1alpha1kind: CapacityBuffermetadata: name: web-app-buffer namespace: defaultspec: provisioningStrategy: "buffer.x-k8s.io/active-capacity" podTemplateRef: name: web-buffer-template replicas: 5 limits: cpu: "20" memory: "40Gi"Ou, para manter a capacidade extra acompanhando um workload, aponte para um Deployment e defina um percentual. Isto mantém a capacidade do buffer em 20% das réplicas do Deployment api-service, então a capacidade extra cresce e diminui conforme esse Deployment escala:
yaml
apiVersion: autoscaling.x-k8s.io/v1alpha1kind: CapacityBuffermetadata: name: api-service-buffer namespace: defaultspec: scalableRef: apiGroup: apps kind: Deployment name: api-service percentage: 20Quando você define mais de um desses campos, a contagem final é min(max(replicas, percentage), limits). Ou seja, replicas e percentage são combinados pegando o maior valor, e limits estabelece o teto do resultado.
Há um detalhe importante sobre a limpeza de nós. O Karpenter não remove um nó como vazio se ele contém capacidade de buffer. Os pods virtuais de buffer impedem que ele conte como vazio, e o Karpenter o marca com o motivo Node has buffer pods. Todos os outros tipos de limpeza continuam rodando, e qualquer nó substituto ainda precisa acomodar os pods de buffer, então a capacidade extra se mantém abastecida.
O CapacityBuffer está em alpha e vem desativado por padrão. Você o ativa com o feature gate CapacityBuffer=true. Ele foi adicionado na v1.13, e a v1.14 evoluiu sua API interna e adicionou métricas de status, mas ele ainda está em alpha e a API pode mudar. Teste primeiro em um cluster de testes. Lembre também que capacidade extra custa dinheiro, porque você paga por nós ociosos. Dimensione de acordo com o pico real que você precisa atender.
Consolidação Balanced: a nova política de consolidação do Karpenter
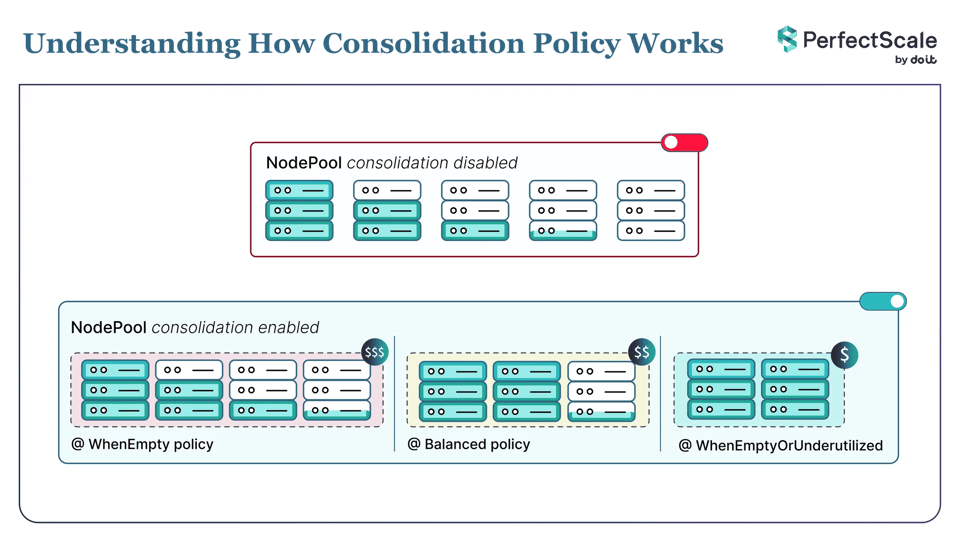
A consolidação é como o Karpenter economiza dinheiro para você. Ele remove nós vazios e compacta ou substitui os subutilizados. Você controla isso com o campo consolidationPolicy em um NodePool. A v1.14 adiciona uma terceira opção, Balanced, então agora são três:
| consolidationPolicy | Quais nós ela considera | Escolha quando |
|---|---|---|
| WhenEmpty | Apenas nós vazios | Você quer o comportamento mais cauteloso e só remove nós quando não há mais nada rodando neles. |
| Balanced | Nós em que a economia compensa a interrupção dos pods | Você quer a maior parte da economia sem mover nós por ganhos pequenos e marginais. |
| WhenEmptyOrUnderutilized | Qualquer nó que possa ser removido ou substituído para reduzir custos | Você quer o menor custo e aceita a interrupção de pods que isso exige. |
A Balanced pontua cada ação de consolidação. Ela compara a economia gerada pela ação com a interrupção de pods que ela causa, e só age quando a economia é grande o suficiente para compensar a interrupção. Por padrão, cada pod conta igual, então a interrupção é basicamente o número de pods que seriam movidos. Pods mais caros de mover podem contar mais. Por exemplo, pods de prioridade mais alta contam como mais disruptivos, então o nó deles tem menos chance de ser removido.
Você consegue ver por que o Karpenter tomou cada decisão. Uma ação aprovada emite um evento ConsolidationApproved com a pontuação e os percentuais de economia e interrupção. O Karpenter também exporta as métricas karpenter_consolidation_score e karpenter_consolidation_moves_total, e registra as decisões com --log-level debug.
Para usar, defina a política no seu NodePool:
yaml
apiVersion: karpenter.sh/v1kind: NodePoolmetadata: name: defaultspec: disruption: consolidationPolicy: BalancedUse a Balanced quando a WhenEmptyOrUnderutilized economiza bem mas move nós com muita frequência, e a WhenEmpty deixa desperdício demais. Ela fica no meio-termo. O Karpenter continua removendo nós vazios e claramente subutilizados, mas pula as movimentações pequenas em que a economia não compensa. Este é o único recurso novo da v1.14 que é um campo estável sem feature gate, então é seguro experimentar. Ative primeiro em um NodePool e acompanhe os eventos e as métricas. Se você não tem certeza de qual política se encaixa em cada NodePool, o PerfectScale recomenda a política de consolidação certa a partir dos dados reais dos seus workloads, para você não precisar adivinhar.
Outras mudanças do Karpenter v1.14
Algumas mudanças menores que merecem atenção:
a. Tipos de instância EC2 em preview (AWS): o provider da AWS agora pode usar tipos de instância EC2 que ainda estão em preview, então você pode experimentar novas gerações de instância antes de elas ficarem disponíveis de forma geral.
b. Escolha de nós que considera DaemonSets: o Karpenter agora verifica os requisitos de tipo de instância de um DaemonSet ao escolher um nó, para que o nó realmente consiga rodar seus DaemonSets.
c. Menos rotatividade em nós novos: consolidateAfter agora também se aplica aos nós substitutos criados durante a consolidação, então um nó recém-criado não é removido novamente logo em seguida.
d. Label de zona nas métricas: as métricas de ciclo de vida de nós e NodeClaims agora incluem um label de zona, o que facilita o monitoramento por zona.
A lista completa está nas notas de lançamento da v1.14.0.
Como fazer o upgrade para o Karpenter v1.14
O Karpenter v1.14 funciona com o Kubernetes 1.30 a 1.36. Veja a matriz de compatibilidade:
| Kubernetes | 1.30 | 1.31 | 1.32 | 1.33 | 1.34 | 1.35 | 1.36 |
|---|---|---|---|---|---|---|---|
| Karpenter | >= 0.37 | >= 1.0.5 | >= 1.2 | >= 1.5 | >= 1.6 | >= 1.9 | >= 1.13 |
A v1.14.0 é uma versão estável, e versões estáveis são as únicas recomendadas para produção.
O Karpenter é instalado a partir de um registry OCI público com o Helm. Note que a versão do chart é 1.14.0, sem o v, enquanto a tag do Git é v1.14.0.
bash
helm upgrade --install karpenter oci://public.ecr.aws/karpenter/karpenter \ --version "1.14.0" \ --namespace "kube-system" --create-namespace \ --set "settings.clusterName=${CLUSTER_NAME}" \ --set "settings.interruptionQueue=${CLUSTER_NAME}" \ --set controller.resources.requests.cpu=1 \ --set controller.resources.requests.memory=1Gi \ --set controller.resources.limits.cpu=1 \ --set controller.resources.limits.memory=1Gi \ --waitVocê pode verificar o chart assinado com o cosign antes de instalar.
Leia o guia de upgrade antes de atualizar, porque o Karpenter lista qualquer breaking change de cada versão minor. Aplique os CRDs da nova versão e depois atualize o controller. Subir uma versão minor por vez é o caminho mais seguro.
O Karpenter v1.14 está pronto para produção?
Em resumo, veja no que você pode confiar hoje:
| Recurso | O que ele faz | Maturidade na v1.14 | Padrão | Como controlar |
|---|---|---|---|---|
| Alocador DRA | O Karpenter lê os claims DRA (GPU/acelerador) de um pod ao escolher um nó | Ainda não é GA no Karpenter | Ativado | Desative com --ignore-dra-requests |
| CapacityBuffer | Mantém capacidade extra pronta para agendamento instantâneo | Alpha | Desativado | Ative com o feature gate CapacityBuffer=true |
| Consolidação Balanced | Nova política de consolidação que equilibra economia e interrupção | Campo estável | Opt-in por NodePool | Defina consolidationPolicy: Balanced |
Ou seja, a consolidação Balanced é segura para testar em produção. Comece com um NodePool. O suporte a DRA e o CapacityBuffer ainda estão em estágio inicial, então mantenha-os em ambiente de teste ou staging até você rodar seus próprios workloads neles.
Otimize o custo e a performance do Karpenter com o PerfectScale by DoiT
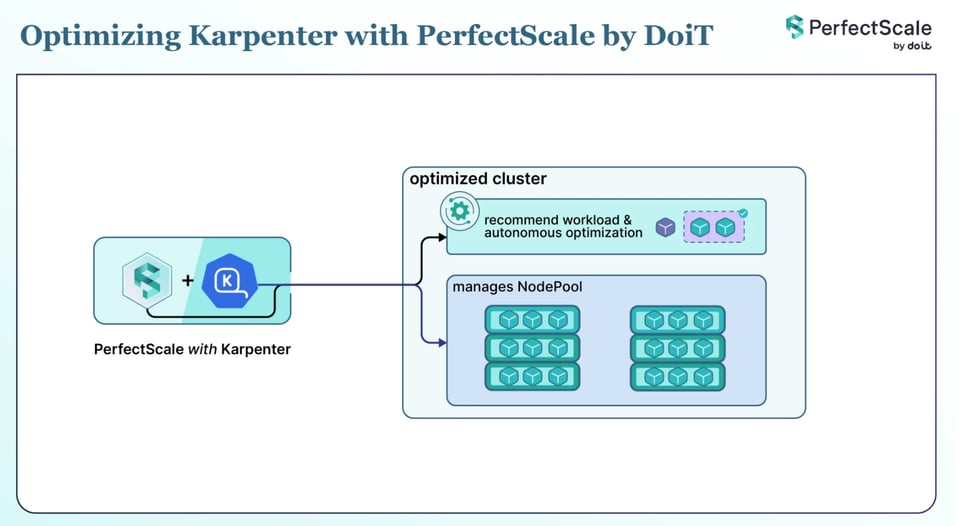
O Karpenter e o PerfectScale fazem trabalhos diferentes, e funcionam bem juntos. O Karpenter atua no nível dos nós. Ele adiciona e remove nós. O PerfectScale atua no nível dos pods. Ele observa seus workloads e transforma o uso real em recomendações de right-sizing que você pode aplicar manualmente ou de forma autônoma. O PerfectScale não substitui o Karpenter. Ele ajuda o Karpenter a tomar decisões melhores sobre os nós.
Isso ajuda de duas formas, e ambas importam ainda mais depois da v1.14:
- Ajuste os pods primeiro, para o Karpenter escolher os nós certos. O Karpenter cria nós com base nos requests de CPU e memória dos seus pods. Se esses requests estiverem errados, o Karpenter cria os nós errados. O PerfectScale define requests e limits a partir do uso real, então os números que o Karpenter lê estão corretos.
- Escolha as configurações certas de NodePool com base em dados reais. O PerfectScale lê a sua configuração do Karpenter e os seus workloads e recomenda mudanças: qual política de consolidação se encaixa, um atraso de consolidação (
consolidateAfter), mais flexibilidade de instâncias entre geração, família e categoria, e limites de NodePool que estão perto do teto. Agora que a Balanced é uma opção, o PerfectScale pode indicar qual política se encaixa em cada NodePool em vez de você adivinhar. Ele também sinaliza pods que não podem ser removidos (unevictable), que bloqueiam a consolidação em qualquer política, para você corrigi-los.
Times como Paramount Pictures e Creditas usam o PerfectScale para manter seus clusters bem dimensionados e seus custos sob controle. Cadastre-se ou agende uma demo para ver o PerfectScale no seu próprio cluster.