
PerfectScale
Karpenter v1.14: le novità e come eseguire l'upgrade
Supporto DRA, una nuova API CapacityBuffer e la policy di consolidamento Balanced: ecco le novità di Karpenter v1.14, come eseguire l'upgrade e cosa è davvero pronto per la produzione.
Questa pagina è disponibile anche in English, Deutsch, Español, Français, 日本語 e Português.


TLDR;
Karpenter v1.14, rilasciato l'11 luglio 2026, aggiunge tre funzionalità: il supporto alla Dynamic Resource Allocation (DRA) per lo scheduling di GPU e acceleratori, un'API CapacityBuffer in alpha per mantenere capacità di riserva sui nodi e una nuova policy di consolidamento Balanced che bilancia il risparmio sui costi con la disruption dei pod. Il consolidamento Balanced è un campo stabile e sicuro da usare in produzione; il supporto DRA e CapacityBuffer sono ancora in fase iniziale ed è meglio testarli prima in staging.
Karpenter v1.14: le novità e come eseguire l'upgrade
Karpenter v1.14 è l'ultima release del node autoscaler per Kubernetes. Introduce tre novità principali: il supporto alla Dynamic Resource Allocation (DRA), una nuova API CapacityBuffer per la capacità di riserva e una nuova policy di consolidamento Balanced. Due di queste sono ancora in fase iniziale. Il supporto DRA non è ancora GA in Karpenter, e CapacityBuffer è in alpha e disattivata per impostazione predefinita.
Entrambi i repository di Karpenter hanno rilasciato la v1.14.0 l'11 luglio 2026: il progetto core e il provider AWS.
Questo articolo spiega cosa fa ciascuna funzionalità, come eseguire l'upgrade e cosa è sicuro usare in produzione già oggi.
C'è un filo conduttore in questa release. Il team di Karpenter sa bene che affidabilità e disponibilità sono la priorità quando si mette a punto l'autoscaling. Nessuno vuole risparmiare sui costi al prezzo di un disservizio. Sia la nuova policy di consolidamento Balanced sia CapacityBuffer nascono con questa consapevolezza. La prima riduce i costi senza spostare nodi che non ci si può permettere di perdere. La seconda mantiene pronta della capacità di riserva, così i pod non restano in attesa. È lo stesso approccio ai costi orientato all'affidabilità che PerfectScale adotta fin dall'inizio.
Cosa c'è di nuovo in Karpenter v1.14?
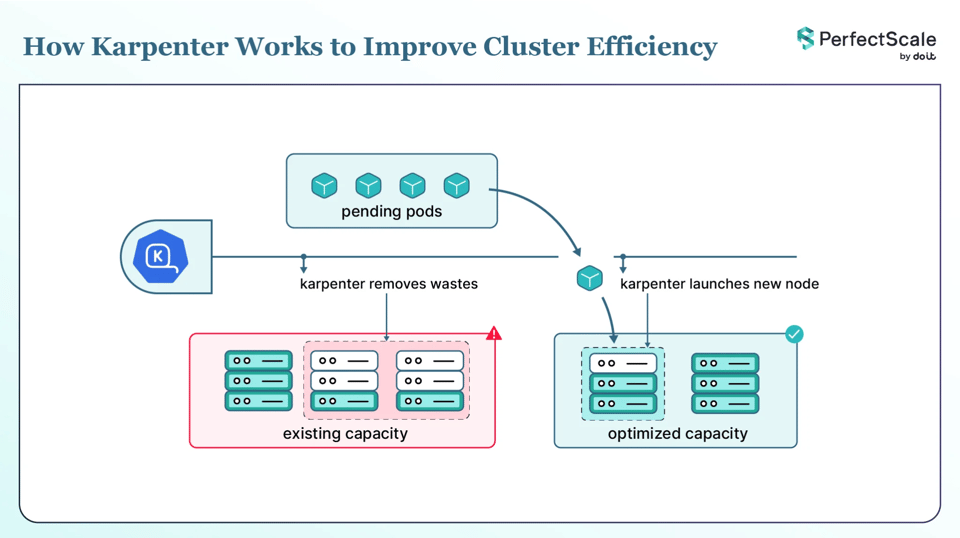
Karpenter avvia nodi quando i pod non possono essere schedulati e li rimuove quando non servono più. La v1.14 non cambia questo compito. Rende Karpenter più intelligente con i workloads GPU e hardware, offre un modo per tenere pronti nodi di riserva e aggiunge un modo più prudente per risparmiare sui costi.
Tre cambiamenti spiccano in questa release:
a. Supporto DRA: Karpenter ora legge la richiesta DRA di un pod quando sceglie un nodo. È particolarmente importante per i workloads GPU e hardware.
b. CapacityBuffer: è possibile mantenere pronti nodi di riserva, così i pod partono subito. Questa funzionalità è in alpha.
c. Consolidamento Balanced: una nuova policy che rimuove un nodo solo quando il risparmio ottenuto giustifica la disruption.
Il supporto DRA in Karpenter v1.14
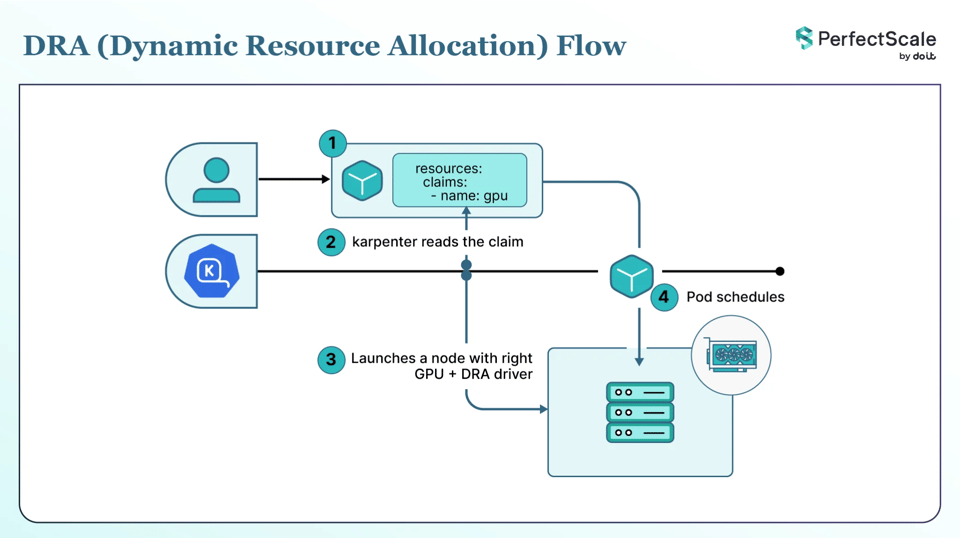
DRA è il meccanismo di Kubernetes per richiedere hardware speciale come GPU e altri acceleratori. Invece di richiedere un numero fisso come nvidia.com/gpu: 1, un pod descrive il device di cui ha bisogno con una ResourceClaim, e lo scheduler sceglie il device effettivo. Ogni nodo ha bisogno di un driver DRA per il proprio hardware. DRA è GA in Kubernetes dalla v1.34 ed è attiva per impostazione predefinita a partire da quella versione.
Prima della v1.14, Karpenter non leggeva queste richieste DRA durante la pianificazione di nuovi nodi. Un pod che richiedeva una GPU tramite DRA poteva quindi restare bloccato, perché Karpenter non avviava un nodo in grado di eseguirlo. Per aggirare il problema, bisognava indirizzare manualmente questi pod verso i nodi giusti, con un nodeSelector o una node affinity, nello stesso modo in cui i pod GPU vengono instradati con il vecchio modello dei device plugin. Karpenter li legge, ma non era in grado di leggere autonomamente la claim DRA. La v1.14 aggiunge un allocatore DRA. Karpenter ora legge la richiesta DRA del pod e la usa per scegliere il nodo giusto. Gestisce anche i device condivisi e divisibili, il che aiuta quando più pod condividono un unico acceleratore.
Non serve attivare nulla: la funzionalità è attiva per impostazione predefinita. Per fare in modo che Karpenter ignori le richieste DRA, impostare il flag --ignore-dra-requests. La funzionalità è però ancora in fase iniziale. Se si eseguono workloads GPU o con acceleratori tramite DRA, conviene provarla prima in staging. Servono inoltre Kubernetes 1.34 o successivo e un driver DRA per il proprio hardware. La Settings reference contiene i dettagli del flag.
Karpenter CapacityBuffer: nodi di riserva sempre pronti
I nuovi nodi impiegano tempo per avviarsi e unirsi al cluster. Per i workloads con picchi o che non possono attendere, quel ritardo è un problema. I pod restano in pending e il servizio non riesce a scalare in tempo per gestire il traffico. CapacityBuffer permette di mantenere pronta una certa capacità di riserva, così i pod vengono schedulati subito invece di attendere un nuovo nodo.
Funziona con pod segnaposto virtuali. Questi pod esistono solo nella pianificazione di Karpenter. Non diventano mai pod reali nel cluster. Fanno sì che Karpenter mantenga pronti nodi di riserva e si ripristinano da soli quando i pod reali occupano lo spazio di riserva.
La dimensione della capacità di riserva si imposta in uno di questi due modi:
- podTemplateRef: puntare a un PodTemplate che descrive una singola unità di buffer, poi impostare replicas e/o limits.
- scalableRef: puntare a un Deployment, StatefulSet o ReplicaSet, poi impostare una percentuale per mantenere la capacità di riserva allineata a quel workload.
Ecco un buffer fisso di cinque unità:
yaml
apiVersion: autoscaling.x-k8s.io/v1alpha1kind: CapacityBuffermetadata: name: web-app-buffer namespace: defaultspec: provisioningStrategy: "buffer.x-k8s.io/active-capacity" podTemplateRef: name: web-buffer-template replicas: 5 limits: cpu: "20" memory: "40Gi"In alternativa, per mantenere la capacità di riserva allineata a un workload, si punta a un Deployment e si imposta una percentuale. In questo esempio la capacità del buffer resta al 20% delle repliche del Deployment api-service, quindi la capacità di riserva cresce e si riduce man mano che quel Deployment scala:
yaml
apiVersion: autoscaling.x-k8s.io/v1alpha1kind: CapacityBuffermetadata: name: api-service-buffer namespace: defaultspec: scalableRef: apiGroup: apps kind: Deployment name: api-service percentage: 20Se si imposta più di uno di questi valori, il conteggio finale è min(max(replicas, percentage), limits). Replicas e percentage vengono quindi combinati prendendo il valore maggiore, e limits pone un tetto al risultato.
C'è un aspetto da conoscere riguardo alla pulizia dei nodi. Karpenter non rimuoverà un nodo come vuoto se ospita capacità di buffer. I pod di buffer virtuali impediscono che venga conteggiato come vuoto, e Karpenter lo contrassegna con il motivo Node has buffer pods. Tutti gli altri tipi di pulizia continuano a funzionare, e qualsiasi nodo sostitutivo deve comunque ospitare i pod di buffer, così la capacità di riserva resta sempre al livello previsto.
CapacityBuffer è in alpha e disattivata per impostazione predefinita. Si abilita con il feature gate CapacityBuffer=true. È stata aggiunta nella v1.13, e la v1.14 ha fatto evolvere la sua API interna e aggiunto metriche di stato, ma è ancora in alpha e l'API può cambiare. Conviene provarla prima in un cluster di test. Va inoltre ricordato che la capacità di riserva costa, perché si pagano nodi inattivi. Meglio dimensionarla sul burst reale effettivamente necessario.
Consolidamento Balanced: la nuova policy di consolidamento di Karpenter
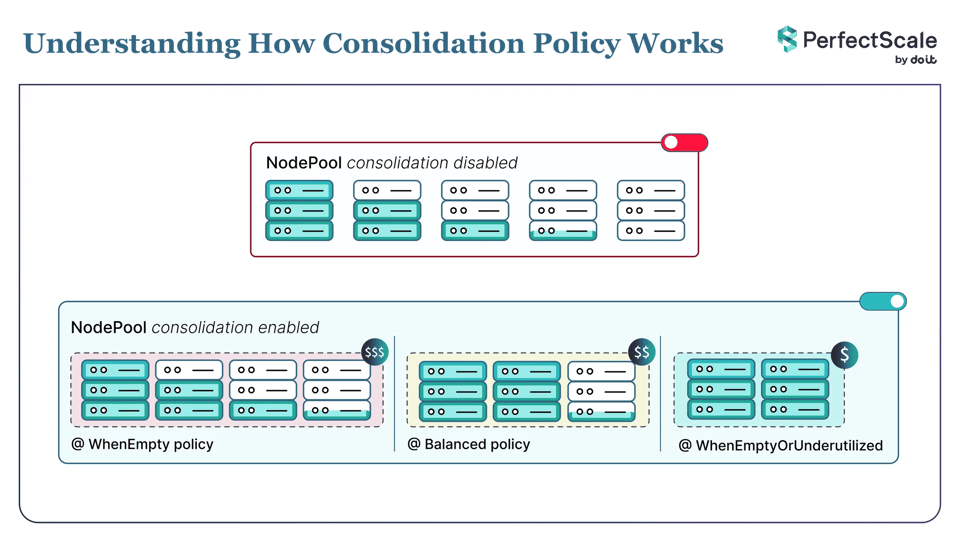
Il consolidamento è il modo in cui Karpenter fa risparmiare. Rimuove i nodi vuoti e compatta o sostituisce quelli sottoutilizzati. Si controlla con il campo consolidationPolicy su un NodePool. La v1.14 aggiunge una terza opzione, Balanced, quindi ora ce ne sono tre:
| consolidationPolicy | Quali nodi considera | Quando sceglierla |
|---|---|---|
| WhenEmpty | Solo i nodi vuoti | Si desidera il comportamento più prudente e rimuovere i nodi solo quando non vi è più nulla in esecuzione. |
| Balanced | I nodi in cui il risparmio giustifica la disruption dei pod | Si desidera la maggior parte del risparmio senza spostare nodi per guadagni piccoli e marginali. |
| WhenEmptyOrUnderutilized | Qualsiasi nodo che possa essere rimosso o sostituito per ridurre i costi | Si desidera il costo più basso e si può accettare la disruption dei pod che ne deriva. |
Balanced assegna un punteggio a ogni azione di consolidamento. Soppesa quanto costo l'azione fa risparmiare rispetto a quanta disruption causa ai pod, e agisce solo quando il risparmio è sufficiente a giustificare la disruption. Per impostazione predefinita ogni pod pesa allo stesso modo, quindi la disruption corrisponde sostanzialmente al numero di pod che verrebbero spostati. I pod più costosi da spostare possono pesare di più. Ad esempio, i pod con priorità più alta contano come più "disruptive", quindi è meno probabile che il loro nodo venga rimosso.
È possibile vedere il motivo di ogni scelta di Karpenter. Un'azione approvata genera un evento ConsolidationApproved con il punteggio e le percentuali di risparmio e disruption. Karpenter esporta anche le metriche karpenter_consolidation_score e karpenter_consolidation_moves_total, e registra le scelte nei log con --log-level debug.
Per utilizzarla, impostare la policy sul NodePool:
yaml
apiVersion: karpenter.sh/v1kind: NodePoolmetadata: name: defaultspec: disruption: consolidationPolicy: BalancedBalanced è la scelta giusta quando WhenEmptyOrUnderutilized fa risparmiare bene ma sposta i nodi troppo spesso, e WhenEmpty lascia troppi sprechi. È la via di mezzo. Karpenter continua a rimuovere i nodi vuoti e chiaramente sottoutilizzati, ma evita i piccoli spostamenti in cui il risparmio non ne vale la pena. È l'unica nuova funzionalità della v1.14 a essere un campo stabile senza feature gate, quindi è sicura da provare. Conviene attivarla prima su un solo NodePool e osservare eventi e metriche. Se non è chiaro quale policy si adatti a ciascun NodePool, PerfectScale consiglia la policy di consolidamento giusta partendo dai dati reali dei workloads, senza dover andare per tentativi.
Altre novità di Karpenter v1.14
Alcuni cambiamenti minori da tenere presenti:
a. Instance type EC2 in preview (AWS): il provider AWS può ora utilizzare instance type EC2 ancora in preview, così è possibile provare le nuove generazioni di istanze prima della disponibilità generale.
b. Scelta del nodo in base ai DaemonSet: Karpenter ora verifica i requisiti di instance type di un DaemonSet quando sceglie un nodo, così il nodo può effettivamente eseguire i DaemonSet.
c. Meno churn sui nuovi nodi: consolidateAfter ora si applica anche ai nodi sostitutivi creati durante il consolidamento, quindi un nodo appena creato non viene rimosso di nuovo subito dopo.
d. Label di zona sulle metriche: le metriche del ciclo di vita di nodi e NodeClaim includono ora una label di zona, il che semplifica il monitoraggio per zona.
L'elenco completo è nelle release notes della v1.14.0.
Come eseguire l'upgrade a Karpenter v1.14
Karpenter v1.14 funziona con Kubernetes dalla 1.30 alla 1.36. Ecco la matrice di compatibilità:
| Kubernetes | 1.30 | 1.31 | 1.32 | 1.33 | 1.34 | 1.35 | 1.36 |
|---|---|---|---|---|---|---|---|
| Karpenter | >= 0.37 | >= 1.0.5 | >= 1.2 | >= 1.5 | >= 1.6 | >= 1.9 | >= 1.13 |
La v1.14.0 è una release stabile, e le release stabili sono le uniche consigliate per la produzione.
Karpenter si installa da un registry OCI pubblico con Helm. Da notare che la versione del chart è 1.14.0 senza v, mentre il tag Git è v1.14.0.
bash
helm upgrade --install karpenter oci://public.ecr.aws/karpenter/karpenter \ --version "1.14.0" \ --namespace "kube-system" --create-namespace \ --set "settings.clusterName=${CLUSTER_NAME}" \ --set "settings.interruptionQueue=${CLUSTER_NAME}" \ --set controller.resources.requests.cpu=1 \ --set controller.resources.requests.memory=1Gi \ --set controller.resources.limits.cpu=1 \ --set controller.resources.limits.memory=1Gi \ --waitÈ possibile verificare il chart firmato con cosign prima dell'installazione.
Prima di procedere, è bene leggere la guida all'upgrade, perché Karpenter documenta le eventuali breaking change per ogni versione minor. Applicare le CRD della nuova versione, poi aggiornare il controller. Avanzare di una versione minor alla volta è il percorso più sicuro.
Karpenter v1.14 è pronto per la produzione?
Ecco, in breve, su cosa si può fare affidamento già oggi:
| Funzionalità | Cosa fa | Maturità nella v1.14 | Default | Come controllarla |
|---|---|---|---|---|
| Allocatore DRA | Karpenter legge le claim DRA (GPU/acceleratori) di un pod quando sceglie un nodo | Non ancora GA in Karpenter | Attiva | Disattivare con --ignore-dra-requests |
| CapacityBuffer | Mantiene pronta capacità di riserva per uno scheduling immediato | Alpha | Disattivata | Attivare con il feature gate CapacityBuffer=true |
| Consolidamento Balanced | Nuova policy di consolidamento che bilancia risparmio e disruption | Campo stabile | Opt-in per NodePool | Impostare consolidationPolicy: Balanced |
Il consolidamento Balanced è quindi sicuro da provare in produzione. Meglio iniziare con un solo NodePool. Il supporto DRA e CapacityBuffer sono ancora in fase iniziale, quindi conviene tenerli in test o staging finché non saranno stati validati con i propri workloads.
Ottimizzare costi e prestazioni di Karpenter con PerfectScale by DoiT
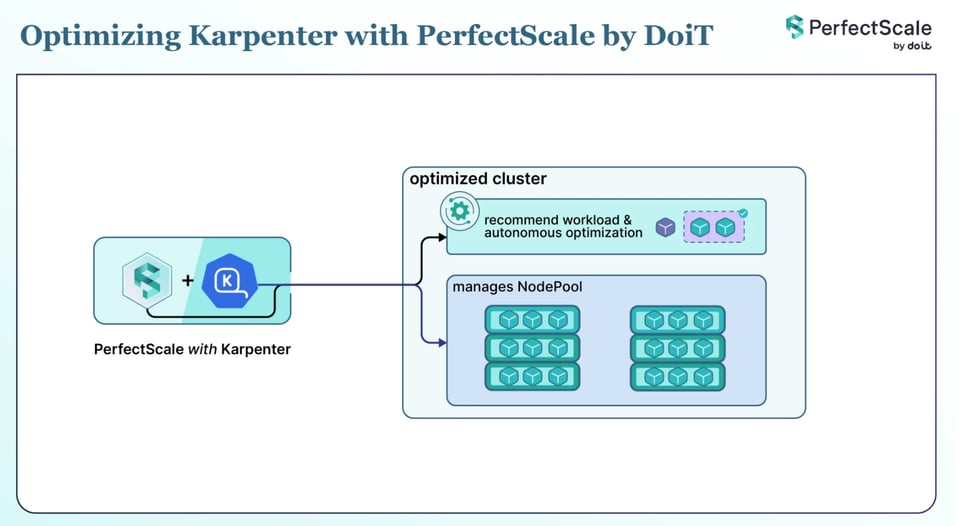
Karpenter e PerfectScale svolgono compiti diversi e funzionano bene insieme. Karpenter opera a livello di nodo: aggiunge e rimuove nodi. PerfectScale opera a livello di pod: osserva i workloads e trasforma l'utilizzo reale in raccomandazioni di right-sizing applicabili manualmente o in modo autonomo. PerfectScale non sostituisce Karpenter: lo aiuta a fare scelte migliori sui nodi.
Questo aiuta in due modi, ed entrambi contano ancora di più dopo la v1.14:
- Prima il right-sizing dei pod, così Karpenter sceglie i nodi giusti. Karpenter avvia nodi in base alle richieste di CPU e memoria dei pod. Se quelle richieste sono sbagliate, Karpenter avvia i nodi sbagliati. PerfectScale imposta request e limit a partire dall'utilizzo reale, così i numeri che Karpenter legge sono corretti.
- Le impostazioni giuste del NodePool a partire da dati reali. PerfectScale legge la configurazione di Karpenter e i workloads e consiglia le modifiche: quale policy di consolidamento è più adatta, un ritardo di consolidamento (
consolidateAfter), maggiore flessibilità di istanze tra generazioni, famiglie e categorie, e limiti dei NodePool prossimi al tetto massimo. Ora che Balanced è un'opzione, PerfectScale può indicare quale policy si adatta a ciascun NodePool, senza andare per tentativi. Segnala anche i pod non evictable, che bloccano il consolidamento con qualsiasi policy, così è possibile correggerli.
Team come Paramount Pictures e Creditas usano PerfectScale per mantenere i cluster correttamente dimensionati e i costi sotto controllo. Si registri o prenoti una demo per vedere PerfectScale sul Suo cluster.