

Reduces un Deployment de 12 pods a 3 y un nodo grande queda casi vacío. En nuestro sandbox, con un tiempo de espera de un minuto, Karpenter reemplaza ese nodo por uno más pequeño en unos 80 segundos. A veces no lo hace, y el nodo grande sigue corriendo y costándote dinero.
Si te preguntas por qué Karpenter no consolida tus nodos, empieza por los eventos. Karpenter escribe un evento cuando omite un nodo, y ese evento suele apuntar a la causa.
Un evento señala una causa, pero no te da la solución. Un PodDisruptionBudget (PDB), una anotación en un pod, un disruption budget y una regla de ubicación pueden, cada uno por su cuenta, mantener un nodo corriendo, y cada uno pertenece a un equipo distinto. La persona que lee el evento no siempre es la que puede cambiar la causa.
En lugar de eso, sigue siempre la misma ruta fija. Lee el evento, confírmalo con un comando, escribe el cambio más pequeño posible como un diff y revisa ese diff antes de que alguien lo aplique. A esta ruta la llamamos "del evento al diff". Un diff muestra solo las líneas que cambian.
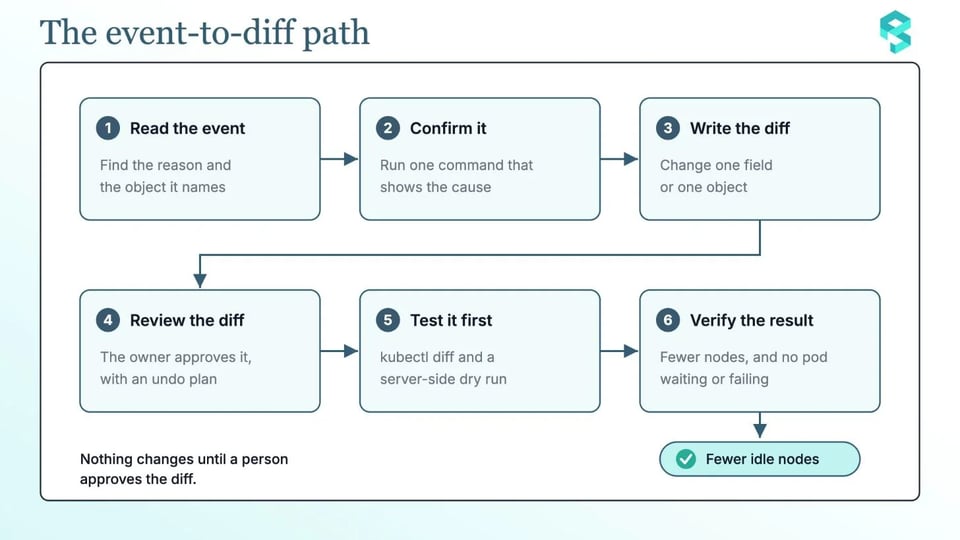
Este artículo recorre la ruta con cuatro casos que puedes encontrar en tus propios clústeres:
- Un disruption budget que no permite ninguna disrupción
- Una anotación do-not-disrupt
- Un PDB sin margen
- Pods que no pueden ejecutarse en otro nodo
Los ejemplos usan Karpenter v1.15 en AWS. Usan un sandbox pequeño: un NodePool llamado workshop y un Deployment llamado inflate en el namespace sandbox.
Qué hace Karpenter por defecto
Karpenter puede eliminar un nodo de dos maneras. Si todos los pods caben en la capacidad libre de otros nodos, elimina el nodo. Si caben en la capacidad libre más un nodo de menor precio, reemplaza el nodo.
Un NodePool que no define nada más recibe consolidationPolicy: WhenEmptyOrUnderutilized y consolidateAfter: 0s. También recibe un budget que le permite a Karpenter interrumpir el 10% de los nodos a la vez.
Para cada disrupción voluntaria, Karpenter sigue los mismos seis pasos:
- Elige los nodos candidatos. Karpenter ignora un nodo que aloja pods que no se pueden desalojar, y vuelve a intentarlo con ese nodo más tarde.
- Verifica que la disrupción no rompa el budget del NodePool.
- Simula la programación de los pods del nodo para determinar si se necesitan nodos de reemplazo.
- Agrega el taint
karpenter.sh/disrupted:NoSchedule, para que ningún pod nuevo arranque en el nodo. - Inicia los nodos de reemplazo, si la simulación los requiere, y espera hasta que estén listos.
- Elimina el nodo. El proceso de terminación drena el nodo con la Eviction API de Kubernetes, por lo que respeta los PDBs. Ignora los pods estáticos, los pods que toleran el taint y los pods que terminaron con éxito o con error.
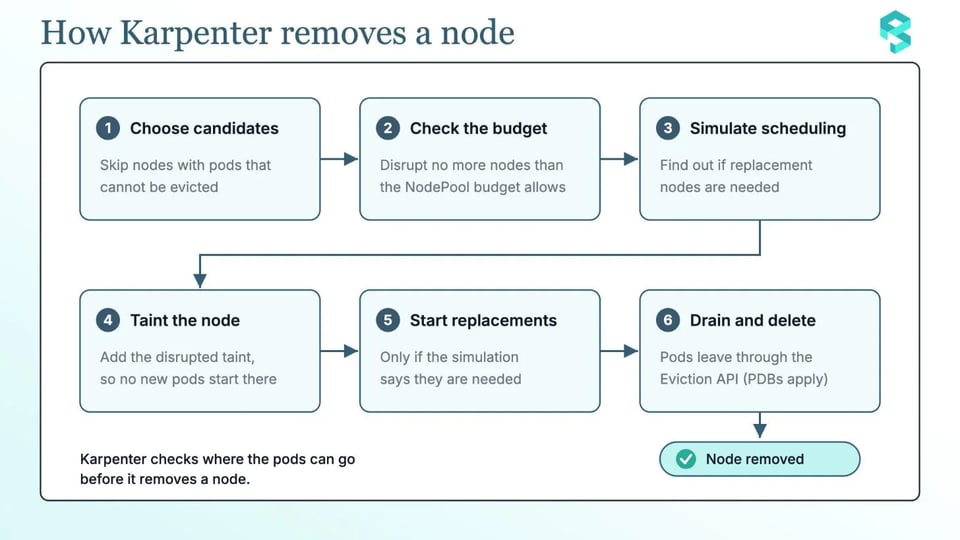
Un nodo se queda cuando Karpenter se detiene en uno de estos pasos, y los eventos te dicen en cuál. Los budgets y la anotación do-not-disrupt solo afectan la disrupción voluntaria. La expiración, la interrupción y la eliminación manual los ignoran.
Lee primero los eventos
Karpenter escribe un evento cuando omite un nodo, y la razón te dice qué tipo de problema tienes. Unconsolidatable significa que la consolidación no es viable para ese nodo. DisruptionBlocked significa que algo bloquea la disrupción: un PDB, una anotación en un pod o en un nodo, o un budget en el NodePool.
Los eventos de nodo aparecen en el nodo y en su NodeClaim. Los eventos de budget aparecen en el NodePool, no en el nodo. Estos comandos recopilan los eventos de un nodo, su NodeClaim, su NodePool y el clúster completo. Reemplaza $NODE, $NODECLAIM y $NODEPOOL con tus nombres:
kubectl describe node $NODEkubectl describe nodeclaim $NODECLAIMkubectl describe nodepool $NODEPOOLkubectl get events -A --field-selector reason=Unconsolidatable --sort-by=.lastTimestampkubectl get events -A --field-selector reason=DisruptionBlocked --sort-by=.lastTimestampEn Karpenter v1.15, los mensajes de los cuatro casos se ven así:
| Mensaje | Qué significa | Confírmalo con |
|---|---|---|
No allowed disruptions for disruption reason Underutilized due to blocking budget |
Un budget no permite disrupciones en este momento. Este evento está en el NodePool. | El bloque disruption del NodePool |
Pod has "karpenter.sh/do-not-disrupt" annotation (Pod=<namespace>/<name>) |
Un pod del nodo lleva la anotación. | Las anotaciones de los pods del nodo |
Pdb prevents pod evictions (PodDisruptionBudget=[<namespace>/<name>]) |
Un PDB no tiene margen para un pod del nodo. | El valor ALLOWED de cada PDB |
Can't replace with a cheaper node |
Karpenter no encontró un nodo más barato que pueda alojar los pods. | Los requests de los pods, los requirements del NodePool y los límites del NodePool |
Dos mensajes más apuntan a la configuración del NodePool. NodePool "<name>" has consolidation disabled significa que consolidateAfter es Never. NodePool "<name>" has consolidation policy WhenEmpty, but node is not empty significa que la política solo considera nodos vacíos. En nodos Spot, Karpenter reemplaza un nodo solo cuando el feature gate SpotToSpotConsolidation está activado.
Ahora puedes seguir la ruta con cada caso, uno a la vez:
Caso 1: Un budget que no permite ninguna disrupción
Aquí la evidencia está en el NodePool, no en el nodo. Tiene un evento DisruptionBlocked que dice No allowed disruptions for disruption reason Underutilized due to blocking budget.
Para confirmarlo, lee el bloque disruption del NodePool:
kubectl get nodepool $NODEPOOL -o jsonpath='{.spec.disruption}{"\n"}'Busca nodes: '0', o un budget con un schedule y una duration que esté activo en este momento. Un budget con nodes: '0' y sin reasons bloquea toda disrupción voluntaria. Cuando un NodePool tiene varios budgets, Karpenter usa el resultado más bajo.
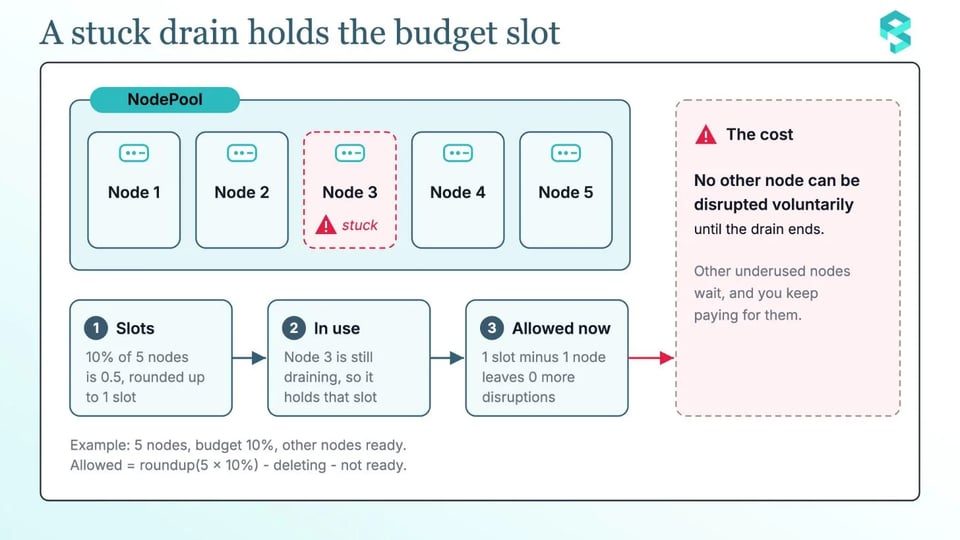
Karpenter también cuenta los nodos que ya se están eliminando. Para un porcentaje, calcula las disrupciones permitidas así:
| permitidas = roundup(total x porcentaje) - en eliminación - no listos |
|---|
Con 5 nodos y un budget del 10%, el resultado es 1. Ahora imagina que un nodo está atascado en un drain. Ese nodo ocupa el cupo, así que el budget permite 0 disrupciones más hasta que el drain termine.
Un budget permanente en cero frena demasiado. Mejor elige una ventana que coincida con tus horas de mayor actividad. Esta corre de lunes a viernes desde las 09:00 UTC durante 8 horas, y el primer budget mantiene el límite normal el resto del tiempo:
spec: disruption: budgets:- - nodes: '0'+ - nodes: 10%+ - nodes: '0'+ schedule: '0 9 * * mon-fri'+ duration: 8h+ reasons:+ - UnderutilizedEl congelamiento ahora solo detiene la eliminación de nodos subutilizados, y solo dentro de la ventana. Karpenter siempre lee un schedule en UTC.
Caso 2: Una anotación do-not-disrupt
La evidencia está en el nodo y en su NodeClaim. El evento DisruptionBlocked dice Pod has "karpenter.sh/do-not-disrupt" annotation (Pod=<namespace>/<name>). Cuando el propio nodo lleva la anotación, el mensaje es Disruption is blocked through the "karpenter.sh/do-not-disrupt" annotation.
Para encontrar la anotación, lista los pods y los nodos que la llevan. Estos comandos usan jq:
kubectl get pods -A -o json | jq -r '.items[] | select(.metadata.annotations["karpenter.sh/do-not-disrupt"] != null) | "\(.metadata.namespace)/\(.metadata.name) node=\(.spec.nodeName) value=\(.metadata.annotations["karpenter.sh/do-not-disrupt"])"'
kubectl get nodes -o json | jq -r '.items[] | select(.metadata.annotations["karpenter.sh/do-not-disrupt"] != null) | .metadata.name'
El valor "true" protege un pod de forma permanente. Una duración como "30m" lo protege durante ese tiempo desde que empieza a ejecutarse. La anotación funciona como un PDB para un solo pod: bloquea la consolidación, y bloquea el drift a menos que el NodePool defina terminationGracePeriod.
Una duración es más fácil de defender en una revisión que un valor permanente, porque indica cuánto tiempo necesita protección el pod en realidad. Si el equipo de la aplicación acepta que el pod puede moverse después de 30 minutos, cambia el valor de "true" a una duración:
template: metadata: annotations:- karpenter.sh/do-not-disrupt: "true"+ karpenter.sh/do-not-disrupt: "30m"Caso 3: Un PDB sin margen
La evidencia está en el nodo y en su NodeClaim. El evento DisruptionBlocked dice Pdb prevents pod evictions (PodDisruptionBudget=[<namespace>/<name>]).
Para confirmarlo, lista cada PDB con sus disrupciones permitidas:
kubectl get pdb -A -o custom-columns='NAMESPACE:.metadata.namespace,NAME:.metadata.name,MIN:.spec.minAvailable,MAXUNAVAIL:.spec.maxUnavailable,ALLOWED:.status.disruptionsAllowed'Un valor ALLOWED de 0 significa que ningún pod detrás de ese PDB puede salir en este momento. Si defines maxUnavailable en 0, o minAvailable en 100% o en el número de réplicas, estás exigiendo cero desalojos voluntarios, y el drain del nodo nunca se completa.
Karpenter necesita que el PDB que selecciona un pod permita el desalojo. Un pod debería tener un solo PDB. Si dos PDBs seleccionan el mismo pod, Kubernetes se niega a desalojarlo, incluso cuando ambos PDBs tienen margen. Karpenter puede no mostrar ningún evento en este caso. Las versiones recientes de Kubernetes escriben un evento MultiplePodDisruptionBudgets en el pod. Ese único pod puede entonces bloquear el nodo completo. Un pod que corre pero no está listo también puede bloquear un desalojo cuando el budget no tiene margen.
La solución es un cambio pequeño. Para un Deployment con 3 réplicas, usa maxUnavailable: 1 en lugar de minAvailable: 3:
spec: minAvailable: 3 maxUnavailable: 1Un PDB solo puede definir uno de los dos campos. Kubernetes recomienda maxUnavailable, porque se ajusta al número de réplicas.
Si un pod en crash loop bloquea el desalojo, agrega unhealthyPodEvictionPolicy: AlwaysAllow. Este campo es estable desde Kubernetes v1.31:
spec: maxUnavailable: 1 unhealthyPodEvictionPolicy: AlwaysAllowCaso 4: Pods que no pueden ejecutarse en otro nodo
Karpenter simula a dónde pueden ir los pods antes de eliminar un nodo. Si un pod no cabe en ningún otro lugar, el nodo se queda. Los eventos no siempre nombran a ese pod, así que lo encuentras en las especificaciones de los pods.
Para ver qué mantiene a cada pod del nodo en su lugar, lista los detalles de cada pod que corre en él:
kubectl get pods -A --field-selector spec.nodeName=$NODE -o json | jq '.items[] | {pod: "\(.metadata.namespace)/\(.metadata.name)", owner: (.metadata.ownerReferences[0].kind // "none"), nodeSelector: .spec.nodeSelector, requiredAntiAffinity: (.spec.affinity.podAntiAffinity.requiredDuringSchedulingIgnoredDuringExecution != null), topologySpread: [.spec.topologySpreadConstraints[]? | {key: .topologyKey, maxSkew: .maxSkew, whenUnsatisfiable: .whenUnsatisfiable}], claims: [.spec.volumes[]? | select(.persistentVolumeClaim != null) | .persistentVolumeClaim.claimName]}'Busca estas causas:
- Un request mayor que la capacidad libre de los otros nodos.
- Un
nodeSelectorque coincide solo con este grupo de nodos. - Una regla de anti-affinity obligatoria.
- Una regla de topology spread que los otros nodos no pueden cumplir.
- Un volumen ligado a una sola zona.
- Un taint en los otros nodos que el pod no tolera.
También conviene saber que las reglas preferidas de anti-affinity y de topology spread pueden reducir la efectividad de la consolidación, porque Karpenter intenta cumplirlas cuando elimina un nodo. Revisa además los pods sin controlador. No bloquean a Karpenter, pero nada los vuelve a iniciar después de un desalojo.
Empieza por la primera causa. Karpenter ubica los pods según sus requests, no según su uso. Compara el uso real con los requests:
sum by (namespace) (rate(container_cpu_usage_seconds_total{container!=""}[5m]))/sum by (namespace) (kube_pod_container_resource_requests{resource="cpu"})Una proporción muy por debajo de 1 significa que los requests son demasiado grandes. Cada nodo aloja entonces menos pods de los que podría, y pagas por el espacio vacío.
Si la evidencia muestra un request sobredimensionado, bájalo a la necesidad real. Cambia solo el valor que la evidencia señala:
resources: requests:- cpu: "4"+ cpu: "2"De la evidencia al diff: revisa antes de que alguien lo aplique
Cada caso termina en un diff pequeño. Revisa cada diff de la misma manera:
| Caso | El evento | Confírmalo con | El diff cambia | Responsable |
|---|---|---|---|---|
| Budget | DisruptionBlocked en el NodePool |
kubectl get nodepool con jsonpath |
Una entrada de budget | Equipo de plataforma |
| Anotación | DisruptionBlocked en el nodo |
Un filtro jq para pods y nodos |
Un valor de anotación | Equipo de aplicación |
| PDB | DisruptionBlocked en el nodo |
kubectl get pdb -A |
Un campo del PDB | Equipo de aplicación |
| Sin otro nodo | Unconsolidatable, o ningún evento |
Un filtro jq para la ubicación de los pods |
Un request o una regla | Equipo de aplicación |
Hazte estas seis preguntas antes de aplicar un diff:
- ¿Qué evento, campo o anotación demuestra el bloqueo?
- ¿El diff toca un solo campo o un solo objeto?
- ¿El responsable de ese objeto lo aprobó?
- ¿Qué limita cuántos nodos pueden moverse a la vez: un budget o una ventana de tiempo?
- ¿Cómo deshaces el cambio y qué te indica que debes deshacerlo?
- ¿El cambio se probó primero en un clúster de prueba o en un NodePool de sandbox?
Luego prueba el diff sin aplicarlo:
kubectl diff -f workshop-nodepool.yamlkubectl apply --dry-run=server -f workshop-nodepool.yamlEl comando kubectl diff muestra lo que kubectl apply cambiaría. El dry run del lado del servidor valida el cambio contra la API real y no guarda nada. El comando diff termina con código 1 cuando encuentra una diferencia, así que un script lo interpreta como un fallo.
Después de aplicar el diff, verifica el resultado:
kubectl get nodeclaims -wkubectl get pods -A --field-selector=status.phase!=Running,status.phase!=SucceededEl número de nodos debería bajar, y ningún pod debería quedar en espera ni fallar por el movimiento. El valor ALLOWED de cada PDB debería estar de nuevo por encima de 0 para los servicios que necesitan moverse.
Cómo puede ayudarte PerfectScale
PerfectScale by DoiT no reemplaza este proceso. Ayuda a tu equipo a recorrer la misma ruta con menos trabajo manual. El orden importa. Los requests con el tamaño correcto le dan a la consolidación más margen de mejora, por eso PerfectScale recomienda hacer primero right-sizing de los workloads. Después puedes ajustar el NodePool.
Así es como PerfectScale puede ayudarte:
- Consulta la configuración y cada cambio que recibe: La configuración de Karpenter cambia con el tiempo, así que ayuda ver qué cambió y cuándo. PerfectScale detecta Karpenter en el clúster y muestra la configuración del NodePool y de la node class, con un historial de cambios.
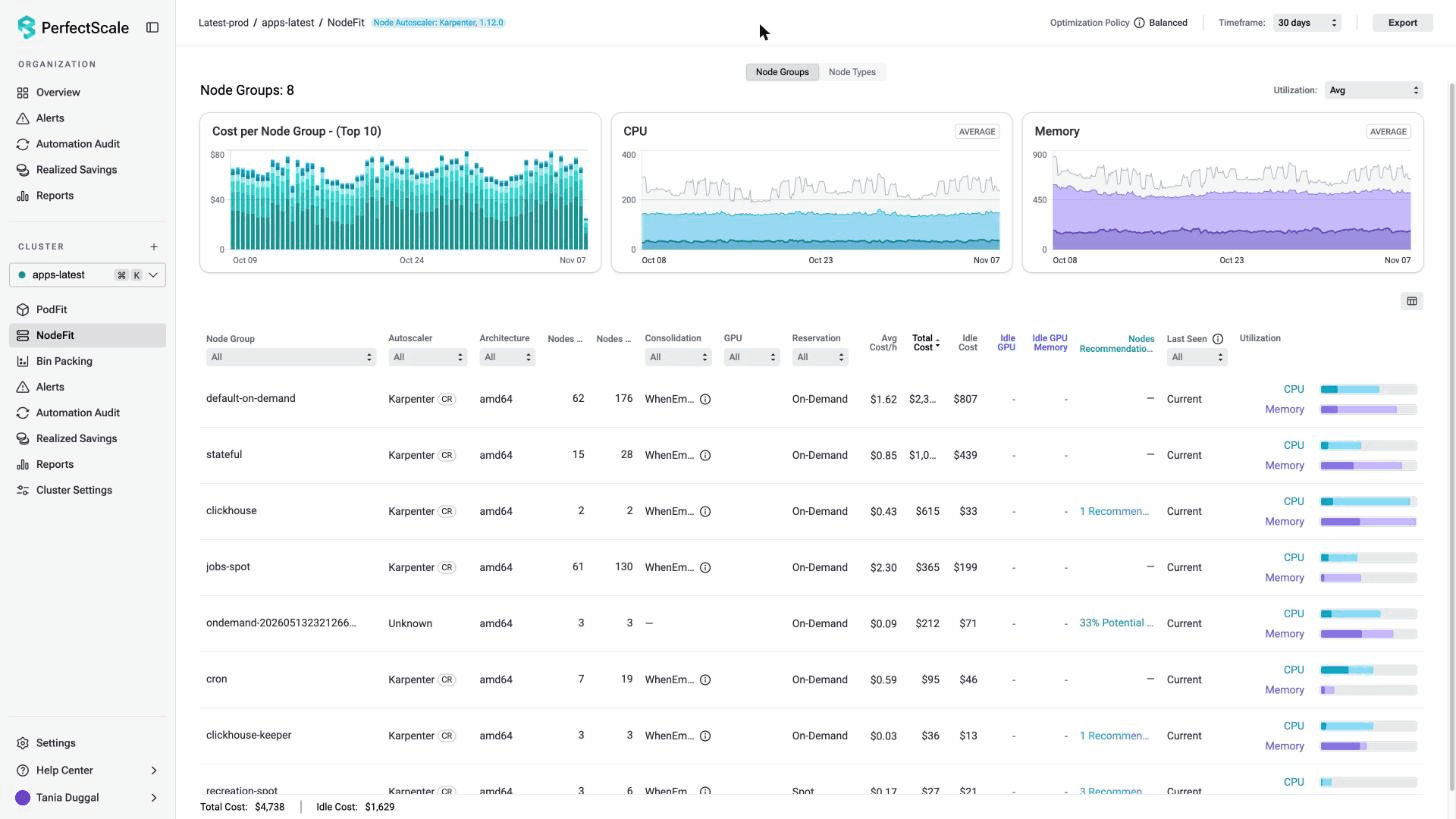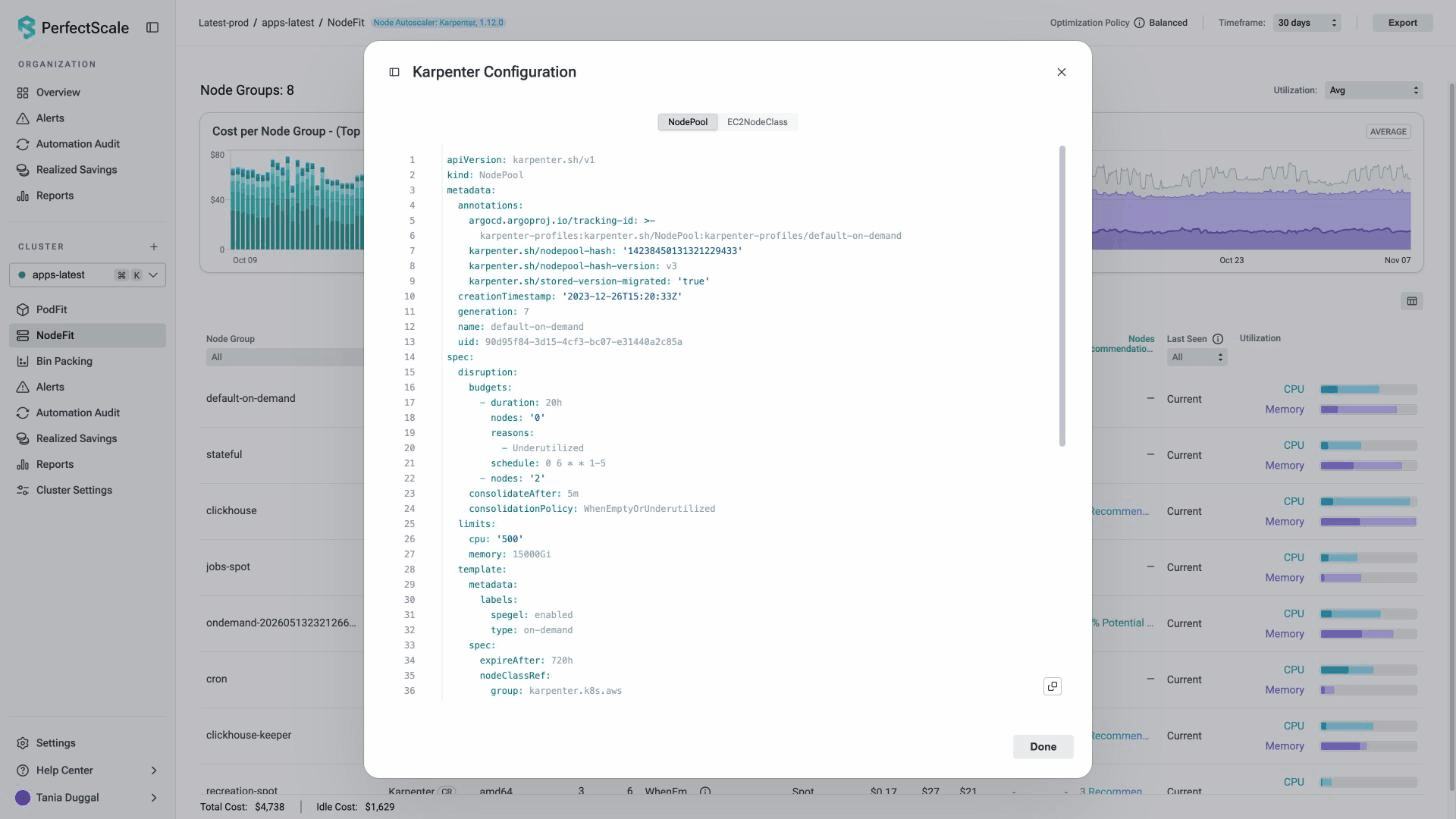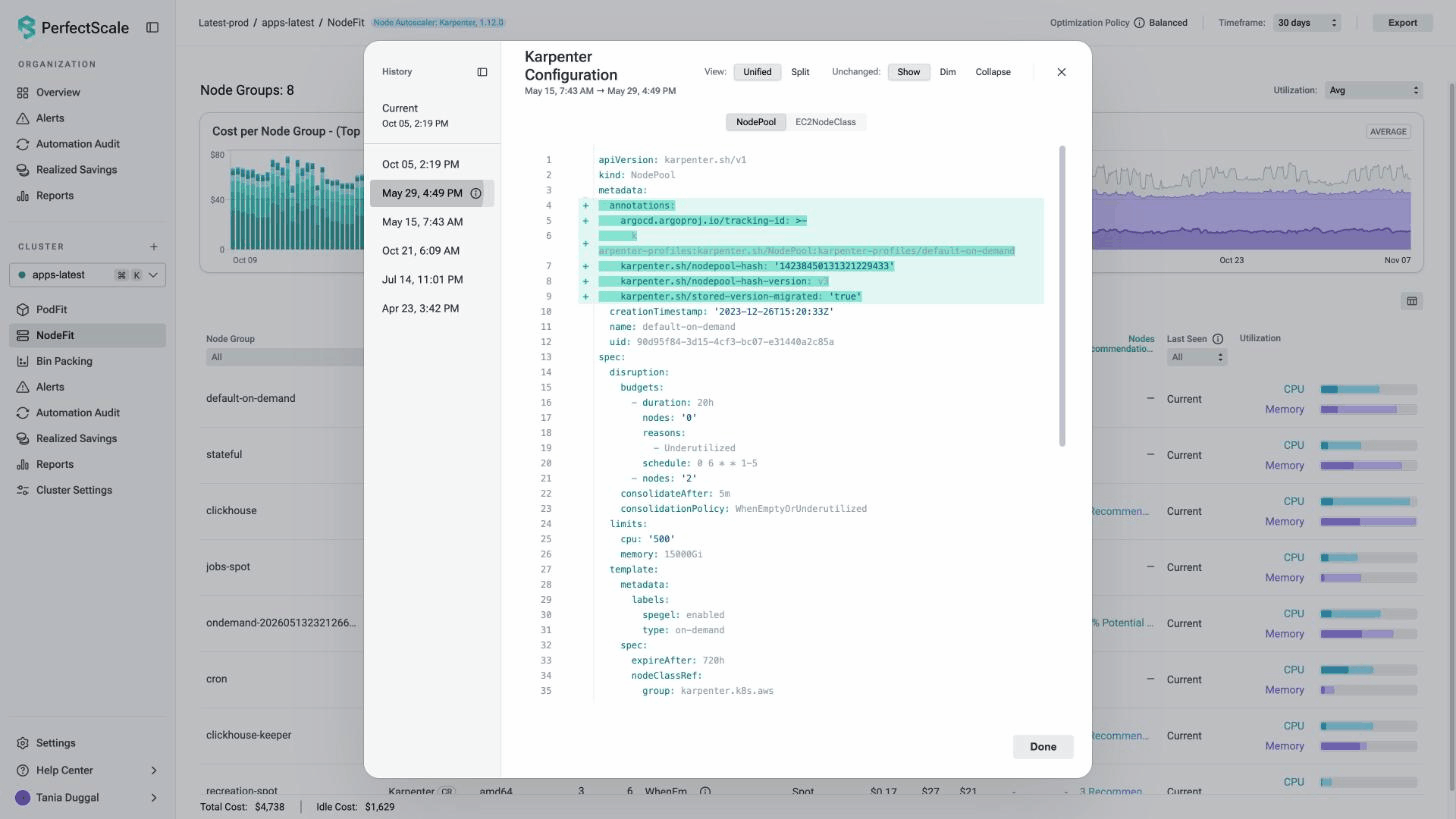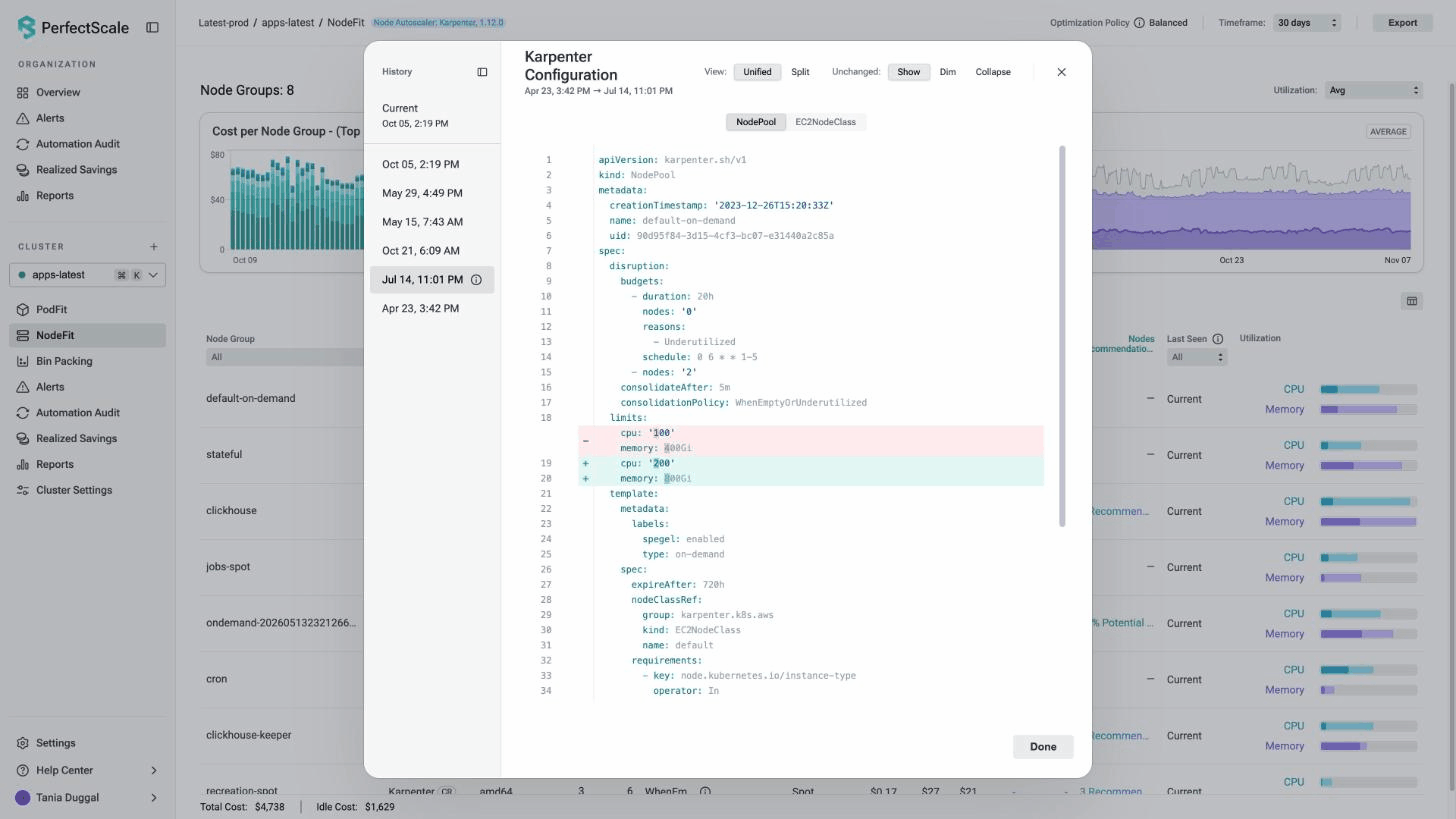
- Recibe recomendaciones para la configuración del NodePool: La política de consolidación, el tiempo de espera y las opciones de instancias determinan qué tan rápido Karpenter elimina nodos. PerfectScale ofrece recomendaciones de optimización de Karpenter para estos ajustes, y para los límites del NodePool que están cerca de agotarse. Sus recomendaciones te ayudan a:
- Revisar la política de consolidación y el tiempo de espera.
- Darle a Karpenter más opciones de instancias cuando aprovisiona nodos nuevos.
- Encontrar límites del NodePool que dejan muy poco espacio para capacidad nueva.
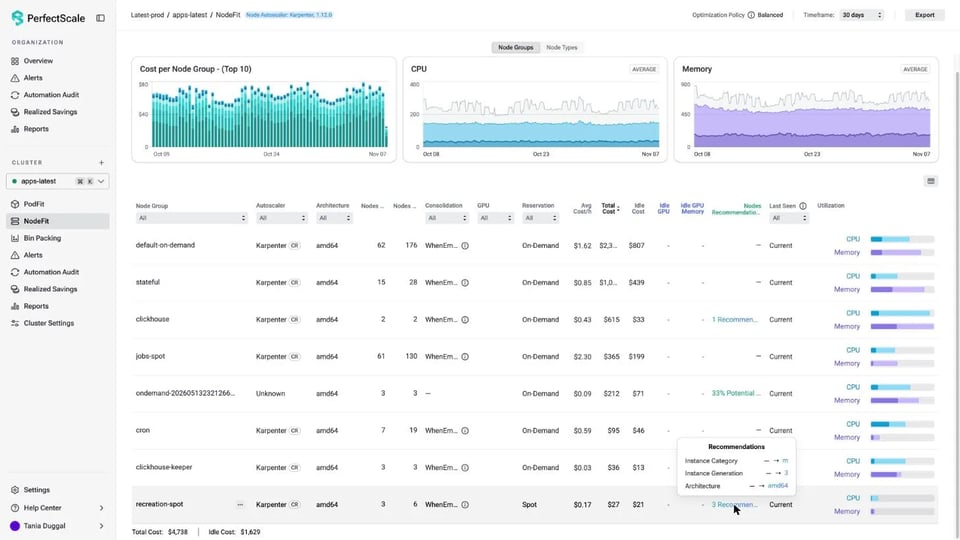
Una vista YAML muestra la configuración actual y la recomendada, y puedes copiar el resultado.
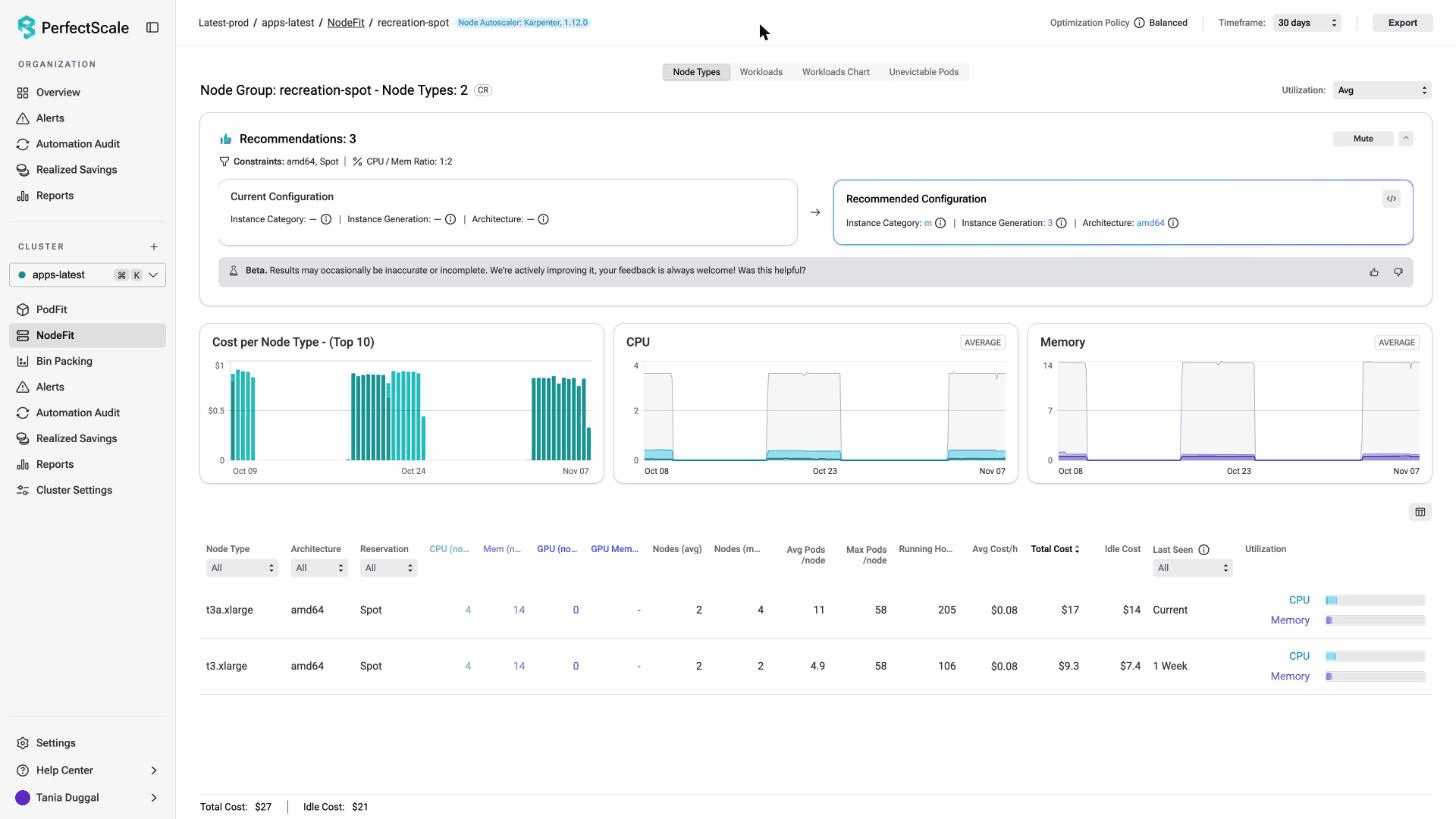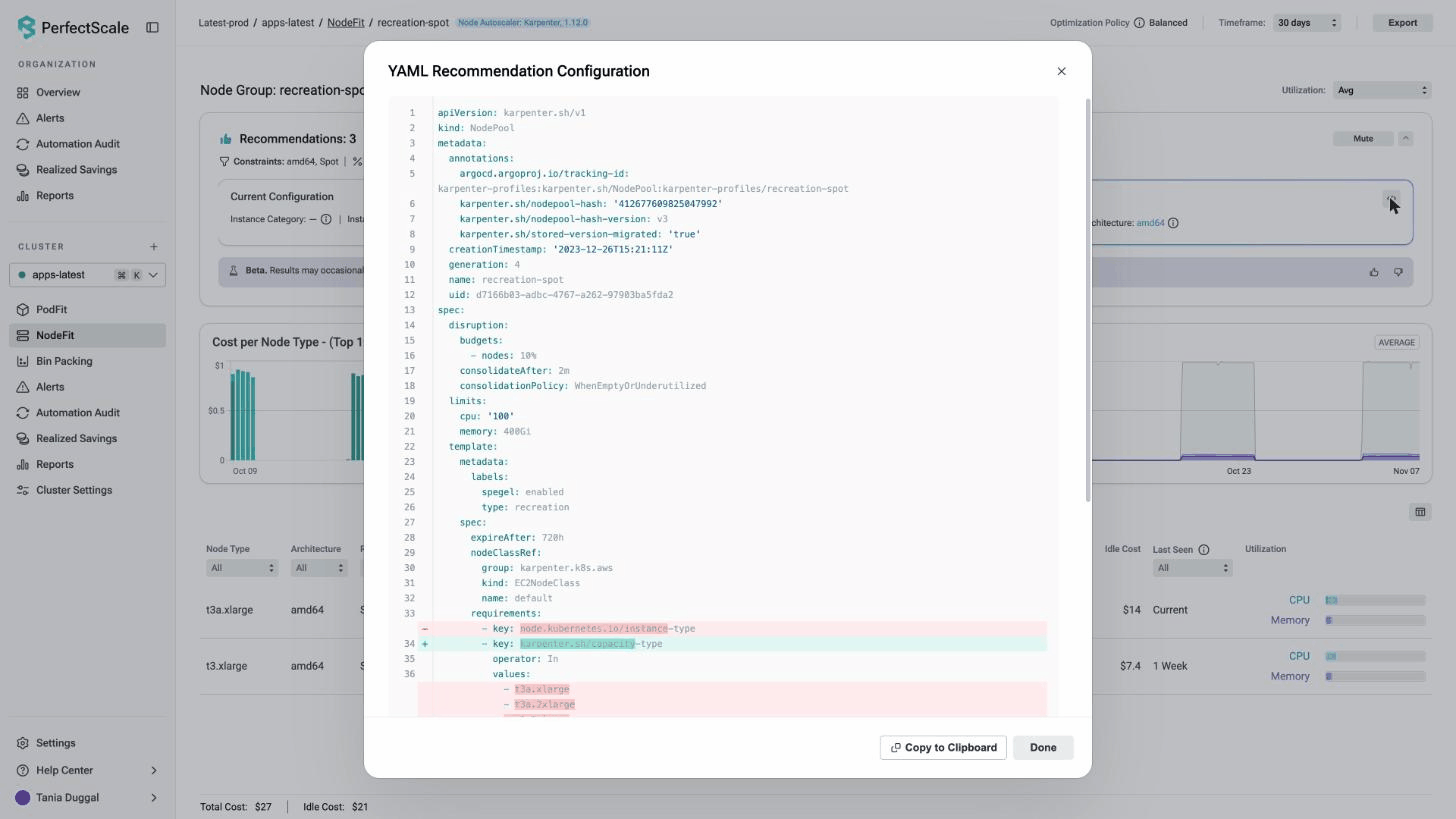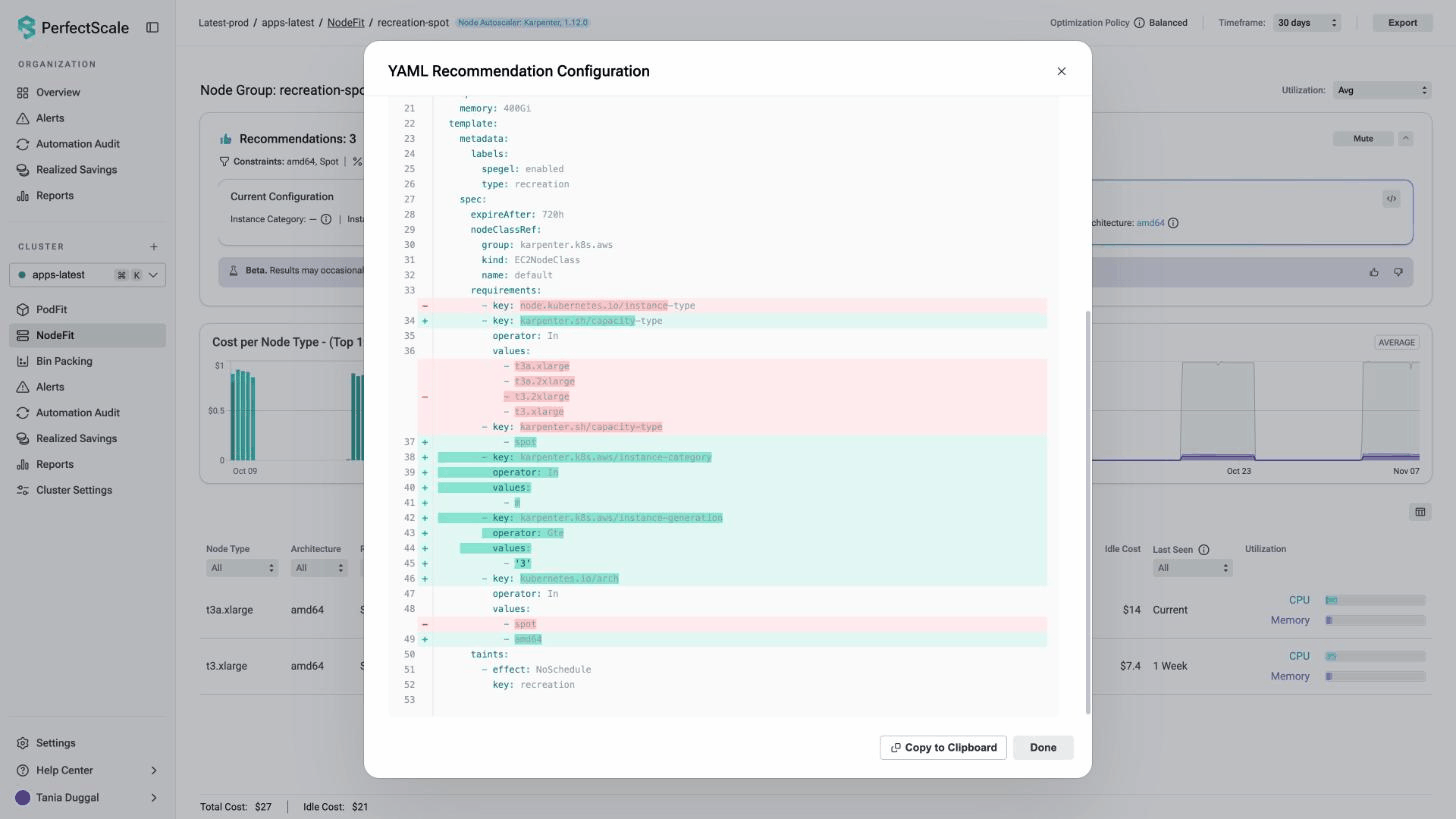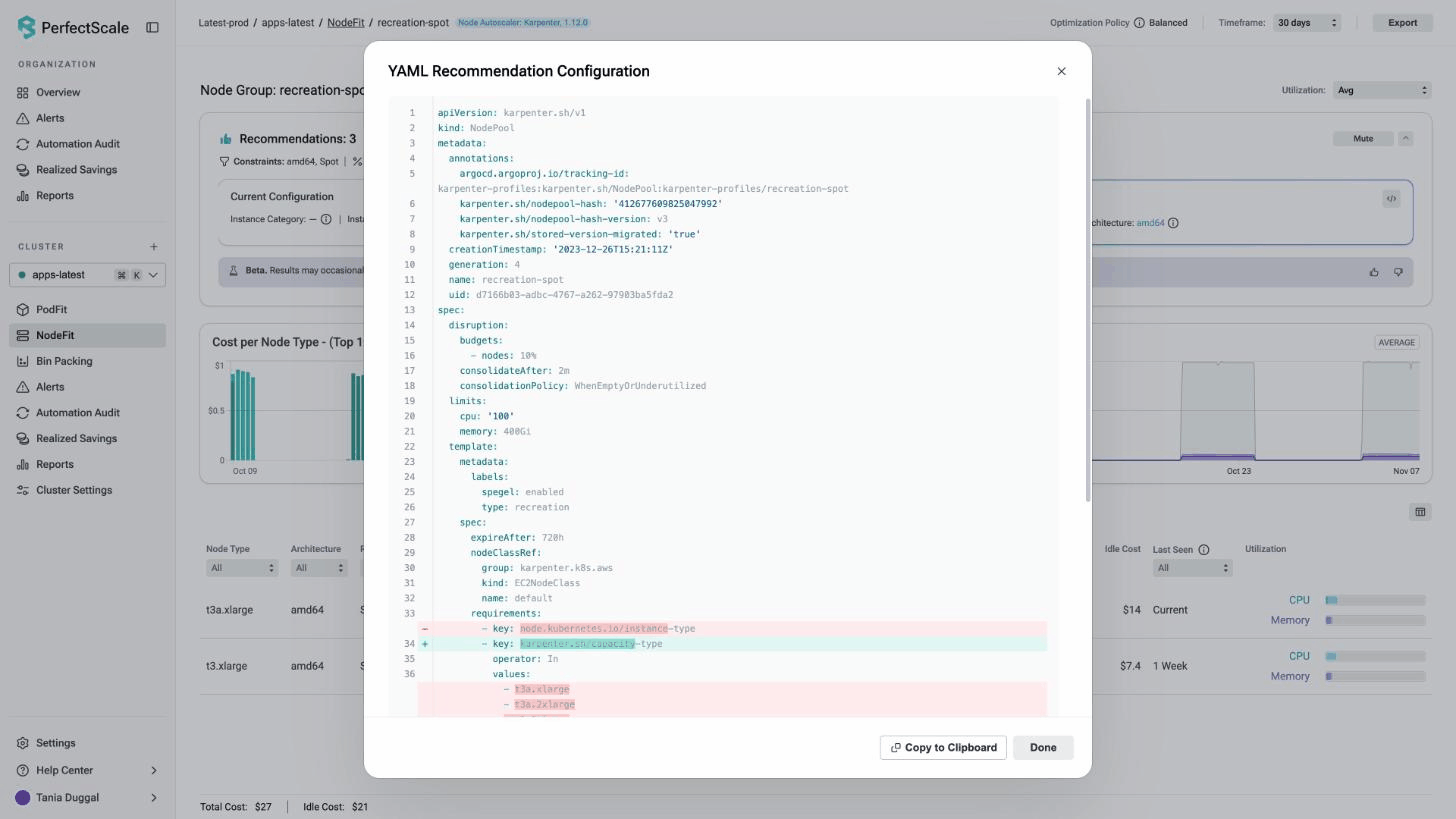
- Encuentra los pods que impiden eliminar nodos: Un solo pod que no se puede desalojar puede mantener corriendo un nodo completo. La vista de bin packing muestra qué pods impiden que se eliminen nodos. Ofrece recomendaciones en forma de diff de YAML ordenadas por impacto en el costo, y cada una tiene un nivel de confianza y un nivel de riesgo. Puedes silenciar un hallazgo que sea intencional.
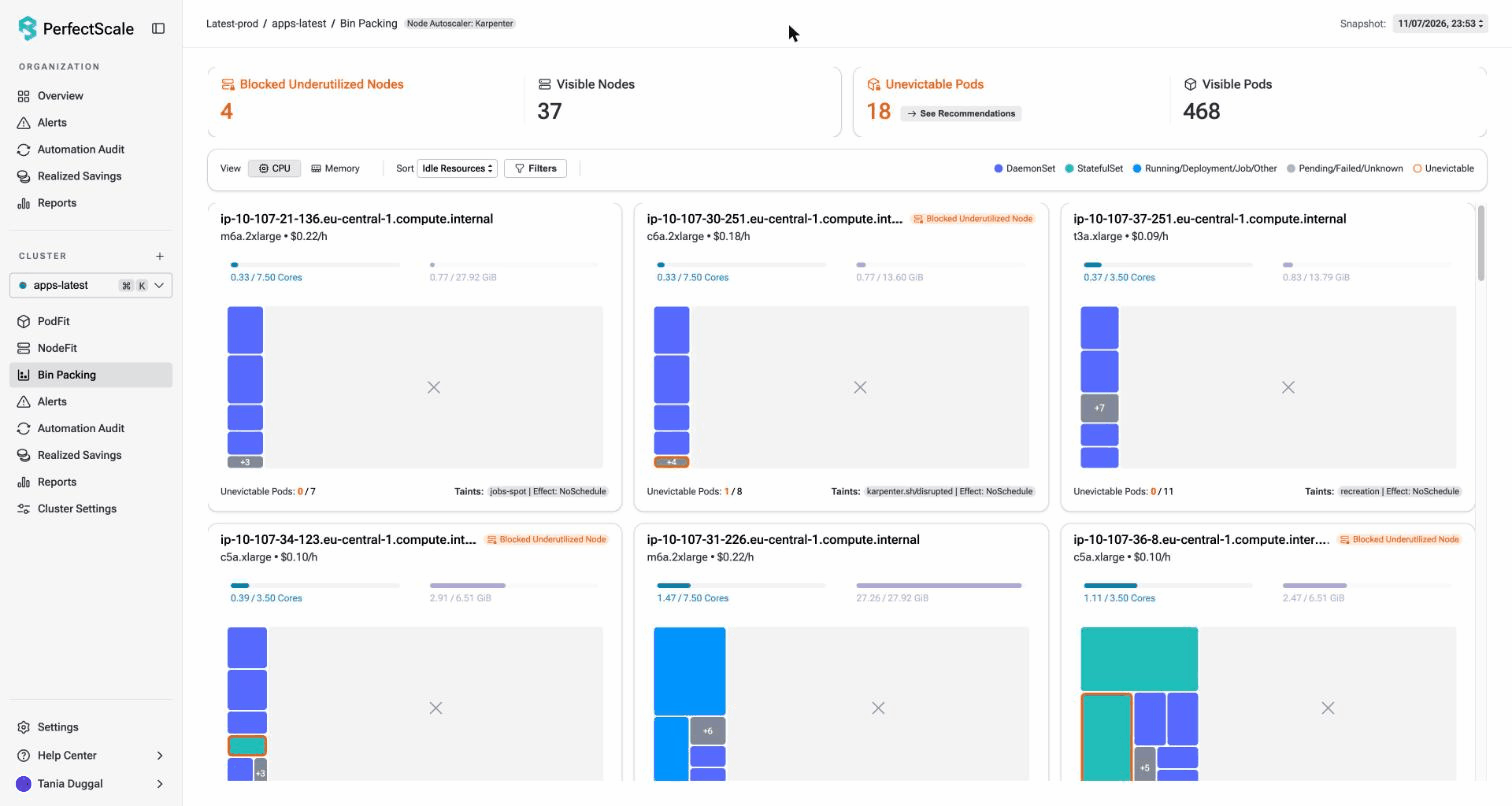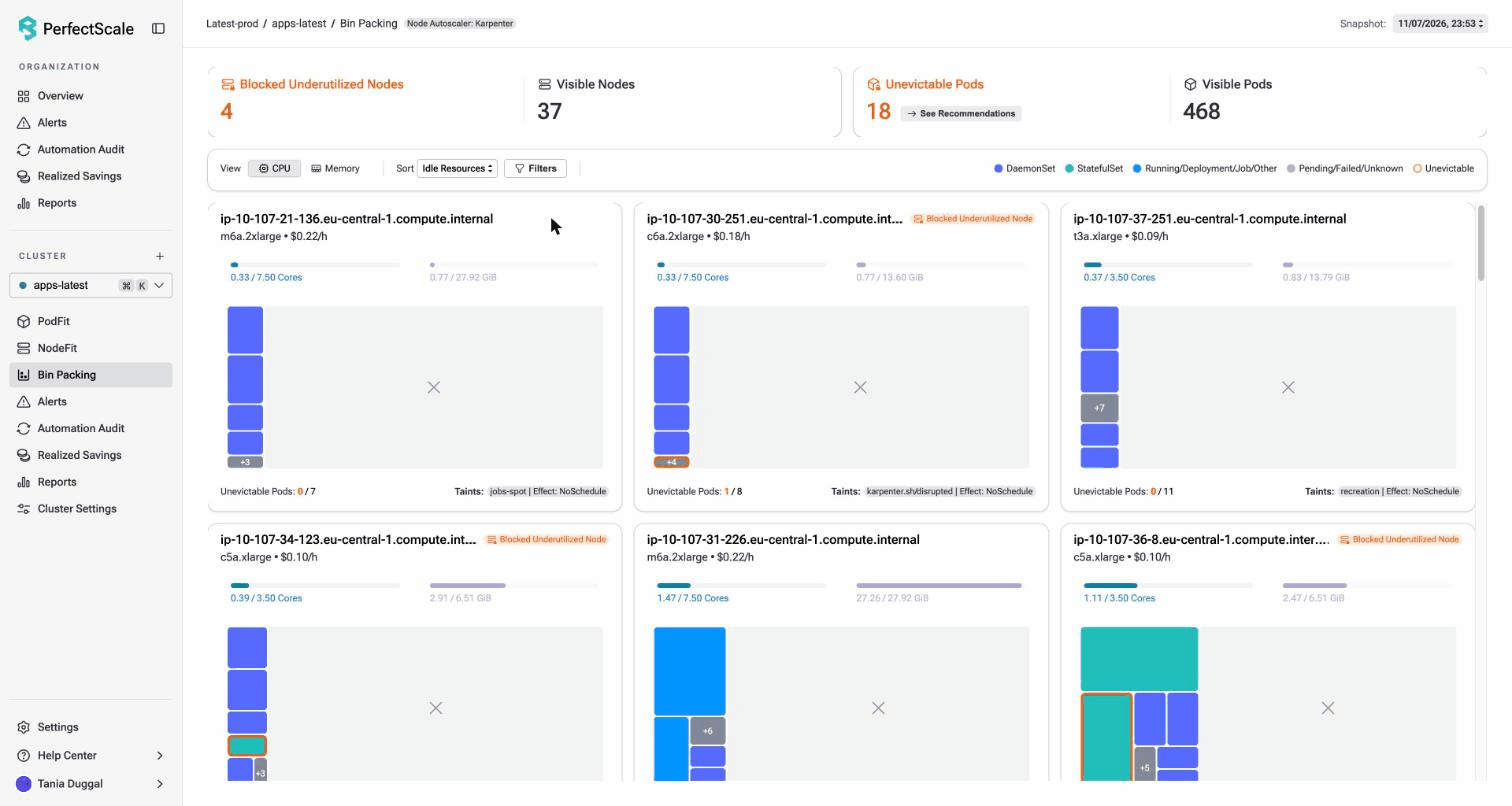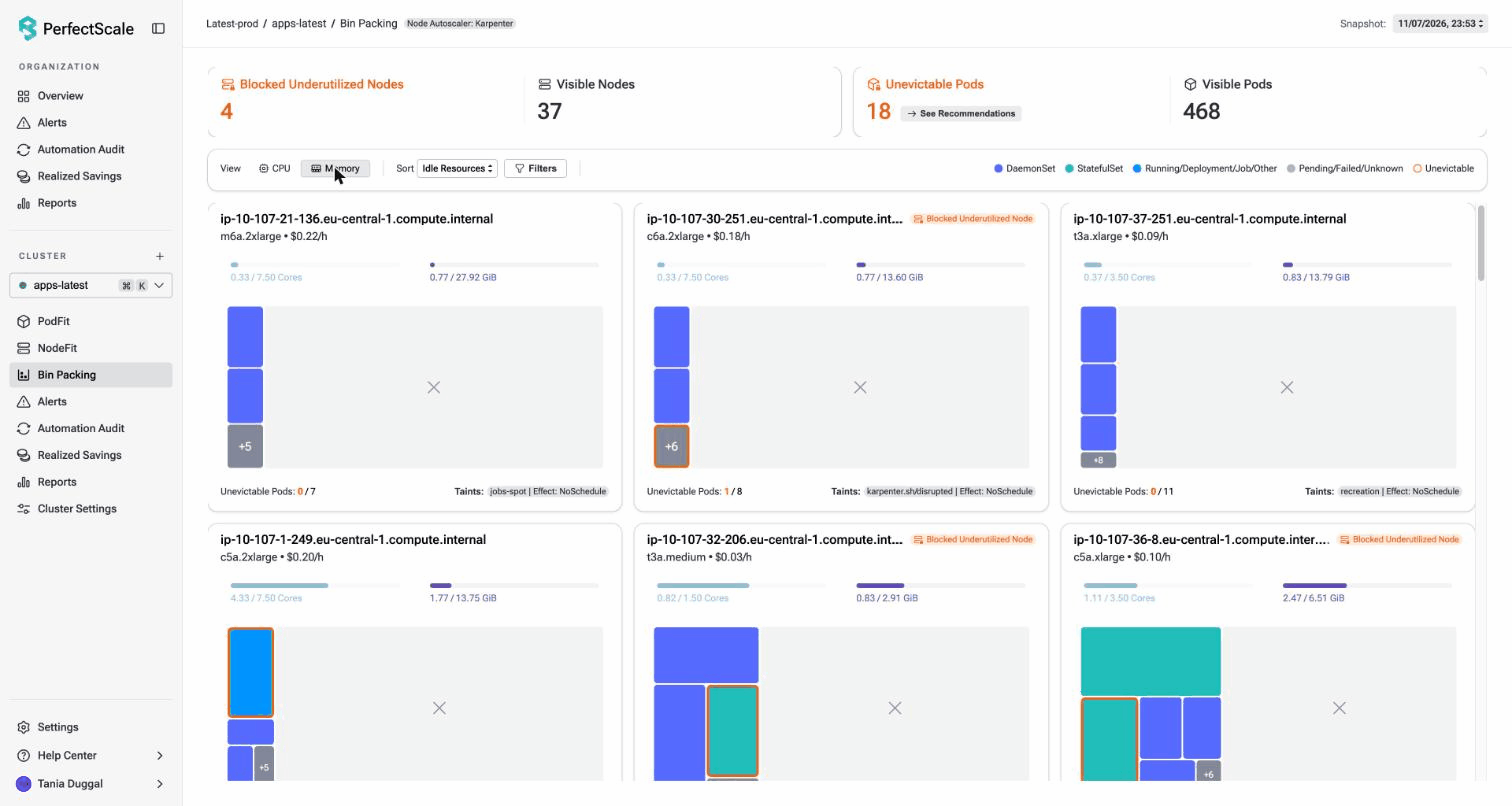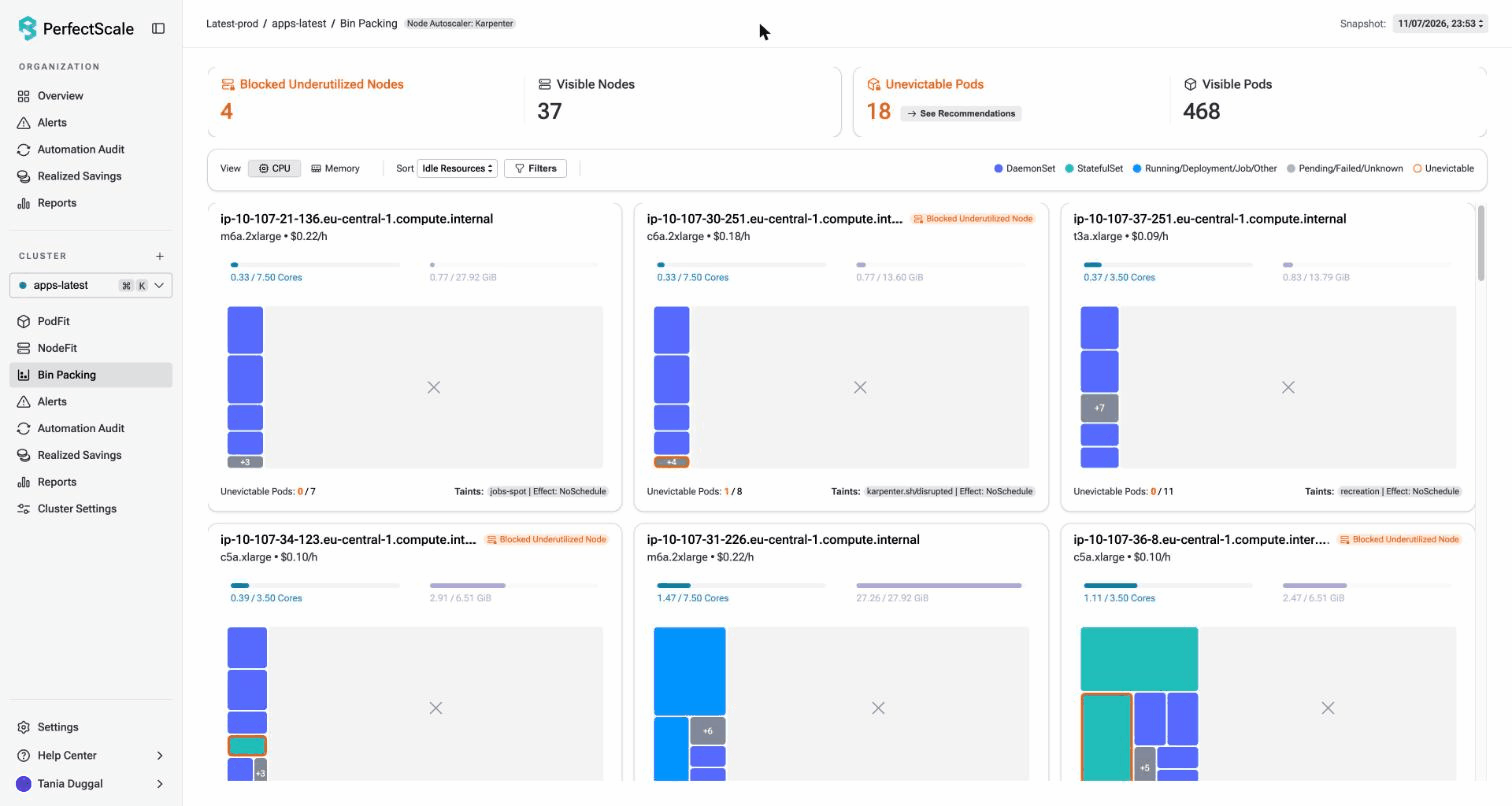
Un agente como Claude también puede consultar los datos de PerfectScale con la skill de agente de IA de PerfectScale. Después de cada cambio, usa el historial de cambios en tu revisión para ver qué cambió y qué automatizar a continuación.
Mira la ruta en acción con un agente en el workshop
La próxima vez que un nodo se quede corriendo, lee el evento antes de tocar cualquier configuración. Un agente puede ayudar con los primeros pasos, porque lee eventos, configuración y métricas mucho más rápido que tú. También puede dar una respuesta distinta cada vez que le preguntas. Por eso una persona revisa cada cambio, y por eso deben aplicarlo en producción reglas fijas, no un agente.
El workshop Agentic Karpenter: Using kagent + Claude to Tune Your Autoscaling se realiza el 17 de noviembre de 2026 a las 11 AM ET. Vikram Seshadri y Ramesh Mathikumar muestran cómo un agente lee eventos como estos y redacta el diff, y en qué punto toman el control las reglas fijas. Regístrate en el workshop.
¿Lidias con nodos que siguen corriendo? Nuestro equipo puede ayudarte a encontrar el bloqueo, revisar el cambio y recuperar capacidad sin comprometer la confiabilidad. Habla con nuestros expertos o regístrate gratis y pruébalo tú mismo.