

Vous réduisez un Deployment de 12 pods à 3, et un grand nœud se retrouve presque vide. Dans notre sandbox, avec un temps d'attente d'une minute, Karpenter remplace ce nœud par un plus petit en 80 secondes environ. Parfois, il ne le fait pas, et le grand nœud continue de tourner et de vous coûter de l'argent.
Si vous vous demandez pourquoi Karpenter ne consolide pas vos nœuds, commencez par les events. Karpenter écrit un event lorsqu'il ignore un nœud, et cet event pointe généralement vers la cause.
Un event désigne une cause, mais il ne vous donne pas la solution. Un PodDisruptionBudget (PDB), une annotation de pod, un budget de disruption et une règle de placement peuvent chacun maintenir un nœud en vie, et chacun relève d'une équipe différente. La personne qui lit l'event n'est pas toujours celle qui peut modifier la cause.
Suivez plutôt un chemin fixe. Lisez l'event, confirmez-le avec une commande, écrivez le plus petit changement possible sous forme de diff, et faites relire ce diff avant que quiconque ne l'applique. Nous appelons ce chemin de l'event au diff. Un diff ne montre que les lignes qui changent.
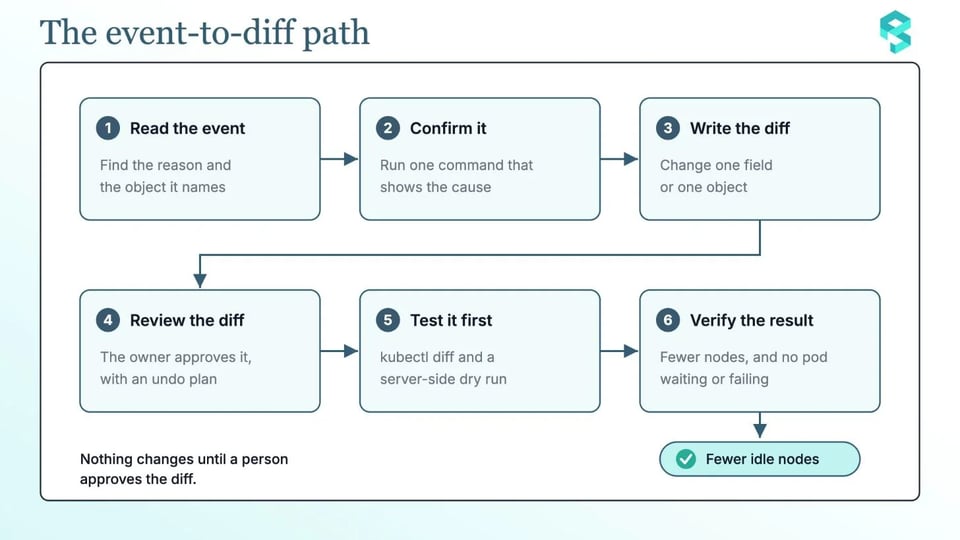
Cet article suit ce chemin avec quatre cas que vous pouvez rencontrer dans vos propres clusters :
- Un budget de disruption qui n'autorise aucune disruption
- Une annotation do-not-disrupt
- Un PDB sans marge
- Des pods qui ne peuvent pas s'exécuter sur un autre nœud
Les exemples utilisent Karpenter v1.15 sur AWS. Ils reposent sur un petit sandbox : un NodePool nommé workshop et un Deployment nommé inflate dans le namespace sandbox.
Ce que Karpenter fait par défaut
Karpenter peut retirer un nœud de deux façons. Si tous les pods tiennent sur la capacité libre des autres nœuds, il supprime le nœud. S'ils tiennent sur la capacité libre plus un nœud moins cher, il remplace le nœud.
Un NodePool qui ne définit rien d'autre reçoit consolidationPolicy: WhenEmptyOrUnderutilized et consolidateAfter: 0s. Il reçoit aussi un budget qui autorise Karpenter à perturber 10 % des nœuds à la fois.
Pour chaque disruption volontaire, Karpenter suit les six mêmes étapes :
- Choisir les nœuds candidats. Karpenter ignore un nœud qui héberge des pods non évincables, et il réexamine ce nœud plus tard.
- Vérifier que la disruption ne dépasse pas le budget du NodePool.
- Simuler la planification des pods du nœud, pour déterminer si des nœuds de remplacement sont nécessaires.
- Ajouter le taint
karpenter.sh/disrupted:NoSchedule, afin qu'aucun nouveau pod ne démarre sur le nœud. - Démarrer les nœuds de remplacement, si la simulation en a besoin, et attendre qu'ils soient prêts.
- Supprimer le nœud. Le processus de terminaison draine le nœud via l'API Eviction de Kubernetes, et respecte donc les PDB. Il ignore les pods statiques, les pods qui tolèrent le taint, et les pods terminés avec succès ou en échec.
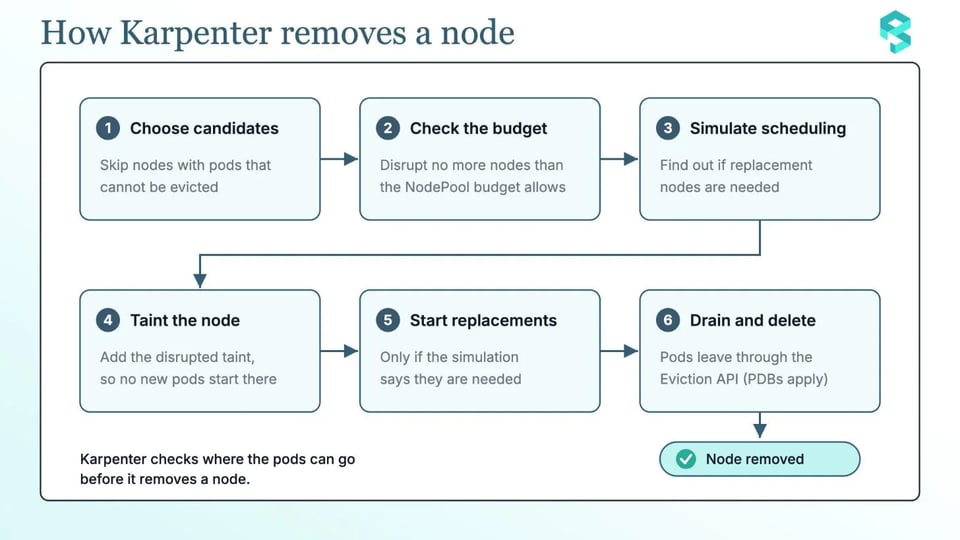
Un nœud reste en place lorsque Karpenter s'arrête à l'une de ces étapes, et les events vous indiquent laquelle. Les budgets et l'annotation do-not-disrupt n'affectent que la disruption volontaire. L'expiration, l'interruption et la suppression manuelle les ignorent.
Lisez d'abord les events
Karpenter écrit un event lorsqu'il ignore un nœud, et la raison vous indique quel type de problème vous avez. Unconsolidatable signifie que la consolidation ne s'applique pas à ce nœud. DisruptionBlocked signifie que quelque chose bloque la disruption : un PDB, une annotation sur un pod ou un nœud, ou un budget sur le NodePool.
Les events de nœud apparaissent sur le nœud et sur son NodeClaim. Les events de budget apparaissent sur le NodePool, pas sur le nœud. Ces commandes rassemblent les events d'un nœud, de son NodeClaim, de son NodePool et de l'ensemble du cluster. Remplacez $NODE, $NODECLAIM et $NODEPOOL par vos propres noms :
kubectl describe node $NODEkubectl describe nodeclaim $NODECLAIMkubectl describe nodepool $NODEPOOLkubectl get events -A --field-selector reason=Unconsolidatable --sort-by=.lastTimestampkubectl get events -A --field-selector reason=DisruptionBlocked --sort-by=.lastTimestampDans Karpenter v1.15, les messages des quatre cas ressemblent à ceci :
| Message | Signification | À confirmer avec |
|---|---|---|
No allowed disruptions for disruption reason Underutilized due to blocking budget |
Un budget n'autorise aucune disruption pour le moment. Cet event se trouve sur le NodePool. | Le bloc disruption du NodePool |
Pod has "karpenter.sh/do-not-disrupt" annotation (Pod=<namespace>/<name>) |
Un pod du nœud porte l'annotation. | Les annotations des pods du nœud |
Pdb prevents pod evictions (PodDisruptionBudget=[<namespace>/<name>]) |
Un PDB n'a plus de marge pour un pod du nœud. | La valeur ALLOWED de chaque PDB |
Can't replace with a cheaper node |
Karpenter n'a trouvé aucun nœud moins cher capable d'accueillir les pods. | Les requests des pods, les requirements du NodePool et les limites du NodePool |
Deux autres messages pointent vers les réglages du NodePool. NodePool "<name>" has consolidation disabled signifie que consolidateAfter vaut Never. NodePool "<name>" has consolidation policy WhenEmpty, but node is not empty signifie que la politique ne considère que les nœuds vides. Sur les nœuds Spot, Karpenter ne remplace un nœud que lorsque la feature gate SpotToSpotConsolidation est activée.
Vous pouvez maintenant suivre le chemin avec chaque cas, un par un :
Cas 1 : un budget qui n'autorise aucune disruption
Ici, la preuve se trouve sur le NodePool, pas sur le nœud. Il porte un event DisruptionBlocked qui indique No allowed disruptions for disruption reason Underutilized due to blocking budget.
Pour le confirmer, lisez le bloc disruption du NodePool :
kubectl get nodepool $NODEPOOL -o jsonpath='{.spec.disruption}{"\n"}'Cherchez nodes: '0', ou un budget avec un schedule et une duration actifs en ce moment. Un budget avec nodes: '0' et sans reasons bloque toute disruption volontaire. Lorsqu'un NodePool possède plusieurs budgets, Karpenter applique le résultat le plus bas.
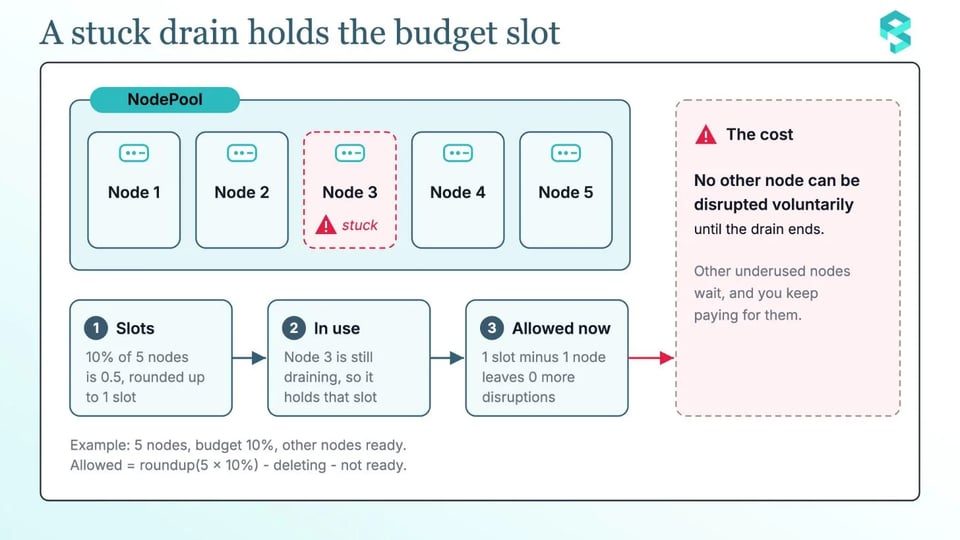
Karpenter compte aussi les nœuds déjà en cours de suppression. Pour un pourcentage, il calcule les disruptions autorisées ainsi :
| autorisées = arrondi_supérieur(total x pourcentage) - en suppression - non prêts |
|---|
Avec 5 nœuds et un budget de 10 %, le résultat est 1. Imaginez maintenant qu'un nœud soit bloqué en plein drain. Ce nœud occupe la place disponible, le budget n'autorise donc aucune disruption supplémentaire jusqu'à la fin du drain.
Un budget à zéro en permanence bloque trop de choses. Choisissez plutôt une fenêtre qui correspond à vos heures de pointe. Celle-ci s'applique en semaine à partir de 09:00 UTC pendant 8 heures, et le premier budget conserve la limite normale le reste du temps :
spec: disruption: budgets:- - nodes: '0'+ - nodes: 10%+ - nodes: '0'+ schedule: '0 9 * * mon-fri'+ duration: 8h+ reasons:+ - UnderutilizedLe gel ne bloque désormais que le retrait des nœuds sous-utilisés, et uniquement à l'intérieur de la fenêtre. Karpenter lit toujours un schedule en UTC.
Cas 2 : une annotation do-not-disrupt
La preuve se trouve sur le nœud et sur son NodeClaim. L'event DisruptionBlocked indique Pod has "karpenter.sh/do-not-disrupt" annotation (Pod=<namespace>/<name>). Lorsque le nœud lui-même porte l'annotation, le message est Disruption is blocked through the "karpenter.sh/do-not-disrupt" annotation.
Pour trouver l'annotation, listez les pods et les nœuds qui la portent. Ces commandes utilisent jq :
kubectl get pods -A -o json | jq -r '.items[] | select(.metadata.annotations["karpenter.sh/do-not-disrupt"] != null) | "\(.metadata.namespace)/\(.metadata.name) node=\(.spec.nodeName) value=\(.metadata.annotations["karpenter.sh/do-not-disrupt"])"'
kubectl get nodes -o json | jq -r '.items[] | select(.metadata.annotations["karpenter.sh/do-not-disrupt"] != null) | .metadata.name'
La valeur "true" protège un pod définitivement. Une durée comme "30m" le protège pendant cette durée après son démarrage. L'annotation fonctionne comme un PDB pour un seul pod : elle bloque la consolidation, et elle bloque le drift sauf si le NodePool définit terminationGracePeriod.
Une durée est plus facile à défendre en revue qu'une valeur permanente, car elle indique combien de temps le pod a réellement besoin d'être protégé. Si l'équipe applicative accepte que le pod puisse bouger après 30 minutes, remplacez la valeur "true" par une durée :
template: metadata: annotations:- karpenter.sh/do-not-disrupt: "true"+ karpenter.sh/do-not-disrupt: "30m"Cas 3 : un PDB sans marge
La preuve se trouve sur le nœud et sur son NodeClaim. L'event DisruptionBlocked indique Pdb prevents pod evictions (PodDisruptionBudget=[<namespace>/<name>]).
Pour le confirmer, listez chaque PDB avec ses disruptions autorisées :
kubectl get pdb -A -o custom-columns='NAMESPACE:.metadata.namespace,NAME:.metadata.name,MIN:.spec.minAvailable,MAXUNAVAIL:.spec.maxUnavailable,ALLOWED:.status.disruptionsAllowed'Une valeur ALLOWED de 0 signifie qu'aucun pod derrière ce PDB ne peut être évincé pour le moment. Si vous définissez maxUnavailable à 0, ou minAvailable à 100 % ou au nombre de réplicas, vous exigez zéro éviction volontaire, et un drain du nœud ne se termine jamais.
Karpenter a besoin que le PDB qui sélectionne un pod autorise l'éviction. Un pod ne devrait avoir qu'un seul PDB. Si deux PDB sélectionnent le même pod, Kubernetes refuse de l'évincer, même lorsque les deux PDB ont de la marge. Karpenter peut ne montrer aucun event pour ce cas. Les versions récentes de Kubernetes écrivent un event MultiplePodDisruptionBudgets sur le pod. Ce seul pod peut alors bloquer tout le nœud. Un pod qui tourne mais n'est pas prêt peut aussi bloquer une éviction lorsque le budget n'a plus de marge.
Le correctif tient en un petit changement. Pour un Deployment avec 3 réplicas, utilisez maxUnavailable: 1 au lieu de minAvailable: 3 :
spec: minAvailable: 3 maxUnavailable: 1Un PDB ne peut définir qu'un seul des deux champs. Kubernetes recommande maxUnavailable, car il suit le nombre de réplicas.
Si un pod en crash-loop bloque l'éviction, ajoutez unhealthyPodEvictionPolicy: AlwaysAllow. Ce champ est stable depuis Kubernetes v1.31 :
spec: maxUnavailable: 1 unhealthyPodEvictionPolicy: AlwaysAllowCas 4 : des pods qui ne peuvent pas s'exécuter sur un autre nœud
Karpenter simule où les pods peuvent aller avant de retirer un nœud. Si un pod ne tient nulle part ailleurs, le nœud reste. Les events ne nomment pas toujours ce pod ; il faut donc le chercher dans les specs des pods.
Pour voir ce qui lie chaque pod du nœud à son emplacement, listez les détails de chaque pod qui s'y trouve :
kubectl get pods -A --field-selector spec.nodeName=$NODE -o json | jq '.items[] | {pod: "\(.metadata.namespace)/\(.metadata.name)", owner: (.metadata.ownerReferences[0].kind // "none"), nodeSelector: .spec.nodeSelector, requiredAntiAffinity: (.spec.affinity.podAntiAffinity.requiredDuringSchedulingIgnoredDuringExecution != null), topologySpread: [.spec.topologySpreadConstraints[]? | {key: .topologyKey, maxSkew: .maxSkew, whenUnsatisfiable: .whenUnsatisfiable}], claims: [.spec.volumes[]? | select(.persistentVolumeClaim != null) | .persistentVolumeClaim.claimName]}'Cherchez ces causes :
- Une request plus grande que la capacité libre des autres nœuds.
- Un
nodeSelectorqui ne correspond qu'à ce groupe de nœuds. - Une règle d'anti-affinité requise.
- Une règle de topology spread que les autres nœuds ne peuvent pas satisfaire.
- Un volume lié à une seule zone.
- Un taint sur les autres nœuds que le pod ne tolère pas.
Sachez aussi que les règles d'anti-affinité et de topology spread en mode preferred peuvent réduire l'efficacité de la consolidation, car Karpenter essaie de les satisfaire lorsqu'il retire un nœud. Vérifiez également les pods sans contrôleur. Ils ne bloquent pas Karpenter, mais rien ne les redémarre après une éviction.
Commencez par la première cause. Karpenter place les pods selon leurs requests, pas selon leur utilisation. Comparez l'utilisation réelle aux requests :
sum by (namespace) (rate(container_cpu_usage_seconds_total{container!=""}[5m]))/sum by (namespace) (kube_pod_container_resource_requests{resource="cpu"})Un ratio bien inférieur à 1 signifie que les requests sont trop grandes. Chaque nœud héberge alors moins de pods qu'il ne le pourrait, et vous payez cet espace vide.
Si la preuve révèle une request surdimensionnée, abaissez-la au besoin réel. Ne modifiez que la valeur désignée par la preuve :
resources: requests:- cpu: "4"+ cpu: "2"De la preuve au diff : une revue avant toute application
Chaque cas se termine par un petit diff. Passez chaque diff en revue de la même manière :
| Cas | L'event | À confirmer avec | Le diff modifie | Responsable |
|---|---|---|---|---|
| Budget | DisruptionBlocked sur le NodePool |
kubectl get nodepool avec jsonpath |
Une entrée de budget | Équipe plateforme |
| Annotation | DisruptionBlocked sur le nœud |
Un filtre jq pour les pods et les nœuds |
Une valeur d'annotation | Équipe applicative |
| PDB | DisruptionBlocked sur le nœud |
kubectl get pdb -A |
Un champ du PDB | Équipe applicative |
| Aucun autre nœud | Unconsolidatable, ou aucun event |
Un filtre jq pour le placement des pods |
Une request ou une règle | Équipe applicative |
Posez ces six questions avant d'appliquer un diff :
- Quel event, champ ou annotation prouve le blocage ?
- Le diff ne touche-t-il qu'un seul champ ou un seul objet ?
- Le responsable de cet objet l'a-t-il approuvé ?
- Qu'est-ce qui limite le nombre de nœuds pouvant bouger en même temps : un budget ou une fenêtre horaire ?
- Comment annulez-vous le changement, et qu'est-ce qui vous indique de l'annuler ?
- Le changement a-t-il d'abord été testé sur un cluster de test ou sur un NodePool sandbox ?
Testez ensuite le diff sans l'appliquer :
kubectl diff -f workshop-nodepool.yamlkubectl apply --dry-run=server -f workshop-nodepool.yamlLa commande kubectl diff montre ce que kubectl apply modifierait. Le dry run côté serveur vérifie le changement auprès de l'API réelle, sans rien enregistrer. La commande diff se termine avec le code 1 lorsqu'elle trouve une différence, de sorte qu'un script l'interprète comme un échec.
Après avoir appliqué le diff, vérifiez le résultat :
kubectl get nodeclaims -wkubectl get pods -A --field-selector=status.phase!=Running,status.phase!=SucceededLe nombre de nœuds devrait baisser, et aucun pod ne devrait attendre ou échouer à cause du déplacement. La valeur ALLOWED de chaque PDB devrait repasser au-dessus de 0 pour les services qui doivent bouger.
Comment PerfectScale peut vous aider
PerfectScale by DoiT ne remplace pas ce processus. Il aide votre équipe à suivre le même chemin avec moins de travail manuel. L'ordre compte : des requests bien dimensionnées donnent plus de gains à la consolidation, c'est pourquoi PerfectScale recommande de commencer par le right-sizing des workloads. Vous pouvez ensuite ajuster le NodePool.
Voici comment PerfectScale peut vous aider :
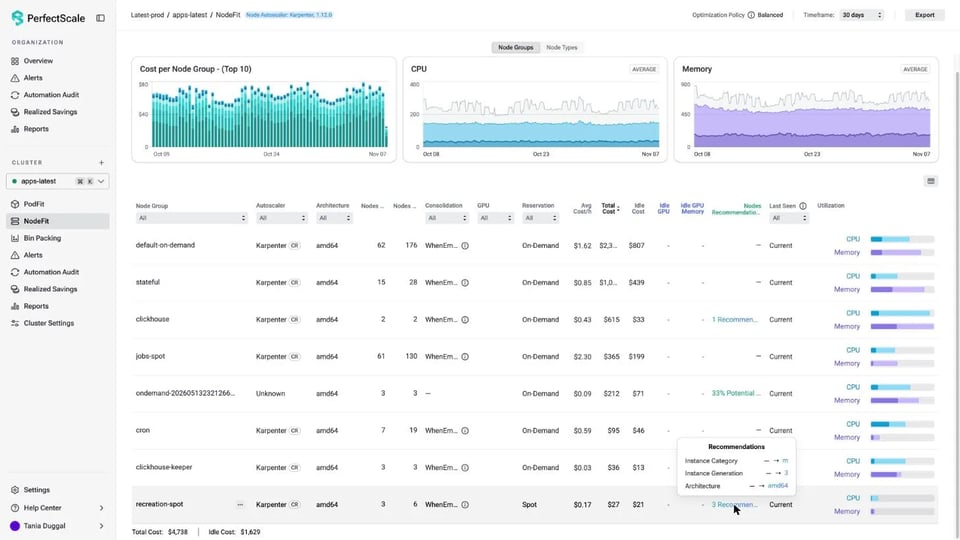
- Visualiser la configuration et chacune de ses modifications : les réglages Karpenter évoluent avec le temps, il est donc utile de voir ce qui a changé et quand. PerfectScale détecte Karpenter dans le cluster et affiche la configuration du NodePool et de la node class, avec un historique des modifications.
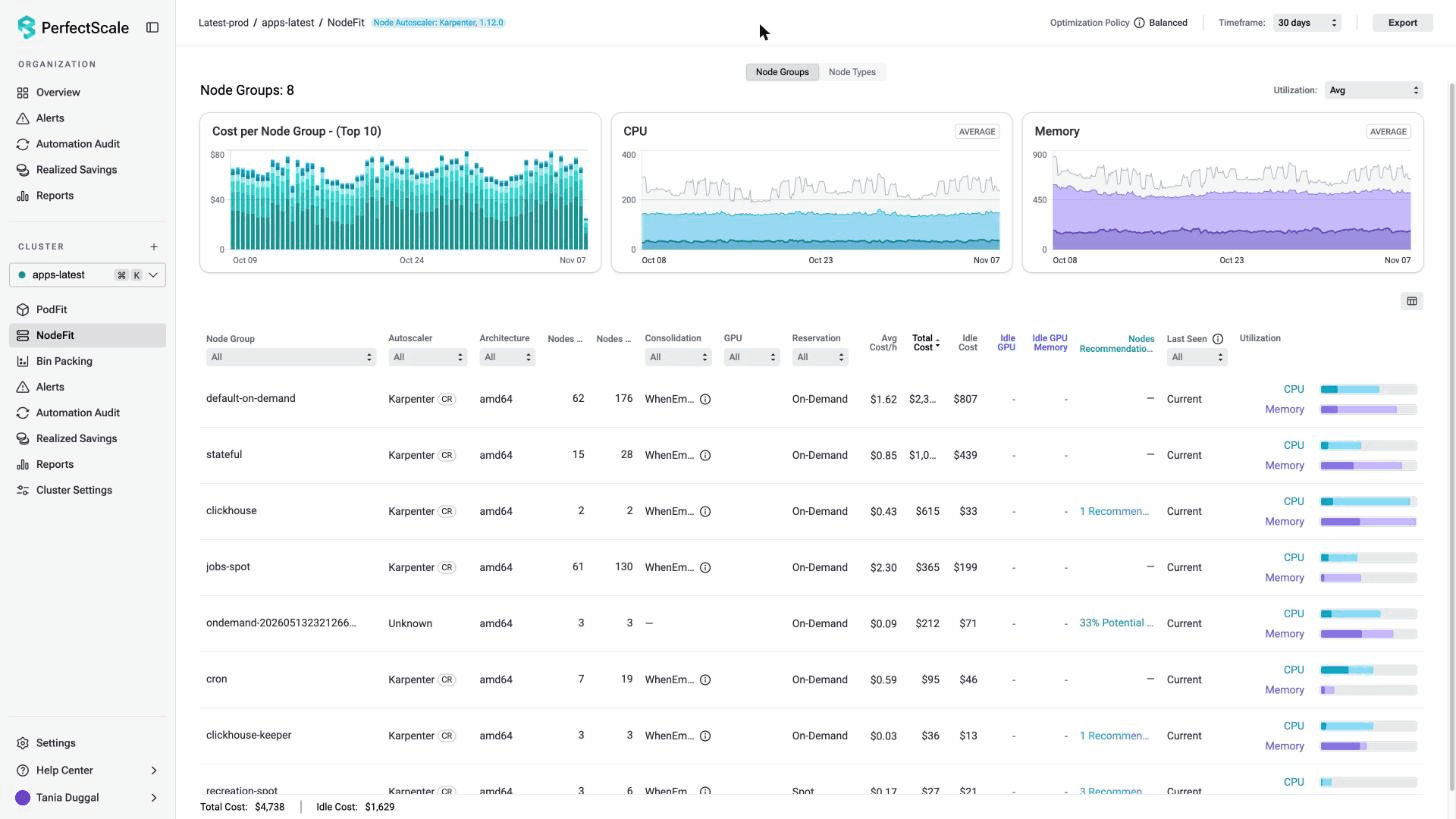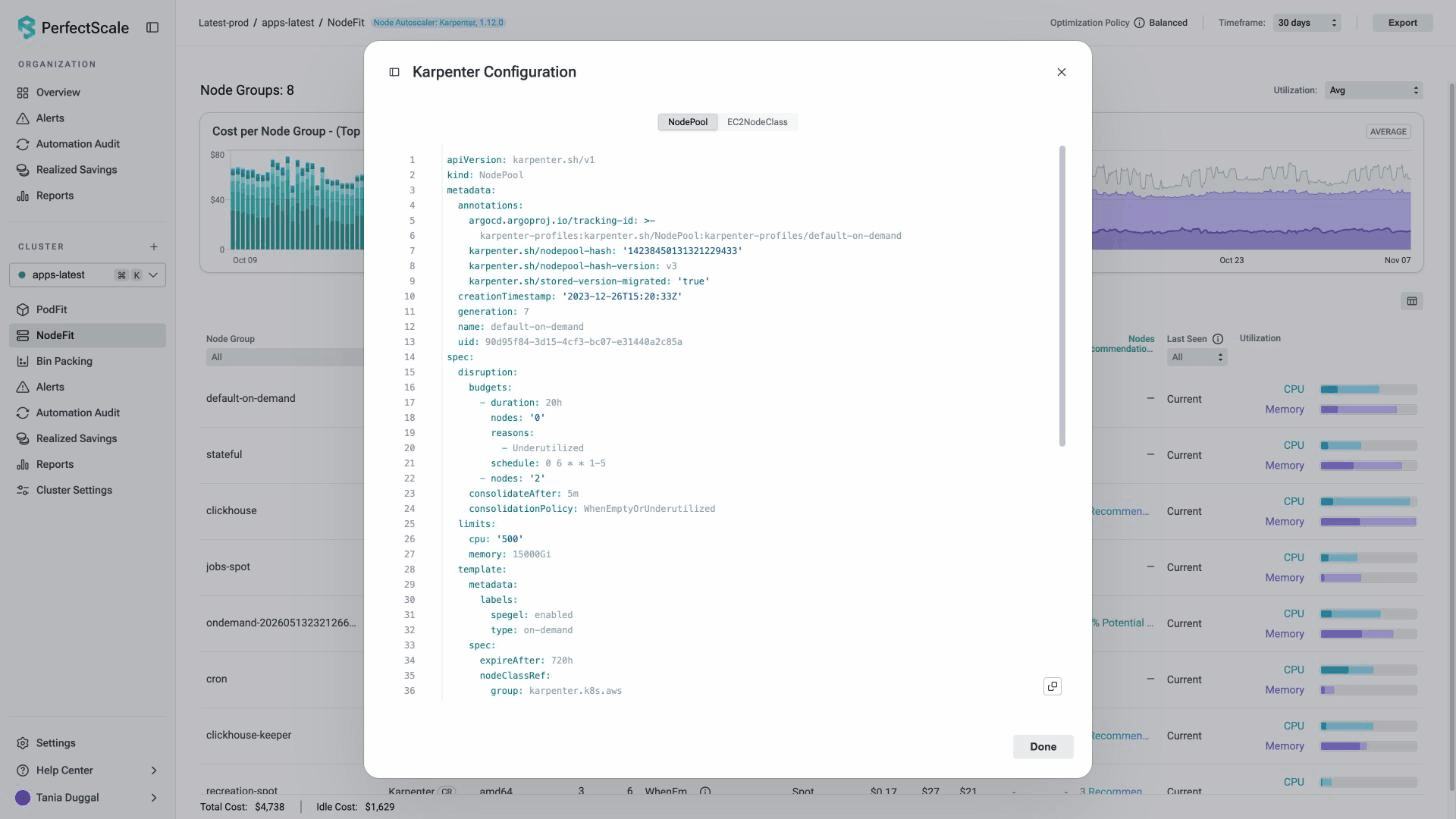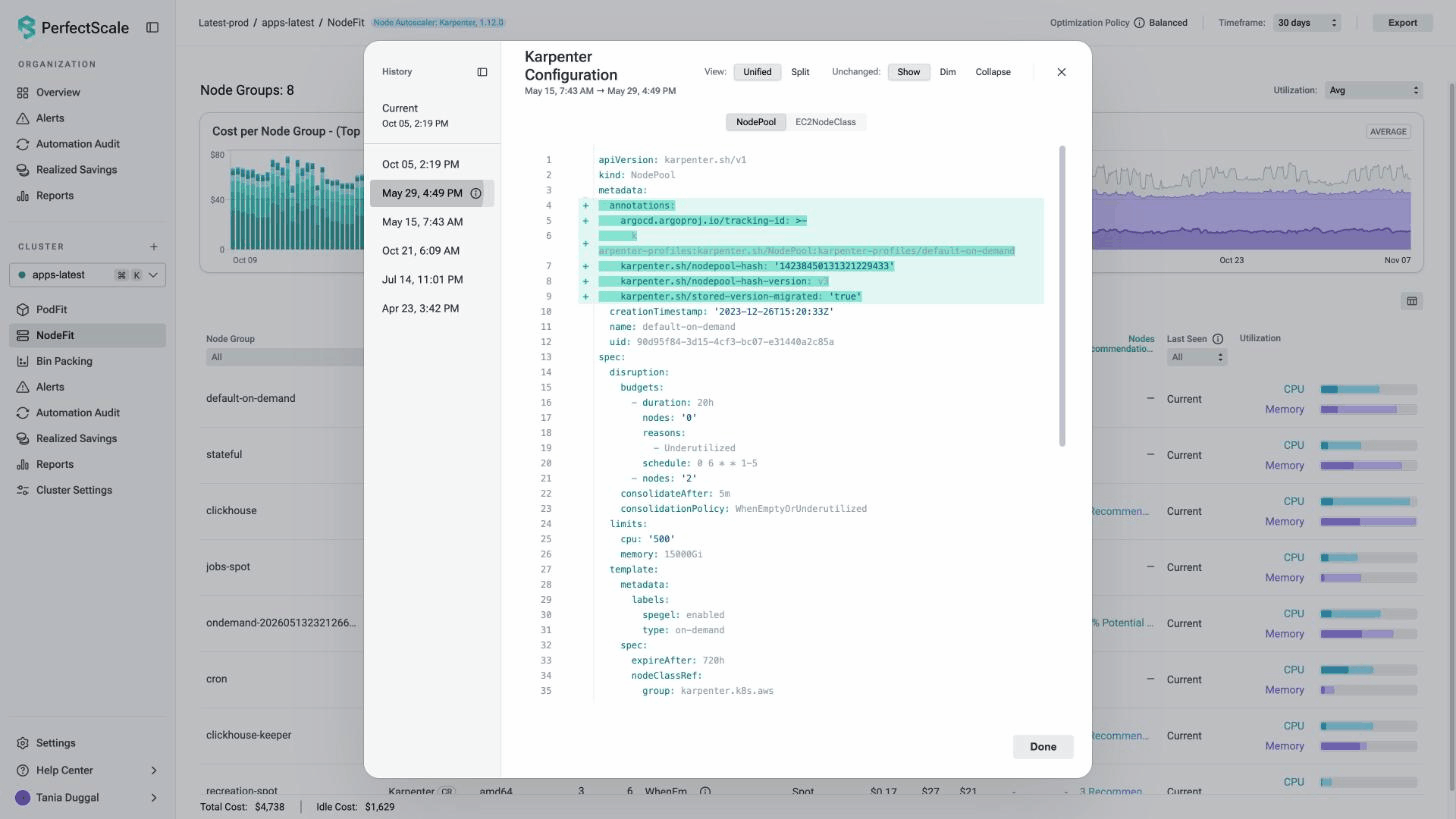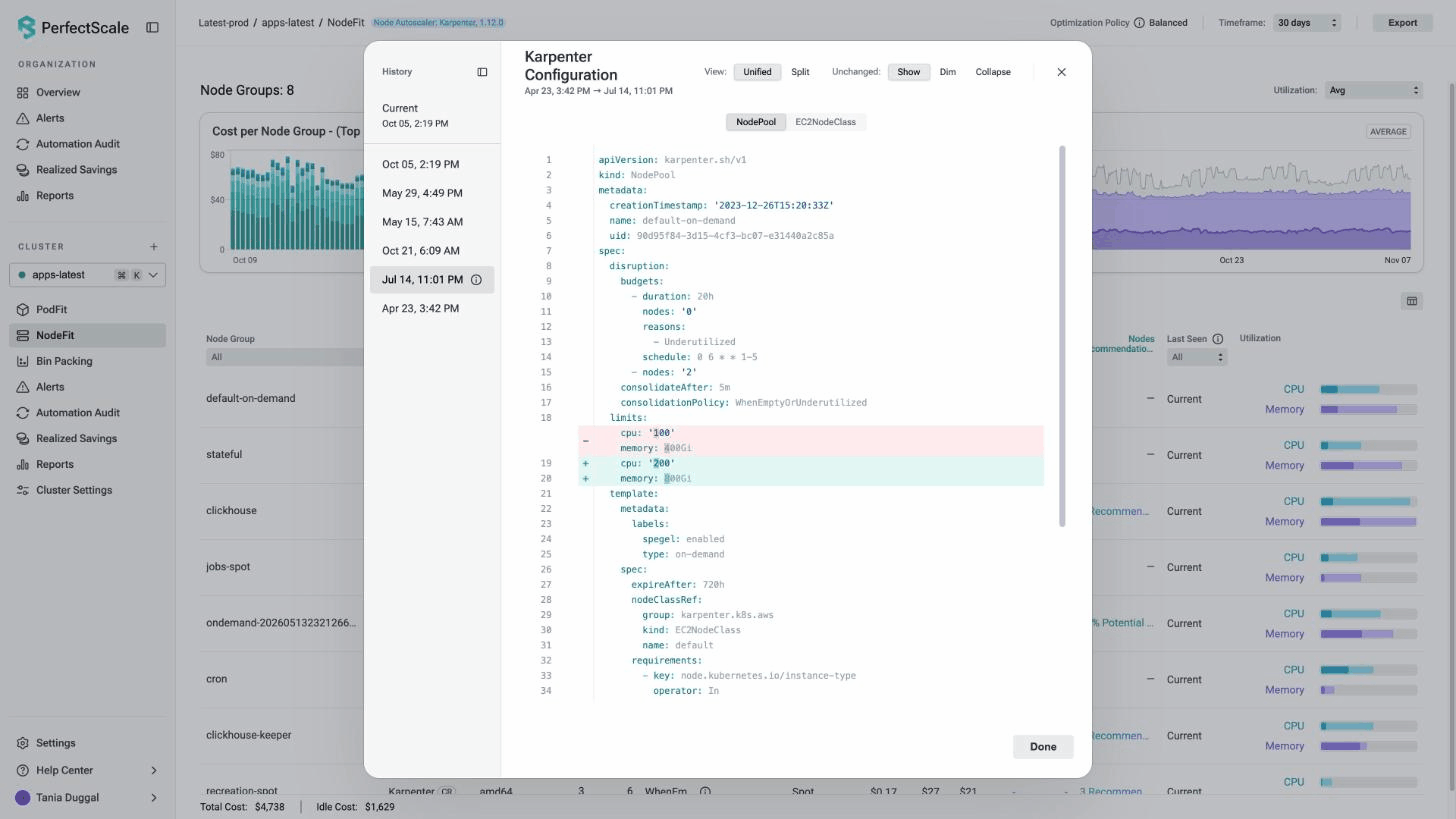
- Obtenir des recommandations pour les réglages du NodePool : la politique de consolidation, le temps d'attente et les choix d'instances déterminent la vitesse à laquelle Karpenter retire les nœuds. PerfectScale fournit des recommandations d'optimisation Karpenter pour ces réglages, ainsi que pour les limites de NodePool proches de l'épuisement. Ses recommandations vous aident à :
- Passer en revue la politique de consolidation et le temps d'attente.
- Donner à Karpenter plus d'options d'instances lorsqu'il provisionne de nouveaux nœuds.
- Repérer les limites de NodePool qui laissent trop peu de place à de nouvelles capacités.
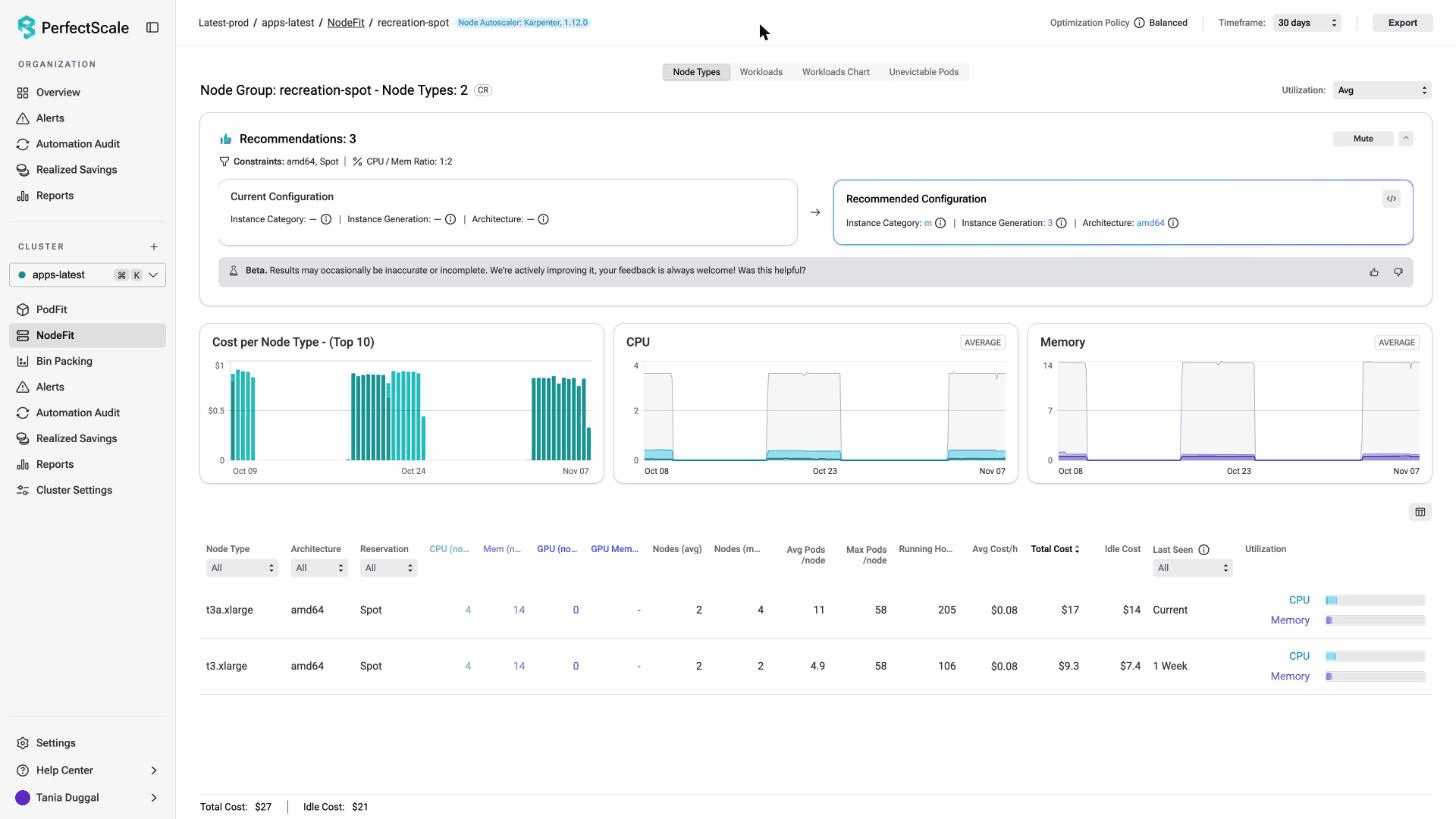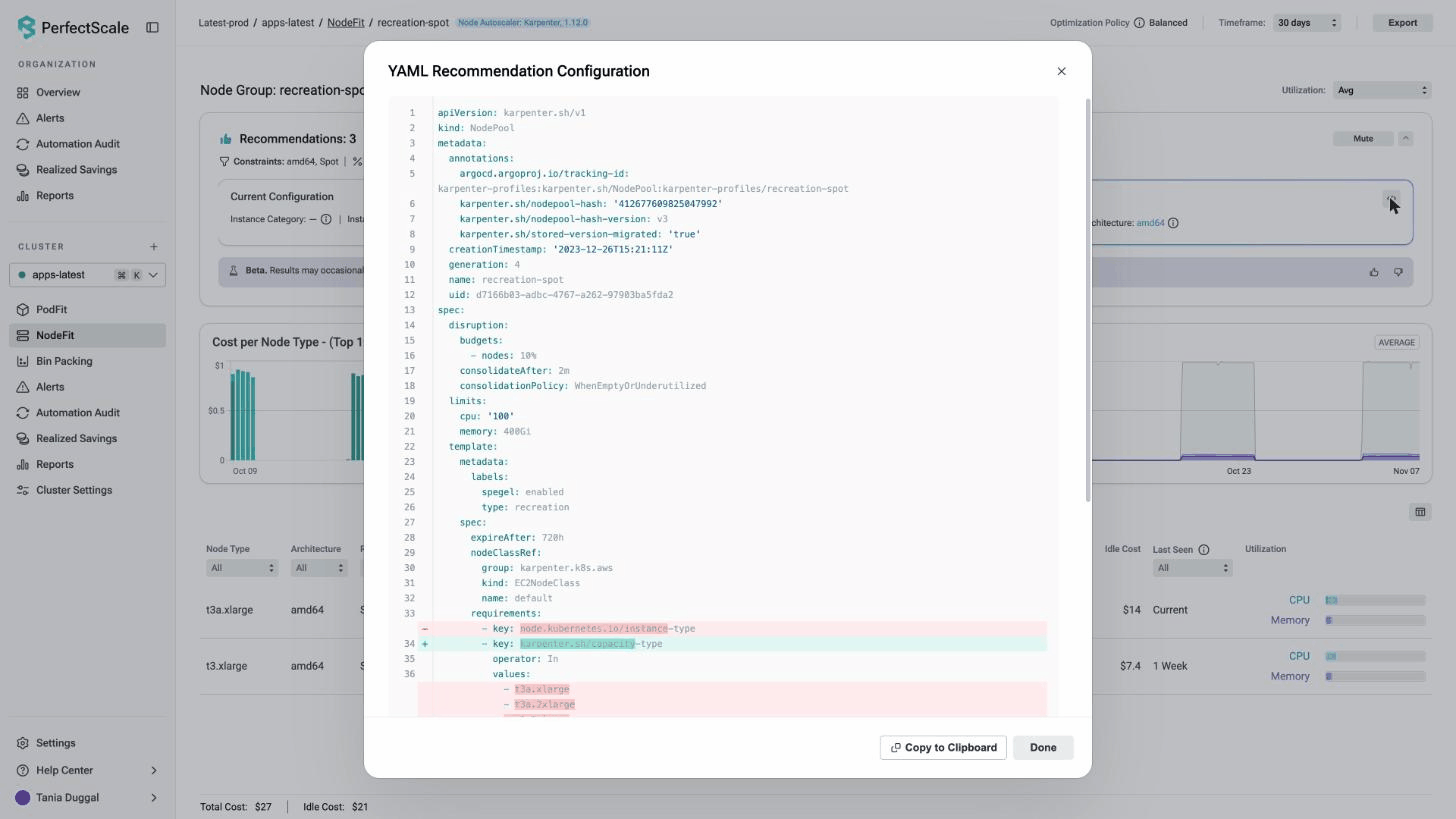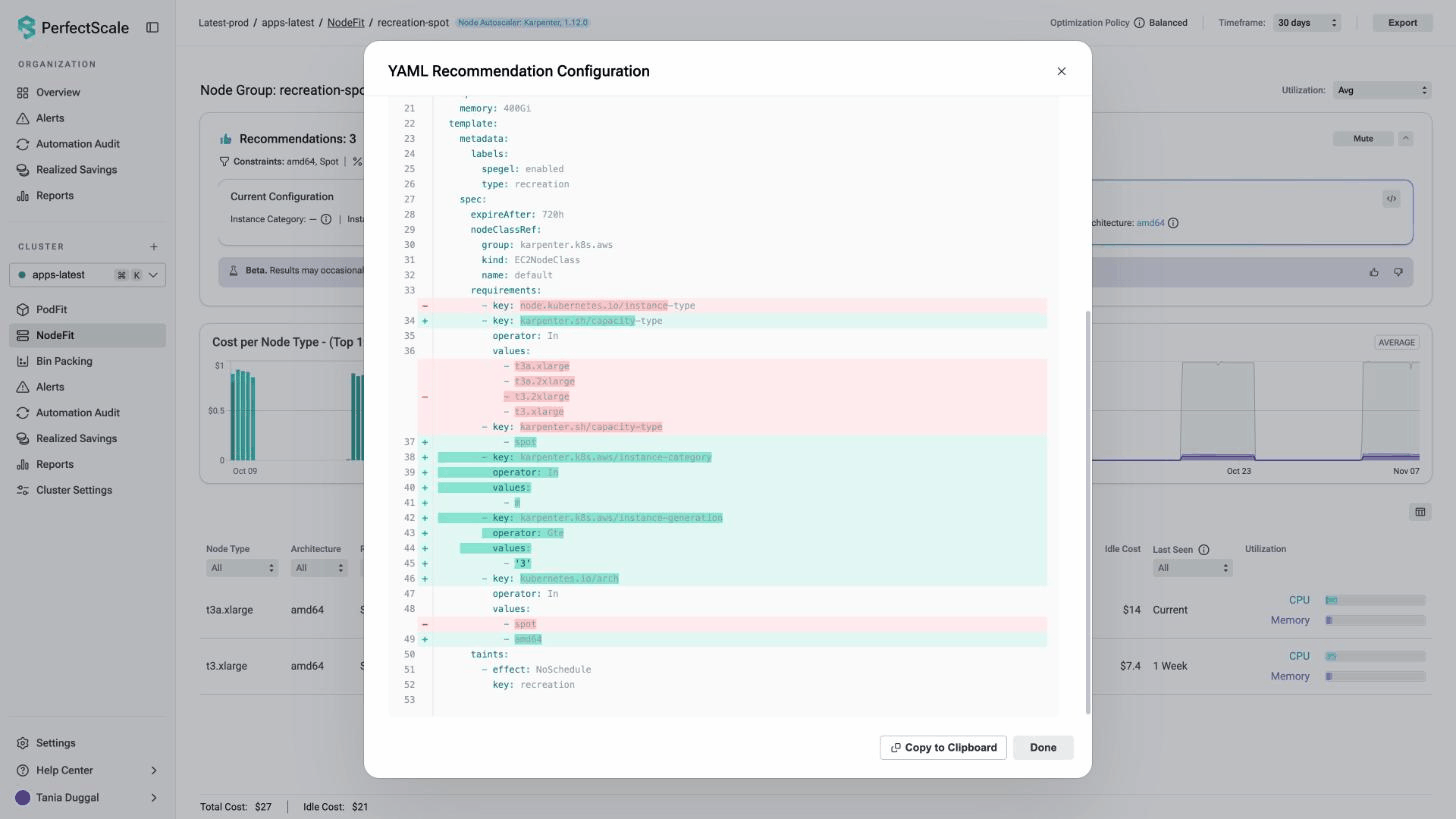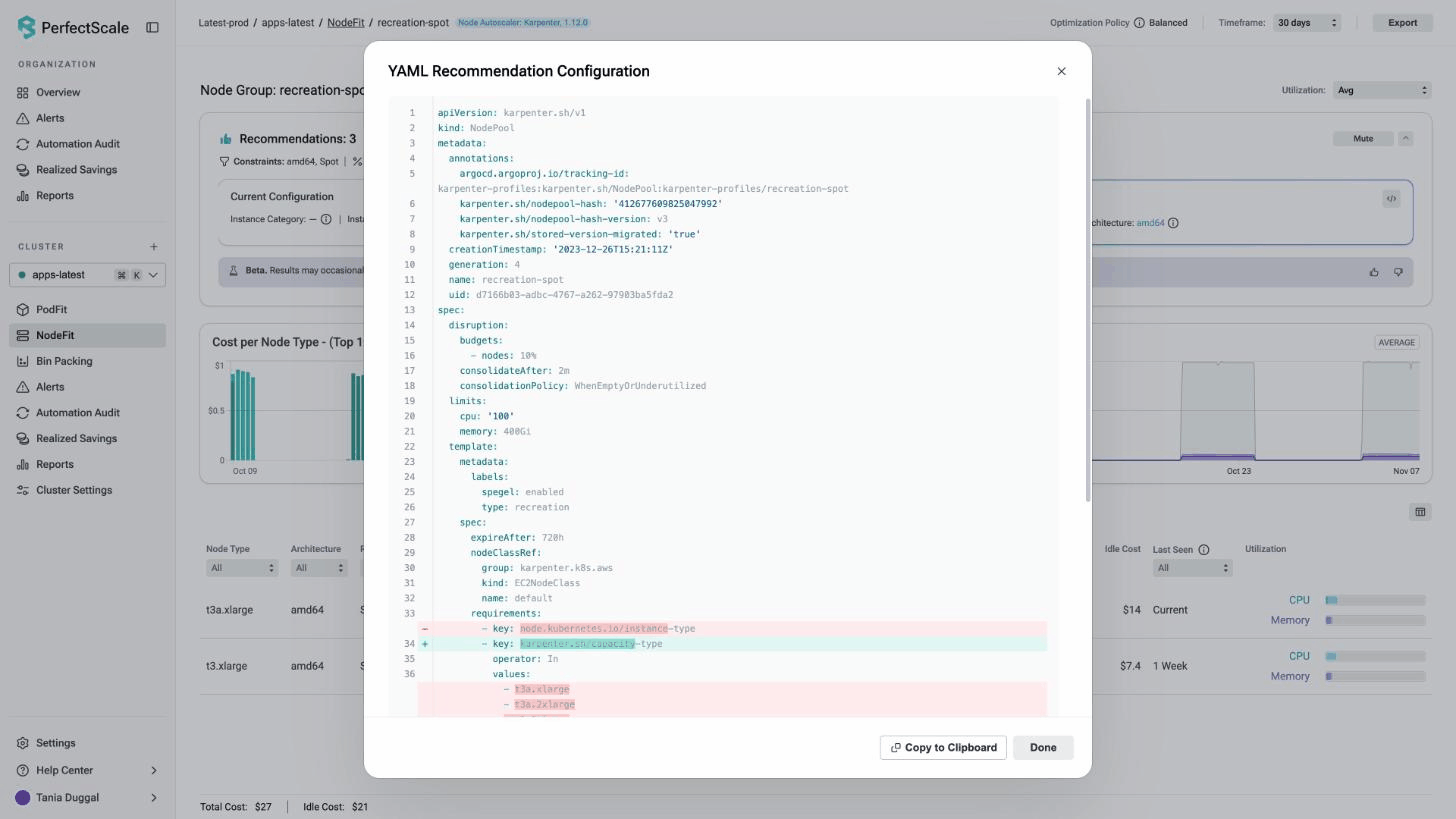
Une vue YAML montre la configuration actuelle et la configuration recommandée, et vous pouvez copier le résultat.
- Trouver les pods qui empêchent le retrait des nœuds : un seul pod non évincable peut maintenir un nœud entier en fonctionnement. La vue bin packing montre quels pods empêchent le retrait des nœuds. Elle fournit des recommandations sous forme de diff YAML classées par impact sur les coûts, chacune avec un niveau de confiance et un niveau de risque. Vous pouvez masquer un constat lorsqu'il correspond à un choix délibéré.
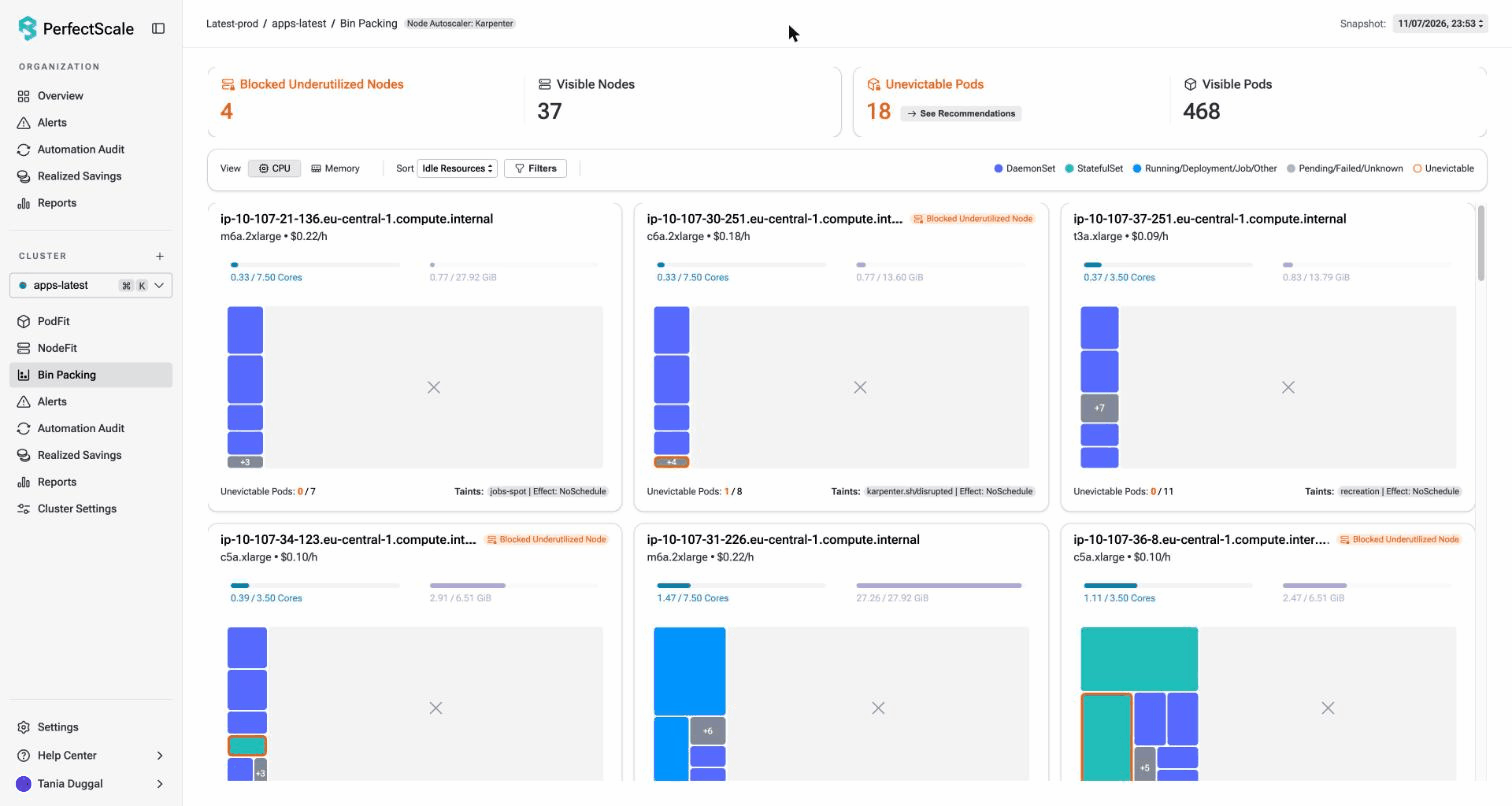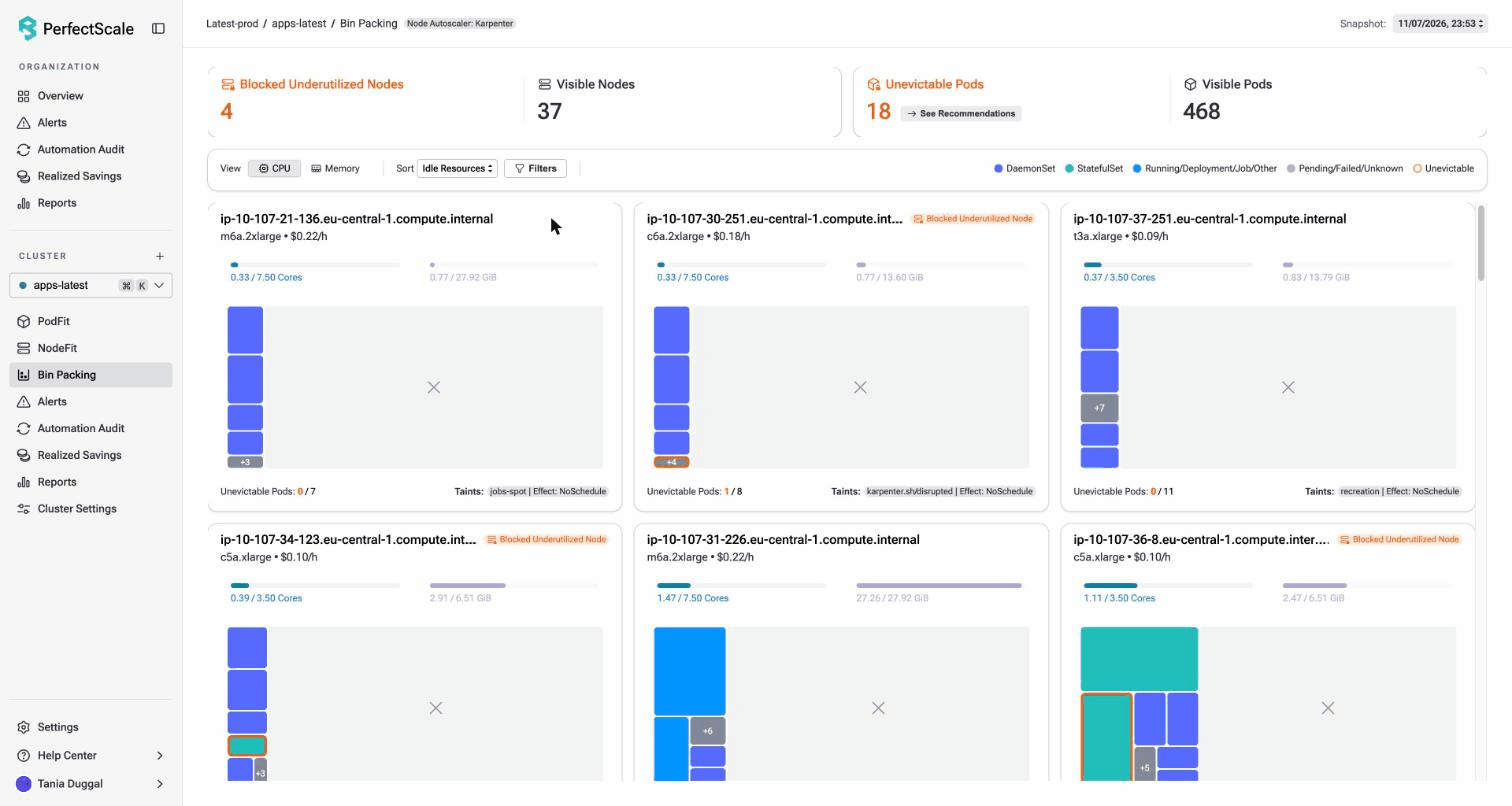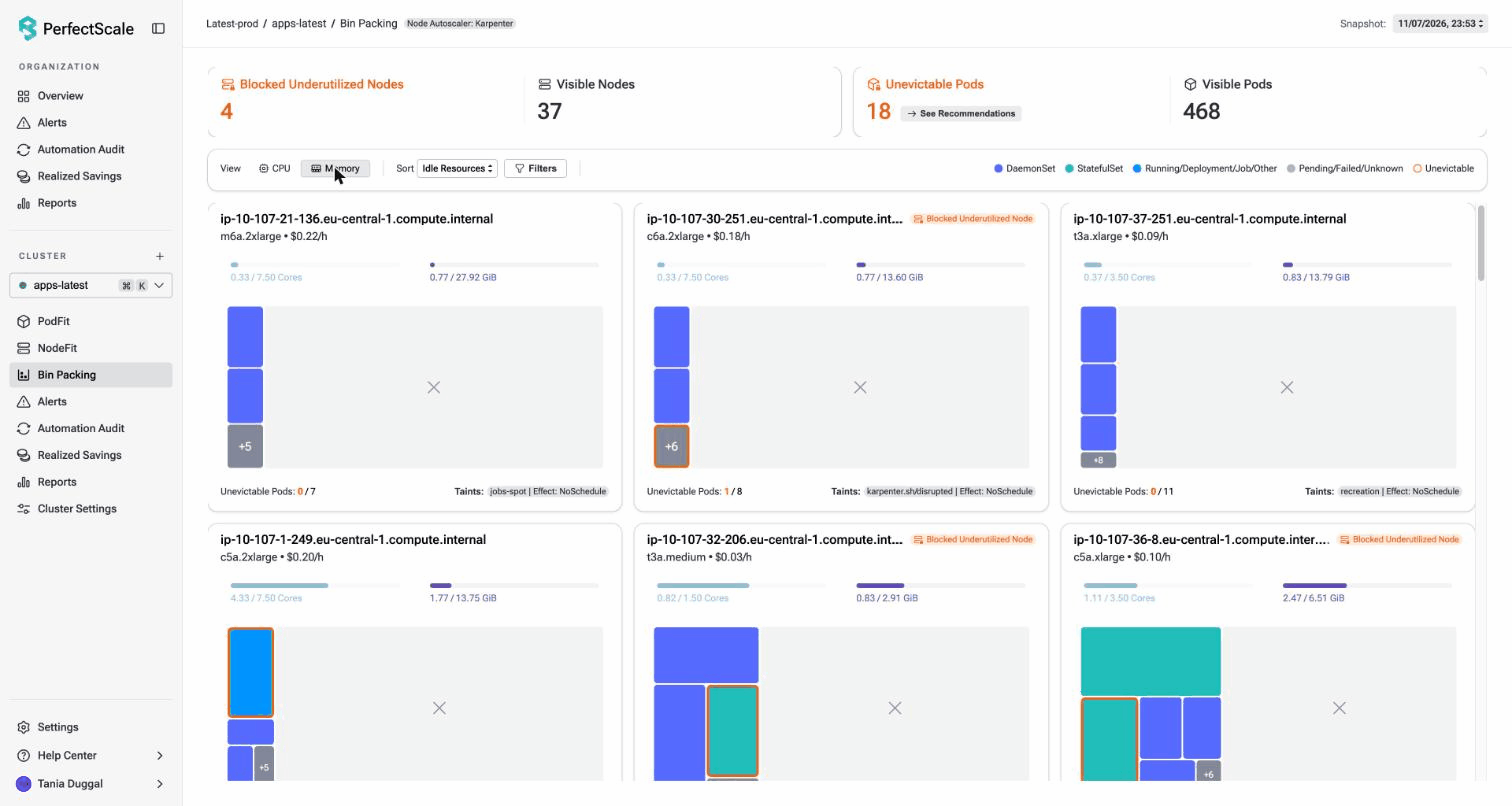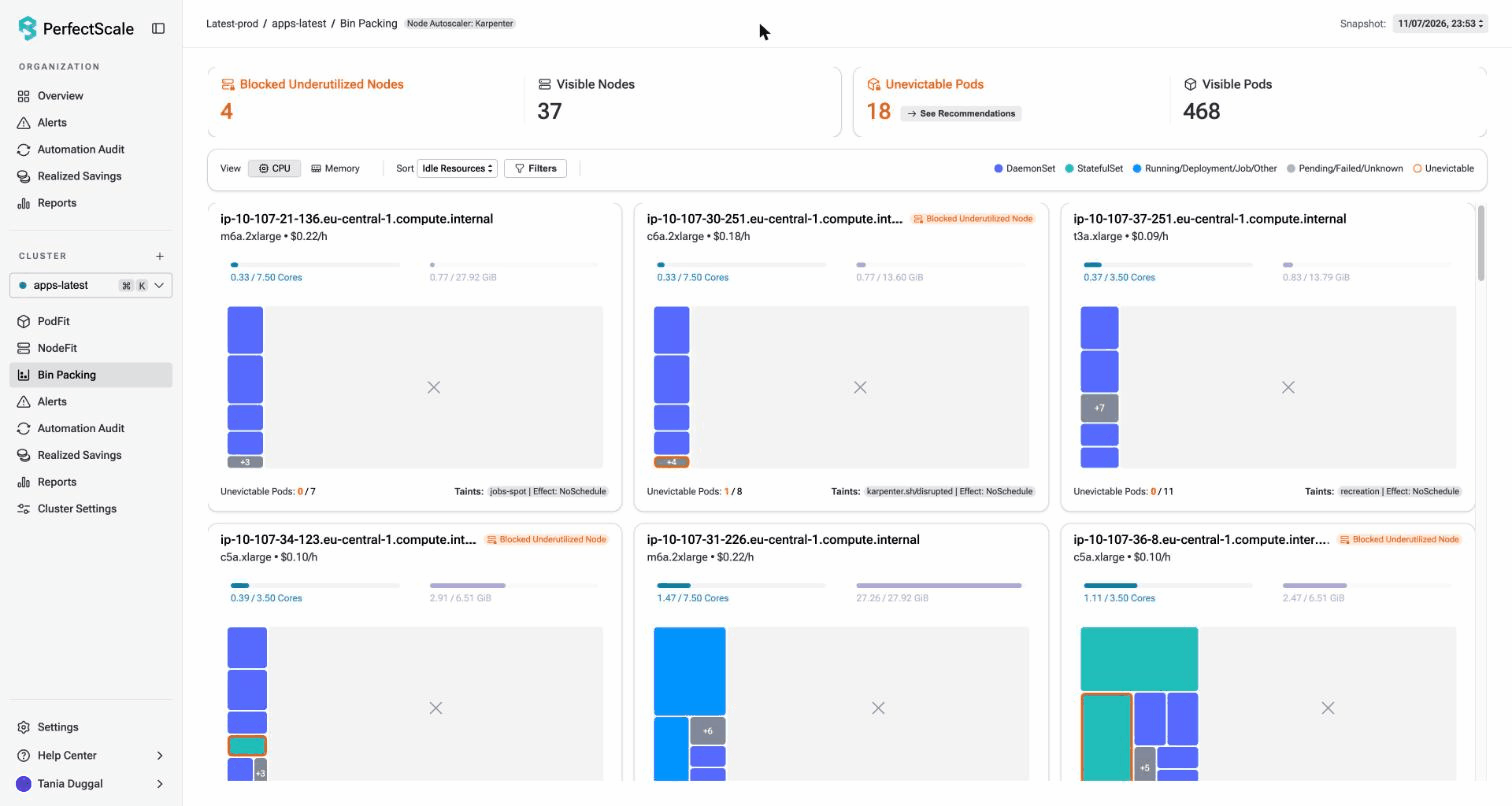
Un agent comme Claude peut aussi interroger les données PerfectScale grâce au skill d'agent IA PerfectScale. Après chaque changement, utilisez l'historique des modifications dans votre revue pour voir ce qui a changé et ce qu'il faut automatiser ensuite.
Voyez un agent dérouler ce chemin lors du workshop
La prochaine fois qu'un nœud reste en place, lisez l'event avant de toucher au moindre réglage. Un agent peut aider pour les premières étapes, car il lit les events, la configuration et les métriques bien plus vite que vous. Il peut aussi donner une réponse différente à chaque fois que vous l'interrogez. C'est pourquoi une personne relit chaque changement, et pourquoi des règles fixes, et non un agent, doivent l'appliquer en production.
Le workshop Agentic Karpenter: Using kagent + Claude to Tune Your Autoscaling aura lieu le 17 novembre 2026 à 11 h (heure de l'Est). Vikram Seshadri et Ramesh Mathikumar montrent comment un agent lit des events comme ceux-ci et rédige le diff, et où les règles fixes prennent le relais. Inscrivez-vous au workshop.
Des nœuds qui continuent de tourner ? Notre équipe peut vous aider à identifier le blocage, relire le changement et récupérer de la capacité sans compromettre la fiabilité. Échangez avec nos experts ou créez un compte gratuit et essayez par vous-même.