

Você reduz um Deployment de 12 pods para 3, e um nó grande fica praticamente vazio. No nosso sandbox, com um tempo de espera de um minuto, o Karpenter substitui esse nó por um menor em cerca de 80 segundos. Às vezes isso não acontece, e o nó grande continua rodando e custando dinheiro.
Se você se pergunta por que o Karpenter não consolida seus nós, comece pelos eventos. O Karpenter registra um evento quando pula um nó, e esse evento geralmente aponta a causa.
Um evento aponta uma causa, mas não entrega a correção. Um PodDisruptionBudget (PDB), uma anotação em um pod, um disruption budget e uma regra de posicionamento podem, cada um, manter um nó rodando, e cada um pertence a um time diferente. Quem lê o evento nem sempre é quem pode mudar a causa.
Em vez disso, siga um caminho fixo. Leia o evento, confirme com um comando, escreva a menor mudança possível como um diff e revise esse diff antes que alguém o aplique. Chamamos esse caminho de "do evento ao diff". Um diff mostra apenas as linhas que mudam.
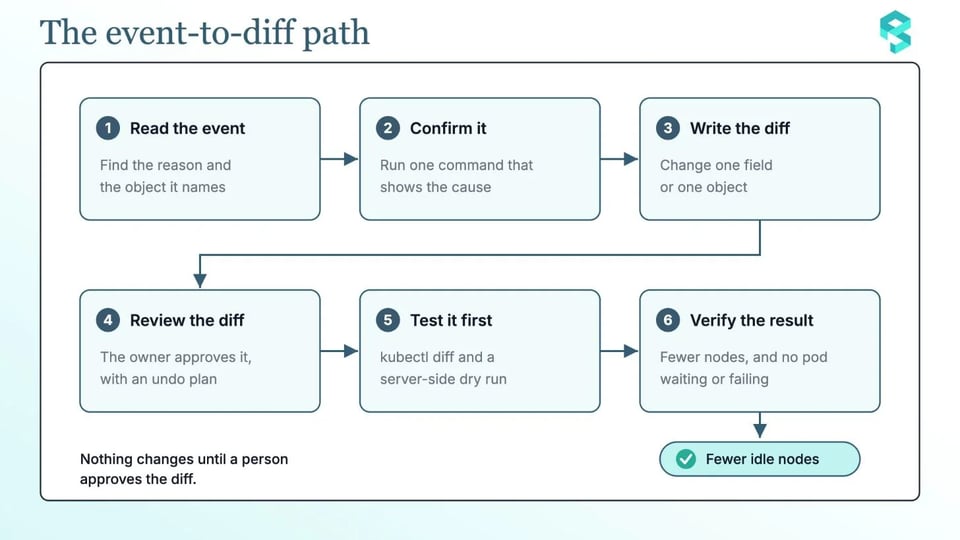
Este artigo percorre esse caminho com quatro casos que você pode encontrar nos seus próprios clusters:
- Um disruption budget que não permite nenhuma disrupção
- Uma anotação do-not-disrupt
- Um PDB sem folga
- Pods que não podem rodar em outro nó
Os exemplos usam o Karpenter v1.15 na AWS. Eles usam um sandbox pequeno: um NodePool chamado workshop e um Deployment chamado inflate no namespace sandbox.
O que o Karpenter faz por padrão
O Karpenter pode remover um nó de duas formas. Se todos os pods couberem na capacidade livre de outros nós, ele exclui o nó. Se couberem na capacidade livre mais um nó de preço menor, ele substitui o nó.
Um NodePool que não define nada além disso recebe consolidationPolicy: WhenEmptyOrUnderutilized e consolidateAfter: 0s. Ele também recebe um budget que permite ao Karpenter causar disrupção em 10% dos nós de cada vez.
Para toda disrupção voluntária, o Karpenter segue as mesmas seis etapas:
- Escolher os nós candidatos. O Karpenter ignora um nó que contém pods que não podem ser despejados e tenta esse nó de novo mais tarde.
- Verificar se a disrupção não viola o budget do NodePool.
- Simular o agendamento dos pods do nó, para descobrir se nós de substituição são necessários.
- Adicionar o taint
karpenter.sh/disrupted:NoSchedule, para que nenhum pod novo inicie no nó. - Iniciar os nós de substituição, se a simulação precisar deles, e esperar até que estejam prontos.
- Excluir o nó. O processo de terminação drena o nó com a Eviction API do Kubernetes, então respeita os PDBs. Ele ignora pods estáticos, pods que toleram o taint e pods que já foram concluídos com sucesso ou falharam.
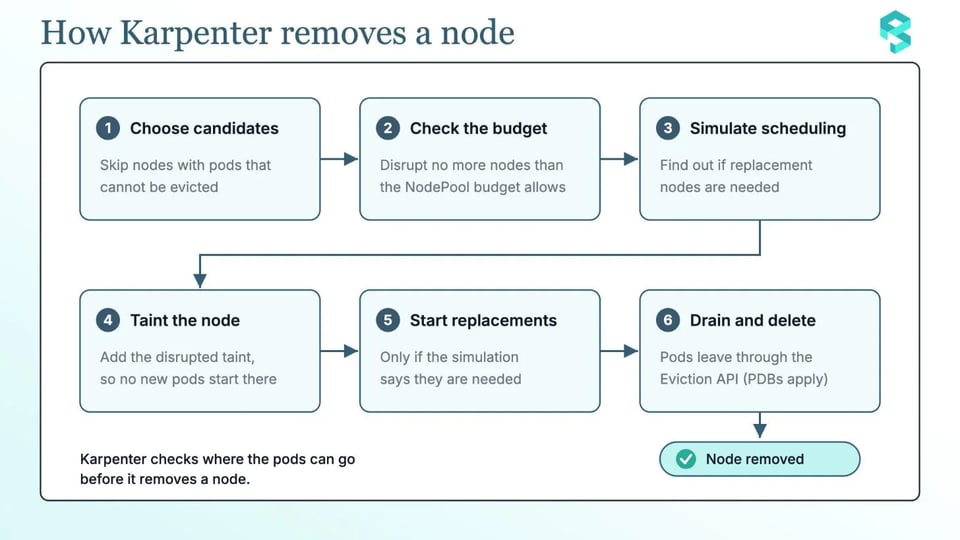
Um nó permanece quando o Karpenter para em uma dessas etapas, e os eventos dizem qual foi. Budgets e a anotação do-not-disrupt afetam apenas a disrupção voluntária. Expiração, interrupção e exclusão manual os ignoram.
Leia os eventos primeiro
O Karpenter registra um evento quando pula um nó, e o motivo diz que tipo de problema você tem. Unconsolidatable significa que a consolidação não é possível para aquele nó. DisruptionBlocked significa que algo bloqueia a disrupção: um PDB, uma anotação em um pod ou nó, ou um budget no NodePool.
Eventos de nó aparecem no nó e no seu NodeClaim. Eventos de budget aparecem no NodePool, não no nó. Estes comandos coletam os eventos de um nó, do seu NodeClaim, do seu NodePool e do cluster inteiro. Substitua $NODE, $NODECLAIM e $NODEPOOL pelos seus nomes:
kubectl describe node $NODEkubectl describe nodeclaim $NODECLAIMkubectl describe nodepool $NODEPOOLkubectl get events -A --field-selector reason=Unconsolidatable --sort-by=.lastTimestampkubectl get events -A --field-selector reason=DisruptionBlocked --sort-by=.lastTimestampNo Karpenter v1.15, as mensagens dos quatro casos são assim:
| Mensagem | O que significa | Confirme com |
|---|---|---|
No allowed disruptions for disruption reason Underutilized due to blocking budget |
Um budget não permite nenhuma disrupção agora. Esse evento fica no NodePool. | O bloco de disruption do NodePool |
Pod has "karpenter.sh/do-not-disrupt" annotation (Pod=<namespace>/<name>) |
Um pod no nó carrega a anotação. | As anotações dos pods no nó |
Pdb prevents pod evictions (PodDisruptionBudget=[<namespace>/<name>]) |
Um PDB não tem folga para um pod do nó. | O valor ALLOWED de cada PDB |
Can't replace with a cheaper node |
O Karpenter não encontrou um nó mais barato capaz de acomodar os pods. | Os requests dos pods, os requisitos do NodePool e os limites do NodePool |
Duas outras mensagens apontam para configurações do NodePool. NodePool "<name>" has consolidation disabled significa que consolidateAfter é Never. NodePool "<name>" has consolidation policy WhenEmpty, but node is not empty significa que a política considera apenas nós vazios. Em nós Spot, o Karpenter só substitui um nó quando o feature gate SpotToSpotConsolidation está ativado.
Agora você pode seguir o caminho com cada caso, um de cada vez:
Caso 1: um budget que não permite nenhuma disrupção
Aqui a evidência está no NodePool, não no nó. Ele tem um evento DisruptionBlocked que diz No allowed disruptions for disruption reason Underutilized due to blocking budget.
Para confirmar, leia o bloco de disruption do NodePool:
kubectl get nodepool $NODEPOOL -o jsonpath='{.spec.disruption}{"\n"}'Procure por nodes: '0', ou por um budget com schedule e duration ativos no momento. Um budget com nodes: '0' e sem reasons bloqueia toda disrupção voluntária. Quando um NodePool tem vários budgets, o Karpenter usa o menor resultado.
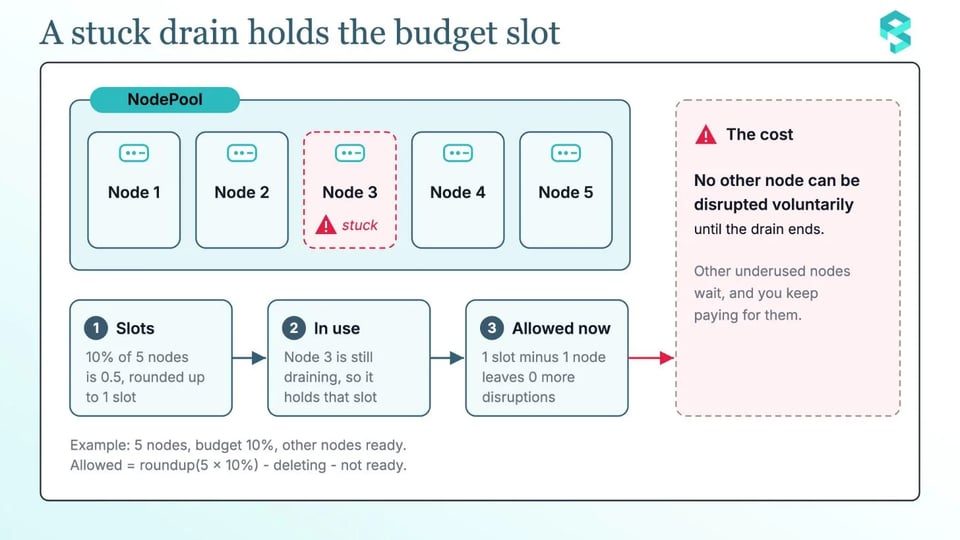
O Karpenter também conta nós que já estão sendo excluídos. Para uma porcentagem, ele calcula as disrupções permitidas assim:
| allowed = roundup(total x percentage) - deleting - not ready |
|---|
Com 5 nós e um budget de 10%, o resultado é 1. Agora imagine que um nó está travado em um drain. Esse nó ocupa a vaga, então o budget permite 0 disrupções adicionais até o drain terminar.
Um budget zero permanente bloqueia demais. Em vez disso, escolha uma janela que corresponda aos seus horários de pico. Este exemplo roda em dias úteis a partir das 09:00 UTC por 8 horas, e o primeiro budget mantém o limite normal no restante do tempo:
spec: disruption: budgets:- - nodes: '0'+ - nodes: 10%+ - nodes: '0'+ schedule: '0 9 * * mon-fri'+ duration: 8h+ reasons:+ - UnderutilizedO congelamento agora bloqueia apenas a remoção de nós subutilizados, e apenas dentro da janela. O Karpenter sempre lê um schedule em UTC.
Caso 2: uma anotação do-not-disrupt
A evidência está no nó e no seu NodeClaim. O evento DisruptionBlocked diz Pod has "karpenter.sh/do-not-disrupt" annotation (Pod=<namespace>/<name>). Quando o próprio nó carrega a anotação, a mensagem é Disruption is blocked through the "karpenter.sh/do-not-disrupt" annotation.
Para encontrar a anotação, liste os pods e os nós que a carregam. Estes comandos usam jq:
kubectl get pods -A -o json | jq -r '.items[] | select(.metadata.annotations["karpenter.sh/do-not-disrupt"] != null) | "\(.metadata.namespace)/\(.metadata.name) node=\(.spec.nodeName) value=\(.metadata.annotations["karpenter.sh/do-not-disrupt"])"'
kubectl get nodes -o json | jq -r '.items[] | select(.metadata.annotations["karpenter.sh/do-not-disrupt"] != null) | .metadata.name'
O valor "true" protege um pod para sempre. Uma duração como "30m" o protege por esse tempo depois que ele começa a rodar. A anotação funciona como um PDB para um único pod: bloqueia a consolidação e bloqueia o drift, a menos que o NodePool defina terminationGracePeriod.
Uma duração é mais fácil de defender em uma revisão do que um valor permanente, porque diz por quanto tempo o pod realmente precisa de proteção. Se o time da aplicação concorda que o pod pode se mover depois de 30 minutos, mude o valor de "true" para uma duração:
template: metadata: annotations:- karpenter.sh/do-not-disrupt: "true"+ karpenter.sh/do-not-disrupt: "30m"Caso 3: um PDB sem folga
A evidência está no nó e no seu NodeClaim. O evento DisruptionBlocked diz Pdb prevents pod evictions (PodDisruptionBudget=[<namespace>/<name>]).
Para confirmar, liste todos os PDBs com suas disrupções permitidas:
kubectl get pdb -A -o custom-columns='NAMESPACE:.metadata.namespace,NAME:.metadata.name,MIN:.spec.minAvailable,MAXUNAVAIL:.spec.maxUnavailable,ALLOWED:.status.disruptionsAllowed'Um valor ALLOWED igual a 0 significa que nenhum pod protegido por esse PDB pode sair agora. Se você definir maxUnavailable como 0, ou minAvailable como 100% ou como o número de réplicas, você exige zero despejos voluntários, e um drain do nó nunca termina.
O Karpenter precisa que o PDB que seleciona um pod permita o despejo. Um pod deve ter apenas um PDB. Se dois PDBs selecionam o mesmo pod, o Kubernetes se recusa a despejá-lo, mesmo quando os dois PDBs têm folga. O Karpenter pode não mostrar nenhum evento nesse caso. Versões recentes do Kubernetes registram um evento MultiplePodDisruptionBudgets no pod. Esse único pod pode então bloquear o nó inteiro. Um pod que roda mas não está pronto também pode bloquear um despejo quando o budget não tem folga.
A correção é uma mudança pequena. Para um Deployment com 3 réplicas, use maxUnavailable: 1 em vez de minAvailable: 3:
spec: minAvailable: 3 maxUnavailable: 1Um PDB pode definir apenas um dos dois campos. O Kubernetes recomenda maxUnavailable, porque ele acompanha o número de réplicas.
Se um pod em crash loop bloqueia o despejo, adicione unhealthyPodEvictionPolicy: AlwaysAllow. Esse campo é estável desde o Kubernetes v1.31:
spec: maxUnavailable: 1 unhealthyPodEvictionPolicy: AlwaysAllowCaso 4: pods que não podem rodar em outro nó
O Karpenter simula para onde os pods podem ir antes de remover um nó. Se um pod não couber em nenhum outro lugar, o nó permanece. Os eventos nem sempre nomeiam esse pod, então você o encontra nas specs dos pods.
Para ver o que prende cada pod do nó ao seu lugar, liste os detalhes de todos os pods nele:
kubectl get pods -A --field-selector spec.nodeName=$NODE -o json | jq '.items[] | {pod: "\(.metadata.namespace)/\(.metadata.name)", owner: (.metadata.ownerReferences[0].kind // "none"), nodeSelector: .spec.nodeSelector, requiredAntiAffinity: (.spec.affinity.podAntiAffinity.requiredDuringSchedulingIgnoredDuringExecution != null), topologySpread: [.spec.topologySpreadConstraints[]? | {key: .topologyKey, maxSkew: .maxSkew, whenUnsatisfiable: .whenUnsatisfiable}], claims: [.spec.volumes[]? | select(.persistentVolumeClaim != null) | .persistentVolumeClaim.claimName]}'Procure por estas causas:
- Um request maior que a capacidade livre dos outros nós.
- Um
nodeSelectorque corresponde apenas a esse grupo de nós. - Uma regra de anti-afinidade obrigatória.
- Uma regra de topology spread que os outros nós não conseguem atender.
- Um volume vinculado a uma única zona.
- Um taint nos outros nós que o pod não tolera.
Vale saber também que regras preferenciais de anti-afinidade e de topology spread podem reduzir a eficácia da consolidação, porque o Karpenter tenta satisfazê-las ao remover um nó. Verifique também se há pods sem controller. Eles não bloqueiam o Karpenter, mas nada os inicia de novo após um despejo.
Comece pela primeira causa. O Karpenter posiciona os pods pelos seus requests, não pelo uso real. Compare o uso real com os requests:
sum by (namespace) (rate(container_cpu_usage_seconds_total{container!=""}[5m]))/sum by (namespace) (kube_pod_container_resource_requests{resource="cpu"})Uma proporção bem abaixo de 1 significa que os requests estão grandes demais. Cada nó passa a acomodar menos pods do que poderia, e você paga pelo espaço vazio.
Se a evidência mostra um request superdimensionado, reduza-o ao que é realmente necessário. Mude apenas o valor apontado pela evidência:
resources: requests:- cpu: "4"+ cpu: "2"Da evidência ao diff: revise antes que alguém aplique
Cada caso termina em um diff pequeno. Revise cada diff da mesma forma:
| Caso | O evento | Confirme com | O diff muda | Responsável |
|---|---|---|---|---|
| Budget | DisruptionBlocked no NodePool |
kubectl get nodepool com jsonpath |
Uma entrada de budget | Time de plataforma |
| Anotação | DisruptionBlocked no nó |
Um filtro jq para pods e nós |
Um valor de anotação | Time da aplicação |
| PDB | DisruptionBlocked no nó |
kubectl get pdb -A |
Um campo do PDB | Time da aplicação |
| Nenhum outro nó | Unconsolidatable, ou nenhum evento |
Um filtro jq para o posicionamento dos pods |
Um request ou uma regra | Time da aplicação |
Faça estas seis perguntas antes de aplicar um diff:
- Qual evento, campo ou anotação comprova o bloqueio?
- O diff toca em um único campo ou um único objeto?
- O responsável por esse objeto aprovou?
- O que limita quantos nós podem se mover de uma vez: um budget ou uma janela de tempo?
- Como você desfaz a mudança, e o que indica que é hora de desfazer?
- A mudança rodou primeiro em um cluster de teste ou em um NodePool de sandbox?
Depois, teste o diff sem aplicá-lo:
kubectl diff -f workshop-nodepool.yamlkubectl apply --dry-run=server -f workshop-nodepool.yamlO comando kubectl diff mostra o que o kubectl apply mudaria. O dry run do lado do servidor valida a mudança contra a API real e não salva nada. O comando diff sai com código 1 quando encontra uma diferença, então um script interpreta isso como falha.
Depois de aplicar o diff, verifique o resultado:
kubectl get nodeclaims -wkubectl get pods -A --field-selector=status.phase!=Running,status.phase!=SucceededO número de nós deve cair, e nenhum pod deve ficar esperando ou falhar por causa da movimentação. O valor ALLOWED de cada PDB deve voltar a ficar acima de 0 para os serviços que precisam se mover.
Como o PerfectScale pode ajudar
O PerfectScale by DoiT não substitui esse processo. Ele ajuda seu time a percorrer o mesmo caminho com menos trabalho manual. A ordem importa. Requests no tamanho certo dão mais margem de ganho para a consolidação, então o PerfectScale recomenda fazer o right-sizing dos workloads primeiro. Depois você pode ajustar o NodePool.
Veja como o PerfectScale pode ajudar você:
- Veja a configuração e cada mudança nela: As configurações do Karpenter mudam com o tempo, então ajuda ver o que mudou e quando. O PerfectScale detecta o Karpenter no cluster e mostra a configuração do NodePool e da node class, com um histórico de mudanças.
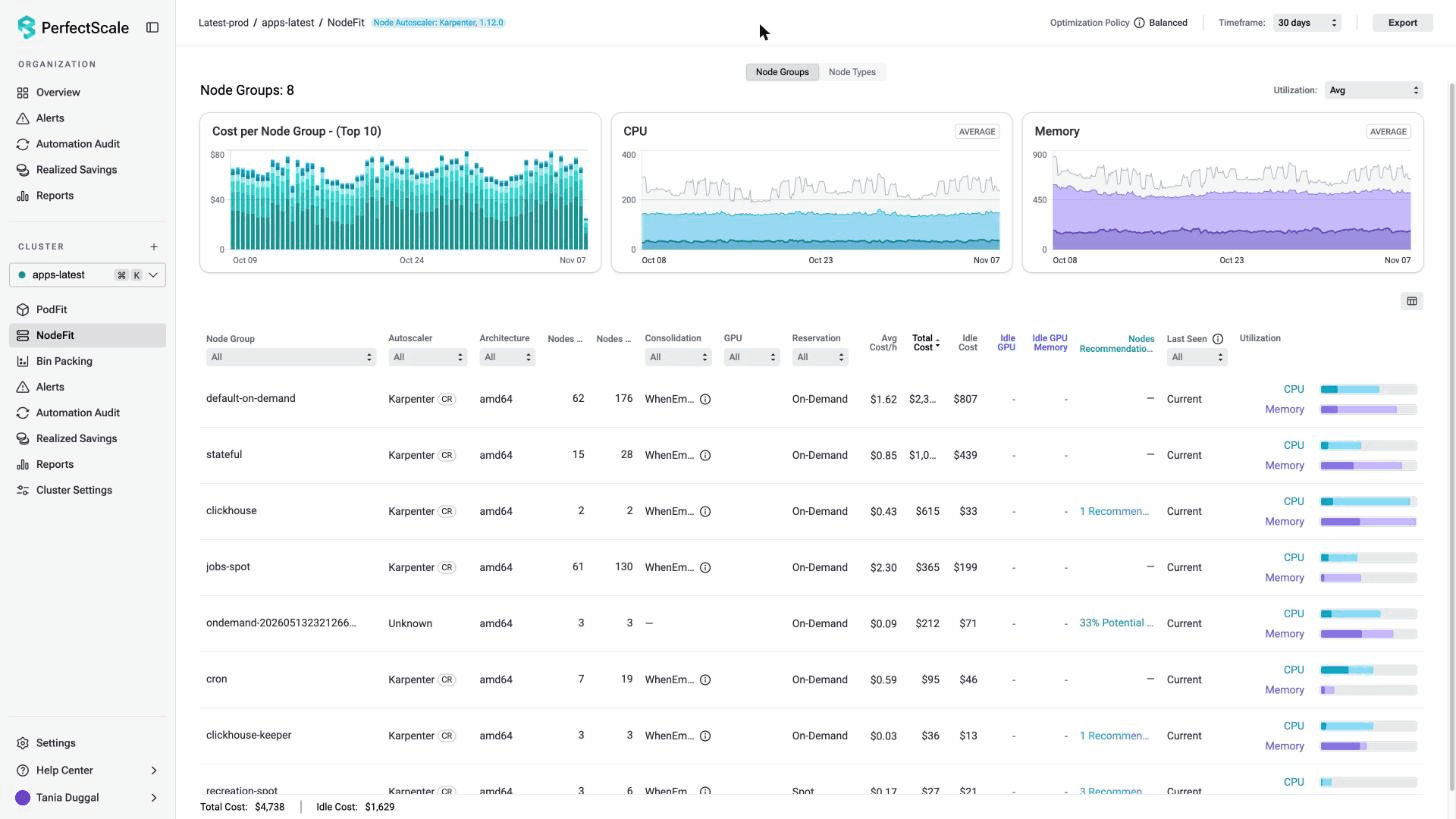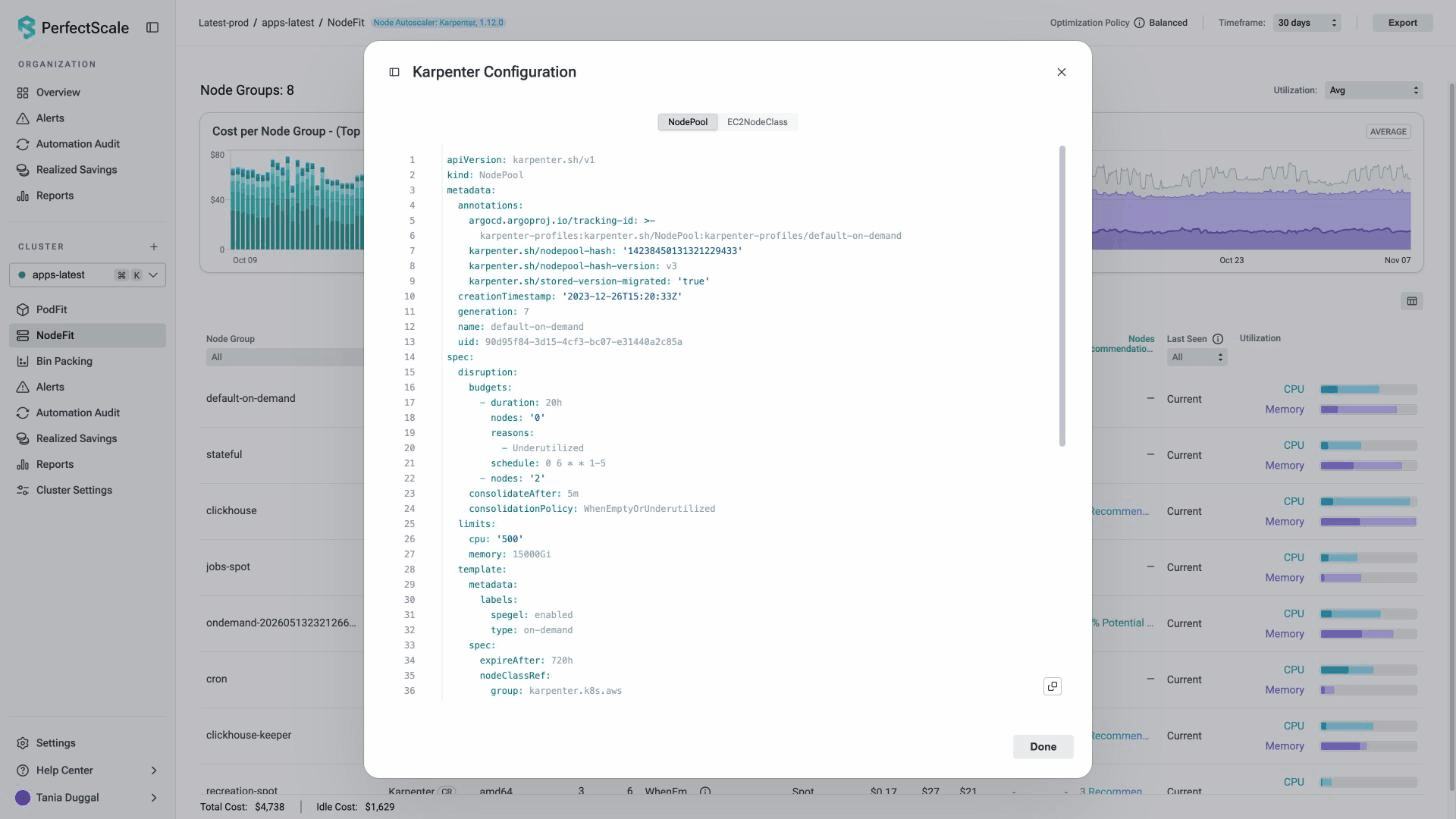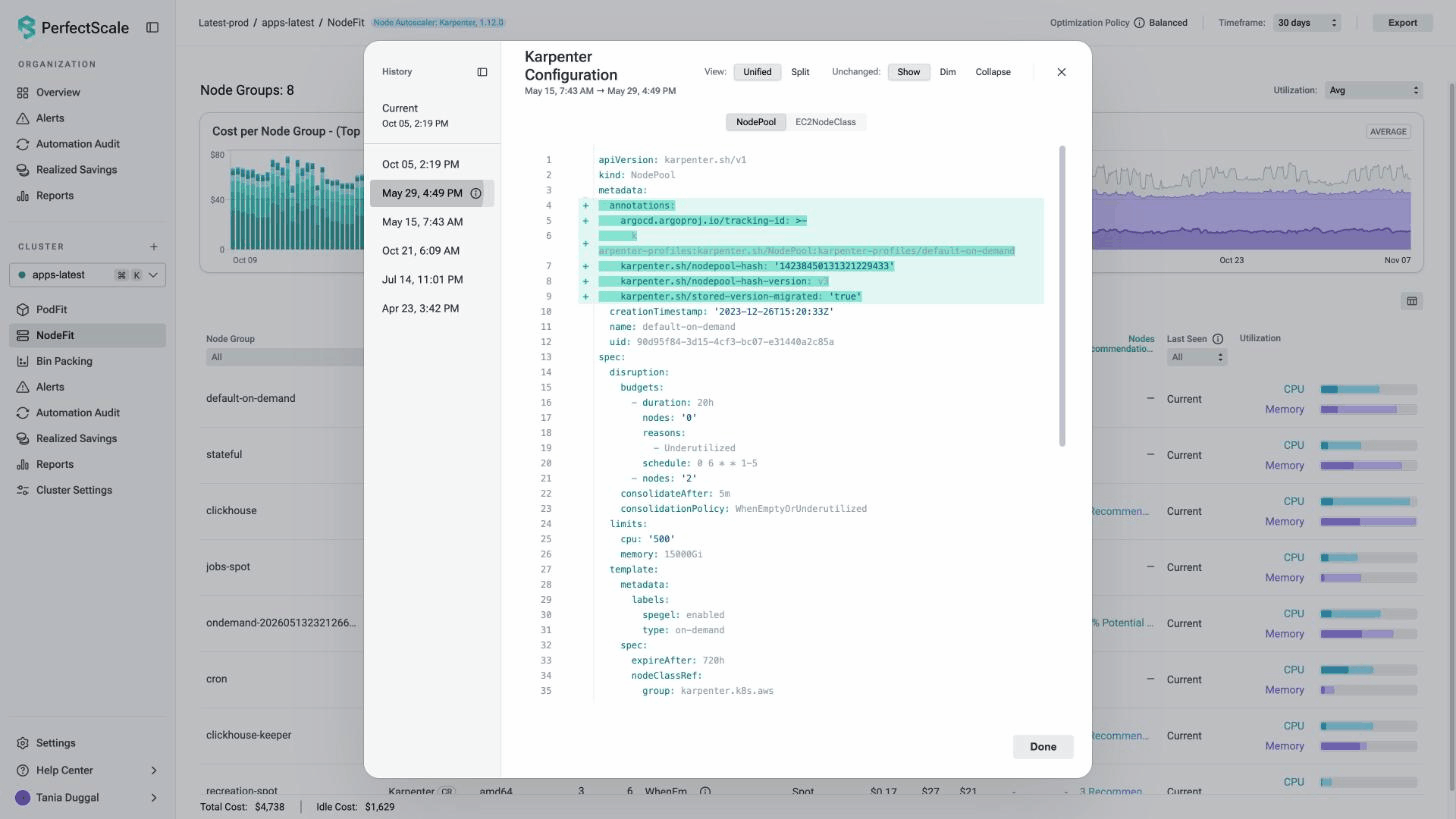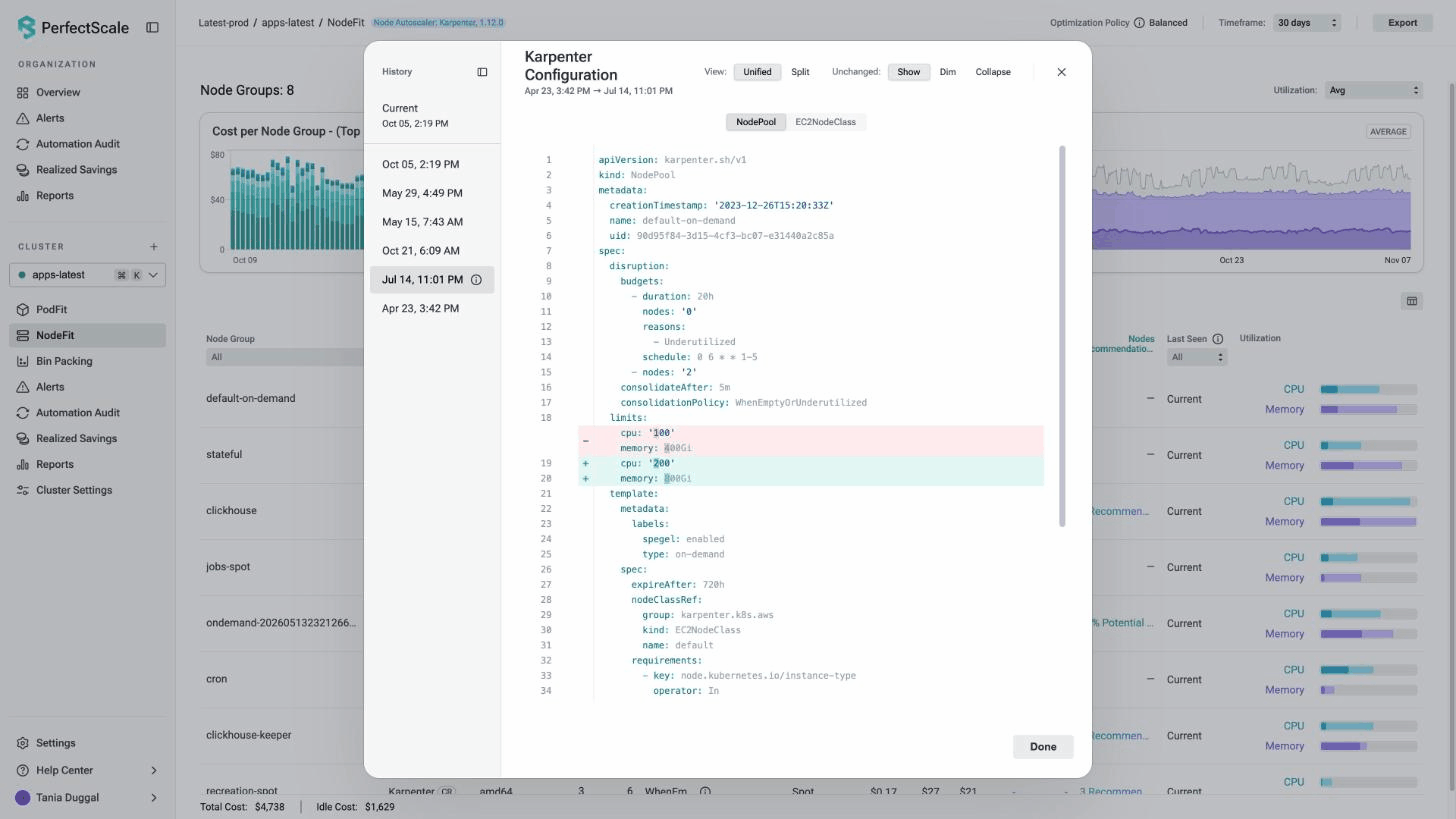
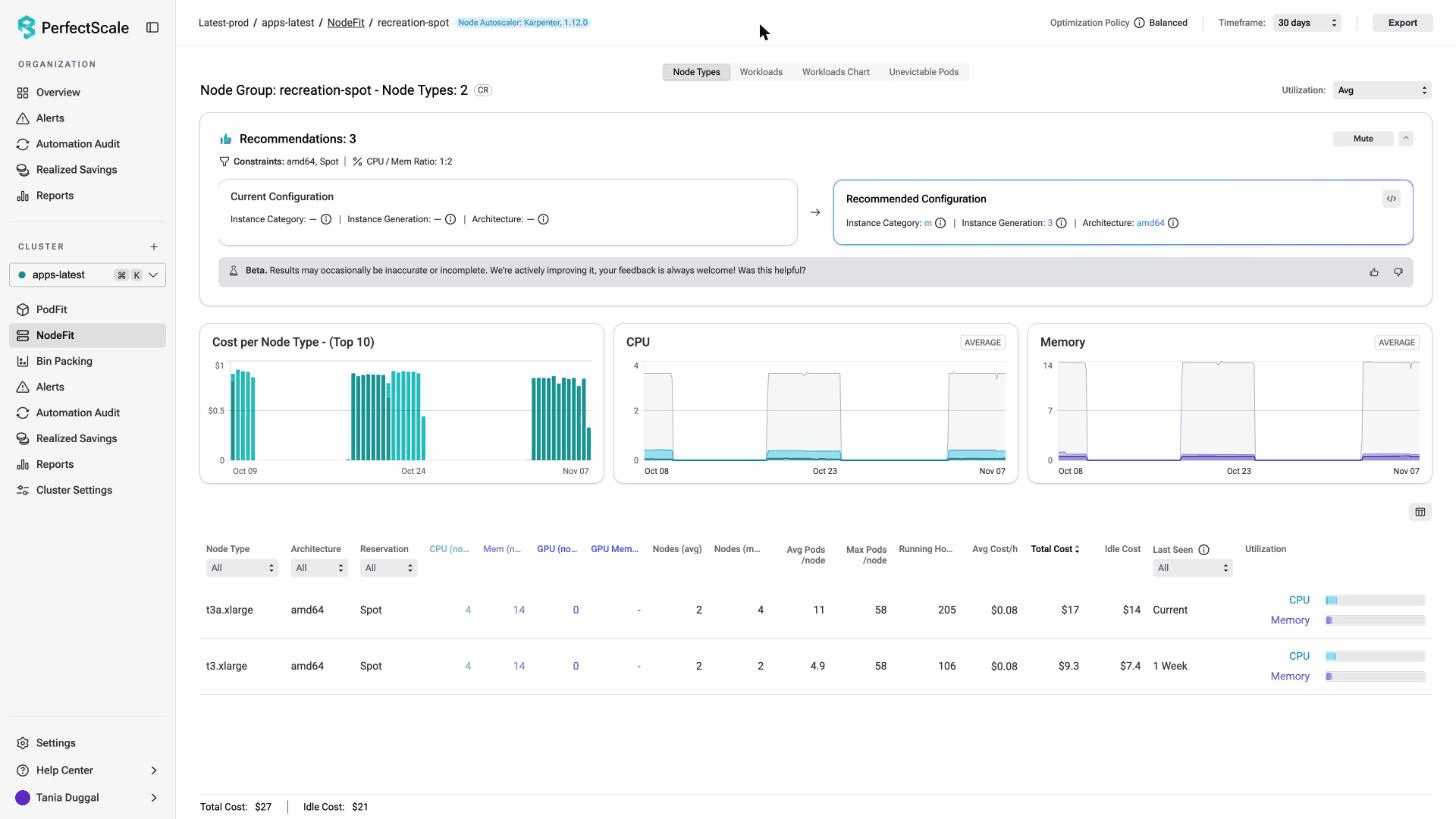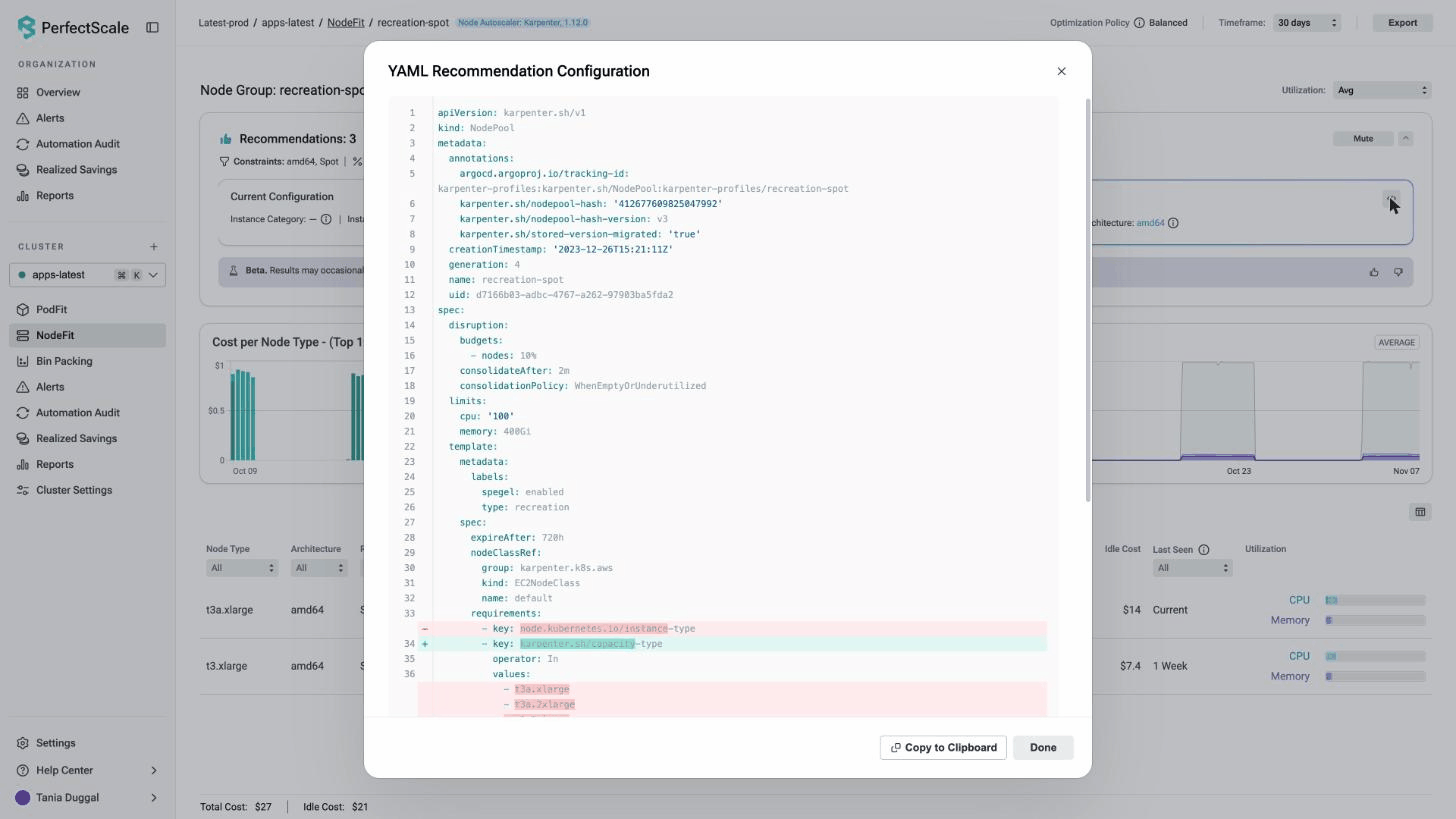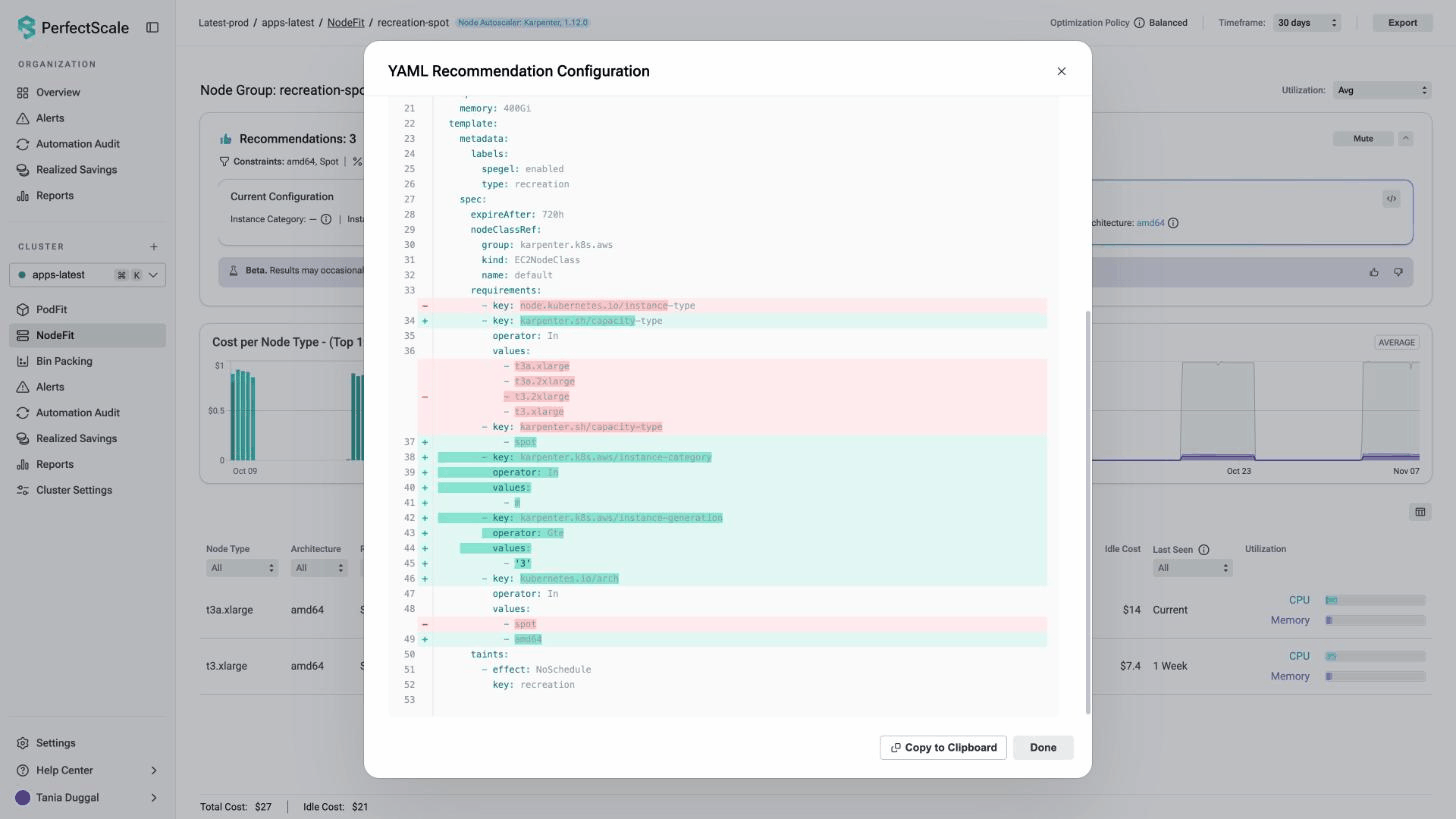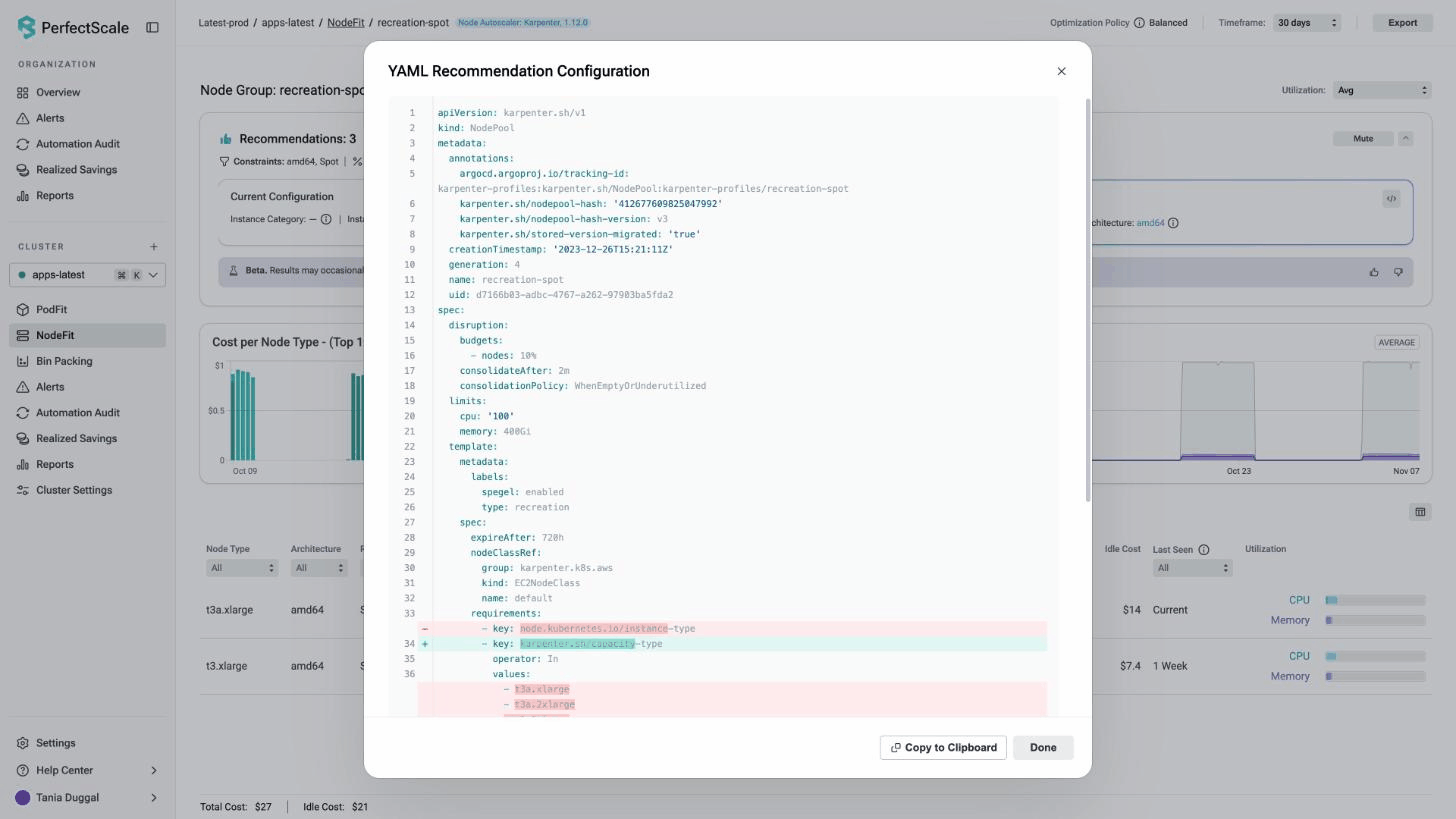
- Receba recomendações para as configurações do NodePool: A política de consolidação, o tempo de espera e as opções de instância determinam a rapidez com que o Karpenter remove nós. O PerfectScale oferece recomendações de otimização do Karpenter para essas configurações e para limites de NodePool próximos do esgotamento. As recomendações ajudam você a:
- Revisar a política de consolidação e o tempo de espera.
- Dar ao Karpenter mais opções de instância ao provisionar novos nós.
- Encontrar limites de NodePool que deixam pouco espaço para nova capacidade.
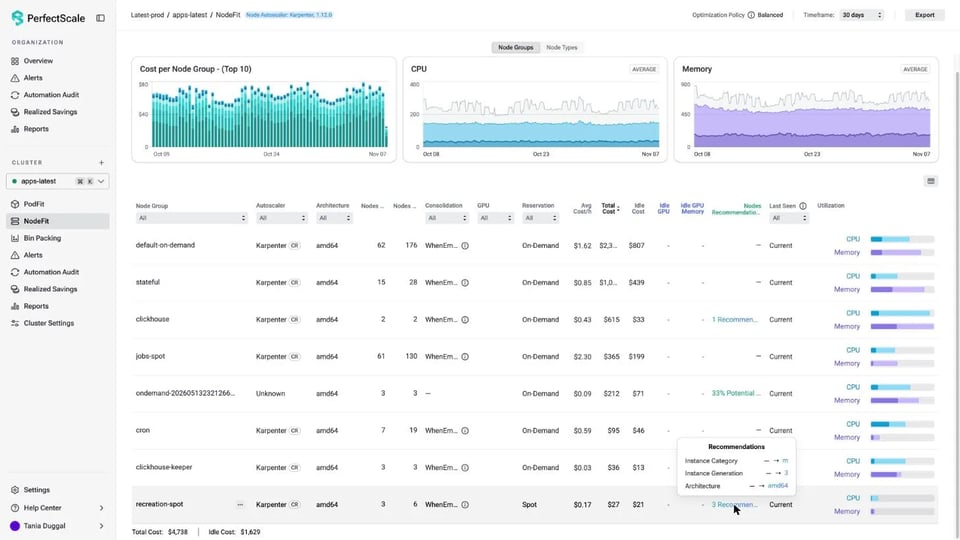
Uma visualização em YAML mostra a configuração atual e a recomendada, e você pode copiar o resultado.
- Encontre os pods que impedem a remoção de nós: Um único pod que não pode ser despejado pode manter um nó inteiro rodando. A visualização de bin packing mostra quais pods impedem a remoção de nós. Ela traz recomendações em diff YAML classificadas por impacto no custo, e cada uma tem um nível de confiança e um nível de risco. Você pode silenciar um apontamento que for intencional.
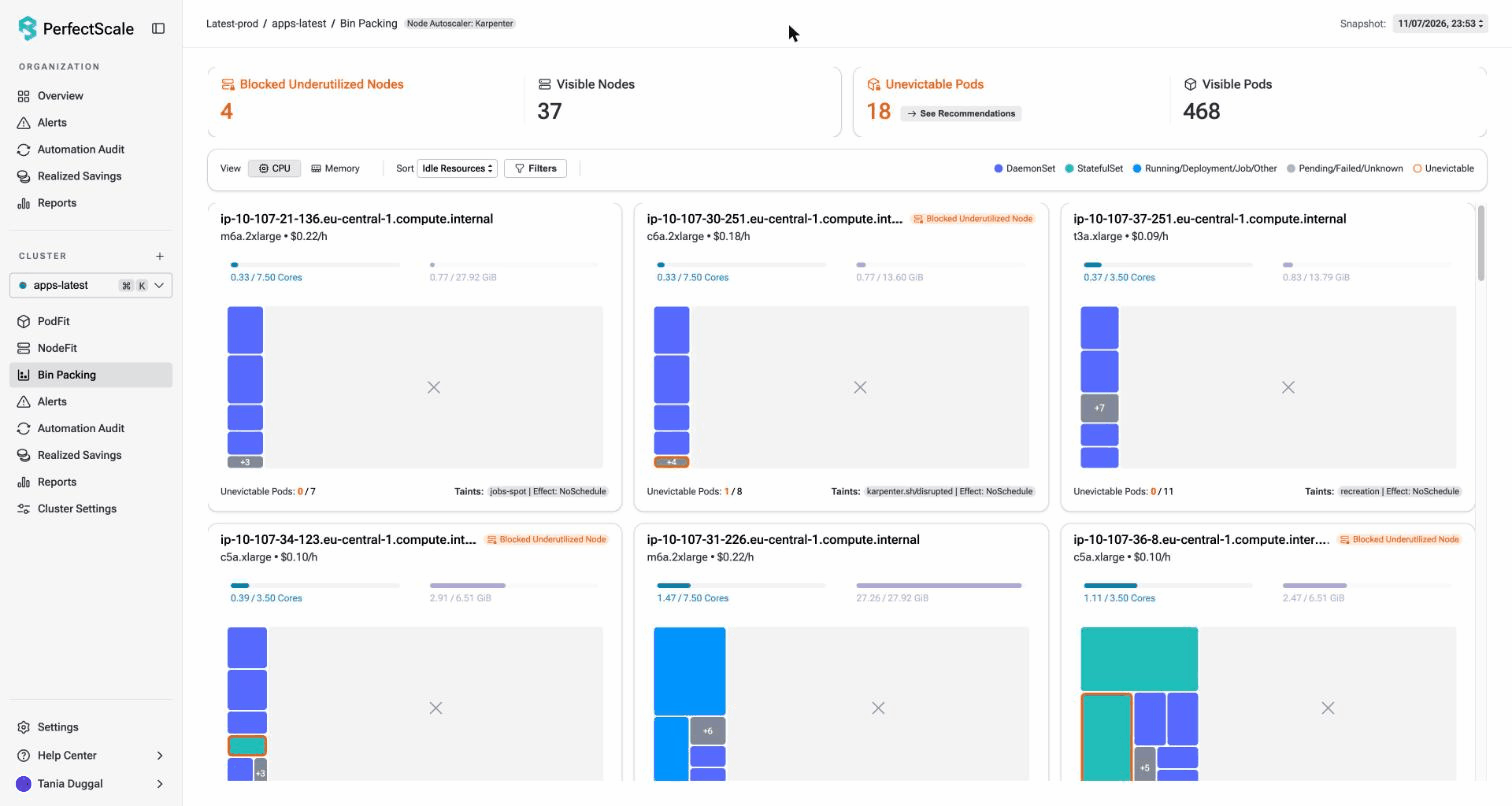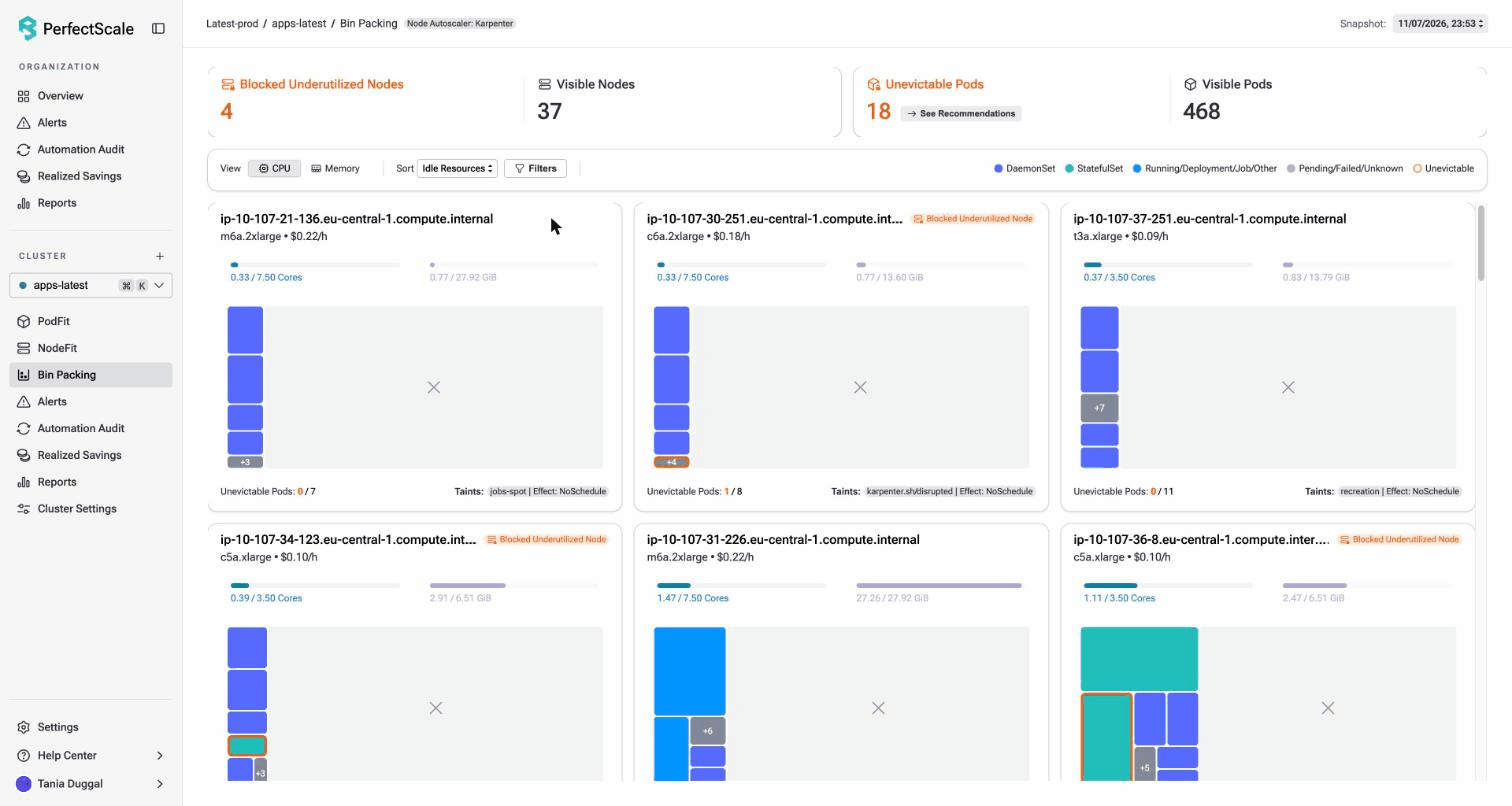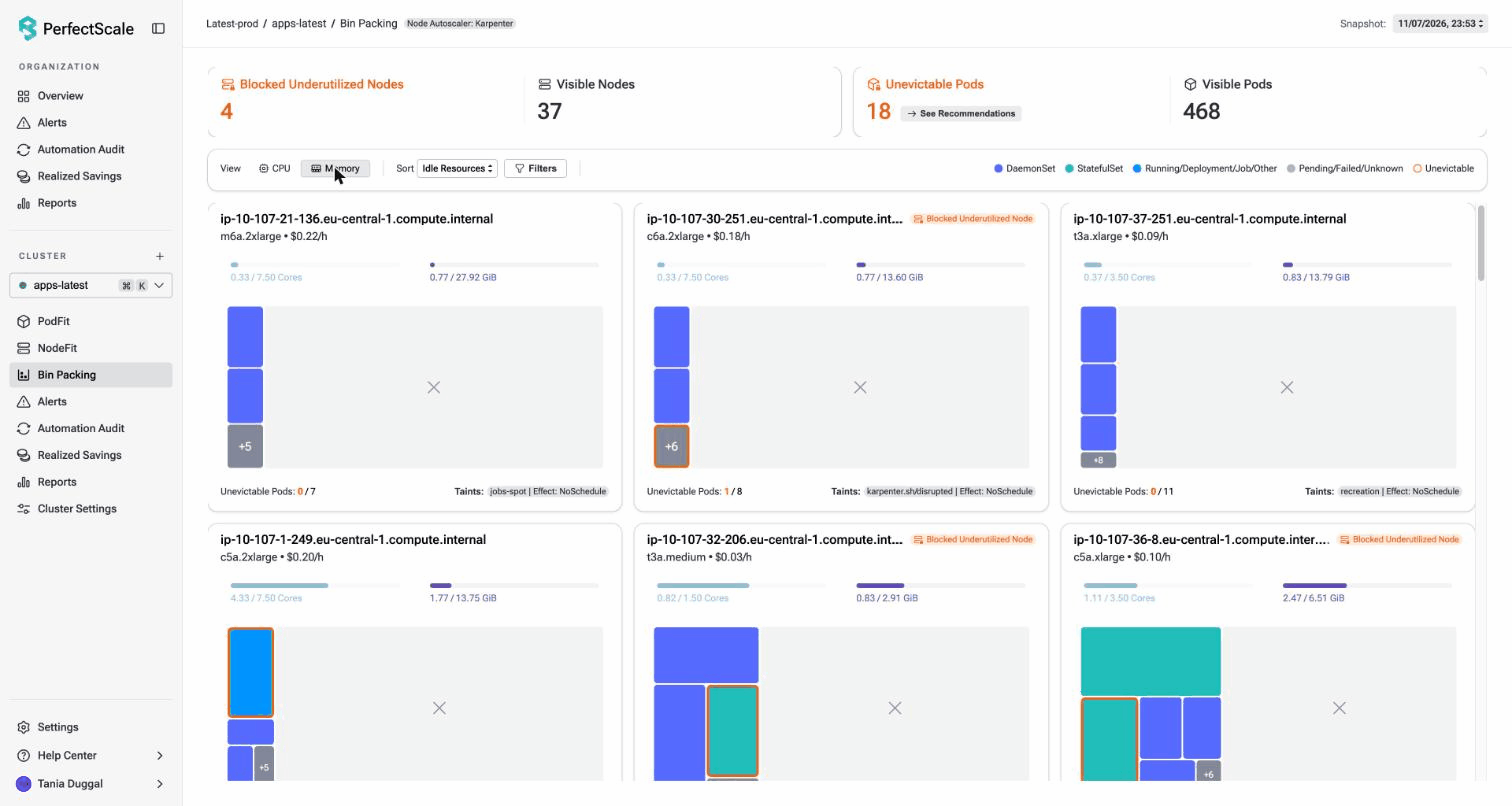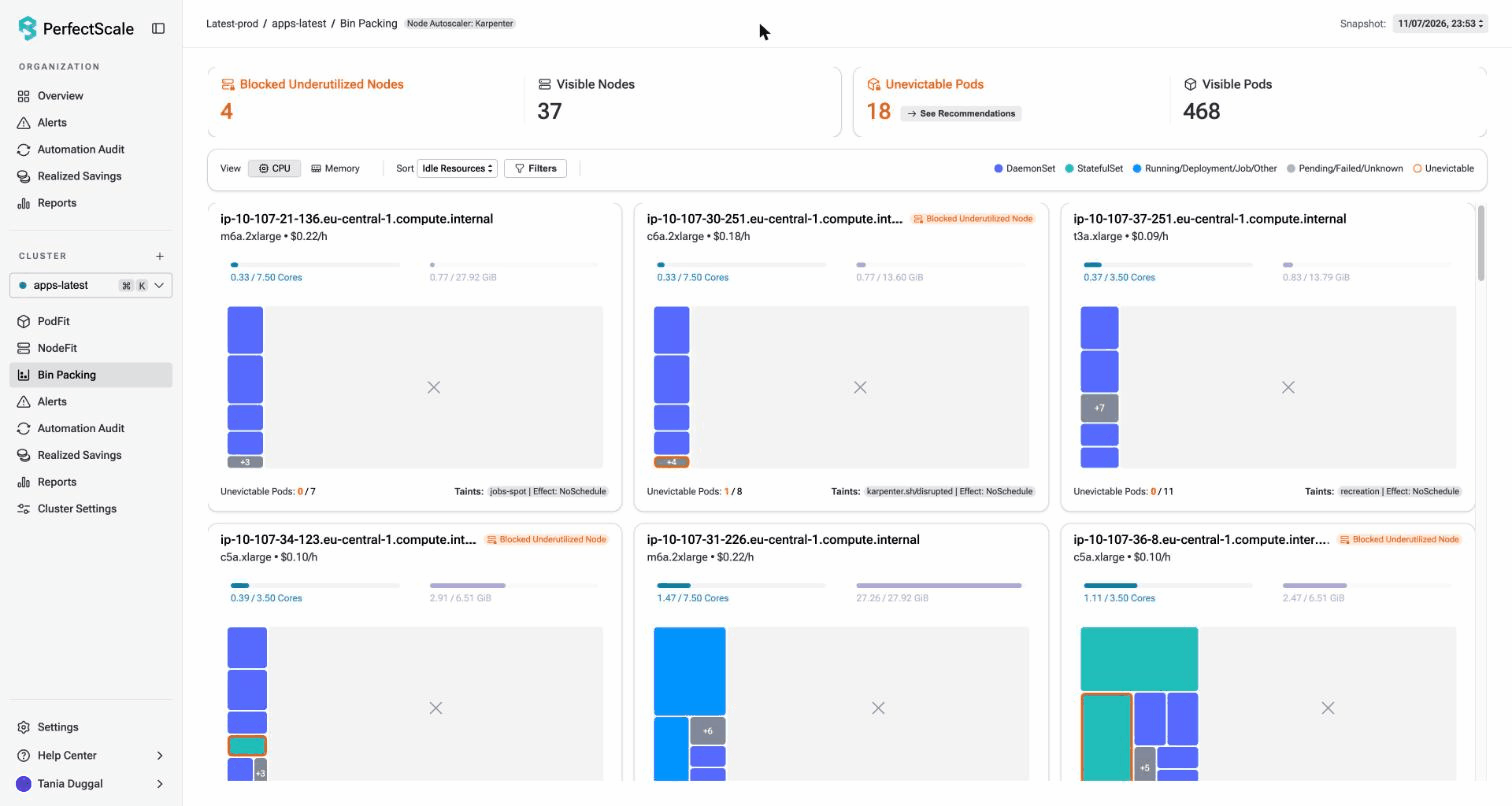
Um agente como o Claude também pode consultar os dados do PerfectScale com a skill de agente de IA do PerfectScale. Depois de cada mudança, use o histórico de mudanças na sua revisão para ver o que mudou e o que automatizar em seguida.
Veja o caminho em ação com um agente no workshop
Na próxima vez que um nó continuar rodando, leia o evento antes de mexer em qualquer configuração. Um agente pode ajudar nos primeiros passos, porque lê eventos, configuração e métricas muito mais rápido que você. Ele também pode dar uma resposta diferente cada vez que você pergunta. Por isso uma pessoa revisa cada mudança, e por isso regras fixas, e não um agente, devem aplicá-la em produção.
O workshop Agentic Karpenter: Using kagent + Claude to Tune Your Autoscaling acontece em 17 de novembro de 2026, às 11h ET. Vikram Seshadri e Ramesh Mathikumar mostram como um agente lê eventos como esses e esboça o diff, e onde as regras fixas assumem. Inscreva-se no workshop.
Lidando com nós que continuam rodando? Nosso time pode ajudar você a encontrar o bloqueio, revisar a mudança e recuperar capacidade sem comprometer a confiabilidade. Fale com nossos especialistas ou cadastre-se gratuitamente e experimente você mesmo.