

Deploymentを12 Podから3 Podにスケールダウンすると、大きなノード1台がほぼ空の状態になります。筆者らのサンドボックス環境では、待機時間を1分に設定した場合、Karpenterは約80秒でそのノードをより小さなノードに置き換えます。しかし、置き換えが行われないこともあり、その場合は大きなノードが稼働し続け、コストが発生し続けます。
Karpenterがノードを統合しない理由を知りたいときは、まずイベントを確認してください。Karpenterはノードをスキップした際にイベントを書き込み、そのイベントにはたいてい原因が示されています。
ただし、イベントは原因を示すだけで、解決策までは教えてくれません。PodDisruptionBudget(PDB)、Podのアノテーション、disruption budget、配置ルールはいずれも1台のノードを残す原因になり得ますが、それぞれ管理するチームが異なります。イベントを読む人が、必ずしもその原因を変更できる人とは限りません。
そこで、常に同じ手順で進めます。イベントを読み、1つのコマンドで裏付けを取り、最小限の変更をdiffとして書き、適用前にそのdiffをレビューする。この手順を私たちは「イベントからdiffへ」と呼んでいます。diffには変更される行だけが表示されます。
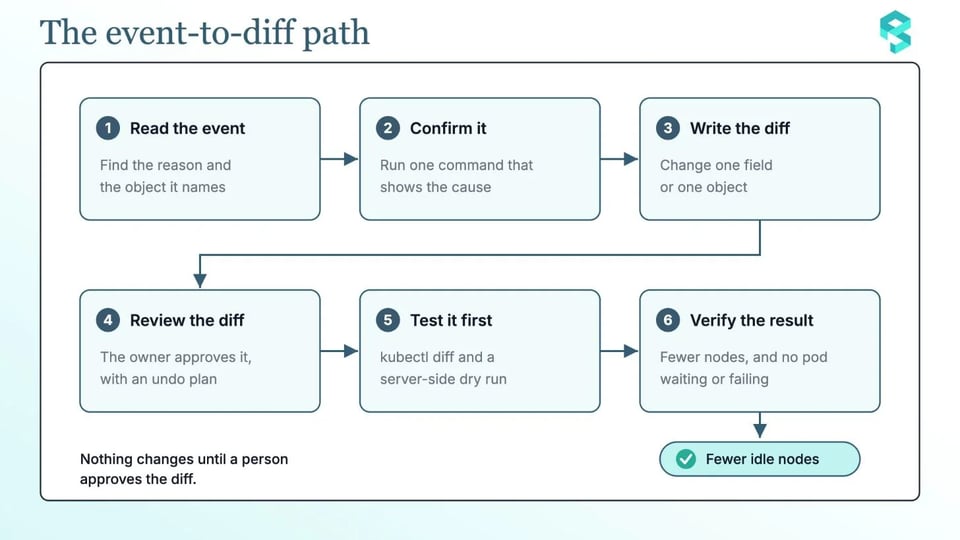
本記事では、ご自身のクラスターでも遭遇しうる4つのケースを通して、この手順をたどります。
- 中断を一切許可しないdisruption budget
- do-not-disruptアノテーション
- 余裕のないPDB
- 他のノードで実行できないPod
例はAWS上のKarpenter v1.15を使用しています。小規模なサンドボックス環境として、workshopという名前のNodePoolと、sandboxネームスペースにあるinflateという名前のDeploymentを使います。
Karpenterのデフォルトの動作
Karpenterがノードを削除する方法は2つあります。すべてのPodが他のノードの空き容量に収まる場合は、ノードを削除します。空き容量に加えてより低価格のノード1台で収まる場合は、ノードを置き換えます。
何も設定していないNodePoolには、consolidationPolicy: WhenEmptyOrUnderutilizedとconsolidateAfter: 0sが適用されます。さらに、Karpenterが一度にノードの10%を中断できるbudgetも設定されます。
自発的な中断(voluntary disruption)のたびに、Karpenterは同じ6つのステップを踏みます。
- 候補ノードを選択します。退避(evict)できないPodを抱えるノードは無視し、後で再試行します。
- その中断がNodePoolのbudgetに違反しないことを確認します。
- ノード上のPodのスケジューリングをシミュレートし、置き換え用のノードが必要かどうかを判断します。
karpenter.sh/disrupted:NoScheduletaintを付与し、そのノードで新しいPodが起動しないようにします。- シミュレーションで必要と判断された場合は置き換えノードを起動し、準備が整うまで待ちます。
- ノードを削除します。終了プロセスはKubernetesのEviction APIを使ってノードをドレインするため、PDBが尊重されます。静的Pod、taintを許容するPod、成功または失敗したPodは無視されます。
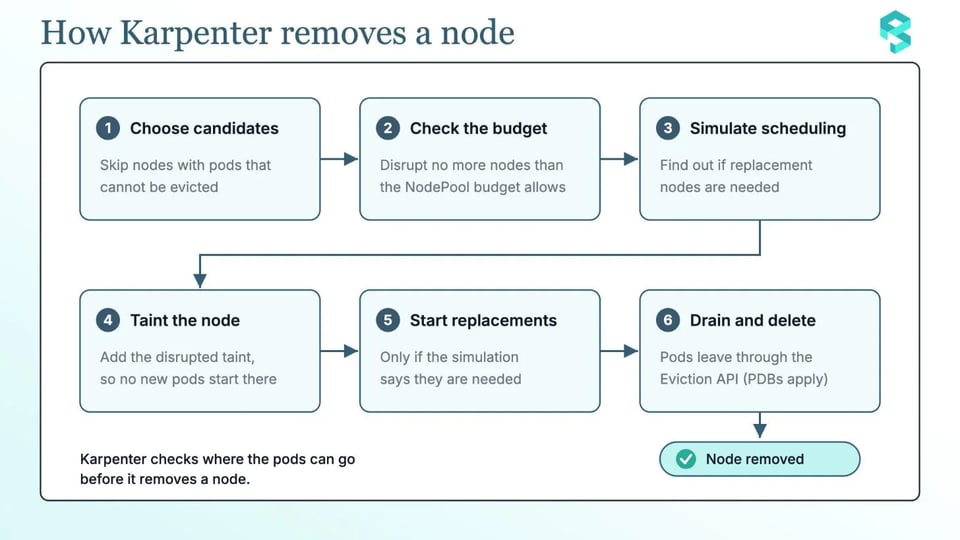
Karpenterがこれらのステップのいずれかで停止するとノードは残り、どのステップで止まったかはイベントで確認できます。budgetとdo-not-disruptアノテーションが影響するのは自発的な中断だけです。有効期限切れ、中断(interruption)、手動削除ではこれらは無視されます。
まずイベントを読む
Karpenterはノードをスキップした際にイベントを書き込み、その理由(reason)から問題の種類がわかります。Unconsolidatableは、統合がそのノードに適用できないことを意味します。DisruptionBlockedは、PDB、Podまたはノードのアノテーション、NodePoolのbudgetといった何かが中断をブロックしていることを意味します。
ノードのイベントは、ノードとそのNodeClaimに表示されます。budgetのイベントはノードではなくNodePoolに表示されます。以下のコマンドで、1つのノード、そのNodeClaim、NodePool、クラスター全体のイベントを収集できます。$NODE、$NODECLAIM、$NODEPOOLは実際の名前に置き換えてください。
kubectl describe node $NODEkubectl describe nodeclaim $NODECLAIMkubectl describe nodepool $NODEPOOLkubectl get events -A --field-selector reason=Unconsolidatable --sort-by=.lastTimestampkubectl get events -A --field-selector reason=DisruptionBlocked --sort-by=.lastTimestampKarpenter v1.15では、4つのケースのメッセージは次のようになります。
| メッセージ | 意味 | 確認方法 |
|---|---|---|
No allowed disruptions for disruption reason Underutilized due to blocking budget |
budgetが現在、中断を一切許可していません。このイベントはNodePoolに表示されます。 | NodePoolのdisruptionブロック |
Pod has "karpenter.sh/do-not-disrupt" annotation (Pod=<namespace>/<name>) |
ノード上のPodがこのアノテーションを持っています。 | ノード上のPodのアノテーション |
Pdb prevents pod evictions (PodDisruptionBudget=[<namespace>/<name>]) |
PDBに、ノード上のPodを退避させる余裕がありません。 | 各PDBのALLOWED値 |
Can't replace with a cheaper node |
Podを収容できる、より安価なノードが見つかりませんでした。 | Podのリクエスト、NodePoolの要件、NodePoolの制限 |
このほかに、NodePoolの設定を示すメッセージが2つあります。NodePool "<name>" has consolidation disabledは、consolidateAfterがNeverであることを意味します。NodePool "<name>" has consolidation policy WhenEmpty, but node is not emptyは、ポリシーが空のノードのみを対象としていることを意味します。Spotノードの場合、Karpenterがノードを置き換えるのはSpotToSpotConsolidationフィーチャーゲートが有効なときだけです。
それでは、各ケースを1つずつ、手順に沿って見ていきましょう。
ケース1:中断を一切許可しないbudget
この場合、証拠はノードではなくNodePoolにあります。No allowed disruptions for disruption reason Underutilized due to blocking budgetというDisruptionBlockedイベントが記録されています。
確認するには、NodePoolのdisruptionブロックを読みます。
kubectl get nodepool $NODEPOOL -o jsonpath='{.spec.disruption}{"\n"}'nodes: '0'、または現在有効なscheduleとdurationを持つbudgetを探してください。nodes: '0'でreasonsのないbudgetは、すべての自発的な中断をブロックします。NodePoolに複数のbudgetがある場合、Karpenterは最も低い値を採用します。
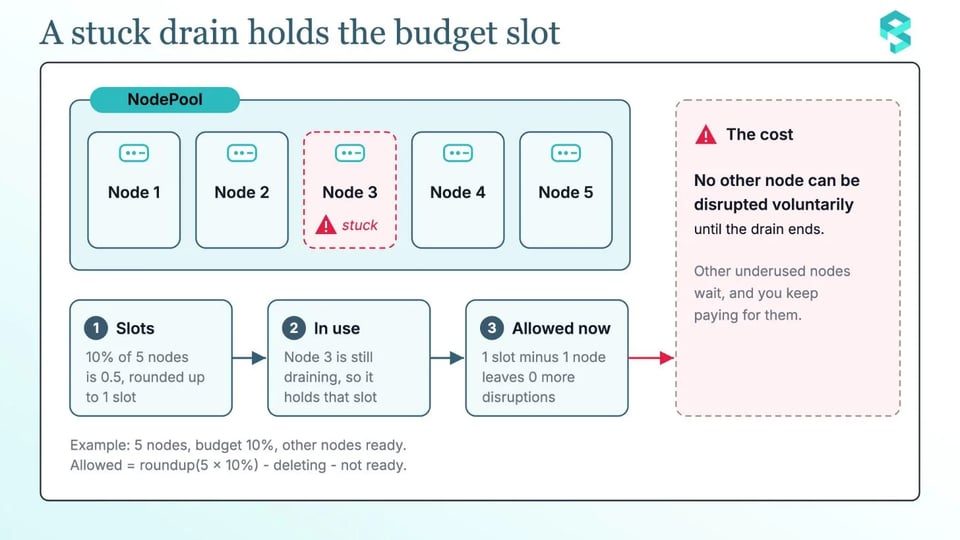
Karpenterは、すでに削除中のノードもカウントに含めます。パーセンテージ指定の場合、許可される中断数は次のように計算されます。
| allowed = roundup(total x percentage) - deleting - not ready |
|---|
ノードが5台でbudgetが10%の場合、結果は1です。ここで、1台のノードがドレイン途中のまま止まっているとしましょう。そのノードが枠を使ってしまうため、ドレインが完了するまで、budgetは追加の中断を1件も許可しません。
budgetを恒久的にゼロにするのは制限が強すぎます。代わりに、繁忙時間帯に合わせたウィンドウを設定しましょう。以下の例は平日のUTC 9:00から8時間有効で、それ以外の時間帯は最初のbudgetが通常の制限を維持します。
spec: disruption: budgets:- - nodes: '0'+ - nodes: 10%+ - nodes: '0'+ schedule: '0 9 * * mon-fri'+ duration: 8h+ reasons:+ - Underutilizedこれにより、停止されるのはウィンドウ内に限った、使用率の低いノードの削除だけになります。Karpenterはスケジュールを常にUTCとして解釈します。
ケース2:do-not-disruptアノテーション
証拠はノードとそのNodeClaimにあります。DisruptionBlockedイベントにはPod has "karpenter.sh/do-not-disrupt" annotation (Pod=<namespace>/<name>)と記録されます。ノード自体がこのアノテーションを持つ場合、メッセージはDisruption is blocked through the "karpenter.sh/do-not-disrupt" annotationになります。
アノテーションを見つけるには、それを持つPodとノードを一覧表示します。以下のコマンドはjqを使用します。
kubectl get pods -A -o json | jq -r '.items[] | select(.metadata.annotations["karpenter.sh/do-not-disrupt"] != null) | "\(.metadata.namespace)/\(.metadata.name) node=\(.spec.nodeName) value=\(.metadata.annotations["karpenter.sh/do-not-disrupt"])"'
kubectl get nodes -o json | jq -r '.items[] | select(.metadata.annotations["karpenter.sh/do-not-disrupt"] != null) | .metadata.name'値が"true"の場合、Podは恒久的に保護されます。"30m"のような期間を指定すると、実行開始からその期間だけ保護されます。このアノテーションは1つのPodに対するPDBのように機能します。統合をブロックし、NodePoolにterminationGracePeriodが設定されていない限りドリフトもブロックします。
恒久的な値よりも期間指定のほうがレビューで正当性を説明しやすくなります。Podが本当に保護を必要とする期間を明示できるからです。アプリケーションチームが30分後にはPodを移動してよいと合意したら、値を"true"から期間に変更します。
template: metadata: annotations:- karpenter.sh/do-not-disrupt: "true"+ karpenter.sh/do-not-disrupt: "30m"ケース3:余裕のないPDB
証拠はノードとそのNodeClaimにあります。DisruptionBlockedイベントにはPdb prevents pod evictions (PodDisruptionBudget=[<namespace>/<name>])と記録されます。
確認するには、すべてのPDBを許可された中断数とともに一覧表示します。
kubectl get pdb -A -o custom-columns='NAMESPACE:.metadata.namespace,NAME:.metadata.name,MIN:.spec.minAvailable,MAXUNAVAIL:.spec.maxUnavailable,ALLOWED:.status.disruptionsAllowed'ALLOWED値が0の場合、そのPDBの対象となるPodは今は1つも退避できません。maxUnavailableを0に設定したり、minAvailableを100%またはレプリカ数に設定したりすると、自発的な退避を一切許可しないことになり、ノードのドレインは永遠に完了しません。
KarpenterがPodを退避するには、そのPodを選択するPDBが退避を許可している必要があります。1つのPodに対するPDBは1つだけにしてください。2つのPDBが同じPodを選択していると、両方のPDBに余裕があっても、KubernetesはそのPodの退避を拒否します。このケースでは、Karpenterがイベントを記録しないことがあります。最近のKubernetesバージョンでは、PodにMultiplePodDisruptionBudgetsイベントが書き込まれます。そのたった1つのPodが、ノード全体をブロックすることもあります。実行中だがready状態ではないPodも、budgetに余裕がない場合、退避をブロックすることがあります。
修正はごく小さな変更です。レプリカ数3のDeploymentでは、minAvailable: 3の代わりにmaxUnavailable: 1を使用します。
spec: minAvailable: 3 maxUnavailable: 1PDBに設定できるのは2つのフィールドのうち1つだけです。Kubernetesは、レプリカ数に追従するmaxUnavailableを推奨しています。
クラッシュループ中のPodが退避をブロックしている場合は、unhealthyPodEvictionPolicy: AlwaysAllowを追加します。このフィールドはKubernetes v1.31以降、安定版です。
spec: maxUnavailable: 1 unhealthyPodEvictionPolicy: AlwaysAllowケース4:他のノードで実行できないPod
Karpenterはノードを削除する前に、Podの移動先をシミュレートします。1つでも他に収まらないPodがあると、ノードは残ります。イベントには必ずしもそのPodの名前が示されないため、Podの仕様から見つけることになります。
ノード上の各Podが何によってその場所に固定されているかを確認するには、ノード上のすべてのPodの詳細を一覧表示します。
kubectl get pods -A --field-selector spec.nodeName=$NODE -o json | jq '.items[] | {pod: "\(.metadata.namespace)/\(.metadata.name)", owner: (.metadata.ownerReferences[0].kind // "none"), nodeSelector: .spec.nodeSelector, requiredAntiAffinity: (.spec.affinity.podAntiAffinity.requiredDuringSchedulingIgnoredDuringExecution != null), topologySpread: [.spec.topologySpreadConstraints[]? | {key: .topologyKey, maxSkew: .maxSkew, whenUnsatisfiable: .whenUnsatisfiable}], claims: [.spec.volumes[]? | select(.persistentVolumeClaim != null) | .persistentVolumeClaim.claimName]}'次の原因を探してください。
- 他のノードの空き容量より大きなリクエスト
- このノードグループにのみ一致する
nodeSelector - 必須(required)のanti-affinityルール
- 他のノードでは満たせないtopology spreadルール
- 特定のゾーンにバインドされたボリューム
- Podが許容しない、他のノード上のtaint
また、preferred指定のanti-affinityルールやtopology spreadルールも統合の効果を下げる可能性がある点に注意してください。Karpenterはノードを削除する際にこれらを満たそうとするからです。コントローラーを持たないPodも確認してください。これらはKarpenterをブロックしませんが、退避後に再起動してくれるものが何もありません。
まず最初の原因から始めましょう。KarpenterはPodを使用量ではなくリクエストに基づいて配置します。実際の使用量をリクエストと比較して確認します。
sum by (namespace) (rate(container_cpu_usage_seconds_total{container!=""}[5m]))/sum by (namespace) (kube_pod_container_resource_requests{resource="cpu"})比率が1を大きく下回っている場合、リクエストが大きすぎます。その結果、各ノードは本来収容できるよりも少ないPodしか収容できず、空いた分のコストを払い続けることになります。
証拠がリクエストの過剰を示している場合は、実際に必要な量まで下げます。変更するのは、証拠が指し示すその1つの値だけにしてください。
resources: requests:- cpu: "4"+ cpu: "2"証拠からdiffへ:適用前に必ずレビューする
すべてのケースは小さなdiffに行き着きます。各diffは同じ方法でレビューしてください。
| ケース | イベント | 確認方法 | diffが変更するもの | 担当 |
|---|---|---|---|---|
| budget | NodePool上のDisruptionBlocked |
jsonpath付きのkubectl get nodepool |
1つのbudgetエントリー | プラットフォームチーム |
| アノテーション | ノード上のDisruptionBlocked |
Podとノードに対するjqフィルター |
1つのアノテーション値 | アプリケーションチーム |
| PDB | ノード上のDisruptionBlocked |
kubectl get pdb -A |
1つのPDBフィールド | アプリケーションチーム |
| 他のノードがない | Unconsolidatable、またはイベントなし |
Pod配置に対するjqフィルター |
1つのリクエストまたは1つのルール | アプリケーションチーム |
diffを適用する前に、次の6つの問いに答えてください。
- どのイベント、フィールド、アノテーションが阻害要因の証拠になっていますか?
- diffが変更するのは1つのフィールドまたは1つのオブジェクトだけですか?
- そのオブジェクトの担当者は承認しましたか?
- 一度に移動できるノード数を制限するものは何ですか。budgetですか、それとも時間ウィンドウですか?
- 変更をどのように元に戻し、何をきっかけに元に戻しますか?
- 変更をまずテストクラスターまたはサンドボックスのNodePoolで実行しましたか?
次に、diffを適用せずにテストします。
kubectl diff -f workshop-nodepool.yamlkubectl apply --dry-run=server -f workshop-nodepool.yamlkubectl diffコマンドは、kubectl applyが何を変更するかを表示します。サーバーサイドのドライランは実際のAPIに対して変更をチェックし、何も保存しません。diffコマンドは差分を見つけると終了コード1で終了するため、スクリプトはそれを失敗として検知できます。
diffを適用したら、結果を検証します。
kubectl get nodeclaims -wkubectl get pods -A --field-selector=status.phase!=Running,status.phase!=Succeededノード数が減少し、移動が原因で待機状態や失敗状態になるPodがないことを確認してください。移動が必要なサービスについては、すべてのPDBのALLOWED値が再び0より大きくなっているはずです。
PerfectScaleができること
PerfectScale by DoiTは、このプロセスを置き換えるものではありません。同じ手順を、より少ない手作業で実行できるようチームを支援します。順序が重要です。リクエストが適正化されているほど統合で得られる効果が大きくなるため、PerfectScaleはまずworkloadsのライトサイジングを推奨します。その後でNodePoolをチューニングできます。
PerfectScaleは次のように役立ちます。
- 設定とそのすべての変更を可視化: Karpenterの設定は時間とともに変化するため、何がいつ変わったかを把握できると便利です。PerfectScaleはクラスター内のKarpenterを検出し、NodePoolとnode classの設定を変更履歴とともに表示します。
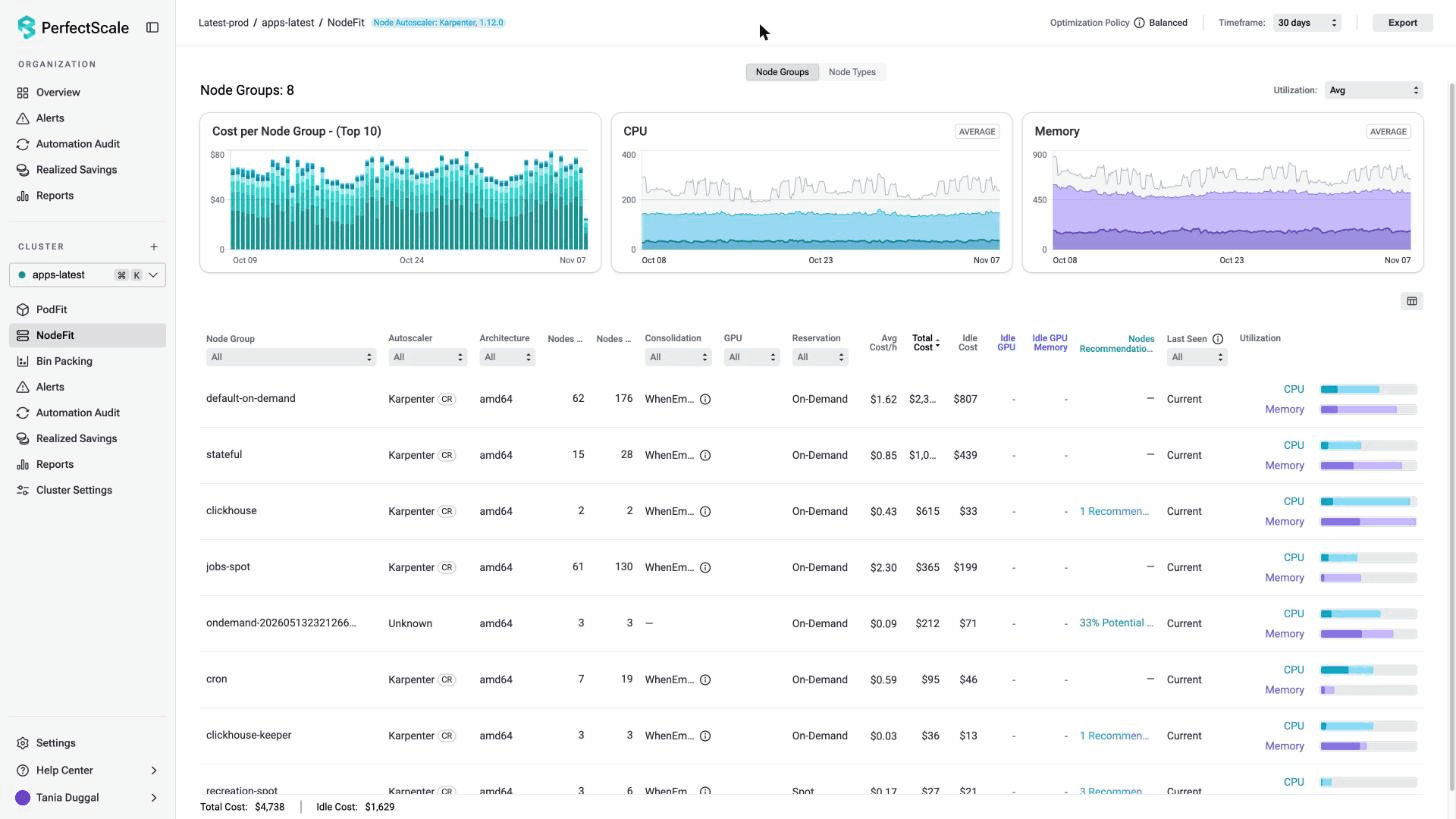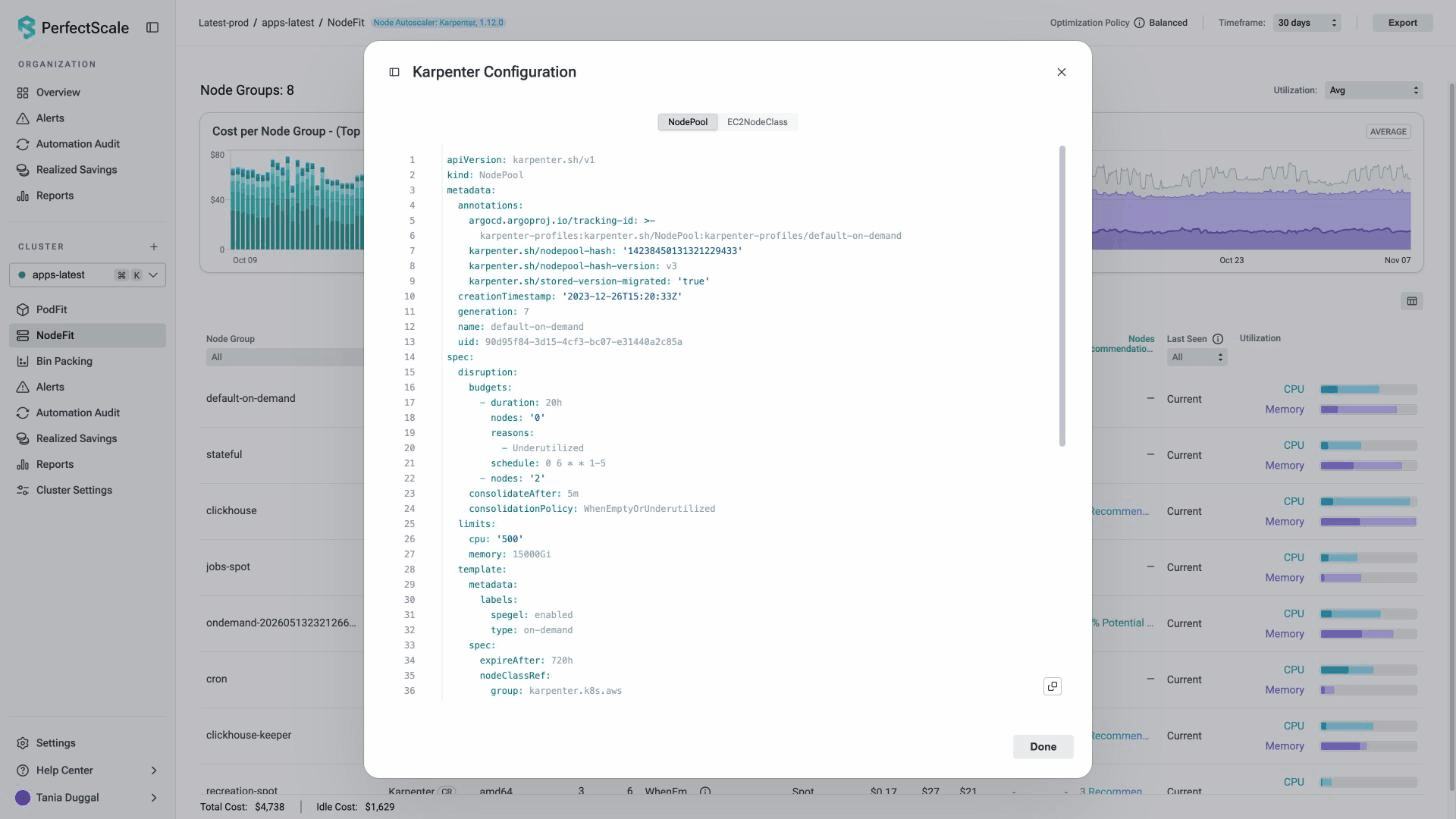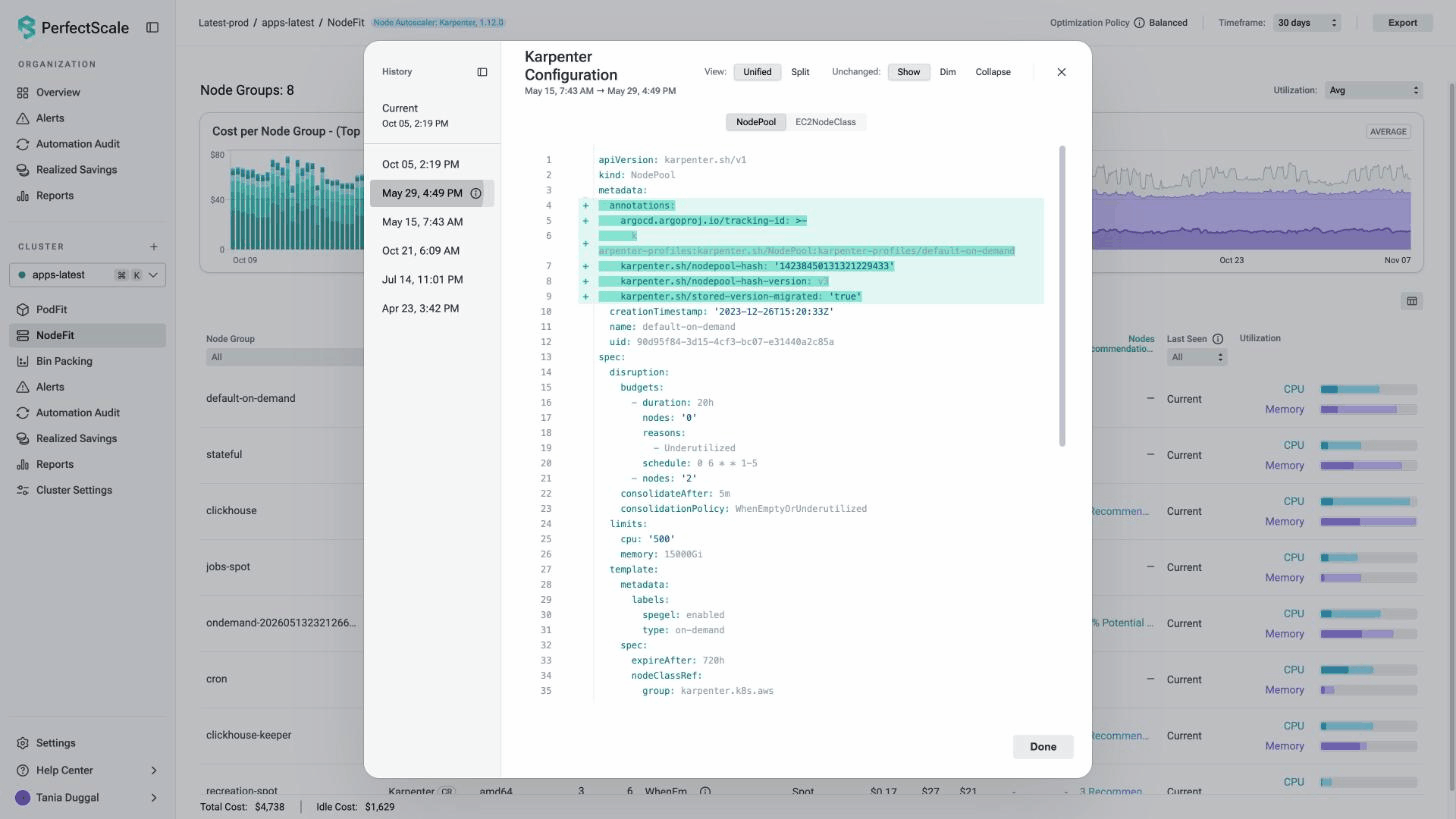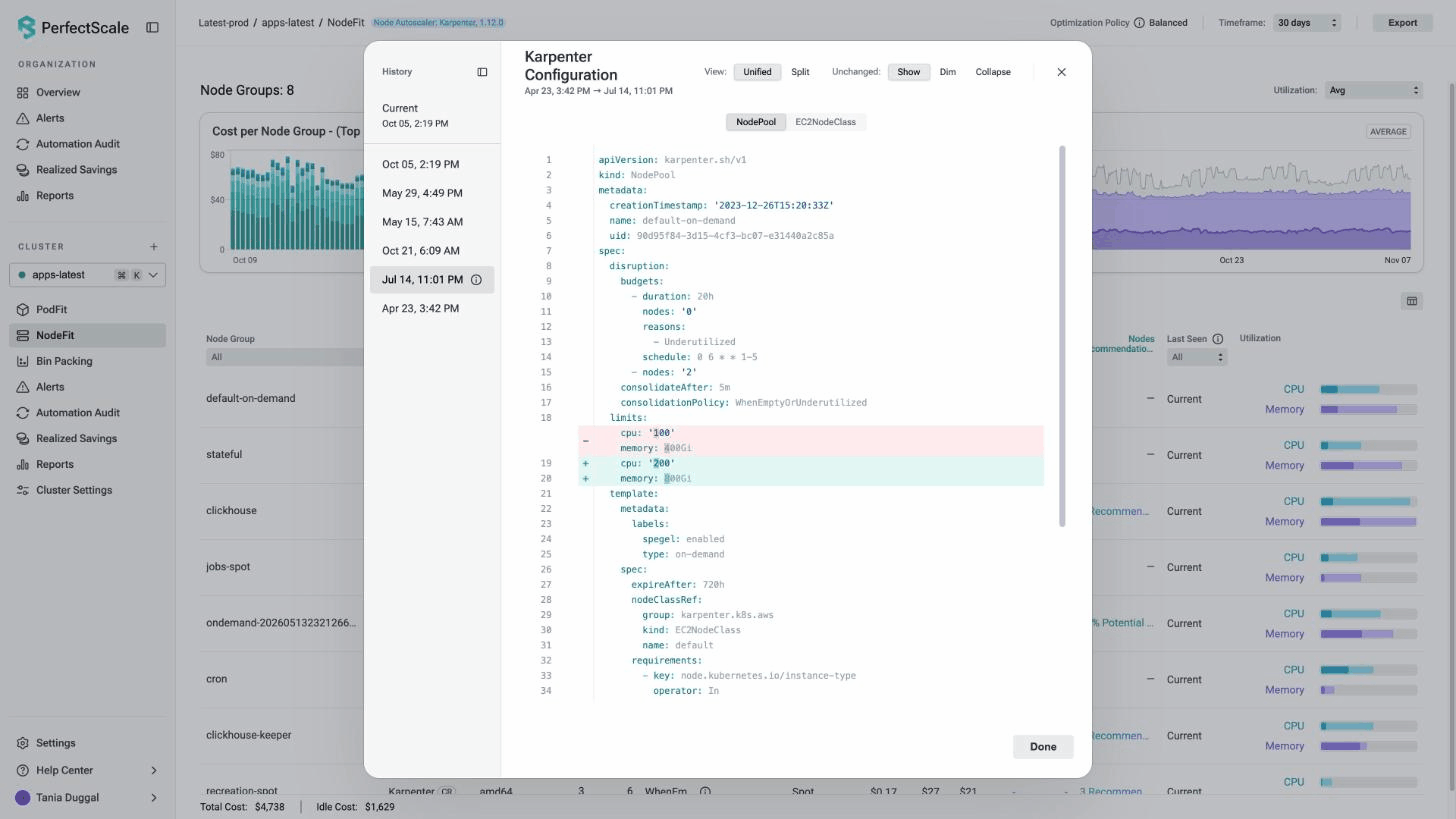
- NodePool設定の推奨事項を取得: 統合ポリシー、待機時間、インスタンスの選択肢が、Karpenterがノードを削除する速度を左右します。PerfectScaleは、これらの設定や、枯渇に近づいているNodePoolの制限について、Karpenter最適化の推奨事項を提供します。推奨事項は次のことに役立ちます。
- 統合ポリシーと待機時間を見直す
- Karpenterが新しいノードをプロビジョニングする際のインスタンスの選択肢を増やす
- 新しいキャパシティの余地が少なすぎるNodePool制限を見つける
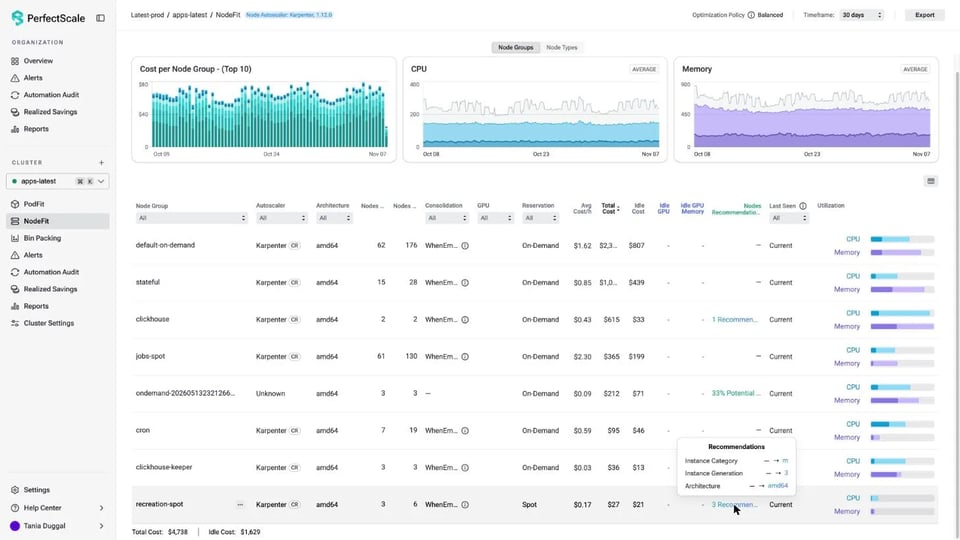
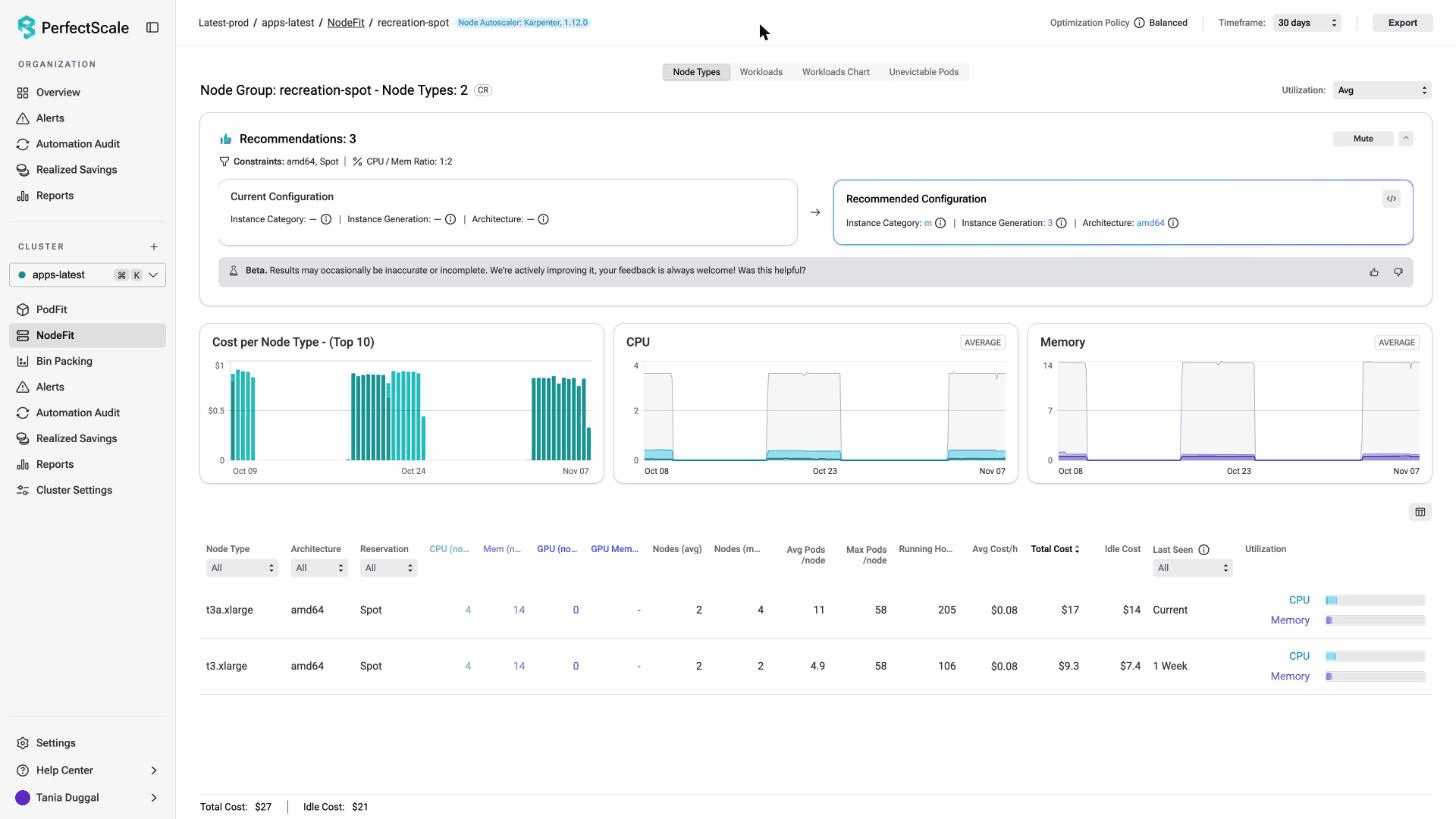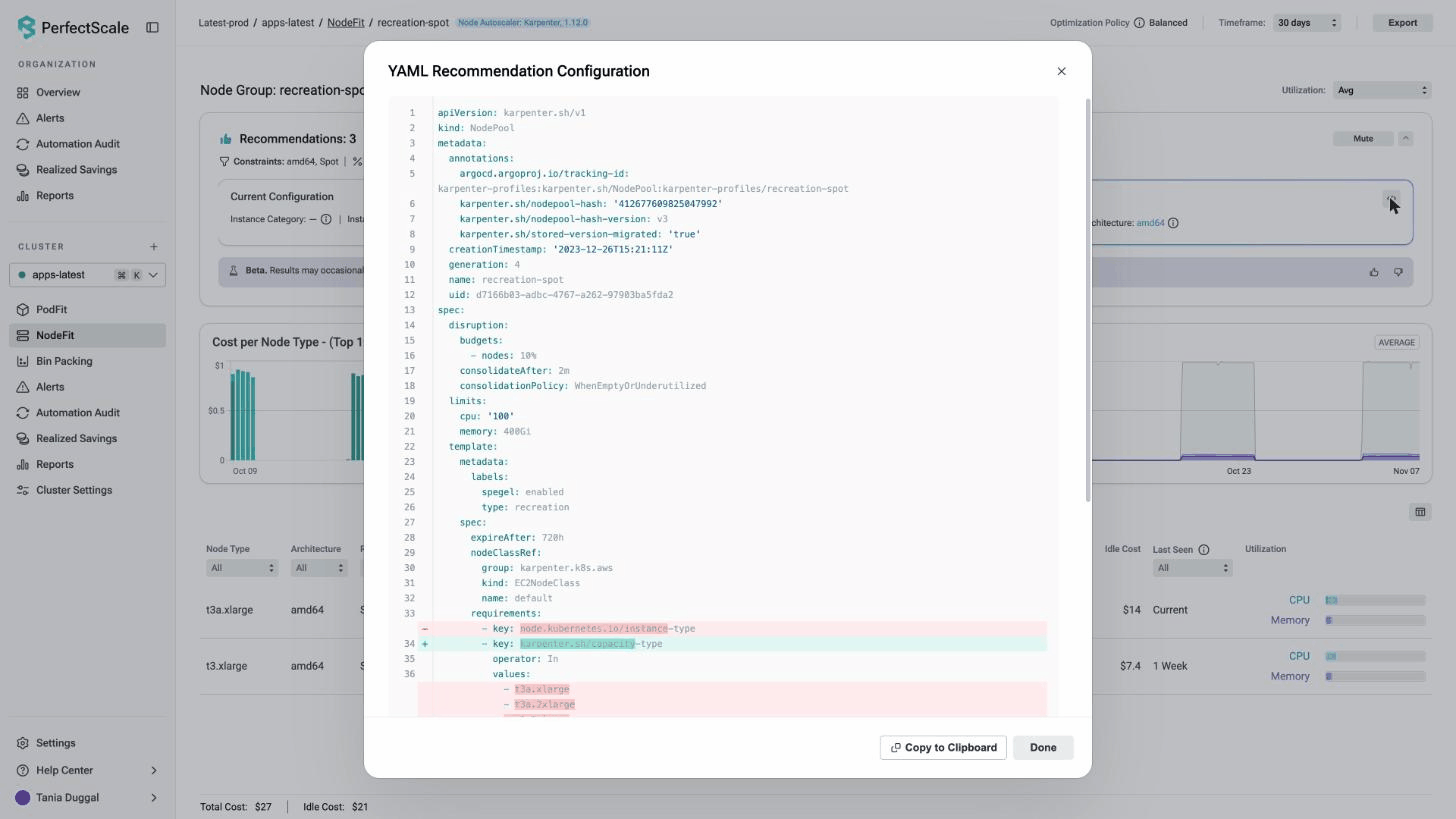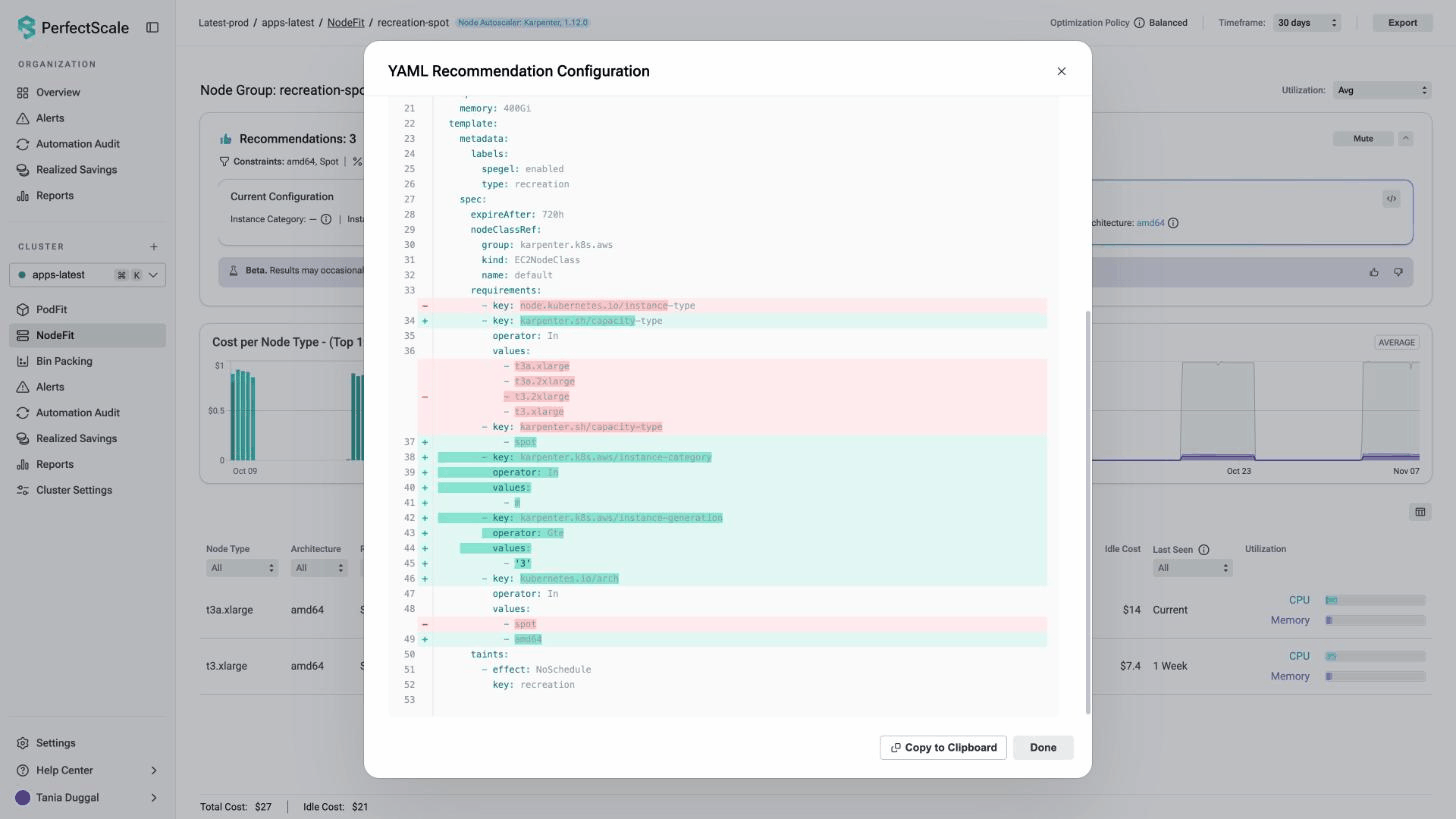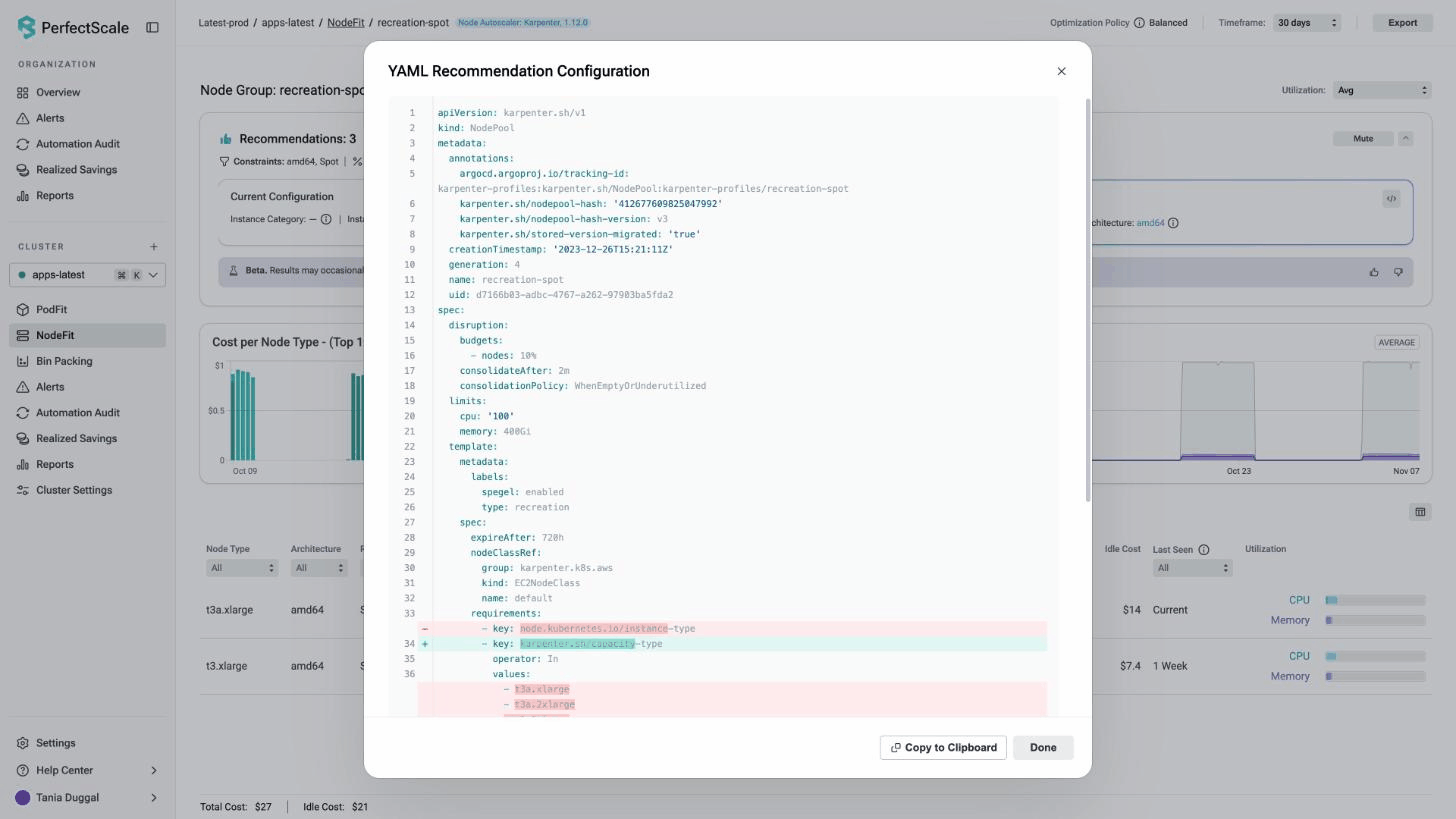
YAMLビューには現在の設定と推奨される設定が表示され、結果をコピーできます。
- ノードの削除を妨げているPodを発見: 退避できない1つのPodが、ノード全体を稼働させ続けることがあります。bin packingビューでは、どのPodがノードの削除を妨げているかがわかります。コストインパクト順にランク付けされたYAML diffの推奨事項を提供し、それぞれに信頼度とリスクレベルが付いています。意図的な設定については、検出結果をミュートできます。
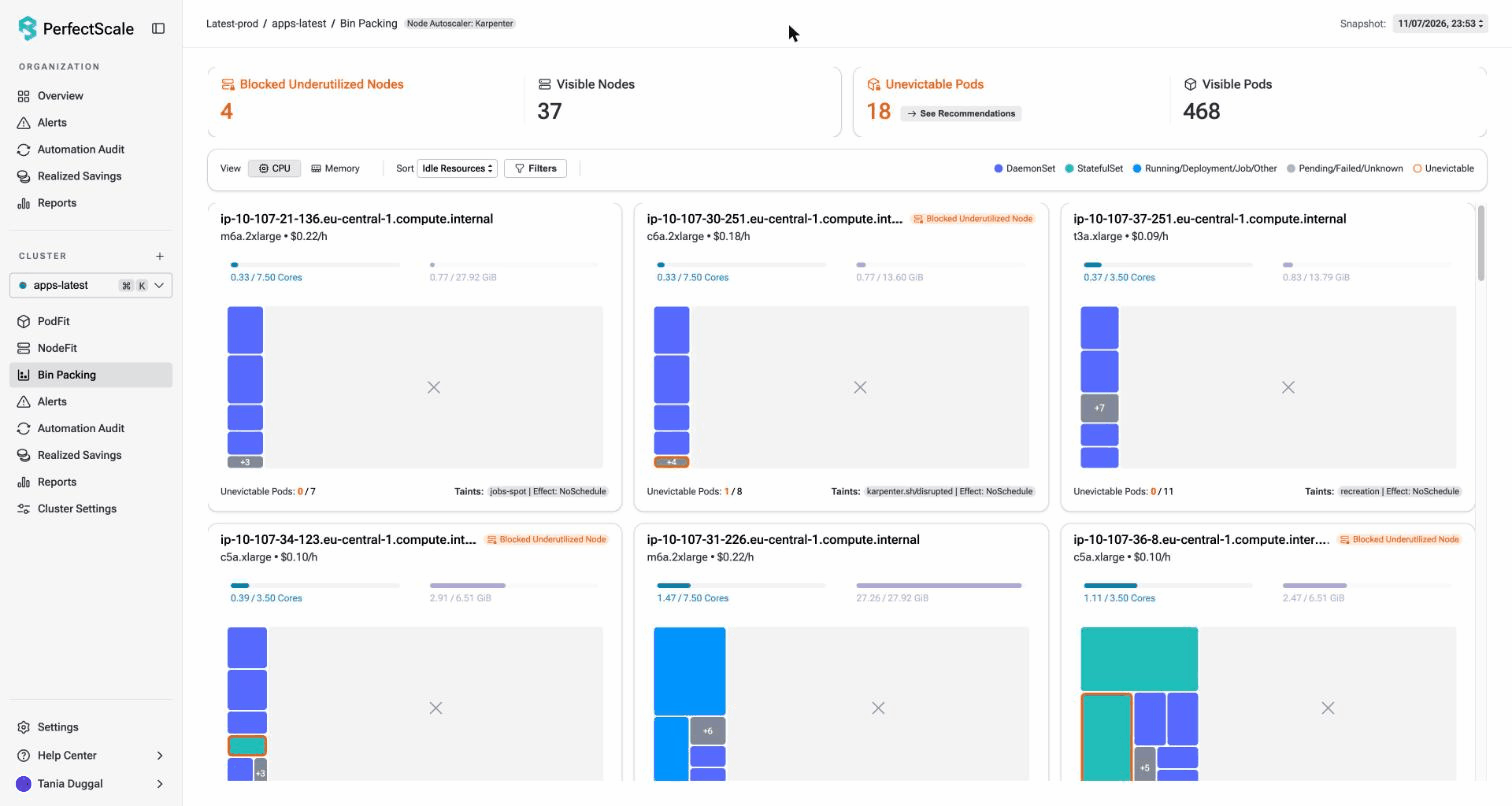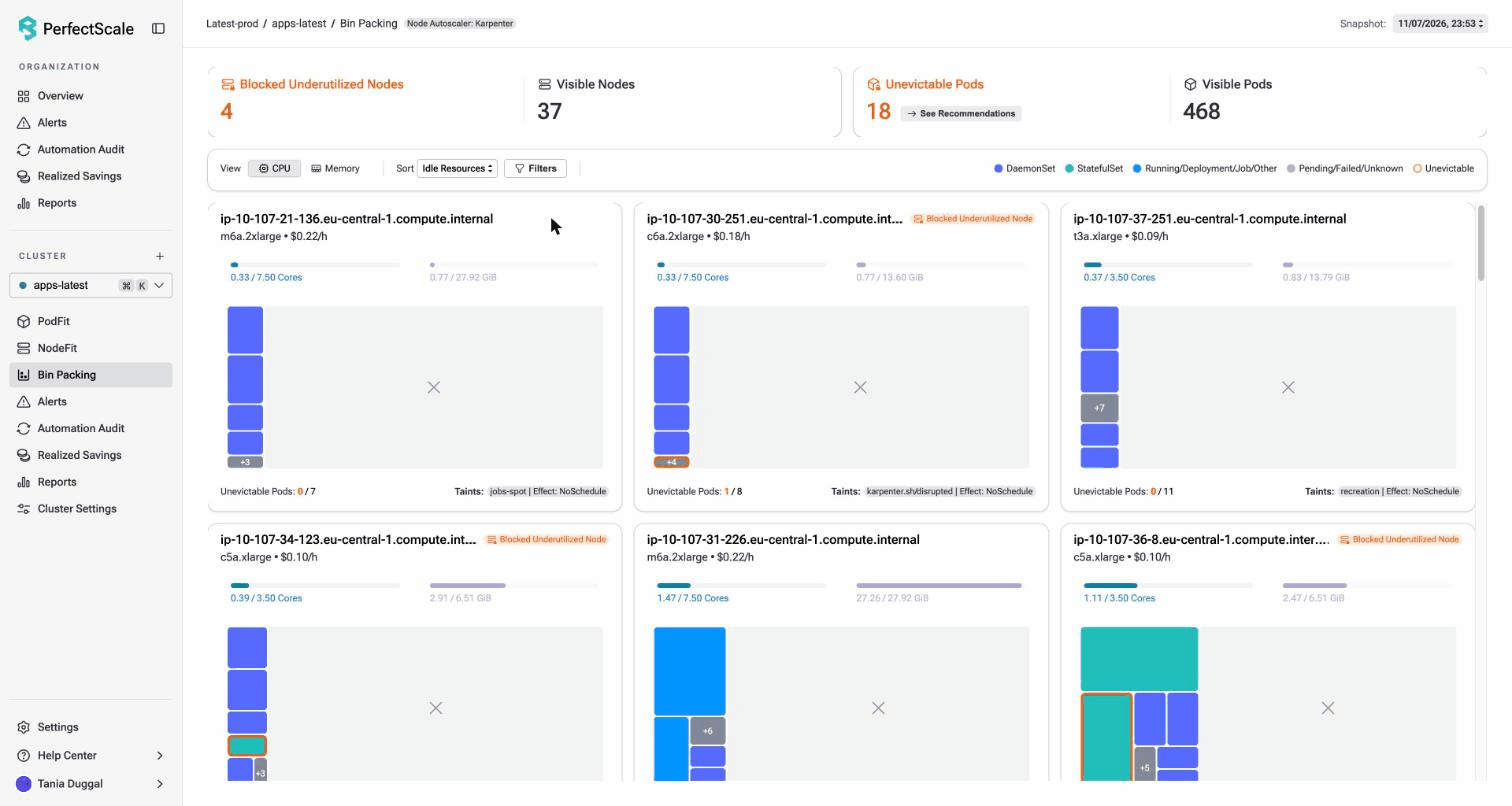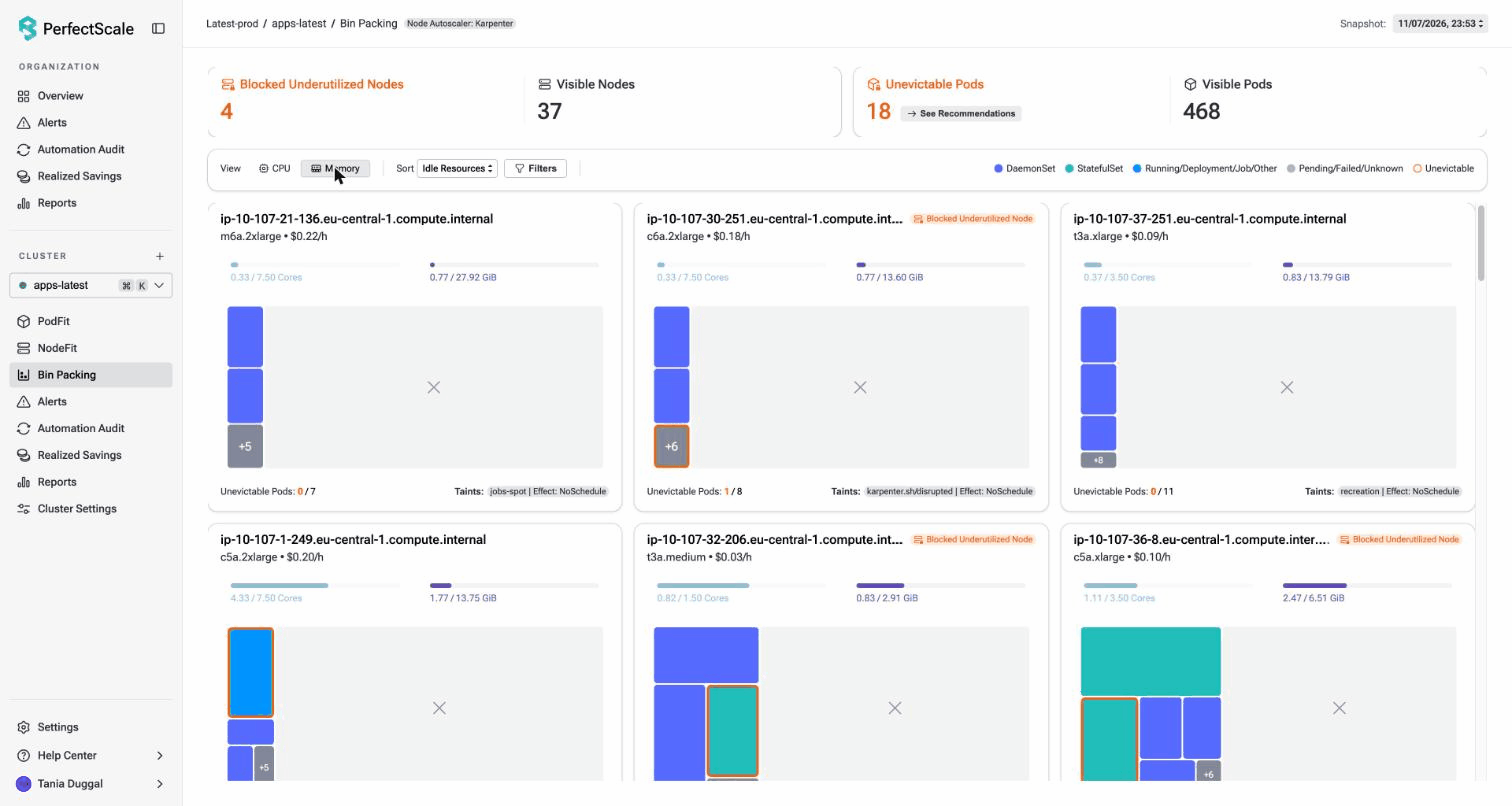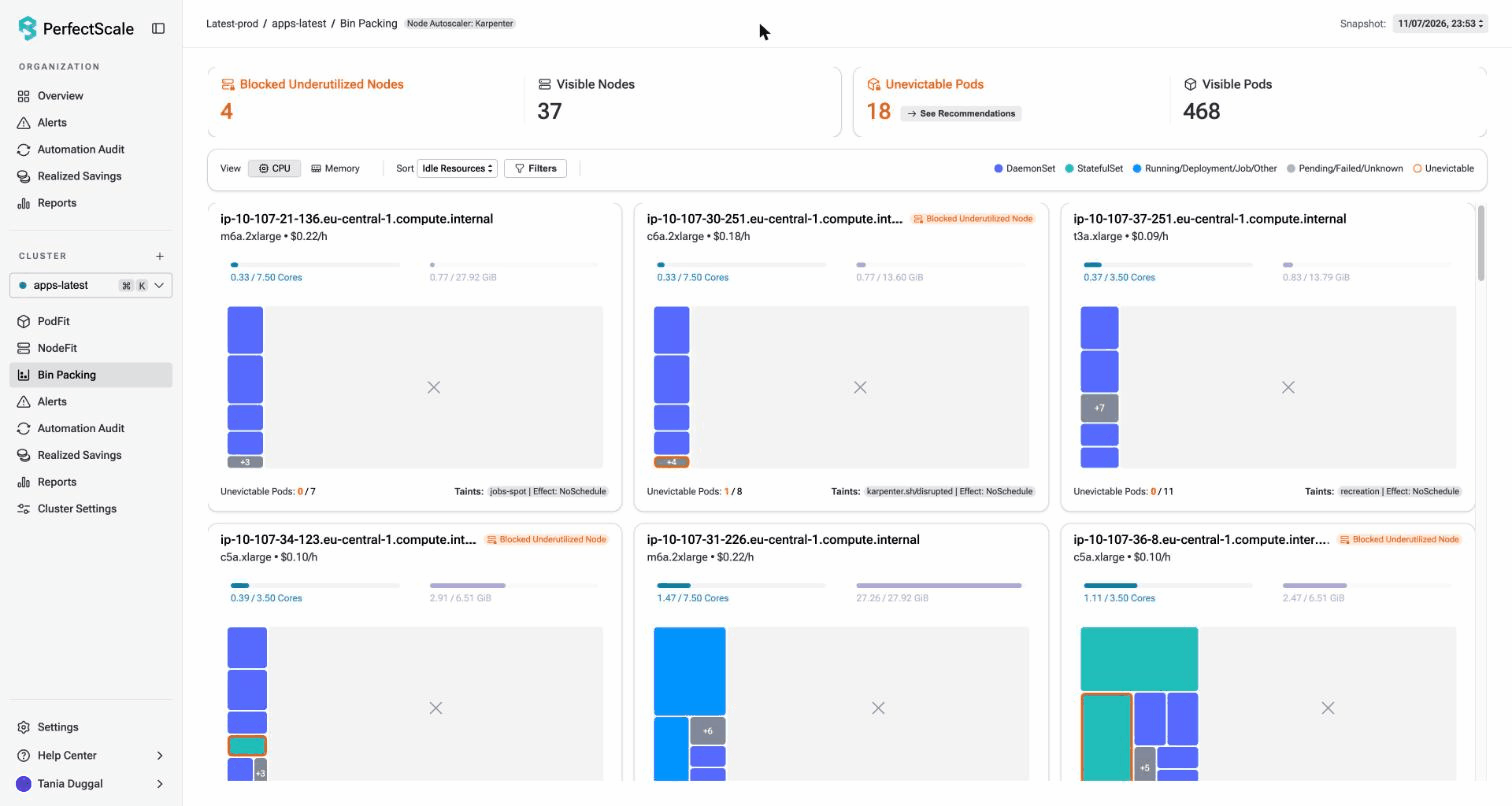
Claudeのようなエージェントは、PerfectScale AIエージェントスキルを使ってPerfectScaleのデータを照会することもできます。変更のたびに、レビューで変更履歴を活用し、何が変わったか、次に何を自動化すべきかを確認してください。
ワークショップでエージェントがこの手順を実行する様子を見る
次にノードが残ったときは、設定に触れる前にイベントを読んでください。エージェントは最初のステップで役立ちます。イベント、設定、メトリクスを人間よりはるかに速く読めるからです。ただし、尋ねるたびに異なる答えを返すこともあります。だからこそ、すべての変更を人間がレビューし、本番環境では、エージェントではなく固定のルールが変更を適用すべきなのです。
ワークショップ Agentic Karpenter: Using kagent + Claude to Tune Your Autoscaling は、2026年11月17日午前11時(米国東部時間)に開催されます。Vikram SeshadriとRamesh Mathikumarが、エージェントがこうしたイベントを読み取ってdiffの下書きを作成する方法と、どこから固定ルールに引き継ぐかを紹介します。ワークショップに登録する。
稼働し続けるノードにお困りですか?私たちのチームが、阻害要因の特定、変更のレビュー、そして信頼性を損なわないキャパシティの回収をお手伝いします。専門家に相談するか、無料で登録してご自身でお試しください。