

Riduci un Deployment da 12 pod a 3 e ora un nodo di grandi dimensioni è quasi vuoto. Nel nostro sandbox, con un tempo di attesa di un minuto, Karpenter sostituisce quel nodo con uno più piccolo in circa 80 secondi. A volte però non lo fa, e il nodo grande continua a girare e a costarti denaro.
Se ti chiedi perché Karpenter non consolida i tuoi nodi, parti dagli eventi. Karpenter scrive un evento quando salta un nodo, e l'evento di solito indica la causa.
Un evento indica una causa, ma non ti dà la soluzione. Un PodDisruptionBudget (PDB), un'annotazione su un pod, un disruption budget e una regola di posizionamento possono ciascuno tenere in esecuzione un nodo, e ognuno di questi elementi appartiene a un team diverso. Chi legge l'evento non è sempre chi può intervenire sulla causa.
Segui invece un percorso fisso. Leggi l'evento, confermalo con un comando, scrivi la modifica più piccola possibile sotto forma di diff e fai revisionare quel diff prima che qualcuno lo applichi. Chiamiamo questo percorso "dall'evento al diff". Un diff mostra solo le righe che cambiano.
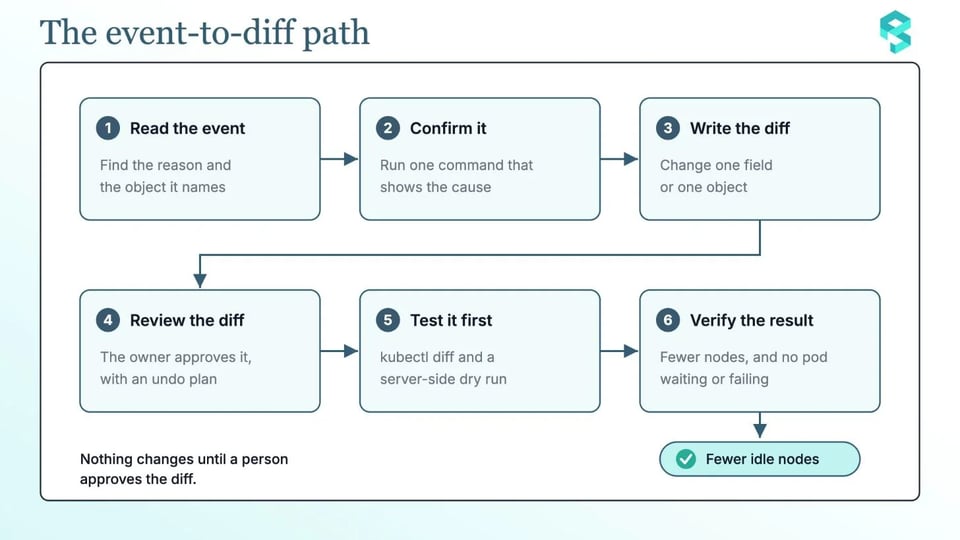
Questo articolo segue il percorso con quattro casi che puoi incontrare nei tuoi cluster:
- Un disruption budget che non consente alcuna disruption
- Un'annotazione do-not-disrupt
- Un PDB senza margine
- Pod che non possono girare su un altro nodo
Gli esempi usano Karpenter v1.15 su AWS. Utilizzano un piccolo sandbox: un NodePool chiamato workshop e un Deployment chiamato inflate nel namespace sandbox.
Cosa fa Karpenter di default
Karpenter può rimuovere un nodo in due modi. Se tutti i pod trovano posto nella capacità libera degli altri nodi, elimina il nodo. Se trovano posto nella capacità libera più un nodo di prezzo inferiore, sostituisce il nodo.
Un NodePool che non imposta nient'altro riceve consolidationPolicy: WhenEmptyOrUnderutilized e consolidateAfter: 0s. Riceve anche un budget che consente a Karpenter di applicare la disruption al 10% dei nodi alla volta.
Per ogni disruption volontaria, Karpenter segue gli stessi sei passaggi:
- Sceglie i nodi candidati. Karpenter ignora un nodo che ospita pod che non possono essere evicted, e riprova con quel nodo più tardi.
- Verifica che la disruption non violi il budget del NodePool.
- Simula lo scheduling dei pod presenti sul nodo, per capire se servono nodi sostitutivi.
- Aggiunge il taint
karpenter.sh/disrupted:NoSchedule, così nessun nuovo pod parte sul nodo. - Avvia i nodi sostitutivi, se la simulazione li richiede, e attende che siano pronti.
- Elimina il nodo. Il processo di terminazione esegue il drain del nodo tramite la Eviction API di Kubernetes, quindi rispetta i PDB. Ignora i pod statici, i pod che tollerano il taint e i pod completati con successo o falliti.
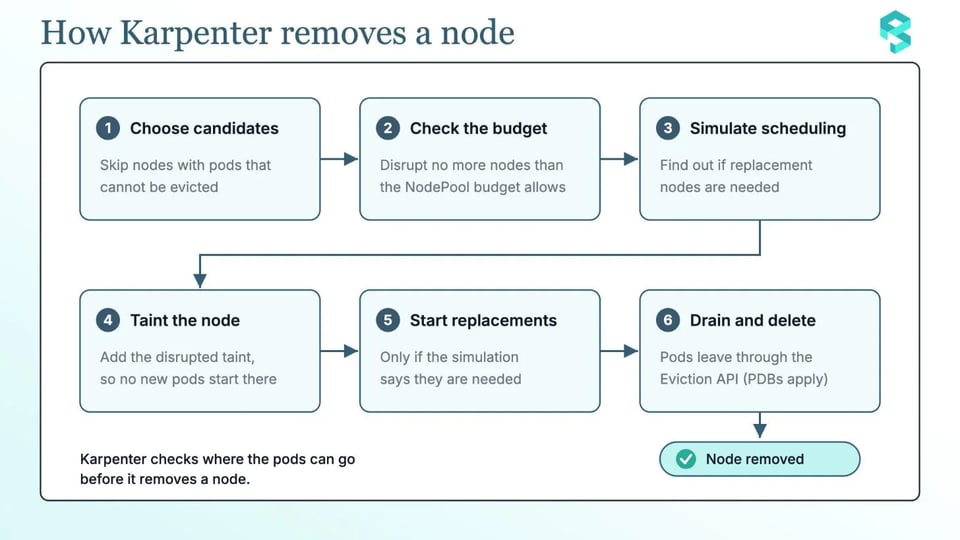
Un nodo resta attivo quando Karpenter si ferma a uno di questi passaggi, e gli eventi ti dicono quale. I budget e l'annotazione do-not-disrupt influiscono solo sulla disruption volontaria. La scadenza (expiration), l'interruzione e l'eliminazione manuale li ignorano.
Leggi prima gli eventi
Karpenter scrive un evento quando salta un nodo, e il motivo ti dice che tipo di problema hai. Unconsolidatable significa che il consolidamento non è applicabile al nodo. DisruptionBlocked significa che qualcosa blocca la disruption: un PDB, un'annotazione su un pod o su un nodo, oppure un budget sul NodePool.
Gli eventi del nodo compaiono sul nodo e sul suo NodeClaim. Gli eventi del budget compaiono sul NodePool, non sul nodo. Questi comandi raccolgono gli eventi per un nodo, il suo NodeClaim, il suo NodePool e l'intero cluster. Sostituisci $NODE, $NODECLAIM e $NODEPOOL con i tuoi nomi:
kubectl describe node $NODEkubectl describe nodeclaim $NODECLAIMkubectl describe nodepool $NODEPOOLkubectl get events -A --field-selector reason=Unconsolidatable --sort-by=.lastTimestampkubectl get events -A --field-selector reason=DisruptionBlocked --sort-by=.lastTimestampIn Karpenter v1.15, i messaggi per i quattro casi sono questi:
| Messaggio | Cosa significa | Come confermarlo |
|---|---|---|
No allowed disruptions for disruption reason Underutilized due to blocking budget |
Un budget non consente alcuna disruption in questo momento. Questo evento è sul NodePool. | La sezione disruption del NodePool |
Pod has "karpenter.sh/do-not-disrupt" annotation (Pod=<namespace>/<name>) |
Un pod sul nodo porta l'annotazione. | Le annotazioni dei pod sul nodo |
Pdb prevents pod evictions (PodDisruptionBudget=[<namespace>/<name>]) |
Un PDB non ha margine per un pod sul nodo. | Il valore ALLOWED di ogni PDB |
Can't replace with a cheaper node |
Karpenter non ha trovato un nodo più economico in grado di ospitare i pod. | Le request dei pod, i requirement del NodePool e i limiti del NodePool |
Altri due messaggi puntano alle impostazioni del NodePool. NodePool "<name>" has consolidation disabled significa che consolidateAfter è Never. NodePool "<name>" has consolidation policy WhenEmpty, but node is not empty significa che la policy considera solo i nodi vuoti. Sui nodi Spot, Karpenter sostituisce un nodo solo quando il feature gate SpotToSpotConsolidation è attivo.
Ora puoi seguire il percorso con ciascun caso, uno alla volta:
Caso 1: un budget che non consente alcuna disruption
Qui la prova si trova sul NodePool, non sul nodo. Il NodePool ha un evento DisruptionBlocked che dice No allowed disruptions for disruption reason Underutilized due to blocking budget.
Per confermarlo, leggi la sezione disruption del NodePool:
kubectl get nodepool $NODEPOOL -o jsonpath='{.spec.disruption}{"\n"}'Cerca nodes: '0', oppure un budget con uno schedule e una duration attivi in questo momento. Un budget con nodes: '0' e senza reasons blocca tutte le disruption volontarie. Quando un NodePool ha più budget, Karpenter usa il risultato più basso.
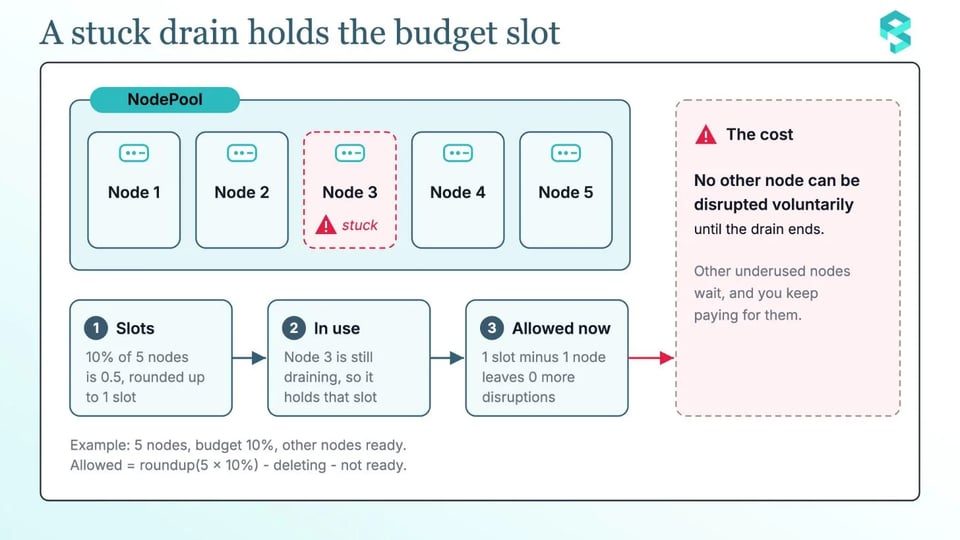
Karpenter conta anche i nodi già in fase di eliminazione. Per una percentuale, calcola le disruption consentite così:
| consentite = roundup(totale x percentuale) - in eliminazione - non pronti |
|---|
Con 5 nodi e un budget del 10%, il risultato è 1. Ora immagina che un nodo sia bloccato durante un drain. Quel nodo occupa lo slot, quindi il budget consente 0 ulteriori disruption finché il drain non termina.
Un budget a zero permanente blocca troppo. Scegli invece una finestra che corrisponda alle tue ore di punta. Questa è attiva nei giorni feriali dalle 09:00 UTC per 8 ore, e il primo budget mantiene il limite normale per il resto del tempo:
spec: disruption: budgets:- - nodes: '0'+ - nodes: 10%+ - nodes: '0'+ schedule: '0 9 * * mon-fri'+ duration: 8h+ reasons:+ - UnderutilizedIl blocco ora ferma solo la rimozione dei nodi sottoutilizzati, e solo all'interno della finestra. Karpenter interpreta sempre uno schedule in UTC.
Caso 2: un'annotazione do-not-disrupt
La prova si trova sul nodo e sul suo NodeClaim. L'evento DisruptionBlocked dice Pod has "karpenter.sh/do-not-disrupt" annotation (Pod=<namespace>/<name>). Quando è il nodo stesso a portare l'annotazione, il messaggio è Disruption is blocked through the "karpenter.sh/do-not-disrupt" annotation.
Per trovare l'annotazione, elenca i pod e i nodi che la portano. Questi comandi usano jq:
kubectl get pods -A -o json | jq -r '.items[] | select(.metadata.annotations["karpenter.sh/do-not-disrupt"] != null) | "\(.metadata.namespace)/\(.metadata.name) node=\(.spec.nodeName) value=\(.metadata.annotations["karpenter.sh/do-not-disrupt"])"'
kubectl get nodes -o json | jq -r '.items[] | select(.metadata.annotations["karpenter.sh/do-not-disrupt"] != null) | .metadata.name'
Il valore "true" protegge un pod in modo permanente. Una durata come "30m" lo protegge per quel periodo a partire dal momento in cui entra in esecuzione. L'annotazione funziona come un PDB per un singolo pod: blocca il consolidamento e blocca il drift, a meno che il NodePool non imposti terminationGracePeriod.
In una revisione, una durata è più facile da difendere di un valore permanente, perché dichiara per quanto tempo il pod ha davvero bisogno di protezione. Se il team applicativo concorda che il pod possa spostarsi dopo 30 minuti, cambia il valore da "true" a una durata:
template: metadata: annotations:- karpenter.sh/do-not-disrupt: "true"+ karpenter.sh/do-not-disrupt: "30m"Caso 3: un PDB senza margine
La prova si trova sul nodo e sul suo NodeClaim. L'evento DisruptionBlocked dice Pdb prevents pod evictions (PodDisruptionBudget=[<namespace>/<name>]).
Per confermarlo, elenca ogni PDB con le disruption consentite:
kubectl get pdb -A -o custom-columns='NAMESPACE:.metadata.namespace,NAME:.metadata.name,MIN:.spec.minAvailable,MAXUNAVAIL:.spec.maxUnavailable,ALLOWED:.status.disruptionsAllowed'Un valore ALLOWED pari a 0 significa che nessun pod coperto da quel PDB può essere evicted in questo momento. Se imposti maxUnavailable a 0, o minAvailable al 100% o al numero di repliche, richiedi zero eviction volontarie, e un drain del nodo non si completa mai.
Karpenter ha bisogno che il PDB che seleziona un pod consenta l'eviction. Un pod dovrebbe avere un solo PDB. Se due PDB selezionano lo stesso pod, Kubernetes rifiuta di eseguire l'eviction del pod, anche quando entrambi i PDB hanno margine. In questo caso Karpenter potrebbe non mostrare alcun evento. Le versioni recenti di Kubernetes scrivono un evento MultiplePodDisruptionBudgets sul pod. Quel singolo pod può quindi bloccare l'intero nodo. Anche un pod in esecuzione ma non ready può bloccare un'eviction quando il budget non ha margine.
La soluzione è una piccola modifica. Per un Deployment con 3 repliche, usa maxUnavailable: 1 invece di minAvailable: 3:
spec: minAvailable: 3 maxUnavailable: 1Un PDB può impostare solo uno dei due campi. Kubernetes raccomanda maxUnavailable, perché segue il numero di repliche.
Se un pod in crash loop blocca l'eviction, aggiungi unhealthyPodEvictionPolicy: AlwaysAllow. Questo campo è stabile da Kubernetes v1.31:
spec: maxUnavailable: 1 unhealthyPodEvictionPolicy: AlwaysAllowCaso 4: pod che non possono girare su un altro nodo
Karpenter simula dove possono andare i pod prima di rimuovere un nodo. Se un pod non trova posto da nessun'altra parte, il nodo resta. Gli eventi non sempre indicano quel pod, quindi devi cercarlo nelle spec dei pod.
Per vedere cosa lega ogni pod del nodo alla sua posizione, elenca i dettagli di ogni pod presente sul nodo:
kubectl get pods -A --field-selector spec.nodeName=$NODE -o json | jq '.items[] | {pod: "\(.metadata.namespace)/\(.metadata.name)", owner: (.metadata.ownerReferences[0].kind // "none"), nodeSelector: .spec.nodeSelector, requiredAntiAffinity: (.spec.affinity.podAntiAffinity.requiredDuringSchedulingIgnoredDuringExecution != null), topologySpread: [.spec.topologySpreadConstraints[]? | {key: .topologyKey, maxSkew: .maxSkew, whenUnsatisfiable: .whenUnsatisfiable}], claims: [.spec.volumes[]? | select(.persistentVolumeClaim != null) | .persistentVolumeClaim.claimName]}'Cerca queste cause:
- Una request più grande della capacità libera degli altri nodi.
- Un
nodeSelectorche corrisponde solo a questo gruppo di nodi. - Una regola di anti-affinity obbligatoria (required).
- Una regola di topology spread che gli altri nodi non possono soddisfare.
- Un volume vincolato a una singola zona.
- Un taint sugli altri nodi che il pod non tollera.
Tieni presente anche che le regole di anti-affinity e di topology spread di tipo preferred possono ridurre l'efficacia del consolidamento, perché Karpenter cerca di soddisfarle quando rimuove un nodo. Controlla inoltre i pod senza controller. Non bloccano Karpenter, ma dopo un'eviction nessuno li riavvia.
Parti dalla prima causa. Karpenter posiziona i pod in base alle loro request, non al loro utilizzo. Confronta l'utilizzo reale con le request:
sum by (namespace) (rate(container_cpu_usage_seconds_total{container!=""}[5m]))/sum by (namespace) (kube_pod_container_resource_requests{resource="cpu"})Un rapporto molto inferiore a 1 significa che le request sono troppo grandi. Ogni nodo ospita così meno pod di quanti potrebbe, e paghi per lo spazio vuoto.
Se le prove mostrano una request sovradimensionata, riducila al fabbisogno reale. Cambia solo il valore indicato dalle prove:
resources: requests:- cpu: "4"+ cpu: "2"Dalla prova al diff: revisione prima dell'applicazione
Ogni caso termina con un piccolo diff. Revisiona ogni diff nello stesso modo:
| Caso | L'evento | Come confermarlo | Cosa cambia il diff | Owner |
|---|---|---|---|---|
| Budget | DisruptionBlocked sul NodePool |
kubectl get nodepool con jsonpath |
Una voce del budget | Team di piattaforma |
| Annotazione | DisruptionBlocked sul nodo |
Un filtro jq per pod e nodi |
Il valore di un'annotazione | Team applicativo |
| PDB | DisruptionBlocked sul nodo |
kubectl get pdb -A |
Un campo del PDB | Team applicativo |
| Nessun altro nodo | Unconsolidatable, o nessun evento |
Un filtro jq per il posizionamento dei pod |
Una request o una regola | Team applicativo |
Prima di applicare un diff, poniti queste sei domande:
- Quale evento, campo o annotazione dimostra il blocco?
- Il diff tocca un solo campo o un solo oggetto?
- L'owner di quell'oggetto lo ha approvato?
- Cosa limita quanti nodi possono spostarsi contemporaneamente: un budget o una finestra temporale?
- Come annulli la modifica, e cosa ti segnala che devi annullarla?
- La modifica è stata provata prima su un cluster di test o su un NodePool sandbox?
Poi testa il diff senza applicarlo:
kubectl diff -f workshop-nodepool.yamlkubectl apply --dry-run=server -f workshop-nodepool.yamlIl comando kubectl diff mostra cosa cambierebbe kubectl apply. Il dry run lato server verifica la modifica rispetto all'API reale e non salva nulla. Il comando diff esce con codice 1 quando trova una differenza, quindi uno script lo interpreta come un errore.
Dopo aver applicato il diff, verifica il risultato:
kubectl get nodeclaims -wkubectl get pods -A --field-selector=status.phase!=Running,status.phase!=SucceededIl numero di nodi dovrebbe scendere, e nessun pod dovrebbe restare in attesa o fallire a causa dello spostamento. Il valore ALLOWED di ogni PDB dovrebbe tornare sopra 0 per i servizi che devono spostarsi.
Come può aiutarti PerfectScale
PerfectScale by DoiT non sostituisce questo processo. Aiuta il tuo team a seguire lo stesso percorso con meno lavoro manuale. L'ordine conta. Request dimensionate correttamente offrono al consolidamento più margine di recupero, quindi PerfectScale raccomanda di fare prima il right-sizing dei workloads. Poi puoi ottimizzare il NodePool.
Ecco come PerfectScale può aiutarti:
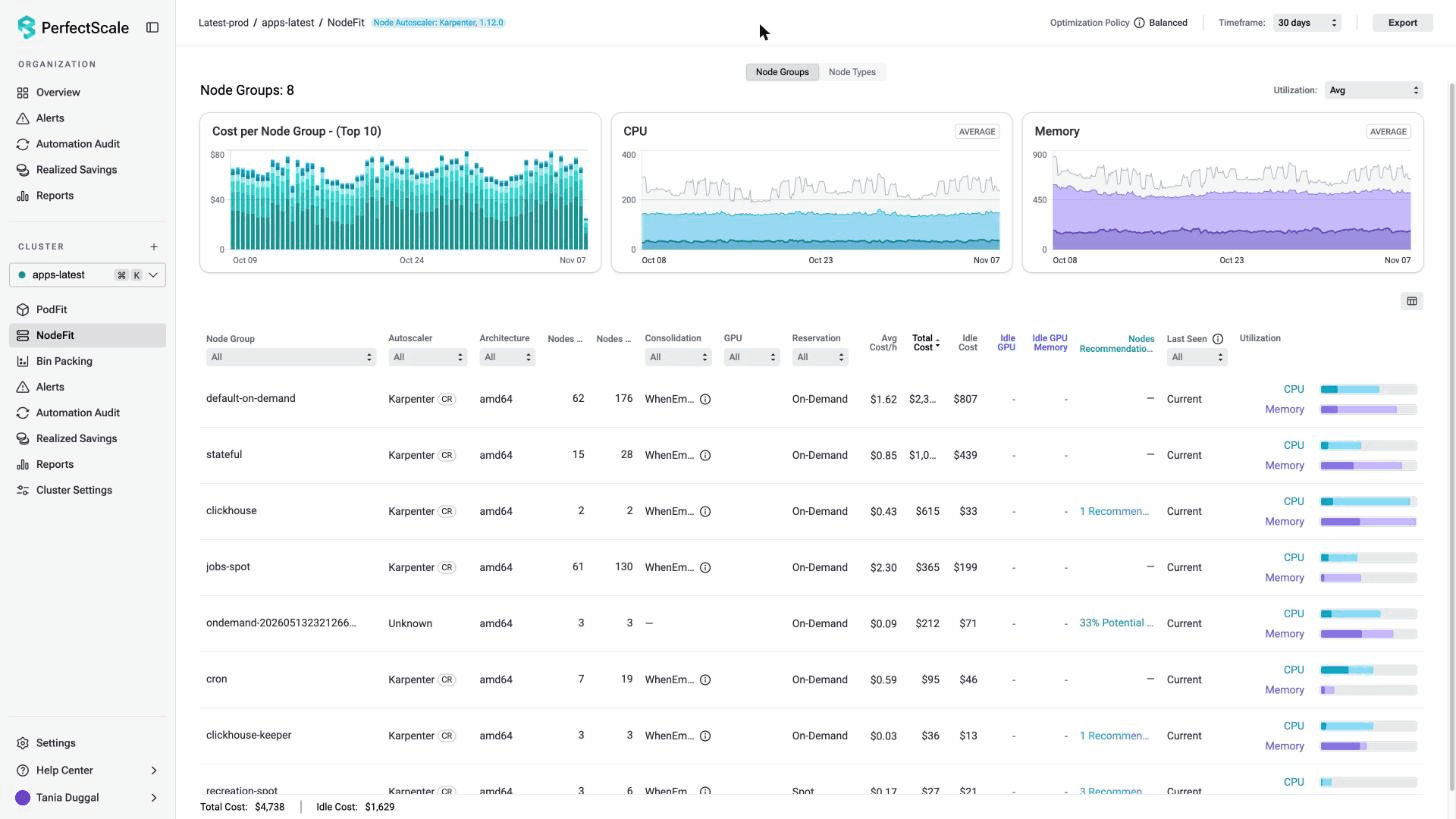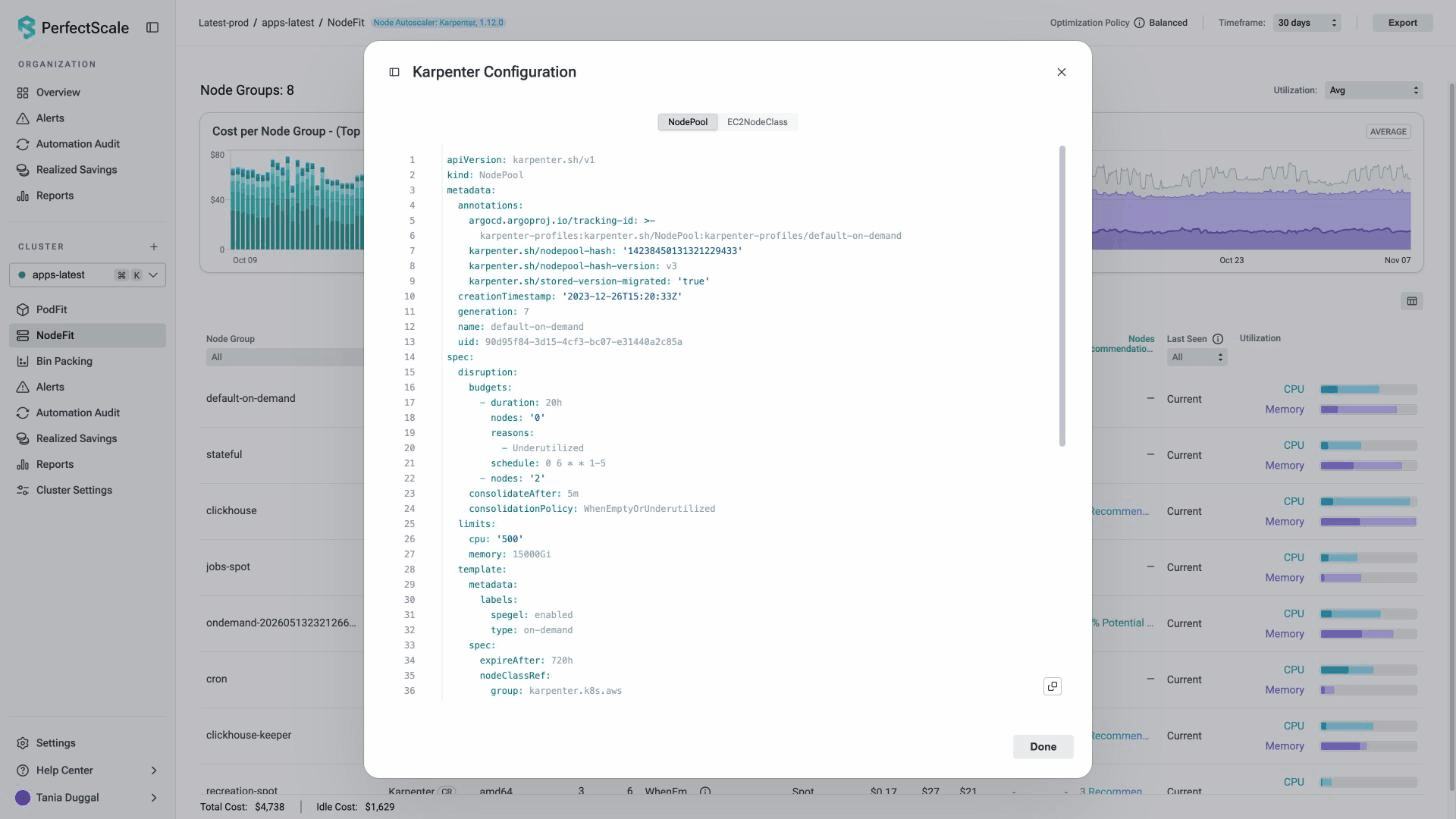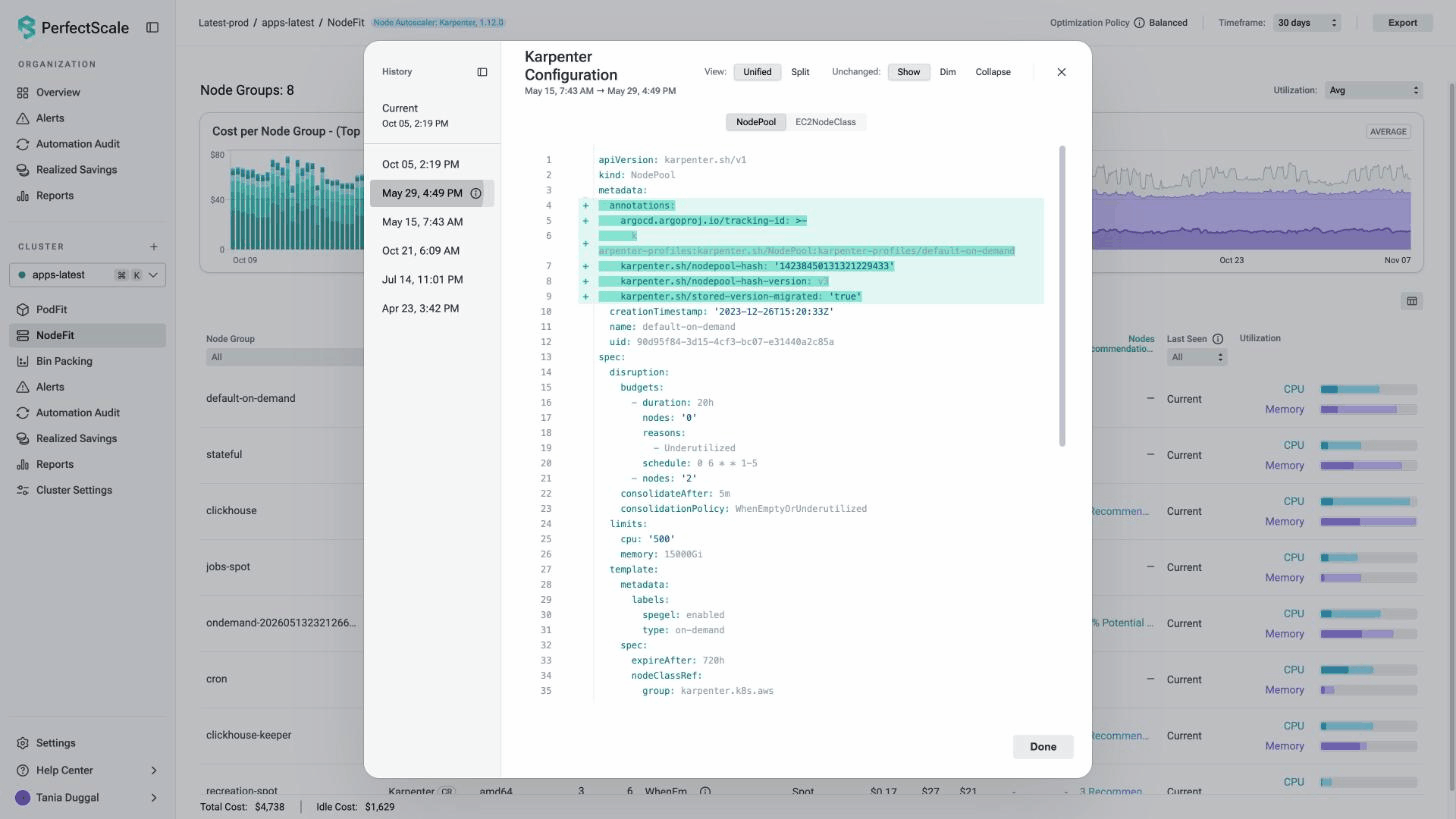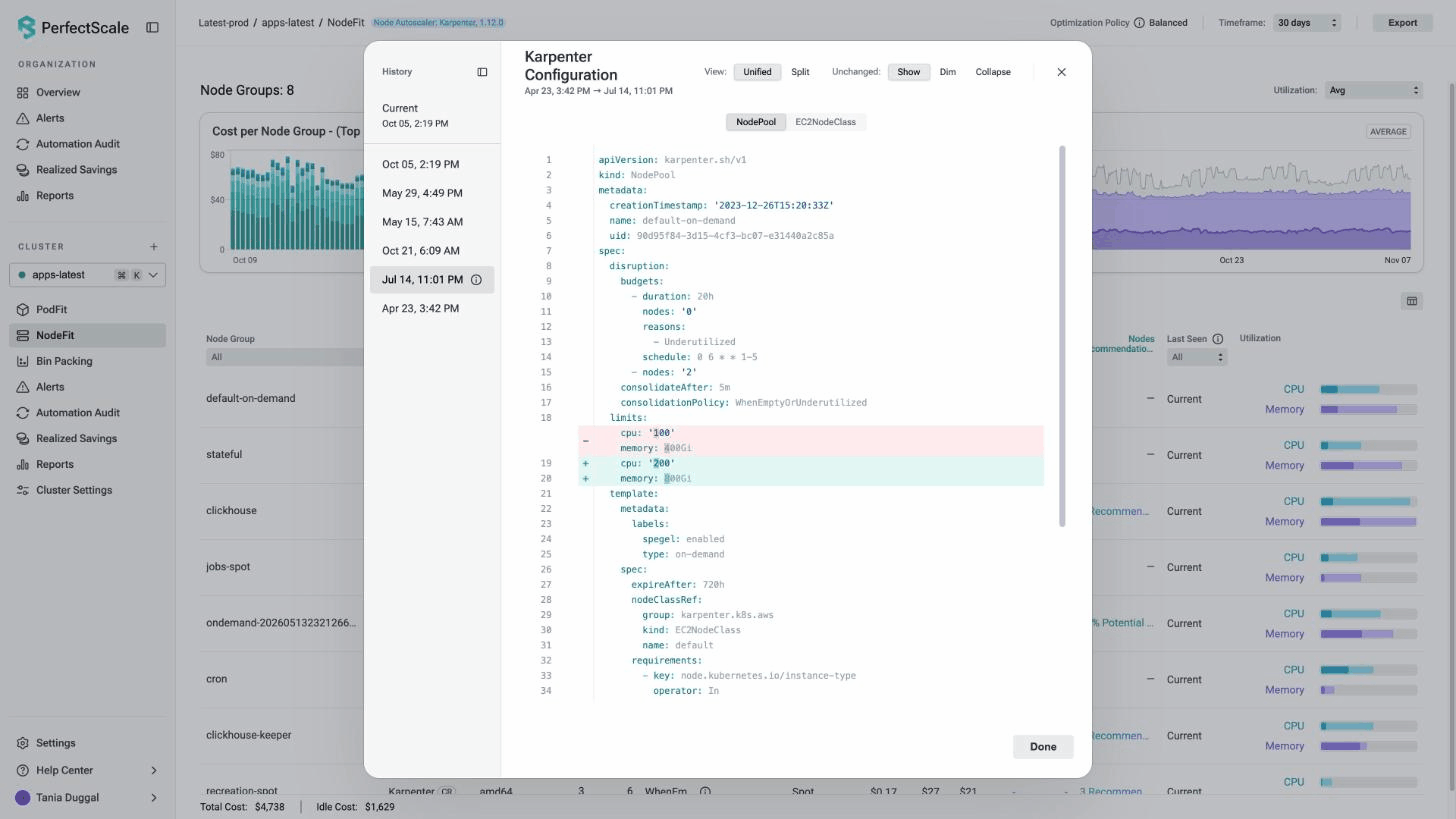
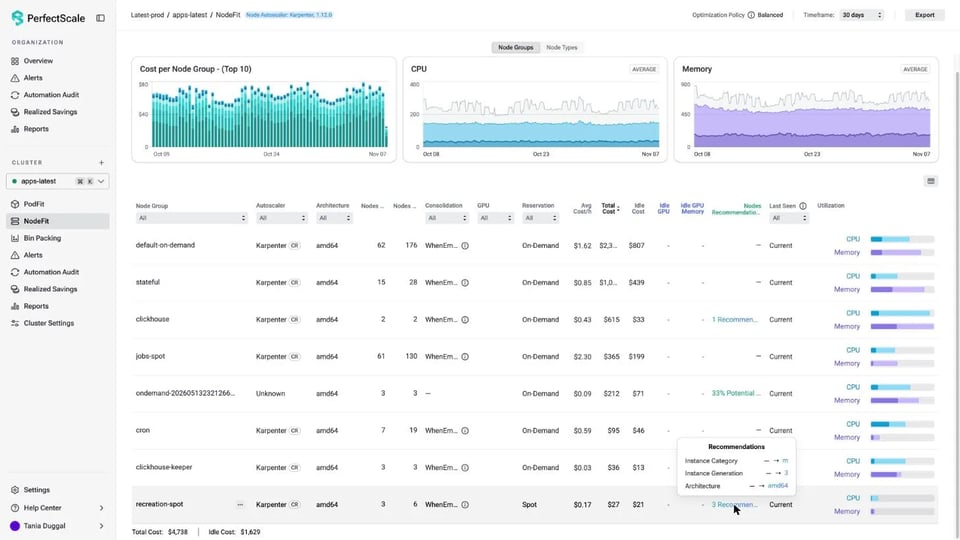
- Vedere la configurazione e ogni sua modifica: le impostazioni di Karpenter cambiano nel tempo, quindi è utile vedere cosa è cambiato e quando. PerfectScale rileva Karpenter nel cluster e mostra la configurazione del NodePool e della node class, con la cronologia delle modifiche.
- Ricevere raccomandazioni per le impostazioni del NodePool: la policy di consolidamento, il tempo di attesa e la scelta delle istanze determinano quanto velocemente Karpenter rimuove i nodi. PerfectScale fornisce raccomandazioni di ottimizzazione per Karpenter per queste impostazioni e per i limiti del NodePool vicini all'esaurimento. Le sue raccomandazioni ti aiutano a:
- Rivedere la policy di consolidamento e il tempo di attesa.
- Dare a Karpenter più opzioni di istanza quando effettua il provisioning di nuovi nodi.
- Individuare i limiti del NodePool che lasciano troppo poco spazio per nuova capacità.
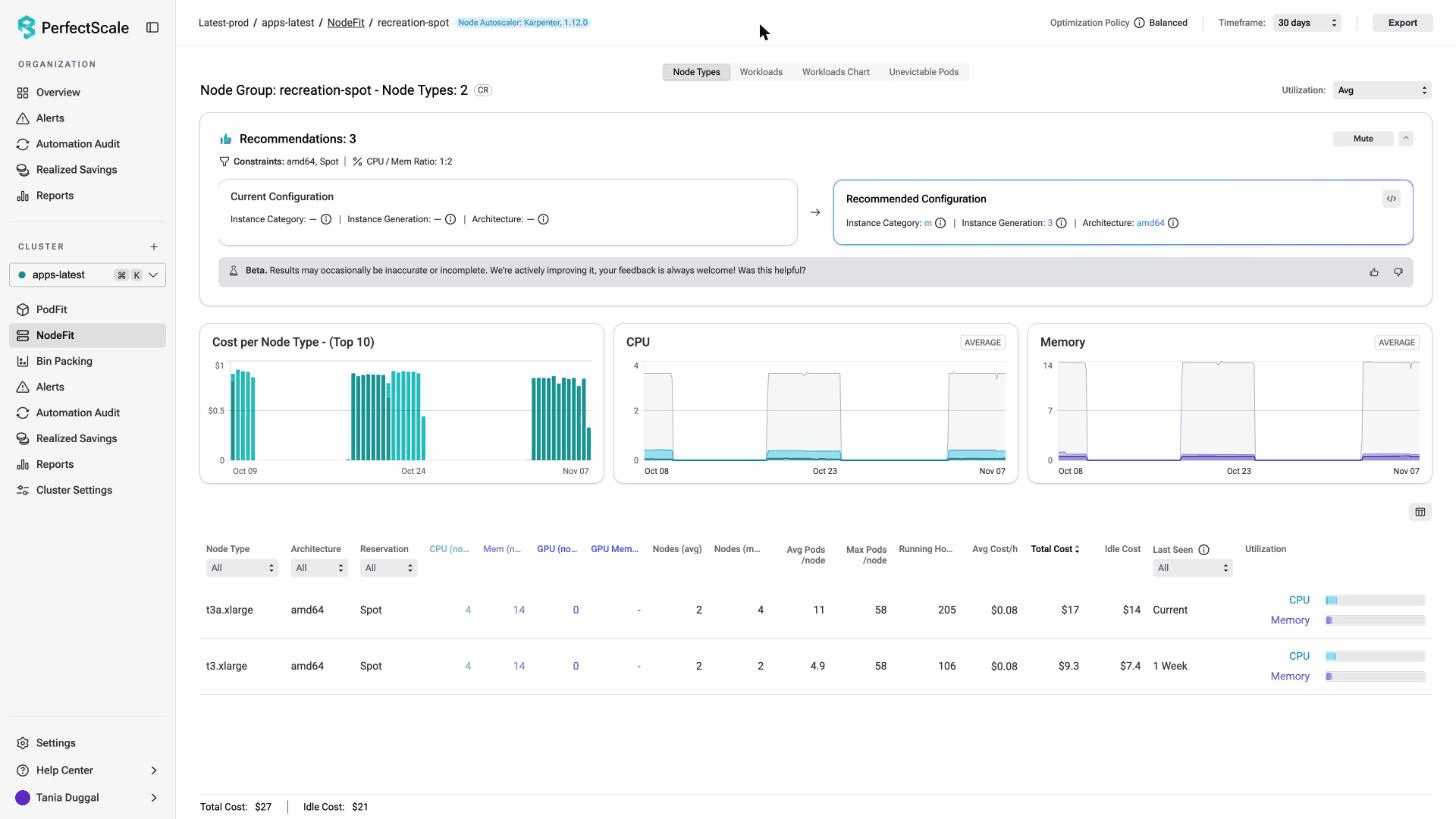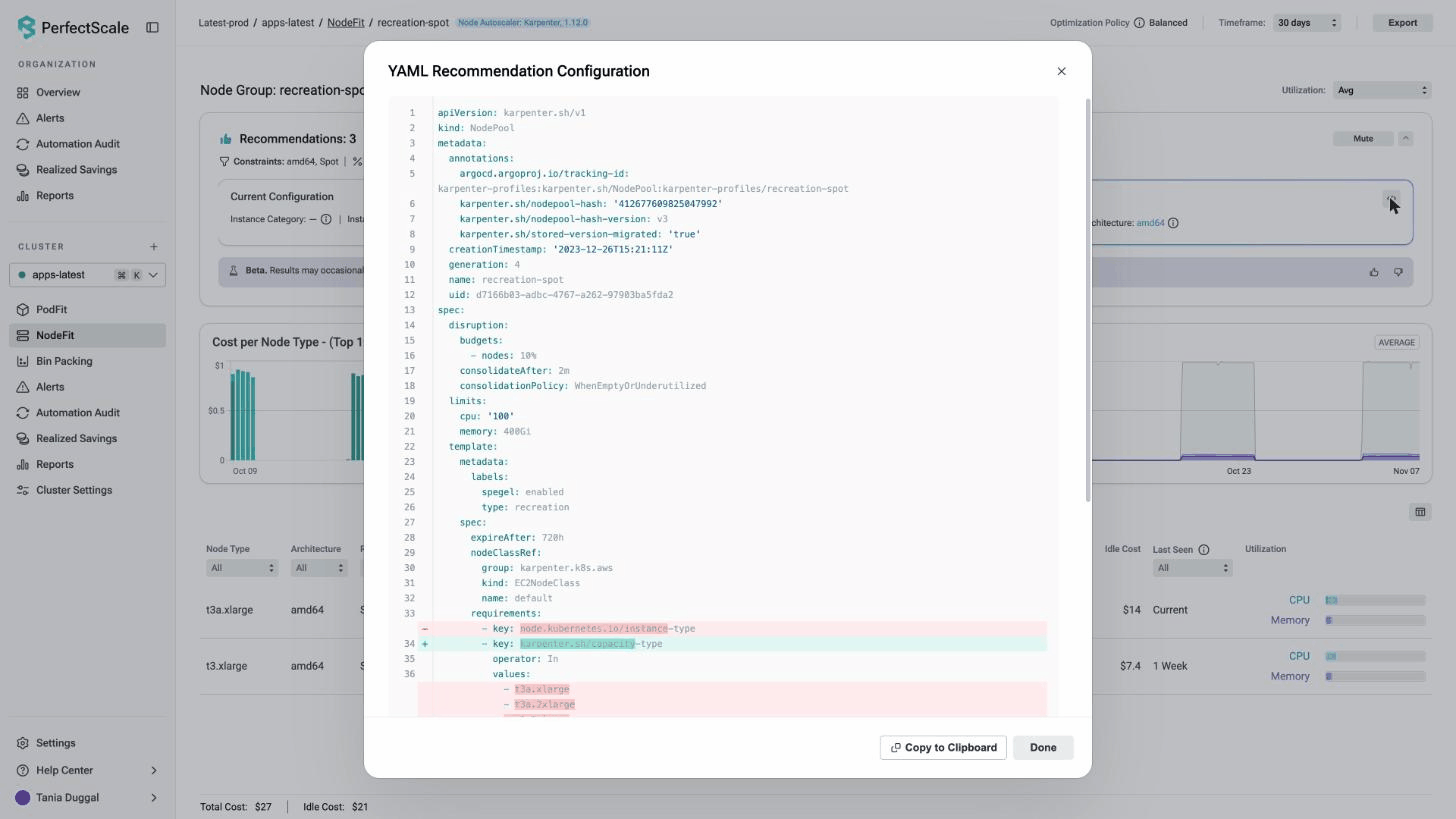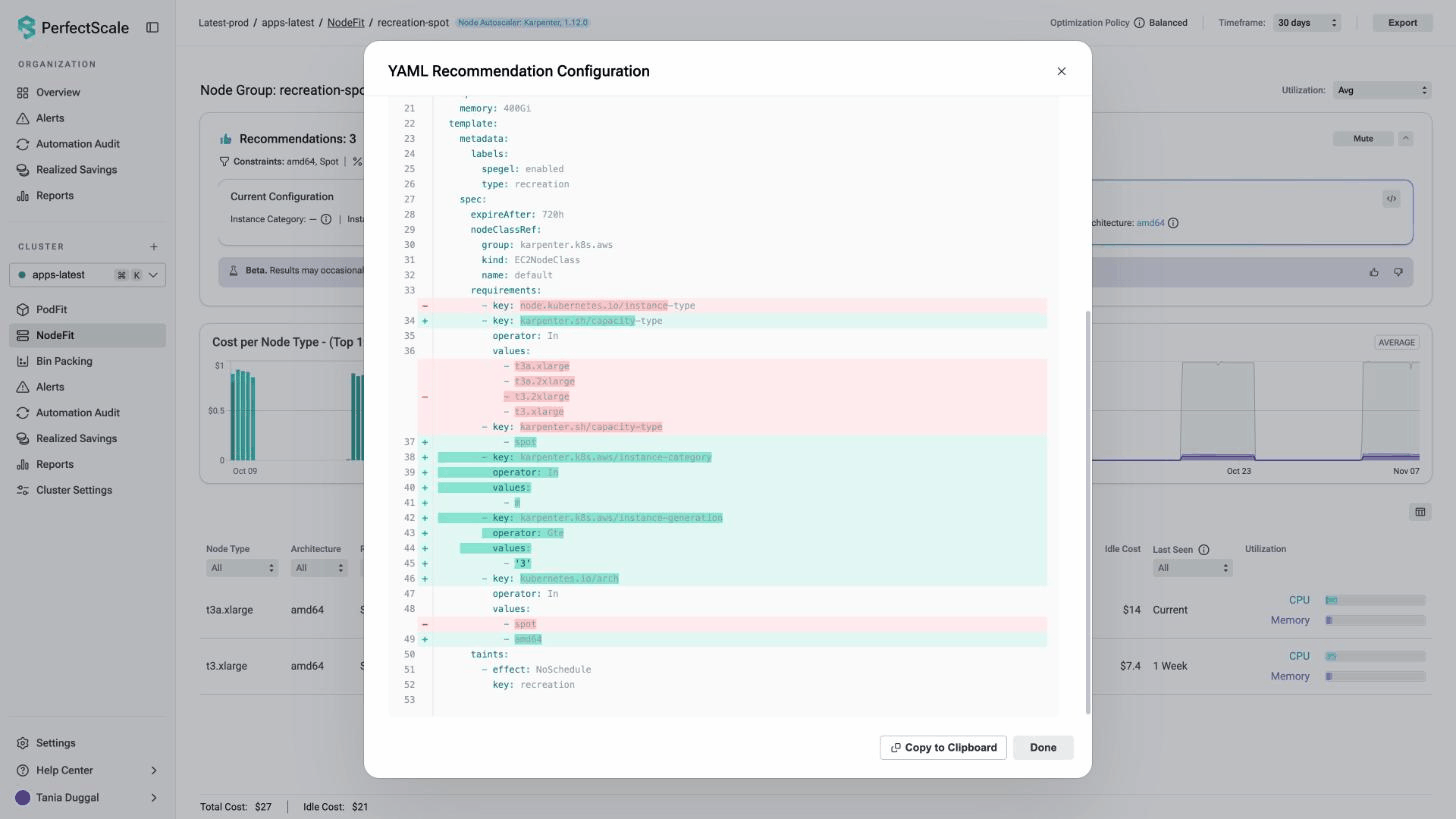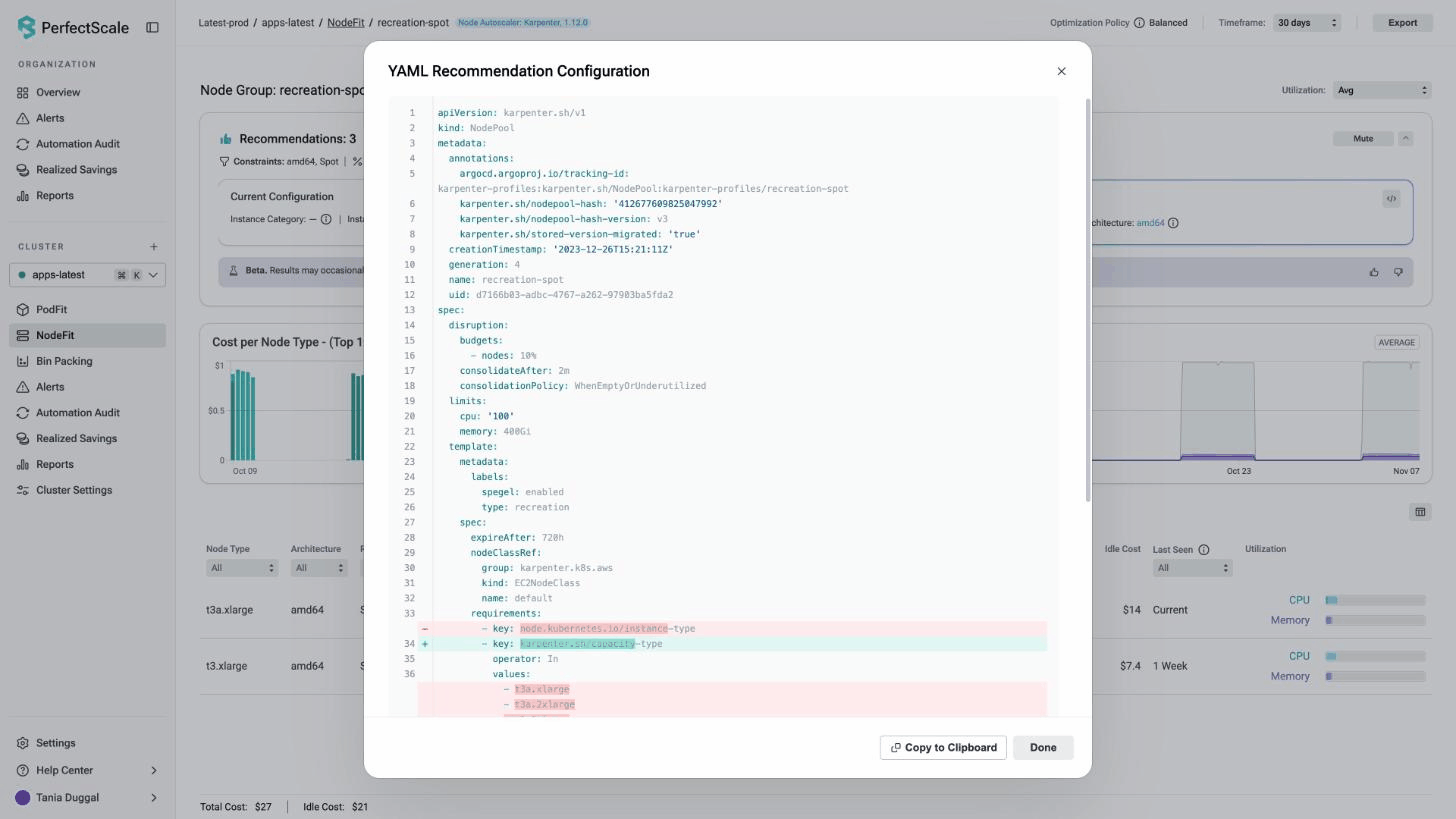
Una vista YAML mostra la configurazione attuale e quella raccomandata, e puoi copiare il risultato.
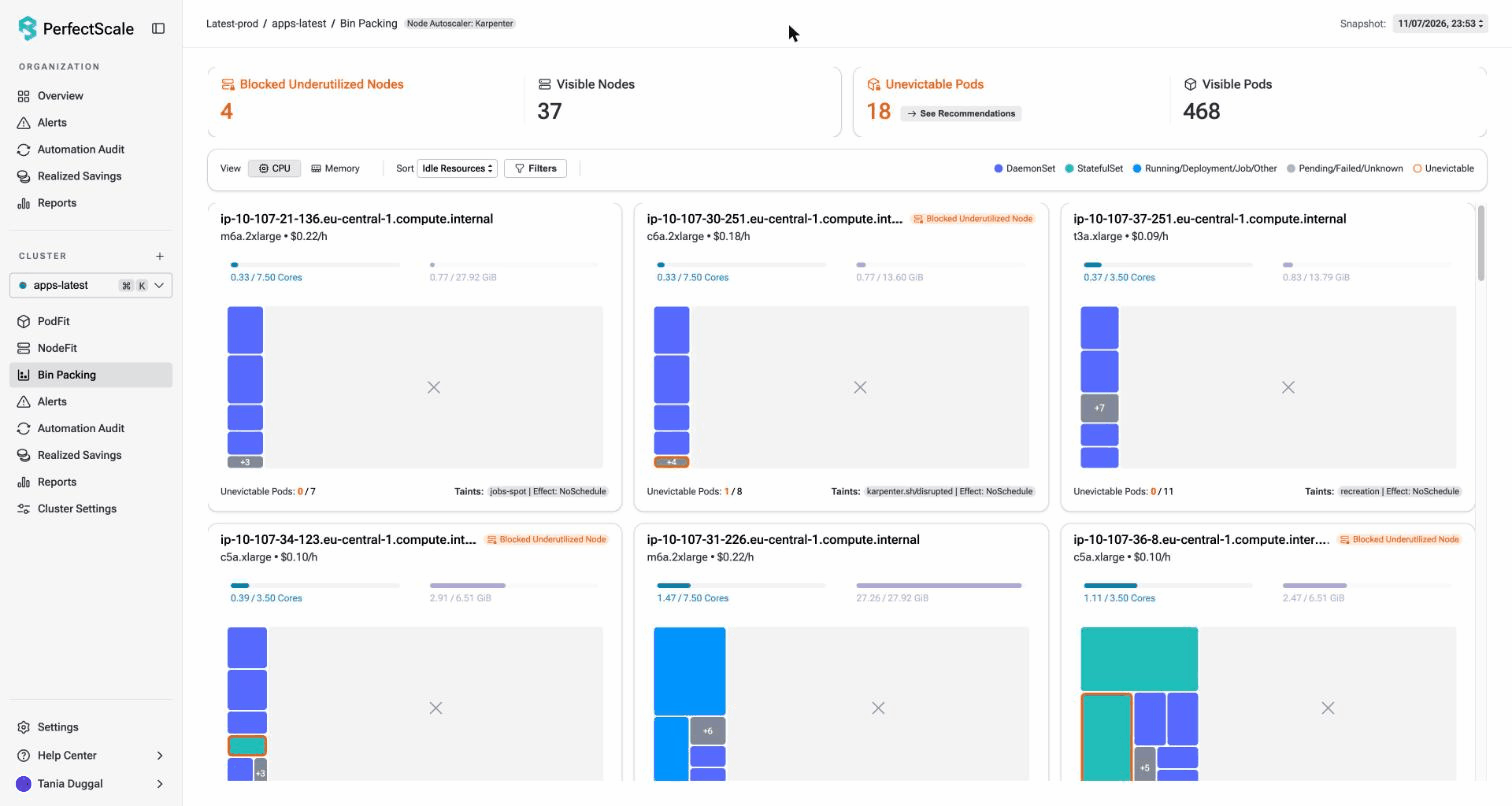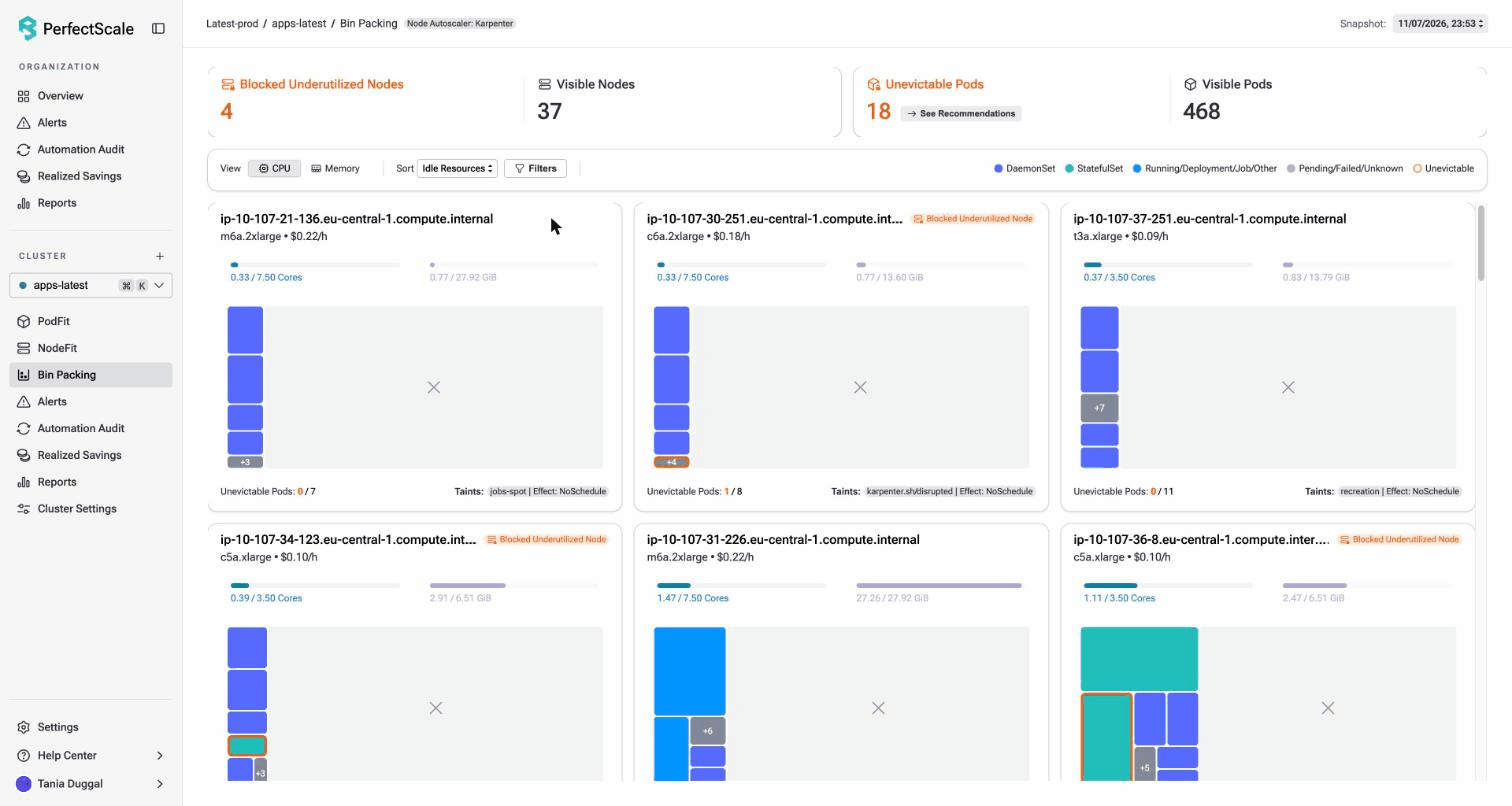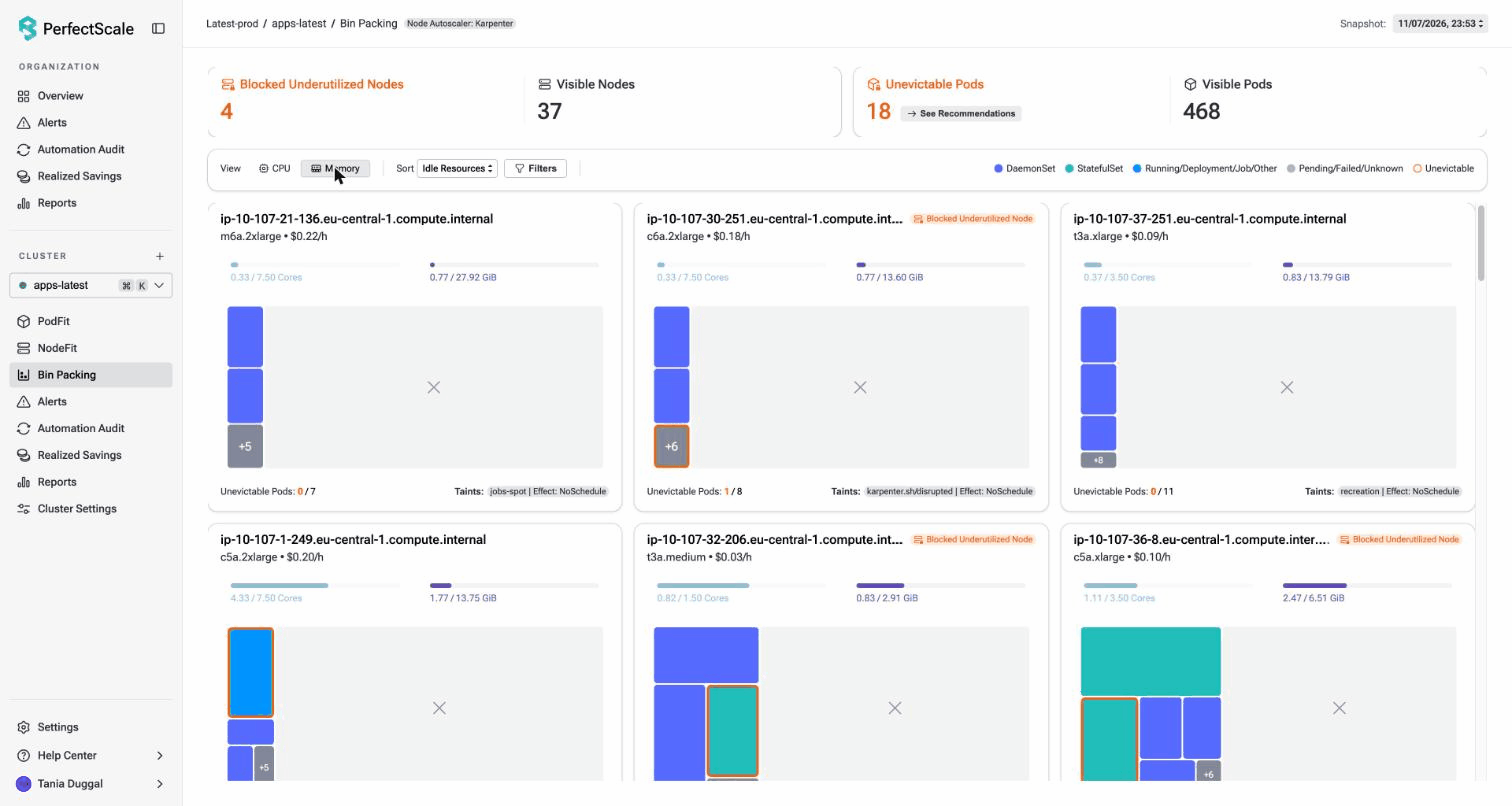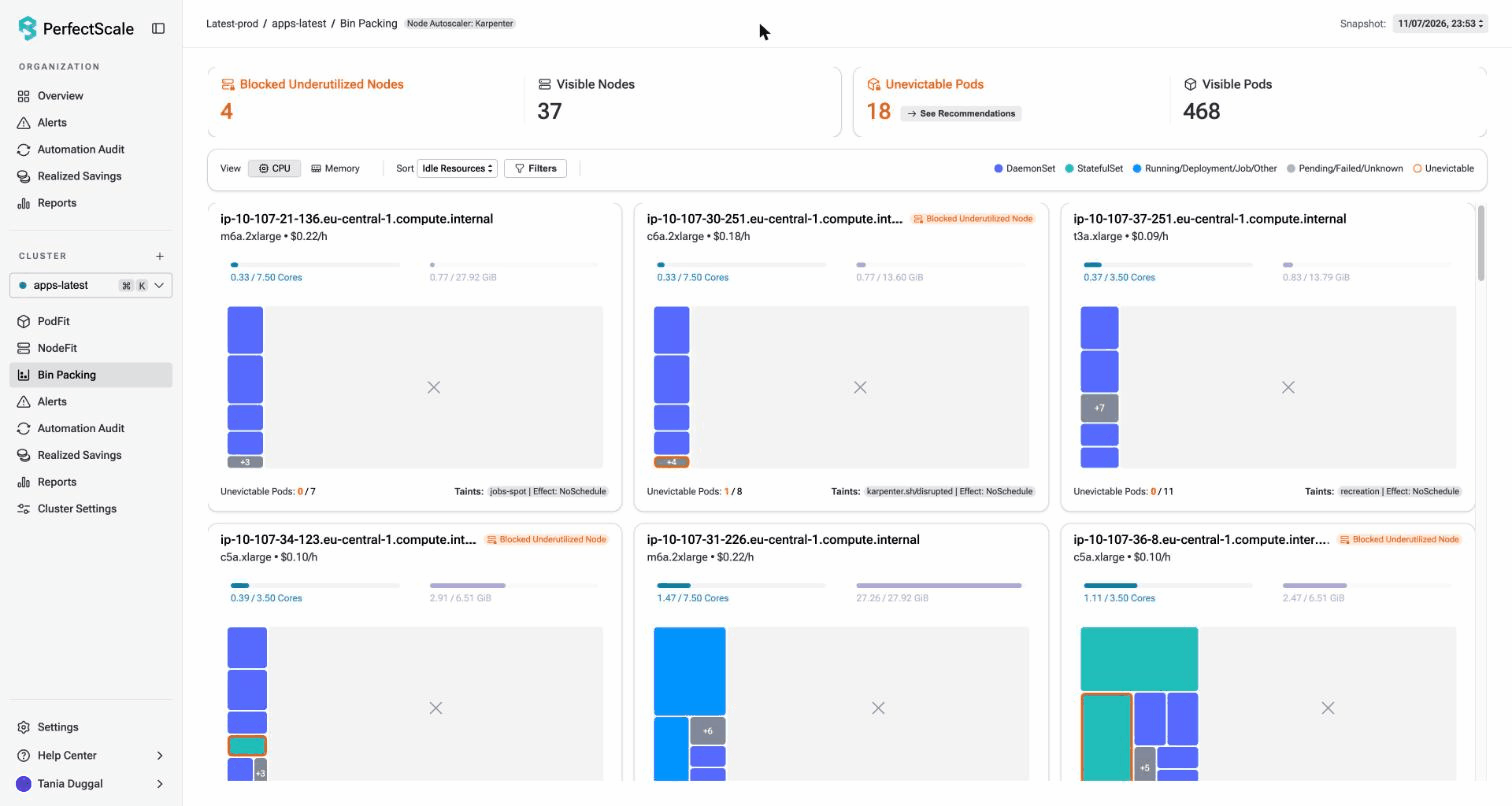
- Trovare i pod che impediscono la rimozione dei nodi: un singolo pod che non può essere evicted può tenere in esecuzione un intero nodo. La vista di bin packing mostra quali pod impediscono la rimozione dei nodi. Fornisce raccomandazioni sotto forma di diff YAML ordinate per impatto sui costi, ognuna con un livello di confidenza e un livello di rischio. Puoi silenziare una segnalazione quando è intenzionale.
Un agente come Claude può inoltre interrogare i dati di PerfectScale con la PerfectScale AI agent skill. Dopo ogni modifica, usa la cronologia delle modifiche nella tua revisione per vedere cosa è cambiato e cosa automatizzare come passo successivo.
Guarda il percorso in azione con un agente nel workshop
La prossima volta che un nodo resta in esecuzione, leggi l'evento prima di toccare qualsiasi impostazione. Un agente può aiutarti nei primi passaggi, perché legge eventi, configurazione e metriche molto più velocemente di te. Può anche dare una risposta diversa ogni volta che glielo chiedi. Ecco perché una persona revisiona ogni modifica, e perché in produzione dovrebbero applicarla regole fisse, non un agente.
Il workshop Agentic Karpenter: Using kagent + Claude to Tune Your Autoscaling si tiene il 17 novembre 2026 alle 11:00 ET. Vikram Seshadri e Ramesh Mathikumar mostrano come un agente legge eventi come questi e prepara la bozza del diff, e dove subentrano le regole fisse. Iscriviti al workshop.
Hai nodi che restano in esecuzione? Il nostro team può aiutarti a individuare il blocco, revisionare la modifica e recuperare capacità senza compromettere l'affidabilità. Parla con i nostri esperti oppure registrati gratuitamente e provalo tu stesso.