

Sie skalieren ein Deployment von 12 Pods auf 3 herunter, und ein großer Node ist nun weitgehend leer. In unserer Sandbox ersetzt Karpenter diesen Node bei einer Wartezeit von einer Minute in etwa 80 Sekunden durch einen kleineren. Manchmal passiert das aber nicht – der große Node läuft weiter und kostet Sie Geld.
Wenn Sie sich fragen, warum Karpenter Ihre Nodes nicht konsolidiert, beginnen Sie mit den Events. Karpenter schreibt ein Event, wenn es einen Node überspringt, und das Event weist in der Regel auf die Ursache hin.
Ein Event benennt eine Ursache, liefert aber nicht die Lösung. Ein PodDisruptionBudget (PDB), eine Pod-Annotation, ein Disruption Budget und eine Platzierungsregel können jeweils einen Node am Laufen halten – und jede dieser Ursachen gehört zu einem anderen Team. Die Person, die das Event liest, ist nicht immer die Person, die die Ursache ändern kann.
Arbeiten Sie stattdessen entlang eines festen Pfads. Lesen Sie das Event, bestätigen Sie es mit einem Befehl, formulieren Sie die kleinstmögliche Änderung als Diff und lassen Sie dieses Diff prüfen, bevor es jemand anwendet. Wir nennen diesen Pfad "vom Event zum Diff". Ein Diff zeigt nur die Zeilen, die sich ändern.
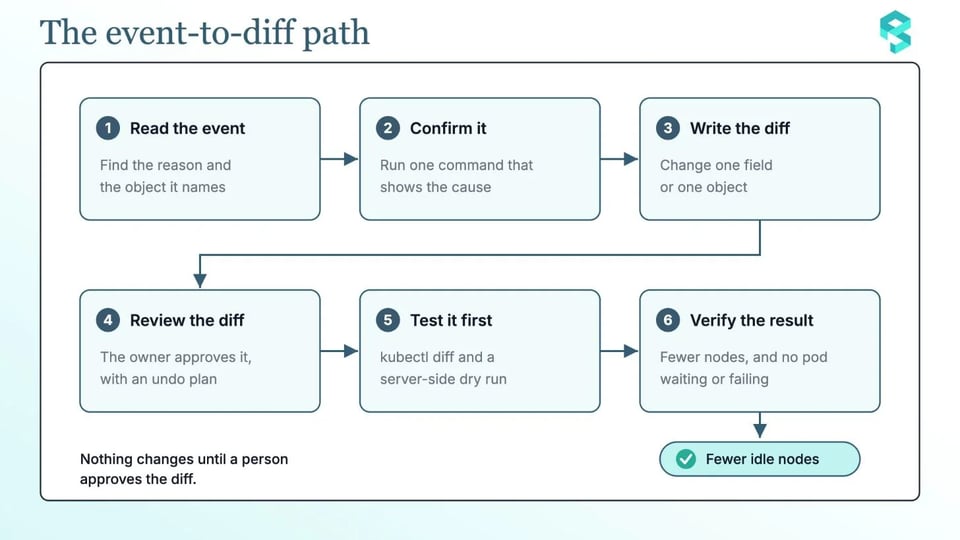
Dieser Artikel folgt dem Pfad anhand von vier Fällen, die Sie in Ihren eigenen Clustern finden können:
- Ein Disruption Budget, das keine Disruption zulässt
- Eine do-not-disrupt-Annotation
- Ein PDB ohne Spielraum
- Pods, die auf keinem anderen Node laufen können
Die Beispiele verwenden Karpenter v1.15 auf AWS. Sie nutzen eine kleine Sandbox: einen NodePool namens workshop und ein Deployment namens inflate im Namespace sandbox.
Was Karpenter standardmäßig tut
Karpenter kann einen Node auf zwei Arten entfernen. Passen alle Pods auf die freie Kapazität anderer Nodes, löscht es den Node. Passen sie auf die freie Kapazität plus einen günstigeren Node, ersetzt es den Node.
Ein NodePool, der sonst nichts festlegt, erhält consolidationPolicy: WhenEmptyOrUnderutilized und consolidateAfter: 0s. Außerdem erhält er ein Budget, das Karpenter die Disruption von 10 % der Nodes gleichzeitig erlaubt.
Bei jeder freiwilligen Disruption folgt Karpenter denselben sechs Schritten:
- Kandidaten-Nodes auswählen. Karpenter ignoriert einen Node mit Pods, die nicht evicted werden können, und versucht es bei diesem Node später erneut.
- Prüfen, dass die Disruption das Budget des NodePools nicht verletzt.
- Das Scheduling der Pods auf dem Node simulieren, um herauszufinden, ob Ersatz-Nodes benötigt werden.
- Den Taint
karpenter.sh/disrupted:NoSchedulehinzufügen, damit keine neuen Pods auf dem Node starten. - Die Ersatz-Nodes starten, falls die Simulation sie benötigt, und warten, bis sie bereit sind.
- Den Node löschen. Der Terminierungsprozess draint den Node über die Kubernetes Eviction API und respektiert daher PDBs. Er ignoriert statische Pods, Pods, die den Taint tolerieren, sowie Pods, die erfolgreich abgeschlossen oder fehlgeschlagen sind.
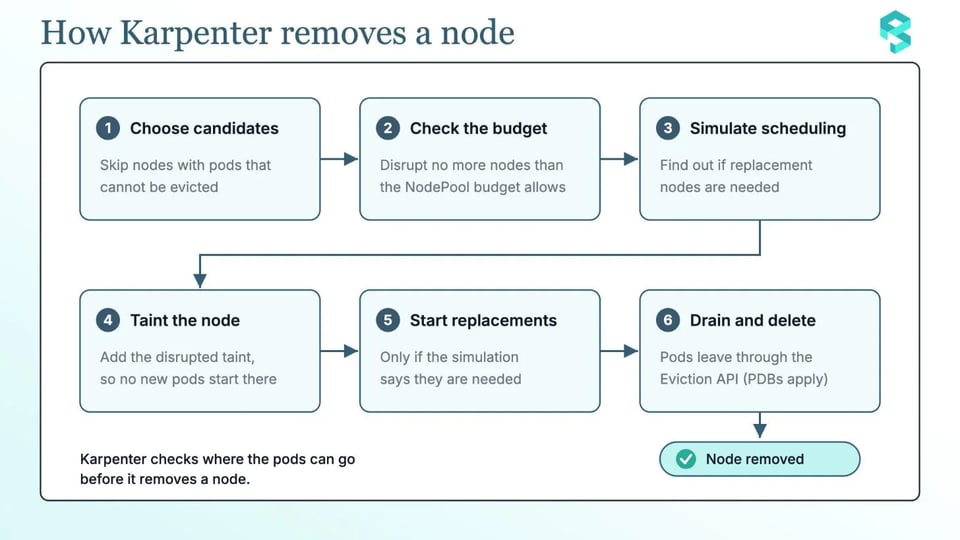
Ein Node bleibt bestehen, wenn Karpenter bei einem dieser Schritte stoppt, und die Events verraten Ihnen, bei welchem. Budgets und die do-not-disrupt-Annotation wirken nur auf freiwillige Disruption. Expiration, Interruption und manuelles Löschen ignorieren sie.
Lesen Sie zuerst die Events
Karpenter schreibt ein Event, wenn es einen Node überspringt, und der Grund verrät Ihnen, welche Art von Problem vorliegt. Unconsolidatable bedeutet, dass die Konsolidierung bei diesem Node nicht greift. DisruptionBlocked bedeutet, dass etwas die Disruption blockiert: ein PDB, eine Annotation auf einem Pod oder Node oder ein Budget auf dem NodePool.
Node-Events erscheinen auf dem Node und auf seinem NodeClaim. Budget-Events erscheinen auf dem NodePool, nicht auf dem Node. Diese Befehle sammeln die Events für einen Node, seinen NodeClaim, seinen NodePool und den gesamten Cluster. Ersetzen Sie $NODE, $NODECLAIM und $NODEPOOL durch Ihre Namen:
kubectl describe node $NODEkubectl describe nodeclaim $NODECLAIMkubectl describe nodepool $NODEPOOLkubectl get events -A --field-selector reason=Unconsolidatable --sort-by=.lastTimestampkubectl get events -A --field-selector reason=DisruptionBlocked --sort-by=.lastTimestampIn Karpenter v1.15 sehen die Meldungen für die vier Fälle so aus:
| Meldung | Bedeutung | Bestätigen mit |
|---|---|---|
No allowed disruptions for disruption reason Underutilized due to blocking budget |
Ein Budget lässt derzeit keine Disruption zu. Dieses Event steht auf dem NodePool. | Dem Disruption-Block des NodePools |
Pod has "karpenter.sh/do-not-disrupt" annotation (Pod=<namespace>/<name>) |
Ein Pod auf dem Node trägt die Annotation. | Den Annotationen der Pods auf dem Node |
Pdb prevents pod evictions (PodDisruptionBudget=[<namespace>/<name>]) |
Ein PDB hat keinen Spielraum für einen Pod auf dem Node. | Dem ALLOWED-Wert jedes PDB |
Can't replace with a cheaper node |
Karpenter hat keinen günstigeren Node gefunden, der die Pods aufnehmen kann. | Den Pod-Requests, den NodePool-Anforderungen und den NodePool-Limits |
Zwei weitere Meldungen verweisen auf NodePool-Einstellungen. NodePool "<name>" has consolidation disabled bedeutet, dass consolidateAfter auf Never steht. NodePool "<name>" has consolidation policy WhenEmpty, but node is not empty bedeutet, dass die Policy nur leere Nodes berücksichtigt. Auf Spot-Nodes ersetzt Karpenter einen Node nur, wenn das Feature Gate SpotToSpotConsolidation aktiviert ist.
Jetzt können Sie den Pfad Fall für Fall durchgehen:
Fall 1: Ein Budget, das keine Disruption zulässt
Den Beleg finden Sie hier am NodePool, nicht am Node. Er trägt ein DisruptionBlocked-Event mit der Meldung No allowed disruptions for disruption reason Underutilized due to blocking budget.
Um das zu bestätigen, lesen Sie den Disruption-Block des NodePools:
kubectl get nodepool $NODEPOOL -o jsonpath='{.spec.disruption}{"\n"}'Achten Sie auf nodes: '0' oder auf ein Budget mit einem schedule und einer duration, das gerade aktiv ist. Ein Budget mit nodes: '0' und ohne reasons blockiert jede freiwillige Disruption. Hat ein NodePool mehrere Budgets, verwendet Karpenter das niedrigste Ergebnis.
Karpenter zählt auch Nodes mit, die bereits gelöscht werden. Bei einem Prozentwert berechnet es die erlaubten Disruptions so:
| erlaubt = roundup(gesamt x Prozentsatz) - in Löschung - nicht bereit |
|---|
Bei 5 Nodes und einem Budget von 10 % ist das Ergebnis 1. Stellen Sie sich nun vor, ein Node steckt in einem Drain fest. Dieser Node belegt den Slot, also erlaubt das Budget 0 weitere Disruptions, bis der Drain abgeschlossen ist.
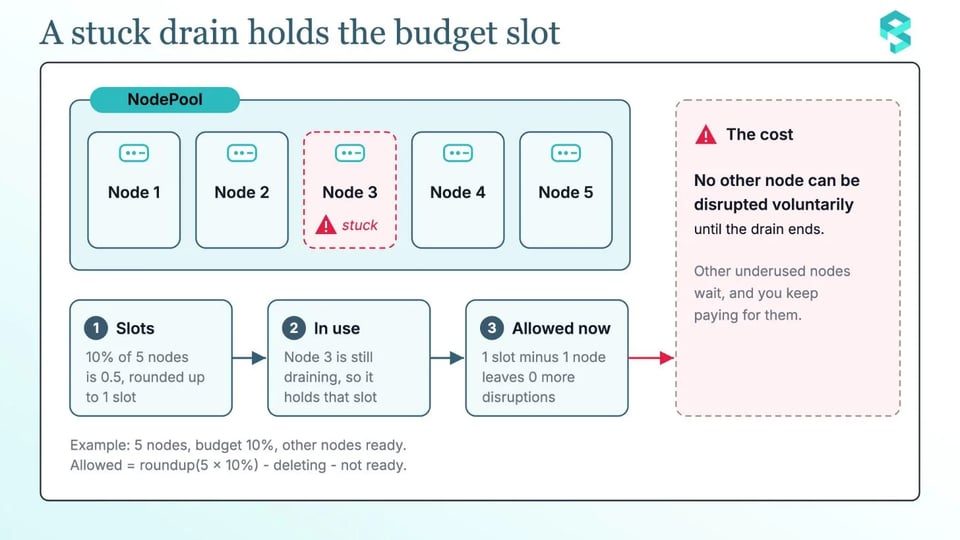
Ein dauerhaftes Null-Budget blockiert mehr als nötig. Wählen Sie stattdessen ein Zeitfenster, das zu Ihren Stoßzeiten passt. Dieses läuft an Wochentagen ab 09:00 UTC für 8 Stunden, und das erste Budget hält für die übrige Zeit das normale Limit:
spec: disruption: budgets:- - nodes: '0'+ - nodes: 10%+ - nodes: '0'+ schedule: '0 9 * * mon-fri'+ duration: 8h+ reasons:+ - UnderutilizedDie Sperre stoppt jetzt nur noch das Entfernen zu wenig ausgelasteter Nodes – und nur innerhalb des Fensters. Karpenter liest einen Schedule immer in UTC.
Fall 2: Eine do-not-disrupt-Annotation
Den Beleg finden Sie am Node und an seinem NodeClaim. Das DisruptionBlocked-Event lautet Pod has "karpenter.sh/do-not-disrupt" annotation (Pod=<namespace>/<name>). Trägt der Node selbst die Annotation, lautet die Meldung Disruption is blocked through the "karpenter.sh/do-not-disrupt" annotation.
Um die Annotation zu finden, listen Sie die Pods und Nodes auf, die sie tragen. Diese Befehle verwenden jq:
kubectl get pods -A -o json | jq -r '.items[] | select(.metadata.annotations["karpenter.sh/do-not-disrupt"] != null) | "\(.metadata.namespace)/\(.metadata.name) node=\(.spec.nodeName) value=\(.metadata.annotations["karpenter.sh/do-not-disrupt"])"'
kubectl get nodes -o json | jq -r '.items[] | select(.metadata.annotations["karpenter.sh/do-not-disrupt"] != null) | .metadata.name'
Der Wert "true" schützt einen Pod dauerhaft. Eine Dauer wie "30m" schützt ihn für diese Zeitspanne, nachdem er gestartet ist. Die Annotation wirkt wie ein PDB für einen einzelnen Pod: Sie blockiert die Konsolidierung, und sie blockiert Drift, sofern der NodePool keine terminationGracePeriod setzt.
Eine Dauer lässt sich in einem Review leichter rechtfertigen als ein dauerhafter Wert, weil sie angibt, wie lange der Pod wirklich Schutz braucht. Wenn das Anwendungsteam zustimmt, dass der Pod nach 30 Minuten verschoben werden darf, ändern Sie den Wert von "true" auf eine Dauer:
template: metadata: annotations:- karpenter.sh/do-not-disrupt: "true"+ karpenter.sh/do-not-disrupt: "30m"Fall 3: Ein PDB ohne Spielraum
Den Beleg finden Sie am Node und an seinem NodeClaim. Das DisruptionBlocked-Event lautet Pdb prevents pod evictions (PodDisruptionBudget=[<namespace>/<name>]).
Um das zu bestätigen, listen Sie jedes PDB mit seinen erlaubten Disruptions auf:
kubectl get pdb -A -o custom-columns='NAMESPACE:.metadata.namespace,NAME:.metadata.name,MIN:.spec.minAvailable,MAXUNAVAIL:.spec.maxUnavailable,ALLOWED:.status.disruptionsAllowed'Ein ALLOWED-Wert von 0 bedeutet, dass derzeit kein Pod, der unter dieses PDB fällt, evicted werden darf. Wenn Sie maxUnavailable auf 0 setzen oder minAvailable auf 100 % oder auf die Anzahl der Replicas, fordern Sie null freiwillige Evictions – und ein Drain des Nodes wird nie abgeschlossen.
Das PDB, das einen Pod selektiert, muss die Eviction zulassen, damit Karpenter fortfahren kann. Ein Pod sollte nur ein PDB haben. Selektieren zwei PDBs denselben Pod, verweigert Kubernetes die Eviction des Pods, selbst wenn beide PDBs Spielraum haben. Karpenter zeigt für diesen Fall möglicherweise kein Event an. Neuere Kubernetes-Versionen schreiben ein MultiplePodDisruptionBudgets-Event auf den Pod. Dieser eine Pod kann dann den gesamten Node blockieren. Auch ein Pod, der läuft, aber nicht bereit ist, kann eine Eviction blockieren, wenn das Budget keinen Spielraum hat.
Die Lösung ist eine kleine Änderung. Verwenden Sie für ein Deployment mit 3 Replicas maxUnavailable: 1 statt minAvailable: 3:
spec: minAvailable: 3 maxUnavailable: 1Ein PDB kann nur eines der beiden Felder setzen. Kubernetes empfiehlt maxUnavailable, weil es der Anzahl der Replicas folgt.
Wenn ein Pod im Crash-Loop die Eviction blockiert, fügen Sie unhealthyPodEvictionPolicy: AlwaysAllow hinzu. Dieses Feld ist seit Kubernetes v1.31 stabil:
spec: maxUnavailable: 1 unhealthyPodEvictionPolicy: AlwaysAllowFall 4: Pods, die auf keinem anderen Node laufen können
Karpenter simuliert, wo die Pods unterkommen können, bevor es einen Node entfernt. Passt ein Pod nirgendwo anders hin, bleibt der Node bestehen. Die Events nennen diesen Pod nicht immer – Sie finden ihn also in den Pod-Spezifikationen.
Um zu sehen, was jeden Pod auf dem Node an seinen Platz bindet, listen Sie die Details aller Pods darauf auf:
kubectl get pods -A --field-selector spec.nodeName=$NODE -o json | jq '.items[] | {pod: "\(.metadata.namespace)/\(.metadata.name)", owner: (.metadata.ownerReferences[0].kind // "none"), nodeSelector: .spec.nodeSelector, requiredAntiAffinity: (.spec.affinity.podAntiAffinity.requiredDuringSchedulingIgnoredDuringExecution != null), topologySpread: [.spec.topologySpreadConstraints[]? | {key: .topologyKey, maxSkew: .maxSkew, whenUnsatisfiable: .whenUnsatisfiable}], claims: [.spec.volumes[]? | select(.persistentVolumeClaim != null) | .persistentVolumeClaim.claimName]}'Achten Sie auf diese Ursachen:
- Ein Request, der größer ist als die freie Kapazität der anderen Nodes.
- Ein
nodeSelector, der nur auf diese Node-Gruppe passt. - Eine zwingende Anti-Affinity-Regel.
- Eine Topology-Spread-Regel, die die anderen Nodes nicht erfüllen können.
- Ein Volume, das an eine Zone gebunden ist.
- Ein Taint auf den anderen Nodes, den der Pod nicht toleriert.
Beachten Sie außerdem, dass bevorzugte Anti-Affinity- und Topology-Spread-Regeln die Wirksamkeit der Konsolidierung verringern können, weil Karpenter versucht, sie beim Entfernen eines Nodes zu erfüllen. Prüfen Sie auch, ob es Pods ohne Controller gibt. Sie blockieren Karpenter nicht, aber nach einer Eviction startet sie nichts neu.
Beginnen Sie mit der ersten Ursache. Karpenter platziert Pods nach ihren Requests, nicht nach ihrer tatsächlichen Nutzung. Vergleichen Sie die reale Nutzung mit den Requests:
sum by (namespace) (rate(container_cpu_usage_seconds_total{container!=""}[5m]))/sum by (namespace) (kube_pod_container_resource_requests{resource="cpu"})Ein Verhältnis weit unter 1 bedeutet, dass die Requests zu groß sind. Jeder Node fasst dann weniger Pods, als er könnte, und Sie zahlen für den ungenutzten Platz.
Belegen die Daten einen überdimensionierten Request, senken Sie ihn auf den tatsächlichen Bedarf. Ändern Sie nur den einen Wert, auf den der Beleg verweist:
resources: requests:- cpu: "4"+ cpu: "2"Vom Beleg zum Diff: Review, bevor jemand die Änderung anwendet
Jeder Fall endet in einem kleinen Diff. Prüfen Sie jedes Diff auf dieselbe Weise:
| Fall | Das Event | Bestätigen mit | Das Diff ändert | Verantwortlich |
|---|---|---|---|---|
| Budget | DisruptionBlocked auf dem NodePool |
kubectl get nodepool mit jsonpath |
Einen Budget-Eintrag | Plattform-Team |
| Annotation | DisruptionBlocked auf dem Node |
Ein jq-Filter für Pods und Nodes |
Einen Annotationswert | Anwendungsteam |
| PDB | DisruptionBlocked auf dem Node |
kubectl get pdb -A |
Ein PDB-Feld | Anwendungsteam |
| Kein anderer Node | Unconsolidatable oder kein Event |
Ein jq-Filter für die Pod-Platzierung |
Einen Request oder eine Regel | Anwendungsteam |
Stellen Sie diese sechs Fragen, bevor Sie ein Diff anwenden:
- Welches Event, welches Feld oder welche Annotation belegt den Blocker?
- Berührt das Diff ein einziges Feld oder ein einziges Objekt?
- Hat der Owner dieses Objekts zugestimmt?
- Was begrenzt, wie viele Nodes gleichzeitig bewegt werden können: ein Budget oder ein Zeitfenster?
- Wie machen Sie die Änderung rückgängig, und woran erkennen Sie, dass Sie das tun sollten?
- Lief die Änderung zuerst auf einem Test-Cluster oder einem Sandbox-NodePool?
Testen Sie das Diff anschließend, ohne es anzuwenden:
kubectl diff -f workshop-nodepool.yamlkubectl apply --dry-run=server -f workshop-nodepool.yamlDer Befehl kubectl diff zeigt, was kubectl apply ändern würde. Der serverseitige Dry Run prüft die Änderung gegen die echte API und speichert nichts. Der diff-Befehl beendet sich mit Exit-Code 1, wenn er einen Unterschied findet – ein Skript wertet das also als Fehler.
Nachdem Sie das Diff angewendet haben, verifizieren Sie das Ergebnis:
kubectl get nodeclaims -wkubectl get pods -A --field-selector=status.phase!=Running,status.phase!=SucceededDie Anzahl der Nodes sollte sinken, und kein Pod sollte wegen des Umzugs warten oder fehlschlagen. Der ALLOWED-Wert jedes PDB sollte für die Services, die umziehen müssen, wieder über 0 liegen.
Wie PerfectScale helfen kann
PerfectScale by DoiT ersetzt diesen Prozess nicht. Es hilft Ihrem Team, denselben Pfad mit weniger manueller Arbeit zu gehen. Die Reihenfolge ist entscheidend. Passend dimensionierte Requests verschaffen der Konsolidierung mehr Einsparpotenzial, deshalb empfiehlt PerfectScale, zuerst das Right-Sizing der Workloads vorzunehmen. Danach können Sie den NodePool feinjustieren.
So hilft Ihnen PerfectScale:
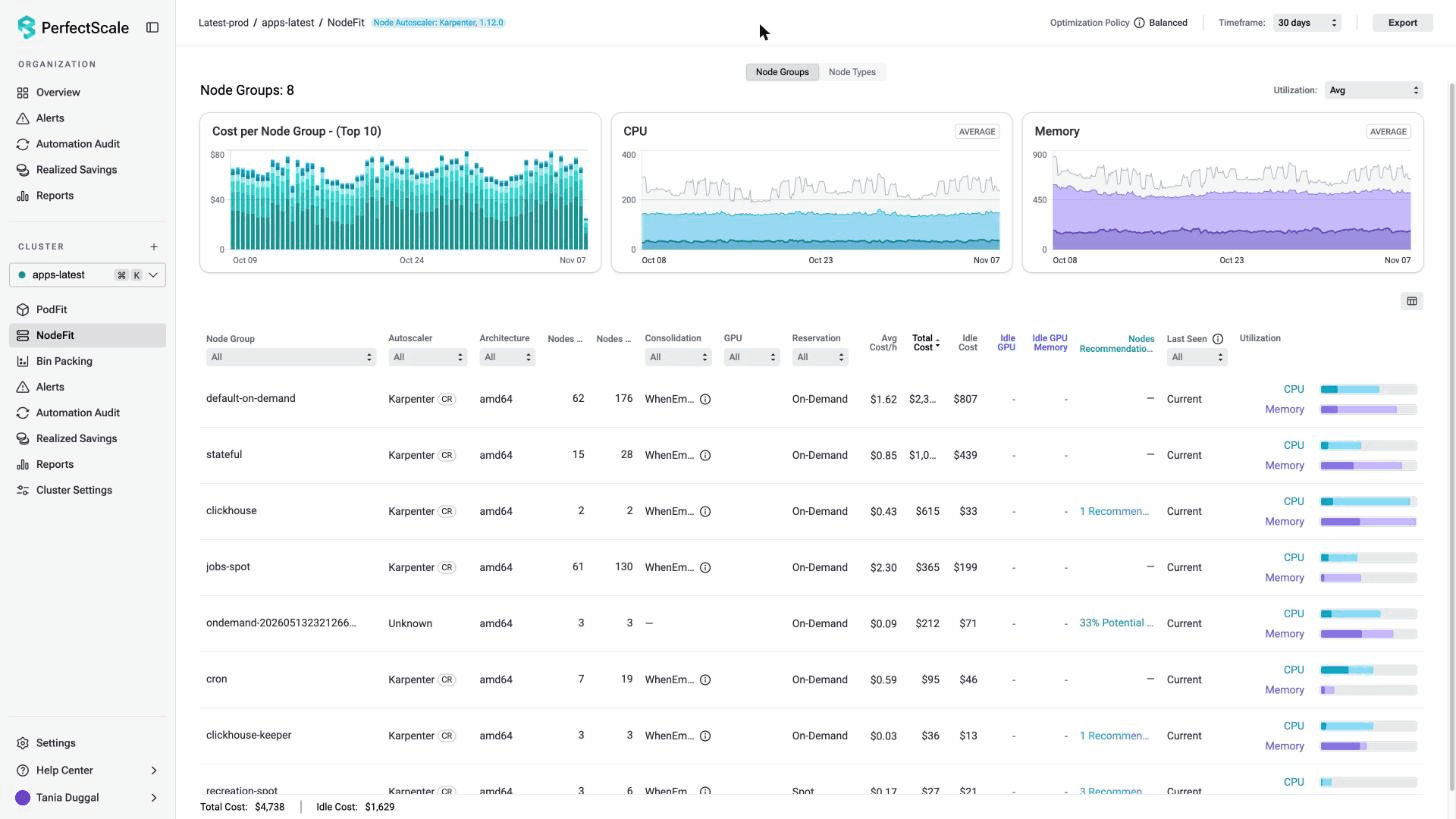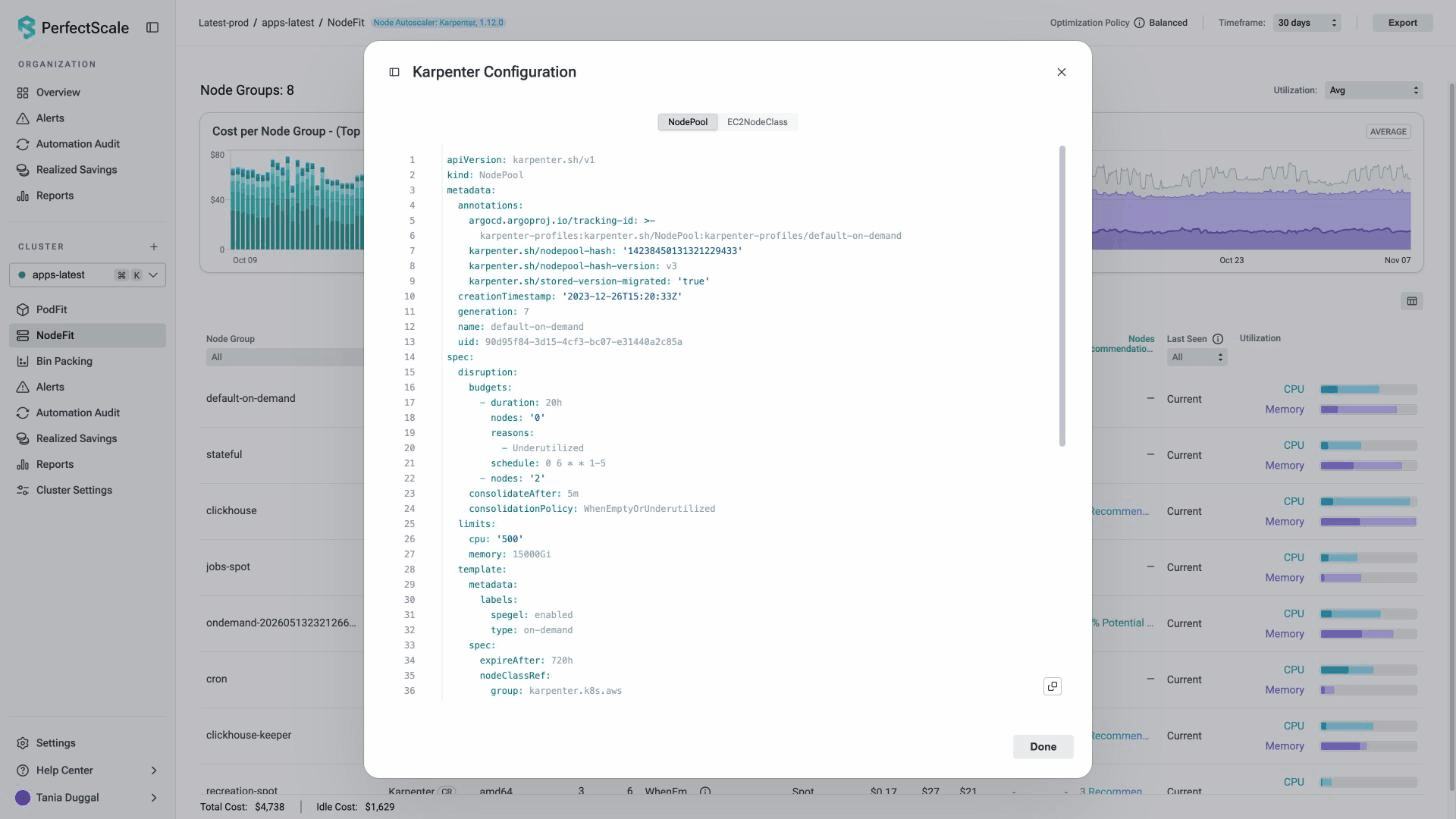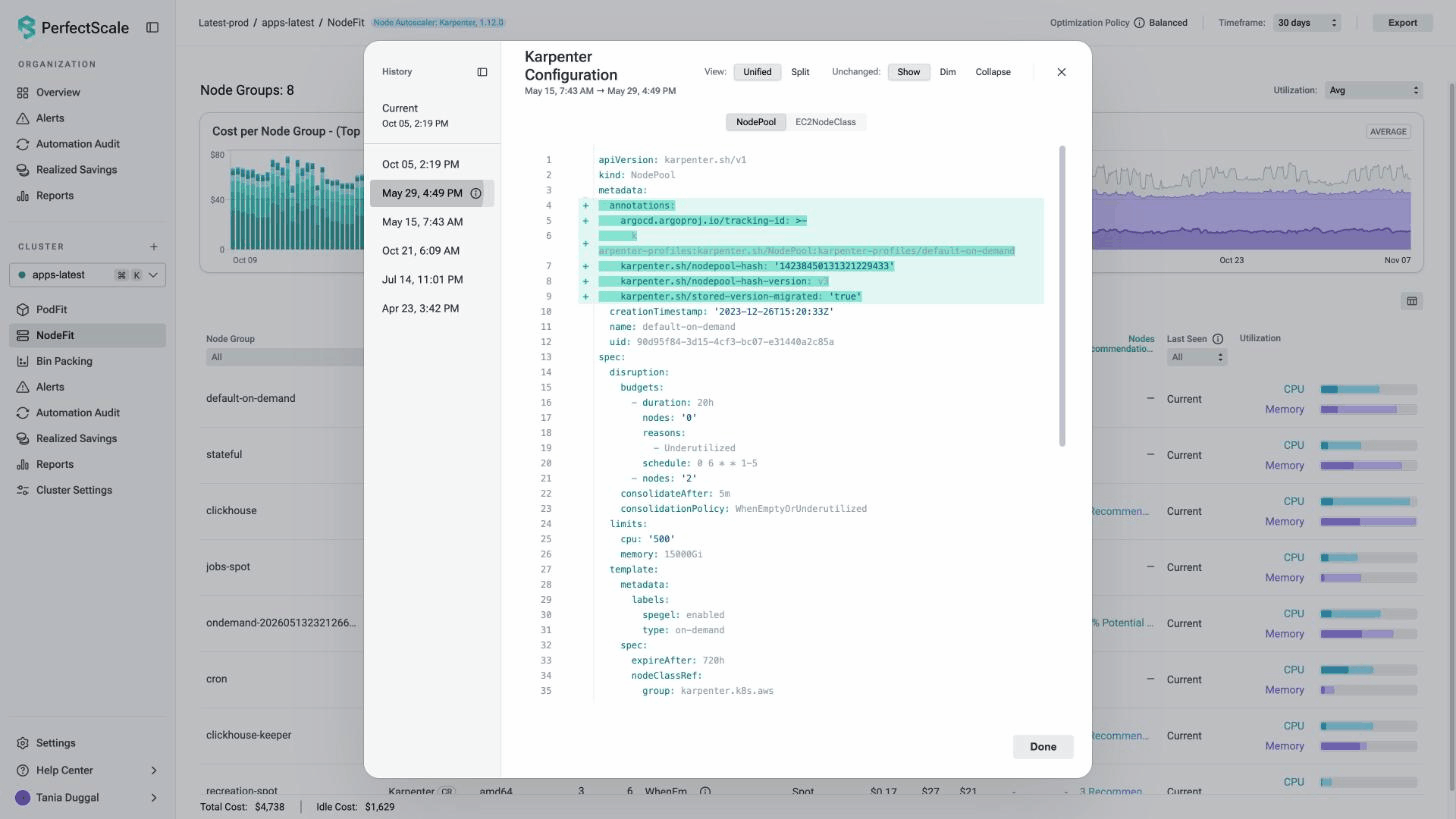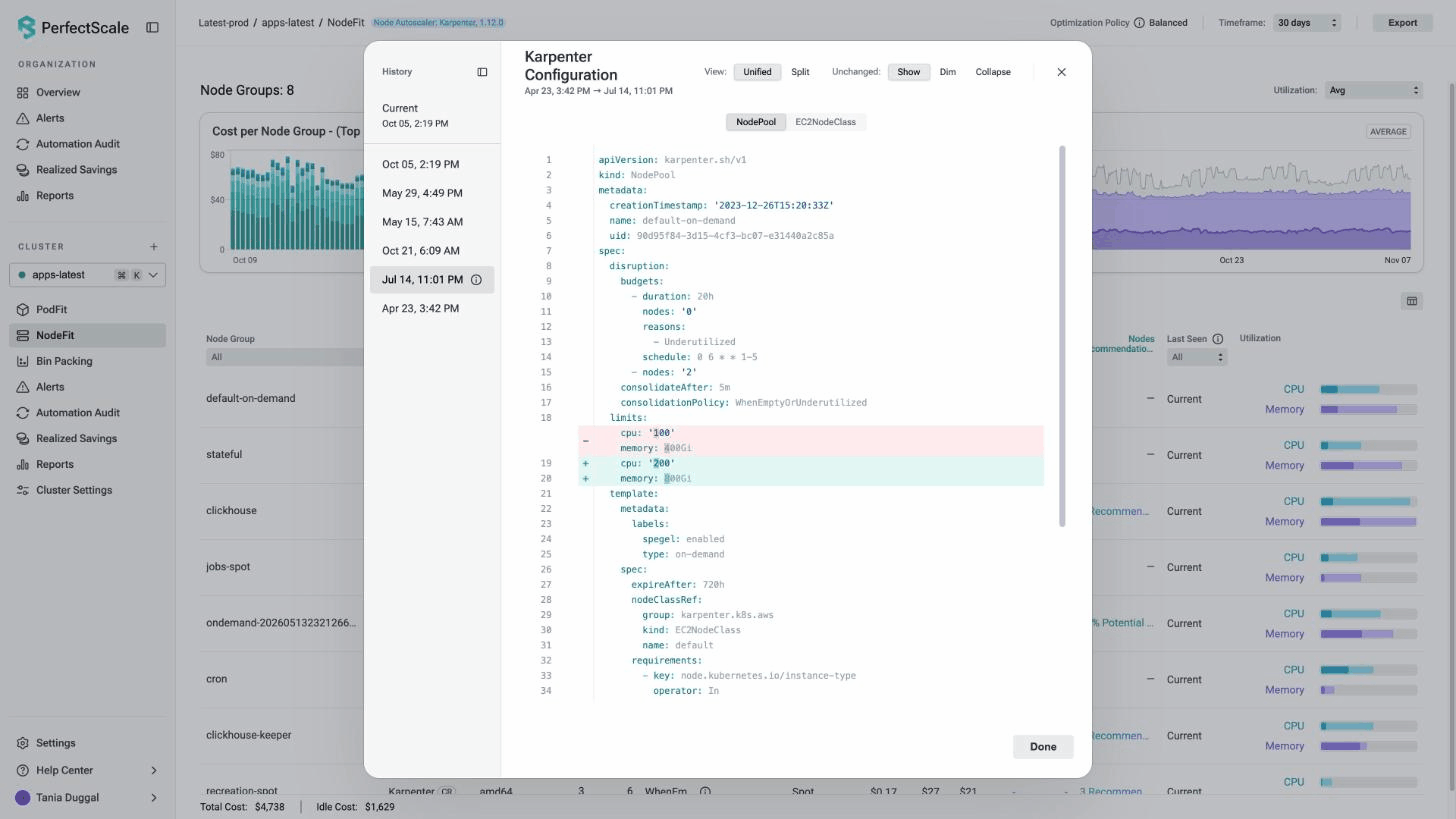
- Die Konfiguration und jede Änderung daran im Blick behalten: Karpenter-Einstellungen ändern sich im Laufe der Zeit, daher hilft es zu sehen, was sich wann geändert hat. PerfectScale erkennt Karpenter im Cluster und zeigt die NodePool- und Node-Class-Konfiguration – inklusive Änderungshistorie.
- Empfehlungen für die NodePool-Einstellungen erhalten: Die Konsolidierungs-Policy, die Wartezeit und die Instanzauswahl bestimmen, wie schnell Karpenter Nodes entfernt. PerfectScale liefert Empfehlungen zur Karpenter-Optimierung für diese Einstellungen sowie für NodePool-Limits, die fast ausgeschöpft sind. Die Empfehlungen helfen Ihnen dabei:
- Die Konsolidierungs-Policy und die Wartezeit zu überprüfen.
- Karpenter mehr Instanzoptionen zu geben, wenn es neue Nodes bereitstellt.
- NodePool-Limits zu finden, die zu wenig Raum für neue Kapazität lassen.
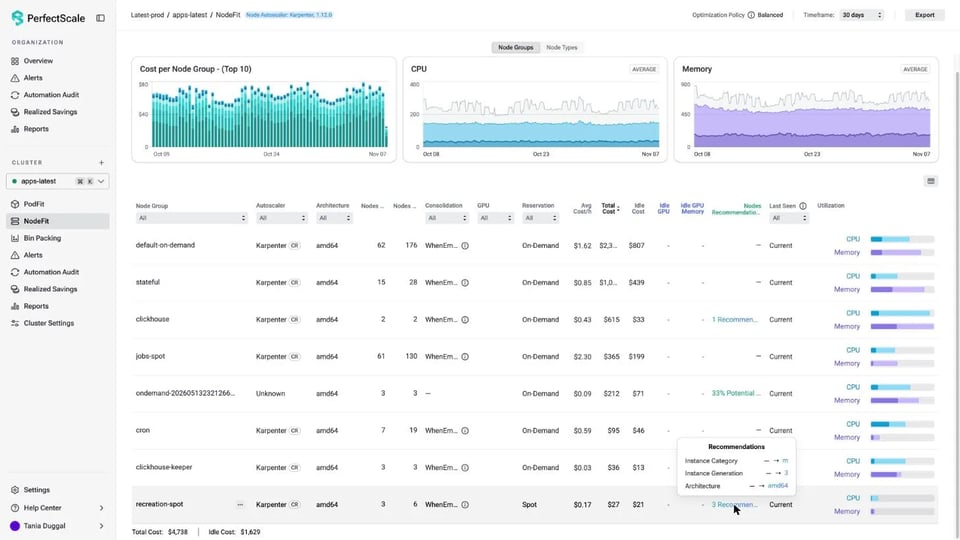
Eine YAML-Ansicht zeigt die aktuelle und die empfohlene Konfiguration, und Sie können das Ergebnis direkt kopieren.
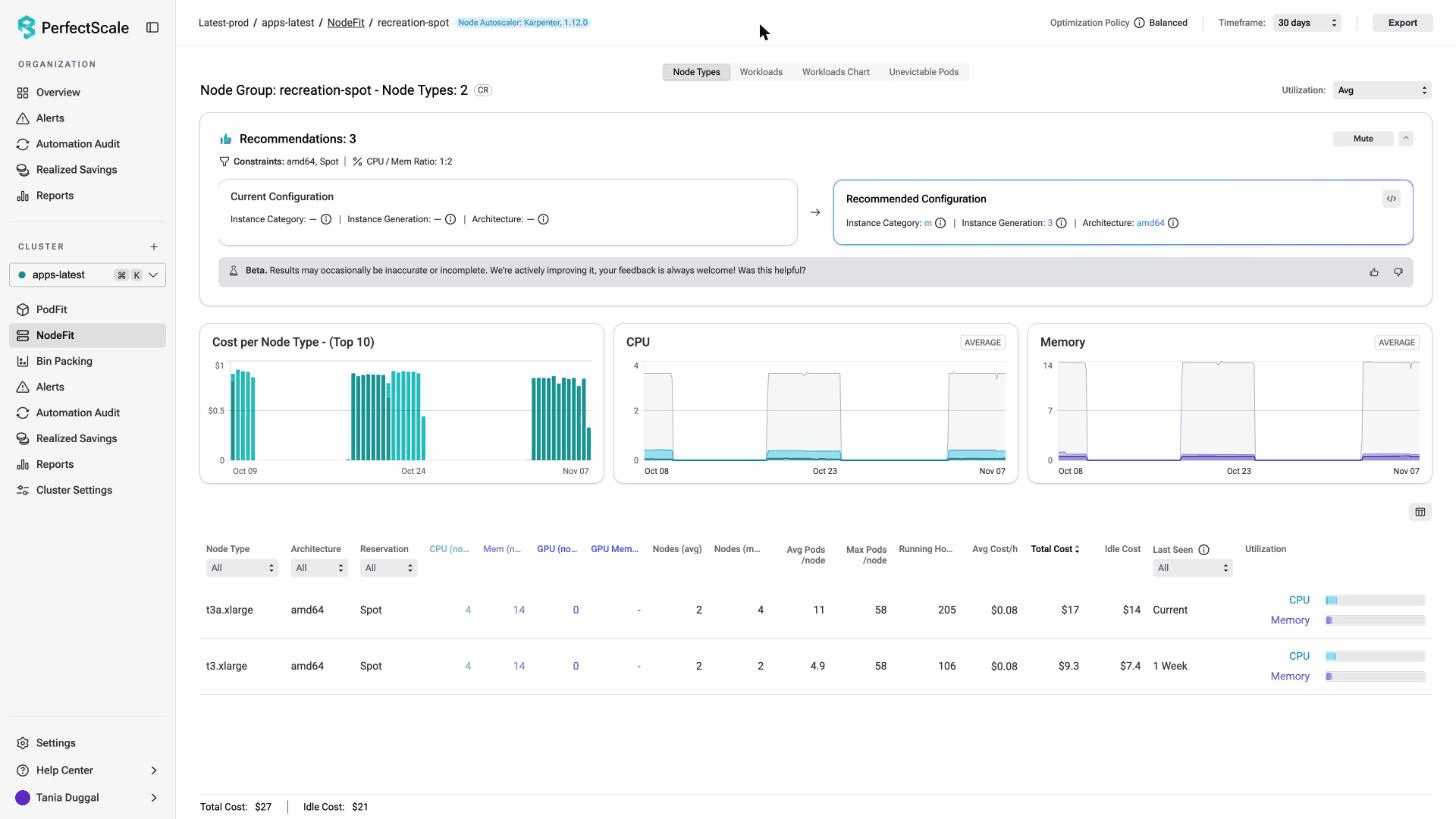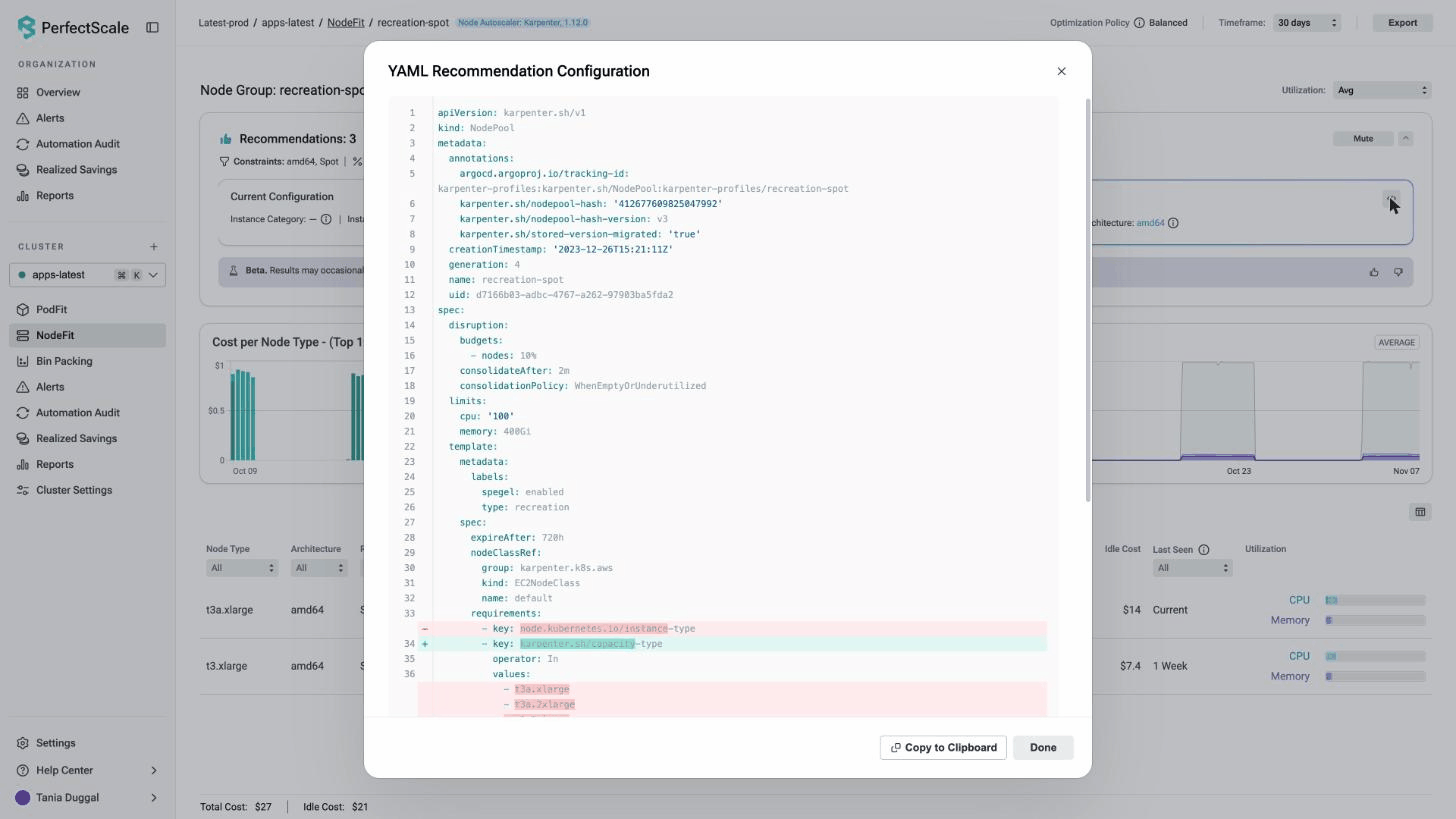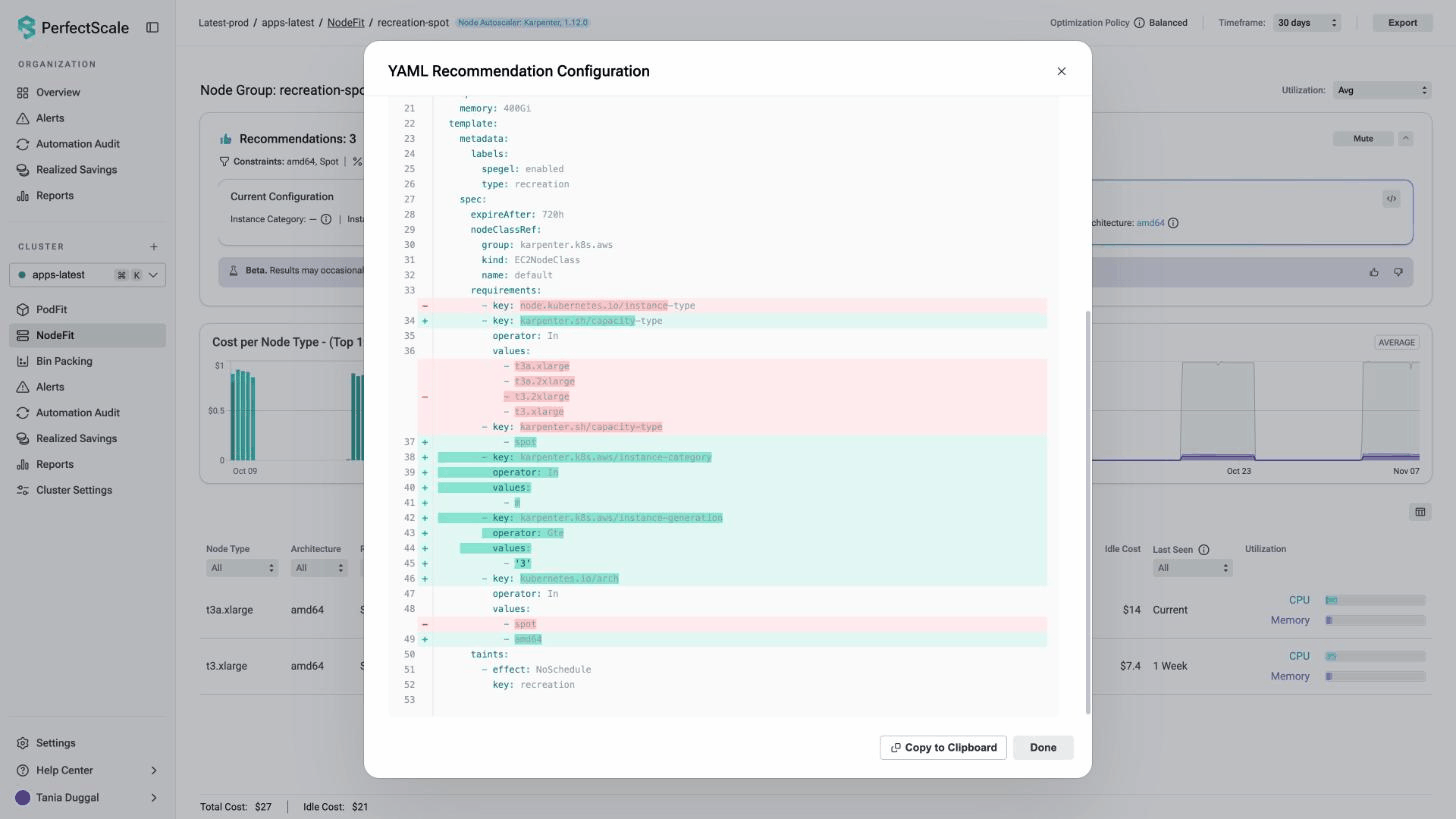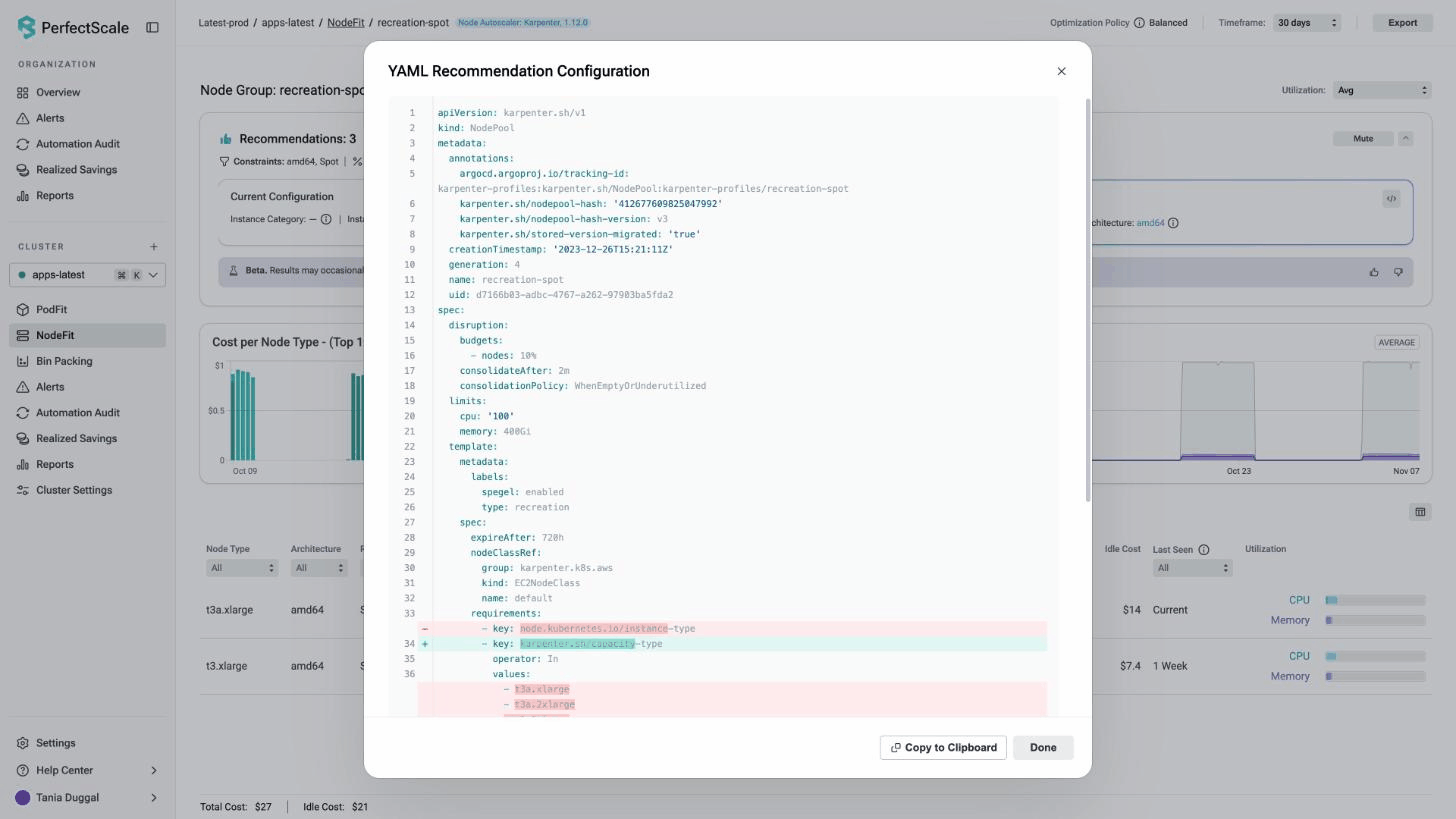
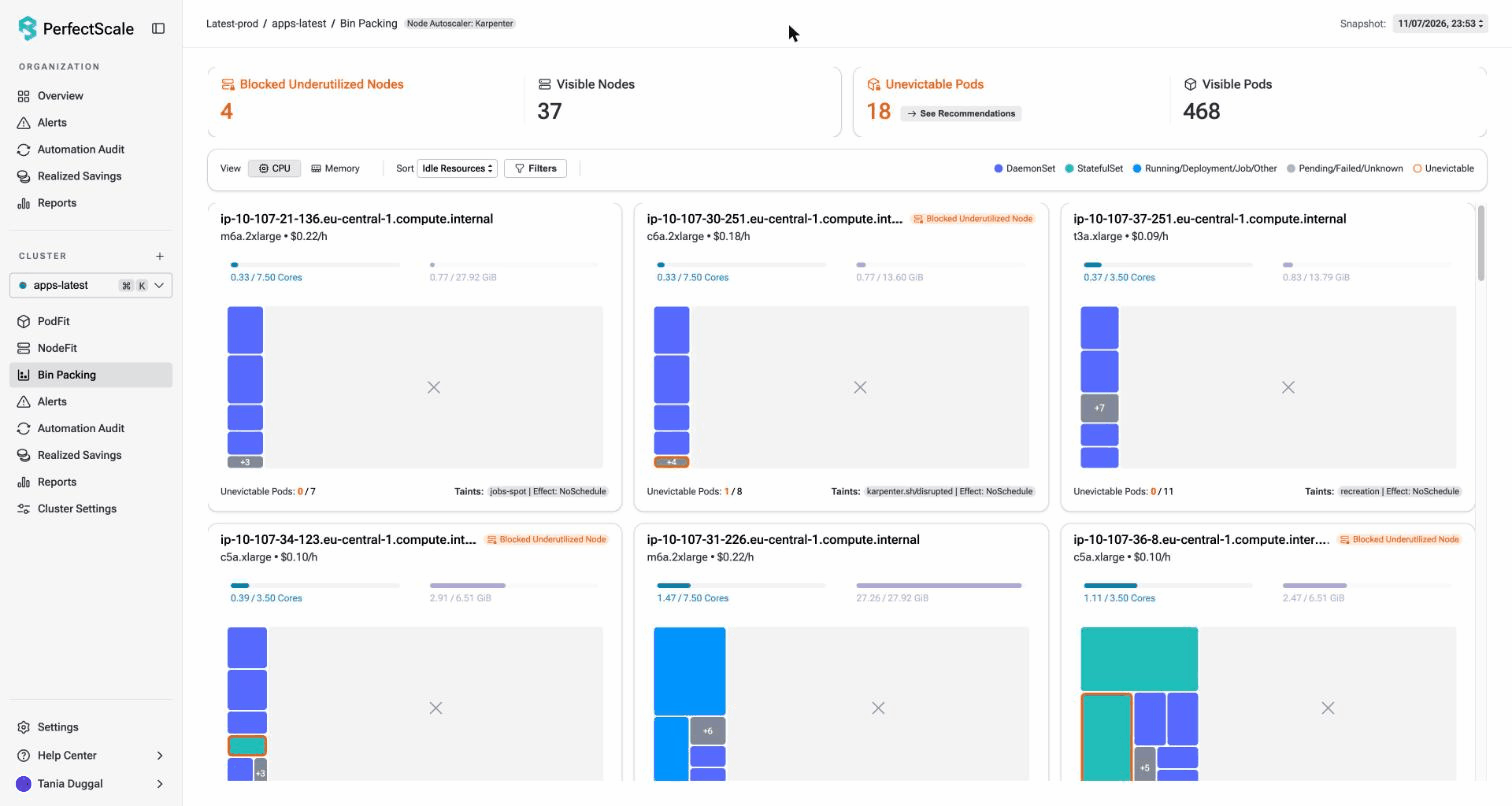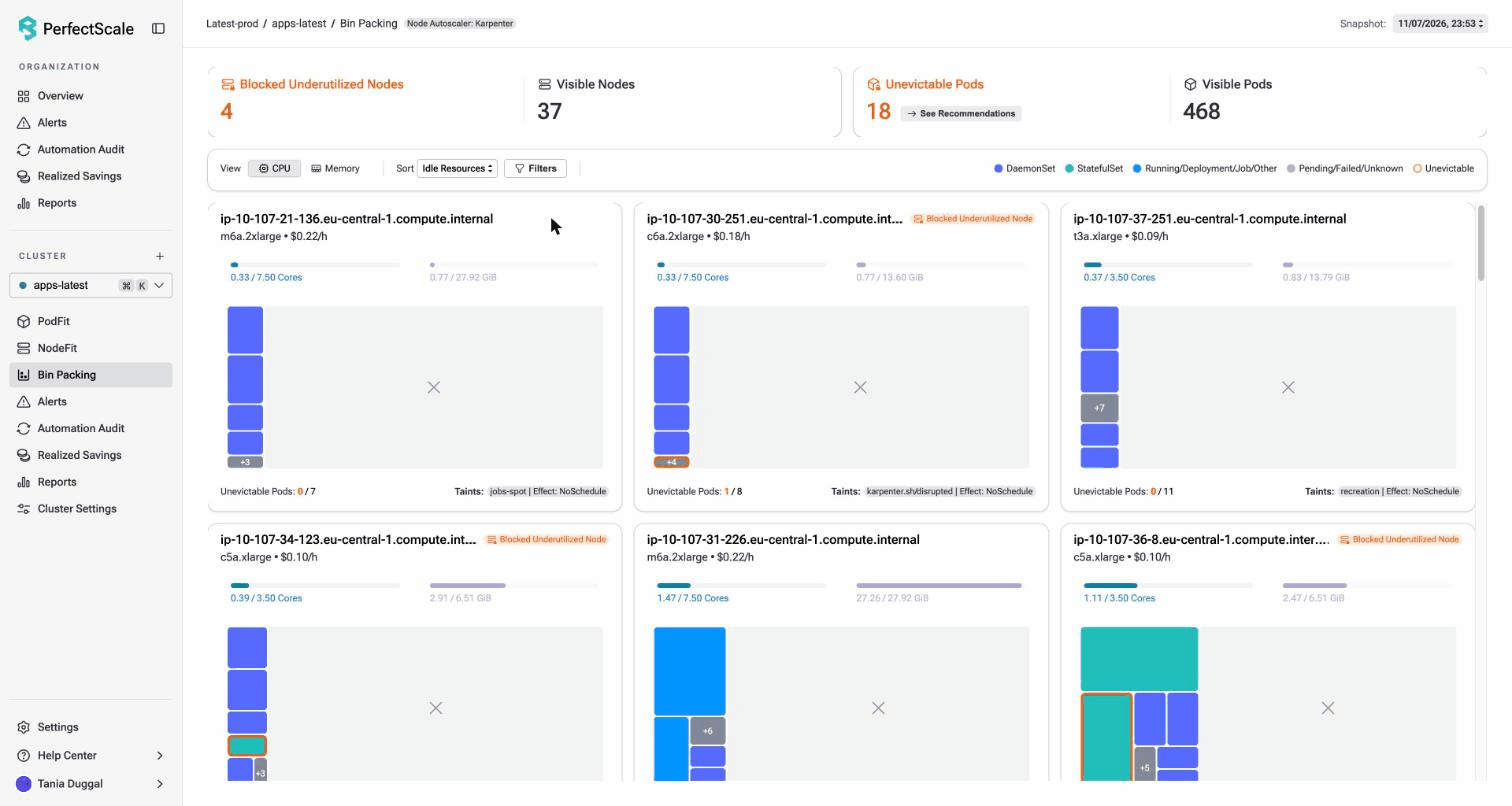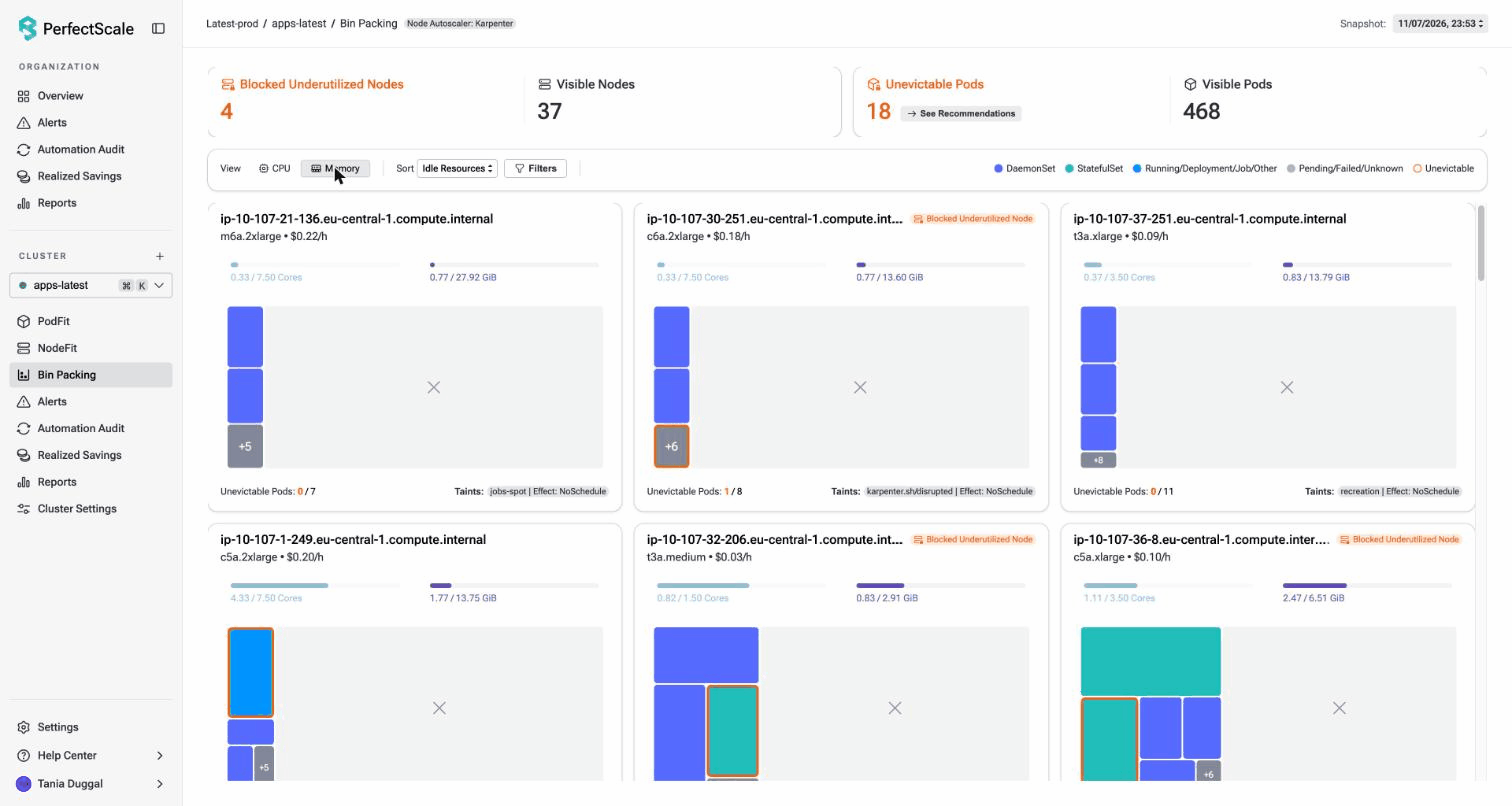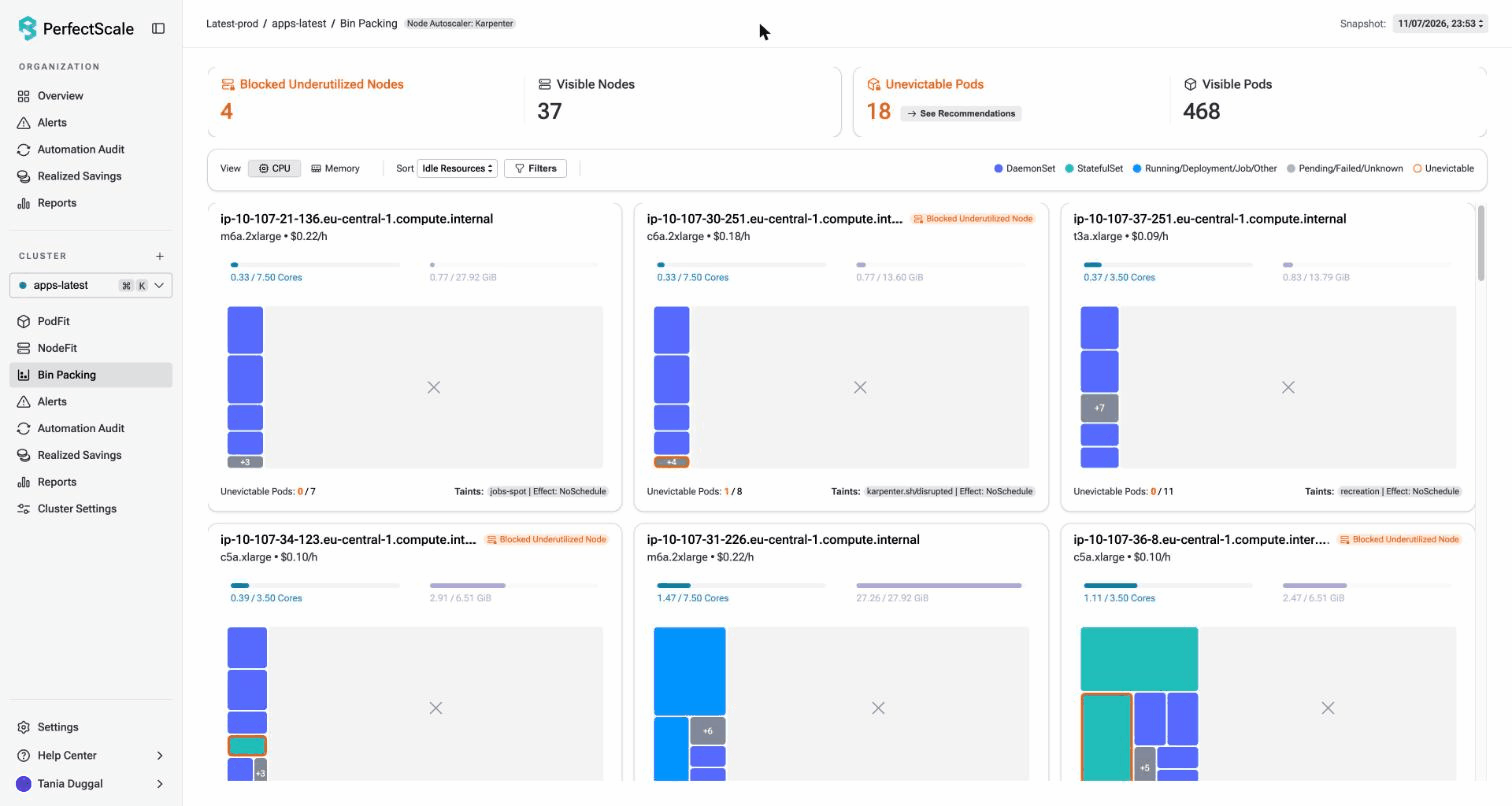
- Die Pods finden, die das Entfernen von Nodes verhindern: Ein einziger Pod, der nicht evicted werden kann, kann einen ganzen Node am Laufen halten. Die Bin-Packing-Ansicht zeigt, welche Pods das Entfernen von Nodes verhindern. Sie liefert YAML-Diff-Empfehlungen, sortiert nach Kostenwirkung, jeweils mit Konfidenz- und Risikostufe. Einen Befund, der so beabsichtigt ist, können Sie stummschalten.
Ein Agent wie Claude kann PerfectScale-Daten außerdem über den PerfectScale AI Agent Skill abfragen. Nutzen Sie nach jeder Änderung die Änderungshistorie in Ihrem Review, um zu sehen, was sich geändert hat und was Sie als Nächstes automatisieren sollten.
Erleben Sie den Pfad mit einem Agenten im Workshop
Wenn das nächste Mal ein Node bestehen bleibt, lesen Sie zuerst das Event, bevor Sie eine Einstellung anfassen. Ein Agent kann bei den ersten Schritten helfen, denn er liest Events, Konfiguration und Metriken deutlich schneller als Sie. Er kann aber auch bei jeder Anfrage eine andere Antwort geben. Deshalb prüft ein Mensch jede Änderung – und deshalb sollten feste Regeln, nicht ein Agent, sie in der Produktion anwenden.
Der Workshop Agentic Karpenter: Using kagent + Claude to Tune Your Autoscaling findet am 17. November 2026 um 11 Uhr ET statt. Vikram Seshadri und Ramesh Mathikumar zeigen, wie ein Agent solche Events liest und das Diff entwirft – und an welcher Stelle feste Regeln übernehmen. Melden Sie sich zum Workshop an.
Kämpfen Sie mit Nodes, die einfach weiterlaufen? Unser Team hilft Ihnen, den Blocker zu finden, die Änderung zu prüfen und Kapazität zurückzugewinnen, ohne die Zuverlässigkeit zu gefährden. Sprechen Sie mit unseren Experten oder registrieren Sie sich kostenlos und probieren Sie es selbst aus.