


Karpenter en Azure ayuda a AKS a crear los nodos adecuados justo cuando se necesitan. En lugar de elegir tamaños de VM por adelantado y administrar node pools fijos, Karpenter analiza los pods pendientes, encuentra una VM que pueda ejecutarlos al menor costo y crea el nodo cuando hace falta. En AKS, esto se ofrece como una funcionalidad administrada llamada Node Auto Provisioning (NAP), que alcanzó la disponibilidad general en 2025.
En esta guía aprenderás cómo Karpenter aprovisiona nodos en AKS, la diferencia entre el NAP administrado y Karpenter autogestionado, los recursos personalizados que se usan para configurarlo, cómo se compara con el proveedor de AWS y con el cluster autoscaler de AKS, cómo habilitarlo y cómo ajustarlo para equilibrar costos y resiliencia.
¿Qué es Karpenter en Azure?
Karpenter es un autoescalador de nodos de código abierto que aprovisiona nodos según lo que tus pods realmente necesitan, en lugar de escalar grupos fijos de máquinas idénticas. En Azure se usa a través de Node Auto Provisioning (NAP), la integración administrada de Karpenter en AKS. NAP despliega, configura y administra Karpenter en tu clúster de forma automática, y está construido sobre el proyecto Karpenter original (upstream) y el proveedor de Karpenter para AKS que mantiene Microsoft.
La diferencia está en cómo se eligen los nodos. Con los node pools tradicionales, decides el tamaño de la VM desde el inicio y quedas atado a ese SKU, a menos que crees otro pool y migres los workloads. NAP elimina ese paso: analiza las solicitudes de recursos de los pods que no pueden programarse, elige el SKU de VM más rentable que pueda alojarlos y lo aprovisiona. Cuando la demanda baja, consolida el trabajo en menos nodos y elimina los que ya no necesita.
¿Cómo aprovisiona nodos Karpenter en AKS?
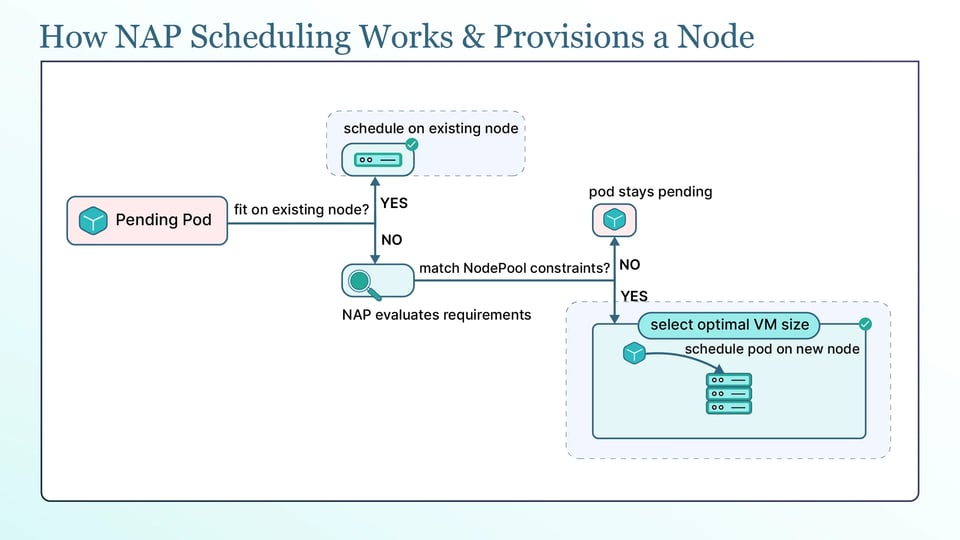
Karpenter monitorea el clúster en busca de pods que no pueden programarse. Cuando un pod no cabe en un nodo existente, Karpenter revisa sus solicitudes de CPU, memoria y otros recursos, junto con restricciones como node selectors, afinidad y tolerations. Estos detalles le permiten a Karpenter decidir qué tipo de nodo necesita el pod, y por eso es tan importante que las solicitudes de recursos sean precisas.
Luego, Karpenter selecciona un SKU de VM adecuado y acomoda los pods pendientes en él. En lugar de usar un solo tipo de máquina fijo, Karpenter considera los tamaños de VM permitidos por tu configuración y elige una opción rentable donde quepan los pods. También intenta colocar la mayor cantidad posible de pods en el nuevo nodo, reduciendo así la capacidad sin usar.
Karpenter representa cada nodo planificado con un NodeClaim. El NodeClaim conecta la decisión de Karpenter con la VM real. Karpenter crea el NodeClaim, el proveedor de Azure lanza la VM correspondiente, la VM se une al clúster y los pods pendientes se programan en ella. Puedes revisar los NodeClaims para ver qué nodos está aprovisionando Karpenter.
Karpenter también administra los nodos después de crearlos. Consolida los nodos subutilizados moviendo pods a menos nodos y eliminando los que ya no se necesitan. Además, detecta el drift cuando un nodo deja de coincidir con la configuración deseada —por ejemplo, tras un cambio en la imagen o la configuración del nodo— y lo reemplaza por uno configurado correctamente.
Node Auto Provisioning vs Karpenter autogestionado en Azure
Hay dos formas de ejecutar Karpenter en AKS, y la correcta depende de cuánto quieras administrar por tu cuenta.
Node Auto Provisioning (NAP) ejecuta Karpenter como un add-on administrado de AKS. Microsoft despliega y opera el controlador de Karpenter, se encarga de las actualizaciones y ofrece soporte como parte de AKS. Tú solo creas los recursos personalizados que definen cómo quieres que se aprovisionen los nodos. Es la opción más simple para la mayoría de los equipos. En los clústeres AKS Automatic, NAP viene preconfigurado por defecto e incluye un SLA de preparación de pods que garantiza que el 99.9% de los pods que califican estén listos en cinco minutos.
Con Karpenter autogestionado, debes instalar y operar tú mismo el proveedor open-source de Karpenter para AKS. Tienes más control, pero también te haces cargo de la instalación, las actualizaciones, la configuración de identidades y la operación continua. El clúster debe usar aprovisionamiento manual, porque NAP y un controlador de Karpenter autogestionado no pueden administrar nodos al mismo tiempo. El proveedor de Azure actualmente es compatible y está probado con Azure CNI Overlay y el dataplane de Cilium.
La diferencia principal se reduce al soporte y la responsabilidad operativa. NAP está administrado y respaldado por Microsoft, lo que lo convierte en el mejor punto de partida para la mayoría de los workloads en producción. Karpenter autogestionado cuenta con soporte de la comunidad y tiene más sentido cuando necesitas una personalización que NAP no ofrece y cuentas con un equipo listo para operarlo.
Recursos personalizados de Karpenter en Azure
Karpenter en AKS usa dos recursos personalizados: NodePool y AKSNodeClass.
El NodePool define las reglas que Karpenter sigue al crear nodos. Especifica qué familias y tamaños de VM puede usar, si puede usar capacidad Spot o bajo demanda, qué arquitecturas de CPU y zonas de disponibilidad están permitidas, y los límites que debe respetar. También incluye la configuración de disrupción que controla la consolidación y el ciclo de vida de los nodos.
El AKSNodeClass contiene la configuración del nodo específica de Azure. Define detalles como la imagen del sistema operativo del nodo, el tamaño del disco del SO, el máximo de pods por nodo, las etiquetas del nodo y, opcionalmente, el vnetSubnetID para ubicar los nodos en una subred específica.
En pocas palabras, el NodePool define qué puede crear Karpenter, mientras que el AKSNodeClass define cómo se configura el nodo en Azure. Un AKSNodeClass mínimo se ve así:
apiVersion: karpenter.azure.com/v1beta1kind: AKSNodeClassmetadata: name: defaultspec: imageFamily: Ubuntu osDiskSizeGB: 128 tags: team: platformKarpenter en Azure vs Karpenter en AWS
La mayor parte de lo que ya sabes por usar Karpenter en EKS también aplica en AKS; la diferencia principal es el NodeClass específico de cada nube. La API de NodePool proviene del proyecto upstream de Karpenter, por lo que funciona de forma similar en ambas nubes. Se usa para definir requisitos, límites de recursos y configuración de disrupción. El NodeClass es específico de cada proveedor: Azure usa AKSNodeClass, mientras que AWS usa EC2NodeClass. Cada NodeClass contiene configuraciones propias de su nube. Azure aprovisiona SKUs de VM, mientras que AWS aprovisiona tipos de instancia EC2, así que las etiquetas y los valores que se usan para seleccionarlos difieren entre proveedores.
La diferencia principal es la madurez de cada proveedor. El proveedor de AWS lleva más tiempo disponible y admite más funcionalidades, mientras que el de Azure es más reciente y puede no tener un equivalente exacto para cada función de AWS. Ambos admiten capacidades centrales como el aprovisionamiento, la consolidación, la capacidad Spot y el drift, pero consulta la documentación antes de asumir que una función específica de AWS funciona igual en Azure.
Node Auto Provisioning vs el cluster autoscaler de AKS
NAP y el cluster autoscaler de AKS resuelven el mismo problema de formas distintas. El cluster autoscaler trabaja dentro de node pools que ya definiste: monitorea los pods pendientes y ajusta el tamaño de esos pools fijos hacia arriba o hacia abajo, pero solo puede agregar más VMs de los tamaños que elegiste por adelantado. NAP no tiene esa restricción. Aprovisiona VMs del tamaño justo sobre la marcha a partir de un conjunto amplio de SKUs, acomoda los pods de forma eficiente (bin-packing) y consolida de manera agresiva, lo que suele traducirse en menos capacidad ociosa y menos planificación manual de pools.
Hay una regla importante: no ejecutes ambos. Tanto NAP como el cluster autoscaler intentan administrar la capacidad de nodos, así que al habilitar NAP debes deshabilitar el cluster autoscaler en el clúster. Deja que un solo sistema sea el dueño del escalado de nodos.
Limitaciones y funcionalidades no compatibles de Node Auto Provisioning
NAP está listo para producción, pero no admite todas las configuraciones de AKS. Debes verificar las siguientes limitaciones antes de habilitarlo:
a. Sistema operativo y tipo de clúster: los node pools de Windows no son compatibles, por lo que NAP solo aprovisiona nodos Linux. Los clústeres IPv6 tampoco son compatibles.
b. Identidad y operaciones del clúster: los service principals no son compatibles, por lo que el clúster debe usar una identidad administrada asignada por el sistema o por el usuario. Tampoco puedes detener un clúster con NAP habilitado, ni cambiar el tipo de salida (egress outbound type) del clúster después de crearlo.
c. Redes: NAP funciona con Azure CNI Overlay, Azure CNI Overlay con Cilium y Azure CNI, y Microsoft recomienda Azure CNI con Cilium. Las políticas de red de Calico y la asignación dinámica de IPs no son compatibles. Si creas un clúster con NAP en una red virtual personalizada, debes usar un Standard Load Balancer, ya que el Basic Load Balancer no es compatible.
Habilitar Node Auto Provisioning en un clúster de AKS
Antes de habilitar NAP, asegúrate de cumplir los requisitos previos. Necesitas Azure CLI versión 2.76.0 o posterior, que puedes verificar con az --version, y el clúster debe usar una identidad administrada en lugar de un service principal. También necesitas una configuración de red compatible, es decir, Azure CNI en modo overlay, y Cilium es el dataplane recomendado.
Para habilitar NAP en un clúster nuevo, establece el modo de aprovisionamiento en Auto junto con la configuración de red:
az aks create \ --name myCluster \ --resource-group myResourceGroup \ --node-provisioning-mode Auto \ --network-plugin azure \ --network-plugin-mode overlay \ --network-dataplane ciliumPara habilitarlo en un clúster existente, actualiza el modo de aprovisionamiento:
az aks update \ --name myCluster \ --resource-group myResourceGroup \ --node-provisioning-mode AutoSi tu clúster corre en una red virtual personalizada, recuerda el requisito del Standard Load Balancer y otorga a la identidad administrada del clúster el rol Network Contributor en la VNet o subred de destino, para que Karpenter pueda conectar nodos a ella.
Una vez habilitado NAP, verifícalo confirmando que los recursos de Karpenter existen y provocando luego un escalado. Comprueba que los CRDs estén presentes con kubectl api-resources | grep karpenter, luego despliega un workload y escálalo más allá de la capacidad actual para que queden pods pendientes. Observa cómo responde Karpenter:
kubectl get nodeclaimskubectl get nodes -wDeberías ver aparecer un NodeClaim, una nueva VM uniéndose al clúster y los pods pendientes programándose en ella.
Configurar los NodePools para optimizar costos y resiliencia
El NodePool controla cómo Karpenter equilibra el costo, la capacidad y la resiliencia:
a. Restringe familias, tamaños y generaciones de SKUs de VM: usa los requisitos del NodePool para indicarle a Karpenter qué VMs puede elegir. Puedes permitir familias completas, excluir SKUs sobredimensionados o preferir generaciones más recientes, lo que mantiene el aprovisionamiento predecible sin quitarle a Karpenter el margen para encontrar una opción económica. Cuanto más amplio sea el conjunto de SKUs permitidos, más opciones tiene Karpenter para encontrar un ajuste rentable.
b. Combina capacidad Spot y bajo demanda: Karpenter puede aprovisionar VMs Spot y bajo demanda mediante el requisito karpenter.sh/capacity-type, y ejecutar recursos NodePool separados con pesos te permite priorizar la capacidad Spot, más barata, y recurrir a la capacidad bajo demanda cuando Spot no está disponible. De aquí proviene gran parte del ahorro para los workloads que toleran interrupciones.
c. Distribuye los nodos entre zonas de disponibilidad: permite varias zonas en los requisitos del NodePool (topology.kubernetes.io/zone) para que Karpenter pueda colocar nodos en distintas zonas, lo que protege tus workloads ante la falla de una sola zona.
d. Define topes y taints para workloads especiales: asigna a cada NodePool límites de CPU y memoria para acotar la capacidad que puede aprovisionar, y usa taints para reservar un NodePool para workloads específicos, como GPU o trabajos batch, de modo que solo los pods que toleren el taint terminen en esos nodos. Un NodePool con requisitos y límites se ve así:
apiVersion: karpenter.sh/v1kind: NodePoolmetadata: name: generalspec: template: spec: requirements: - key: karpenter.sh/capacity-type operator: In values: ["spot", "on-demand"] - key: kubernetes.io/arch operator: In values: ["amd64"] nodeClassRef: name: default limits: cpu: "200" memory: 400GiControlar la consolidación y la disrupción
La consolidationPolicy del NodePool controla la consolidación. WhenEmpty elimina un nodo solo cuando no tiene pods de workloads, lo que la convierte en la opción más conservadora. WhenEmptyOrUnderutilized también considera los nodos que están en ejecución pero no se aprovechan por completo. Karpenter puede mover sus pods a otros nodos y eliminar los subutilizados, lo que puede ahorrar más, aunque también implica mover pods con mayor frecuencia. El parámetro consolidateAfter controla cuánto espera Karpenter antes de considerar un nodo para la consolidación.
Karpenter también administra el ciclo de vida de los nodos. Puedes configurar que los nodos expiren tras cierta antigüedad para que se reemplacen con regularidad. NAP también gestiona las actualizaciones de la imagen de los nodos y los mantiene alineados con la versión de Kubernetes del plano de control cuando actualizas el clúster. Un canal de actualización automática adecuado y una ventana de mantenimiento planificada ayudan a controlar cuándo ocurren estas actualizaciones.
Para proteger la disponibilidad mientras todo esto sucede, usa tres controles en conjunto. Los presupuestos de disrupción del NodePool limitan cuántos nodos puede interrumpir Karpenter a la vez. Los PodDisruptionBudgets protegen tus workloads al limitar cuántos de sus pods pueden estar no disponibles durante disrupciones voluntarias como la consolidación. Y la anotación karpenter.sh/do-not-disrupt: "true" en un pod o nodo le indica a Karpenter que no lo toque, algo útil para un trabajo que no debe interrumpirse.
¿Por qué las solicitudes de recursos de los pods deciden cuánto ahorra Karpenter?
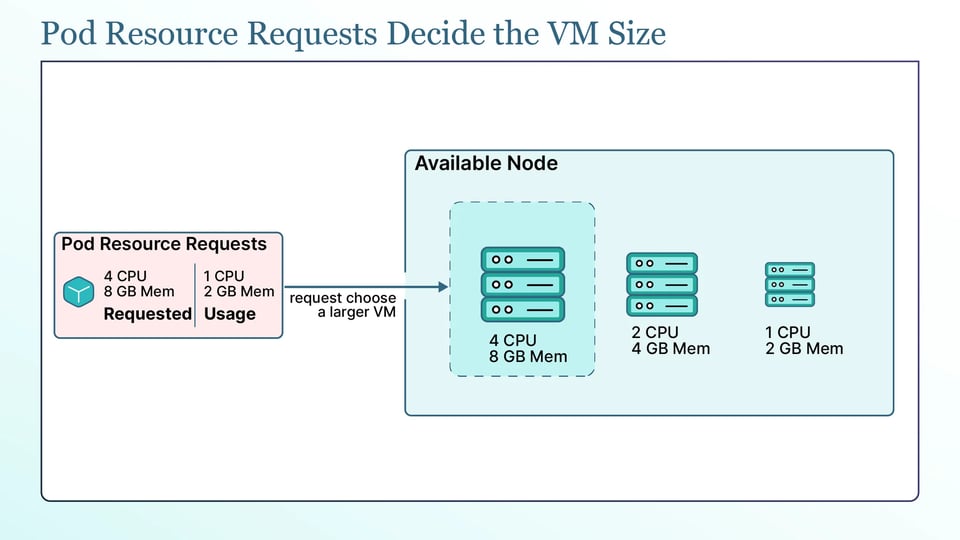
Karpenter aprovisiona nodos según las solicitudes de recursos de los pods, no según el uso real de recursos. Usa esas solicitudes para elegir una VM donde quepan los pods pendientes, así que la precisión de las solicitudes afecta directamente cuánta capacidad se aprovisiona y cuánto pagas.
Las solicitudes infladas pueden hacer que Karpenter elija SKUs de VM más grandes y costosos. Por ejemplo, si un pod solicita 4 CPU y 8 GB de memoria pero solo usa 1 CPU y 2 GB, Karpenter igual necesita encontrar capacidad suficiente para los 4 CPU y 8 GB solicitados. Por lo tanto, puede elegir una VM más grande y colocar menos pods en el nodo. A escala de todo el clúster, las solicitudes infladas pueden derivar en capacidad sin usar y costos más altos. Karpenter simplemente sigue los requisitos de recursos que definiste.
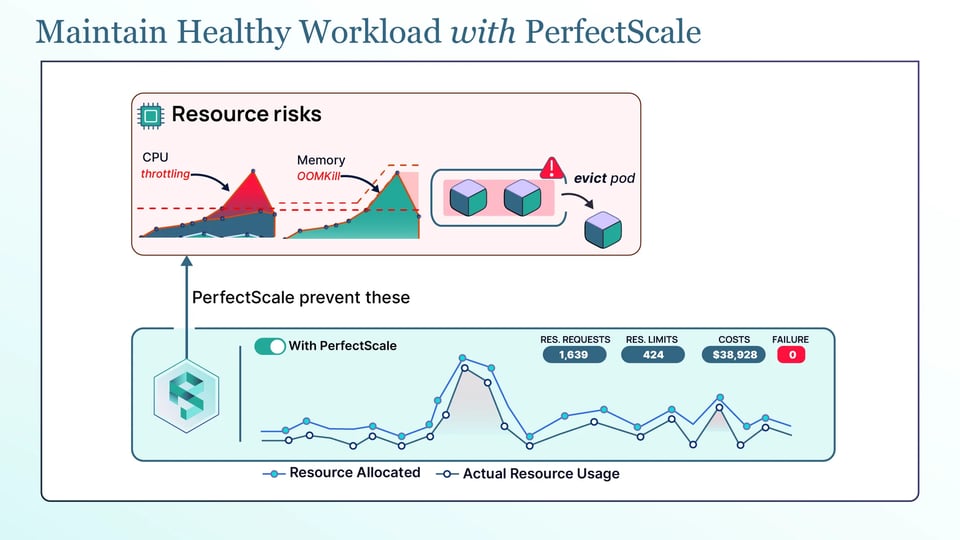
Aquí es donde el right-sizing continuo marca la diferencia. La plataforma de gobernanza de Kubernetes de PerfectScale observa cómo tus workloads usan realmente la CPU y la memoria, y lo convierte en recomendaciones de right-sizing accionables y automatizadas que puedes aplicar de forma manual o autónoma. Alimentar a NAP con solicitudes precisas es lo que le permite hacer su trabajo: con solicitudes que reflejan la realidad, Karpenter aprovisiona VMs más pequeñas y baratas y las aprovecha al máximo, de modo que el ahorro que promete NAP realmente se refleja en tu factura. Equipos como Paramount Pictures y Creditas usan PerfectScale para mantener sus clústeres eficientes; puedes registrarte o agendar una sesión técnica.
Monitorear la actividad de nodos de NAP, la latencia de aprovisionamiento y el costo de los nodos
Una vez que NAP está en marcha, querrás tener visibilidad de lo que hace. Comienza por los NodeClaims, que muestran qué está aprovisionando Karpenter y te permiten ver la actividad de aprovisionamiento en tiempo real.
AKS expone los eventos de Karpenter en los registros del plano de control (la categoría karpenter-events), que es donde debes buscar cuando un nodo no logra aprovisionarse o registrarse.
Para las métricas, habilita las métricas del plano de control mediante el servicio administrado de Azure Monitor para Prometheus, y así monitorear el comportamiento de Karpenter, incluida la actividad y la latencia de aprovisionamiento.
La visibilidad de los costos importa igual, porque NAP cambia continuamente la mezcla de SKUs de VM en el clúster. Herramientas como Kubecost y OpenCost pueden ofrecer una asignación de costos básica, mientras que PerfectScale también ayuda a identificar solicitudes de recursos ineficientes y capacidad subutilizada, lo que facilita medir el impacto de NAP en los costos.
Buenas prácticas para ejecutar Karpenter en AKS
Estas son las buenas prácticas que debes conocer:
a. Aplica right-sizing a las solicitudes de los pods antes de habilitar NAP: Karpenter aprovisiona nodos según las solicitudes de recursos de los pods, así que unas solicitudes precisas tienen un impacto enorme en el costo. Ajústalas primero para evitar aprovisionar más capacidad de la que tus workloads necesitan.
b. Mantén los requisitos del NodePool lo bastante amplios para encontrar SKUs más baratos: restringir a Karpenter a uno o dos tamaños de VM limita su capacidad de encontrar opciones rentables. Permite un rango razonable de familias y tamaños de VM para que Karpenter tenga más alternativas.
c. Usa discos de SO efímeros y capacidad Spot para workloads tolerantes a fallas: los discos de SO efímeros pueden ofrecer almacenamiento más rápido, y las VMs Spot pueden costar mucho menos que la capacidad bajo demanda. Ambos implican concesiones, así que úsalos para workloads que soporten el reemplazo o la interrupción de nodos. Mantén los workloads críticos en capacidad bajo demanda cuando la confiabilidad importe más que el costo.
d. Define límites en los NodePools para frenar el aprovisionamiento descontrolado: establece siempre límites de CPU y memoria en tus recursos NodePool. Sin ellos, un workload mal configurado o un despliegue fuera de control podría hacer que Karpenter aprovisione mucha más capacidad —y mucho más costo— de lo que pretendías.
e. Administra los NodePools y AKSNodeClasses como código: mantén tus definiciones de NodePool y AKSNodeClass en Terraform o Bicep junto con el resto de tu infraestructura, para que la política de aprovisionamiento esté versionada, revisada y sea repetible entre clústeres, en lugar de editarse a mano.