


Karpenter auf Azure hilft AKS dabei, genau die Nodes zu erstellen, die gerade gebraucht werden. Statt VM-Größen im Voraus festzulegen und feste Node-Pools zu verwalten, analysiert Karpenter wartende Pods, findet eine VM, die sie zu den niedrigsten Kosten ausführen kann, und erstellt den Node bei Bedarf. Auf AKS steht das als verwaltetes Feature namens Node Auto Provisioning (NAP) bereit, das 2025 allgemein verfügbar wurde.
In diesem Guide erfahren Sie, wie Karpenter Nodes auf AKS provisioniert, worin sich Managed NAP und Self-Hosted Karpenter unterscheiden, welche Custom Resources Sie zur Konfiguration nutzen, wie es im Vergleich zum AWS-Provider und zum AKS Cluster Autoscaler abschneidet, wie Sie es aktivieren und wie Sie es auf Kosten und Resilienz hin optimieren.
Was ist Karpenter auf Azure?
Karpenter ist ein Open-Source-Node-Autoscaler, der Nodes auf Basis dessen provisioniert, was Ihre Pods tatsächlich benötigen, statt feste Gruppen identischer Maschinen zu skalieren. Auf Azure nutzen Sie ihn über Node Auto Provisioning (NAP), die von AKS verwaltete Karpenter-Integration. NAP stellt Karpenter automatisch auf Ihrem Cluster bereit, konfiguriert und verwaltet ihn – und baut dabei auf dem Upstream-Karpenter-Projekt sowie dem von Microsoft gepflegten AKS-Karpenter-Provider auf.
Der Unterschied liegt darin, wie Nodes ausgewählt werden. Bei traditionellen Node-Pools legen Sie die VM-Größe im Voraus fest und sind an diese SKU gebunden, sofern Sie nicht einen weiteren Pool erstellen und Workloads dorthin migrieren. NAP macht diesen Schritt überflüssig. Es betrachtet die Resource Requests von Pods, die nicht eingeplant werden können, wählt die kosteneffizienteste VM-SKU, auf die sie passen, und provisioniert sie. Sinkt die Nachfrage, konsolidiert es die Arbeit auf weniger Nodes und entfernt die, die nicht mehr benötigt werden.
Wie provisioniert Karpenter Nodes auf AKS?
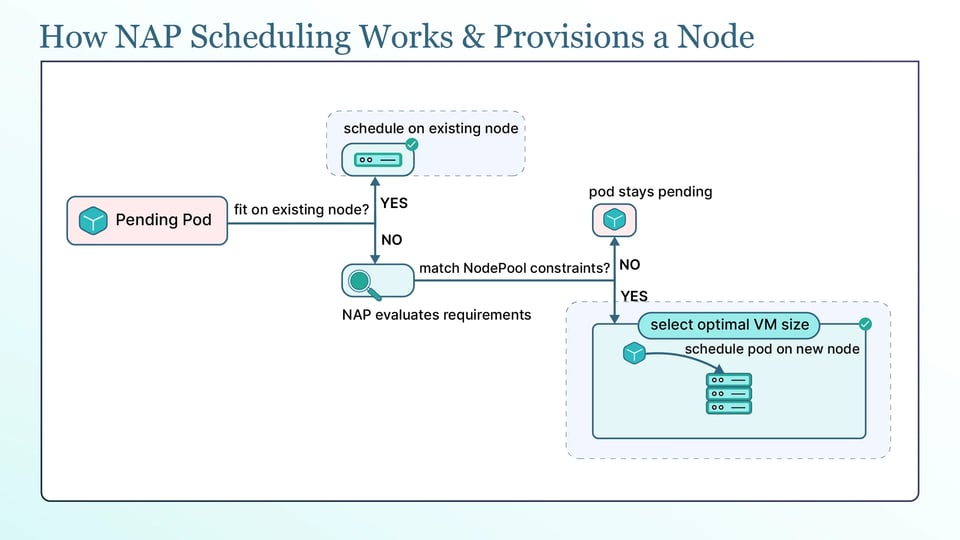
Karpenter überwacht den Cluster auf Pods, die nicht eingeplant werden können. Passt ein Pod auf keinen vorhandenen Node, betrachtet Karpenter dessen CPU-, Memory- und weitere Resource Requests sowie Constraints wie Node Selectors, Affinity und Tolerations. Anhand dieser Angaben entscheidet Karpenter, welche Art von Node der Pod benötigt – genau deshalb sind präzise Resource Requests so wichtig.
Anschließend wählt Karpenter eine passende VM-SKU und platziert die wartenden Pods darauf. Statt einen festen Maschinentyp zu verwenden, berücksichtigt Karpenter die von Ihrer Konfiguration erlaubten VM-Größen und wählt eine kosteneffiziente Option, auf die die Pods passen. Dabei versucht es, möglichst viele Pods auf dem neuen Node unterzubringen und ungenutzte Kapazität zu reduzieren.
Jeden geplanten Node repräsentiert Karpenter über einen NodeClaim. Der NodeClaim verbindet Karpenters Entscheidung mit der tatsächlichen VM. Karpenter erstellt den NodeClaim, der Azure-Provider startet die passende VM, die VM tritt dem Cluster bei, und die wartenden Pods werden darauf eingeplant. Über die NodeClaims sehen Sie, welche Nodes Karpenter gerade provisioniert.
Karpenter verwaltet Nodes auch nach ihrer Erstellung. Es konsolidiert wenig ausgelastete Nodes, indem es Pods auf weniger Nodes verschiebt und nicht mehr benötigte Nodes entfernt. Außerdem erkennt es Drift, wenn ein Node nicht mehr der gewünschten Konfiguration entspricht – etwa nach einer Node-Image- oder Konfigurationsänderung – und ersetzt ihn durch einen korrekt konfigurierten Node.
Node Auto Provisioning vs. Self-Hosted Karpenter auf Azure
Es gibt zwei Wege, Karpenter auf AKS zu betreiben – welcher der richtige ist, hängt davon ab, wie viel Sie selbst verwalten möchten.
Node Auto Provisioning (NAP) betreibt Karpenter als verwaltetes AKS-Add-on. Microsoft deployt und betreibt den Karpenter-Controller, übernimmt Upgrades und bietet Support als Teil von AKS. Sie erstellen lediglich die Custom Resources, die festlegen, wie Nodes provisioniert werden sollen. Für die meisten Teams ist das die einfachere Option. Auf AKS-Automatic-Clustern ist NAP standardmäßig vorkonfiguriert und beinhaltet ein Pod-Readiness-SLA, das garantiert, dass 99,9 % der qualifizierten Pods innerhalb von fünf Minuten bereit sind.
Bei Self-Hosted Karpenter installieren und betreiben Sie den Open-Source-AKS-Karpenter-Provider selbst. Sie erhalten mehr Kontrolle, verantworten aber auch Installation, Upgrades, Identitätskonfiguration und den laufenden Betrieb. Der Cluster muss manuelles Provisioning verwenden, da NAP und ein selbst gehosteter Karpenter-Controller nicht gleichzeitig Nodes verwalten können. Der Azure-Provider unterstützt derzeit Azure CNI Overlay und die Cilium-Dataplane und wird damit getestet.
Der Hauptunterschied liegt in Support und operativer Verantwortung. NAP wird von Microsoft verwaltet und supportet und ist damit für die meisten Produktions-Workloads der bessere Ausgangspunkt. Self-Hosted Karpenter wird von der Community unterstützt und ist dann sinnvoll, wenn Sie Anpassungen benötigen, die NAP nicht bietet, und ein Team haben, das den Betrieb selbst übernehmen kann.
Karpenter Custom Resources auf Azure
Karpenter auf AKS verwendet zwei Custom Resources: NodePool und AKSNodeClass.
Der NodePool definiert die Regeln, nach denen Karpenter Nodes erstellt. Er legt fest, welche VM-Familien und -Größen verwendet werden dürfen, ob Spot- oder On-Demand-Kapazität genutzt werden kann, welche CPU-Architekturen und Availability Zones erlaubt sind und welche Limits gelten. Außerdem enthält er Disruption-Einstellungen, die Konsolidierung und Node-Lifecycle steuern.
Die AKSNodeClass enthält die Azure-spezifischen Node-Einstellungen. Sie definiert Details wie das Node-OS-Image, die OS-Disk-Größe, die maximale Anzahl von Pods pro Node, Node-Tags und optional die vnetSubnetID, um Nodes in einem bestimmten Subnetz zu platzieren.
Vereinfacht gesagt: Der NodePool definiert, was Karpenter erstellen darf, die AKSNodeClass, wie der Azure-Node konfiguriert wird. Eine minimale AKSNodeClass sieht so aus:
apiVersion: karpenter.azure.com/v1beta1kind: AKSNodeClassmetadata: name: defaultspec: imageFamily: Ubuntu osDiskSizeGB: 128 tags: team: platformKarpenter auf Azure vs. Karpenter auf AWS
Das meiste, was Sie von Karpenter auf EKS kennen, gilt auch für AKS – der wesentliche Unterschied ist die cloudspezifische NodeClass. Die NodePool-API stammt aus dem Upstream-Karpenter und funktioniert daher auf beiden Clouds ähnlich. Sie definieren damit Requirements, Ressourcenlimits und Disruption-Einstellungen. Die NodeClass ist providerspezifisch: Azure nutzt AKSNodeClass, AWS EC2NodeClass. Jede NodeClass enthält cloudspezifische Einstellungen. Azure provisioniert VM-SKUs, AWS EC2-Instance-Typen, weshalb sich die Labels und Werte für deren Auswahl zwischen den Providern unterscheiden.
Der Hauptunterschied liegt im Reifegrad der Provider. Der AWS-Provider ist länger verfügbar und unterstützt mehr Features, während der Azure-Provider neuer ist und möglicherweise nicht für jedes AWS-Feature ein exaktes Pendant bietet. Beide unterstützen Kernfunktionen wie Provisioning, Konsolidierung, Spot-Kapazität und Drift – prüfen Sie aber die Dokumentation, bevor Sie davon ausgehen, dass ein AWS-spezifisches Feature auf Azure genauso funktioniert.
Node Auto Provisioning vs. AKS Cluster Autoscaler
NAP und der AKS Cluster Autoscaler lösen dasselbe Problem auf unterschiedliche Weise. Der Cluster Autoscaler arbeitet innerhalb der Node-Pools, die Sie bereits definiert haben. Er überwacht wartende Pods und skaliert diese festen Pools hoch oder herunter, kann aber nur weitere Instanzen der vorab gewählten VM-Größen hinzufügen. NAP kennt diese Einschränkung nicht. Es provisioniert passend dimensionierte VMs on the fly aus einer breiten SKU-Auswahl, platziert Pods per Bin-Packing dicht darauf und konsolidiert aggressiv – was in der Regel weniger verschwendete Kapazität und weniger manuelle Pool-Planung bedeutet.
Eine wichtige Regel gilt: Betreiben Sie nie beide gleichzeitig. NAP und der Cluster Autoscaler versuchen beide, die Node-Kapazität zu verwalten. Wenn Sie NAP aktivieren, deaktivieren Sie daher den Cluster Autoscaler auf dem Cluster. Nur ein System sollte das Node-Scaling verantworten.
Einschränkungen und nicht unterstützte Features von Node Auto Provisioning
NAP ist produktionsreif, unterstützt aber nicht jede AKS-Konfiguration. Prüfen Sie vor der Aktivierung die folgenden Einschränkungen:
a. Betriebssystem und Cluster-Typ: Windows-Node-Pools werden nicht unterstützt, NAP provisioniert also ausschließlich Linux-Nodes. IPv6-Cluster werden ebenfalls nicht unterstützt.
b. Identität und Cluster-Betrieb: Service Principals werden nicht unterstützt, der Cluster muss also eine systemseitig oder benutzerseitig zugewiesene Managed Identity verwenden. Außerdem können Sie einen Cluster mit aktiviertem NAP nicht stoppen und den Egress-Outbound-Typ des Clusters nach der Erstellung nicht ändern.
c. Networking: NAP funktioniert mit Azure CNI Overlay, Azure CNI Overlay powered by Cilium und Azure CNI; Microsoft empfiehlt Azure CNI mit Cilium. Calico Network Policy und dynamische IP-Zuweisung werden nicht unterstützt. Wenn Sie einen NAP-Cluster in einem benutzerdefinierten virtuellen Netzwerk erstellen, müssen Sie einen Standard Load Balancer verwenden, da der Basic Load Balancer nicht unterstützt wird.
Node Auto Provisioning auf einem AKS-Cluster aktivieren
Stellen Sie vor der Aktivierung von NAP sicher, dass die Voraussetzungen erfüllt sind. Sie benötigen Azure CLI ab Version 2.76.0 (prüfbar mit az --version), und der Cluster muss eine Managed Identity statt eines Service Principals verwenden. Außerdem brauchen Sie eine unterstützte Netzwerkkonfiguration, also Azure CNI im Overlay-Modus; Cilium ist die empfohlene Dataplane.
Um NAP auf einem neuen Cluster zu aktivieren, setzen Sie den Provisioning-Modus auf Auto und geben die Netzwerkeinstellungen mit an:
az aks create \ --name myCluster \ --resource-group myResourceGroup \ --node-provisioning-mode Auto \ --network-plugin azure \ --network-plugin-mode overlay \ --network-dataplane ciliumAuf einem bestehenden Cluster aktualisieren Sie den Provisioning-Modus:
az aks update \ --name myCluster \ --resource-group myResourceGroup \ --node-provisioning-mode AutoLäuft Ihr Cluster in einem benutzerdefinierten virtuellen Netzwerk, denken Sie an die Standard-Load-Balancer-Anforderung und weisen Sie der Managed Identity des Clusters die Rolle Network Contributor auf dem Ziel-VNet oder -Subnetz zu, damit Karpenter Nodes daran anbinden kann.
Sobald NAP aktiviert ist, verifizieren Sie es, indem Sie prüfen, ob die Karpenter-Ressourcen existieren, und anschließend ein Scale-up auslösen. Prüfen Sie mit kubectl api-resources | grep karpenter, ob die CRDs vorhanden sind, deployen Sie dann einen Workload und skalieren Sie ihn über die aktuelle Kapazität hinaus, sodass Pods im Pending-Status landen. Beobachten Sie, wie Karpenter reagiert:
kubectl get nodeclaimskubectl get nodes -wSie sollten sehen, wie ein NodeClaim erscheint, eine neue VM dem Cluster beitritt und die wartenden Pods darauf eingeplant werden.
NodePools für Kosten und Resilienz konfigurieren
Der NodePool steuert, wie Karpenter Kosten, Kapazität und Resilienz ausbalanciert:
a. VM-SKU-Familien, -Größen und -Generationen einschränken: Nutzen Sie die NodePool-Requirements, um Karpenter mitzuteilen, welche VMs es wählen darf. Sie können ganze Familien erlauben, überdimensionierte SKUs ausschließen oder neuere Generationen bevorzugen – so bleibt das Provisioning vorhersehbar, während Karpenter genug Spielraum behält, eine günstige Option zu finden. Eine breitere Auswahl erlaubter SKUs gibt Karpenter mehr Möglichkeiten, eine kosteneffiziente Lösung zu finden.
b. Spot- und On-Demand-Kapazität kombinieren: Karpenter kann über das Requirement karpenter.sh/capacity-type sowohl Spot- als auch On-Demand-VMs provisionieren. Mit separaten, gewichteten NodePool-Ressourcen können Sie günstige Spot-Kapazität bevorzugen und auf On-Demand ausweichen, wenn Spot nicht verfügbar ist. Hier entsteht ein großer Teil der Kosteneinsparungen für Workloads, die Unterbrechungen tolerieren.
c. Nodes über Availability Zones verteilen: Erlauben Sie in den NodePool-Requirements (topology.kubernetes.io/zone) mehrere Zonen, damit Karpenter Nodes zonenübergreifend platzieren kann – das schützt Ihre Workloads vor dem Ausfall einer einzelnen Zone.
d. Obergrenzen und Taints für spezielle Workloads setzen: Geben Sie jedem NodePool CPU- und Memory-Limits, um die provisionierbare Kapazität zu begrenzen, und nutzen Sie Taints, um einen NodePool für bestimmte Workloads wie GPU- oder Batch-Jobs zu reservieren – so landen nur Pods darauf, die den Taint tolerieren. Ein NodePool mit Requirements und Limits sieht so aus:
apiVersion: karpenter.sh/v1kind: NodePoolmetadata: name: generalspec: template: spec: requirements: - key: karpenter.sh/capacity-type operator: In values: ["spot", "on-demand"] - key: kubernetes.io/arch operator: In values: ["amd64"] nodeClassRef: name: default limits: cpu: "200" memory: 400GiKonsolidierung und Disruption steuern
Die consolidationPolicy im NodePool steuert die Konsolidierung. WhenEmpty entfernt einen Node nur, wenn er keine Workload-Pods mehr ausführt – die konservativere Option. WhenEmptyOrUnderutilized berücksichtigt auch Nodes, die laufen, aber nicht voll ausgelastet sind. Karpenter kann deren Pods auf andere Nodes verschieben und die wenig genutzten Nodes entfernen. Das spart mehr, verschiebt Pods aber möglicherweise häufiger. Die Einstellung consolidateAfter bestimmt, wie lange Karpenter wartet, bevor ein Node für die Konsolidierung in Frage kommt.
Karpenter verwaltet außerdem den Node-Lifecycle. Sie können Nodes nach einem bestimmten Alter ablaufen lassen, damit sie regelmäßig ersetzt werden. NAP übernimmt auch Node-Image-Updates und hält Nodes beim Cluster-Upgrade auf der Kubernetes-Version der Control Plane. Ein passender Auto-Upgrade-Channel und ein geplantes Wartungsfenster helfen dabei zu steuern, wann diese Updates stattfinden.
Um die Verfügbarkeit währenddessen zu schützen, kombinieren Sie drei Mechanismen. Disruption Budgets im NodePool begrenzen, wie viele Nodes Karpenter gleichzeitig unterbrechen darf. PodDisruptionBudgets schützen Ihre Workloads, indem sie begrenzen, wie viele ihrer Pods bei freiwilligen Unterbrechungen wie der Konsolidierung nicht verfügbar sein dürfen. Und die Annotation karpenter.sh/do-not-disrupt: "true" auf einem Pod oder Node weist Karpenter an, ihn unangetastet zu lassen – nützlich für Jobs, die keinesfalls unterbrochen werden dürfen.
Warum Pod Resource Requests darüber entscheiden, wie viel Karpenter einspart
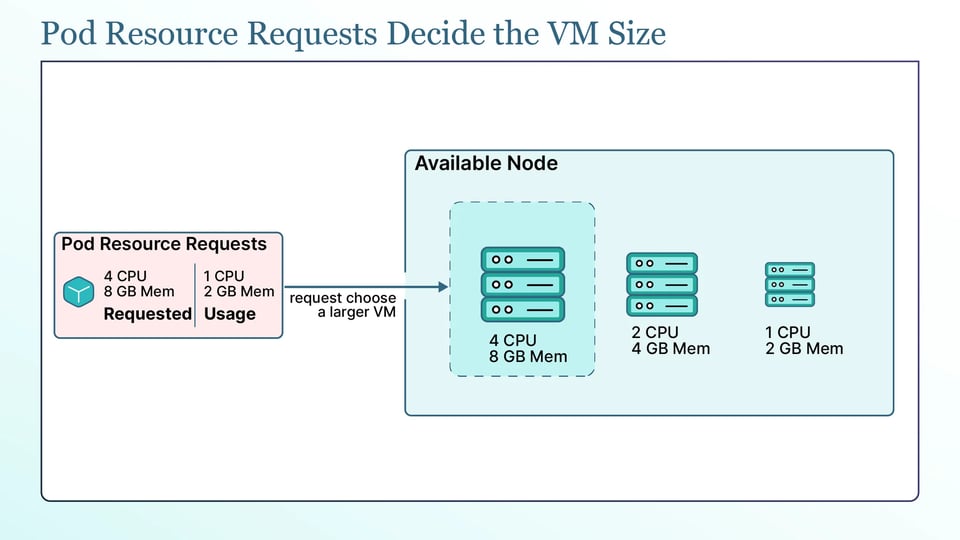
Karpenter provisioniert Nodes auf Basis der Pod Resource Requests, nicht der tatsächlichen Ressourcennutzung. Anhand dieser Requests wählt es eine VM, auf die die wartenden Pods passen – präzise Requests wirken sich also direkt darauf aus, wie viel Kapazität provisioniert wird und wie viel Sie zahlen.
Überhöhte Requests können dazu führen, dass Karpenter größere und teurere VM-SKUs wählt. Fordert ein Pod beispielsweise 4 CPUs und 8 GB Memory an, nutzt aber nur 1 CPU und 2 GB, muss Karpenter dennoch genügend Kapazität für die angeforderten 4 CPUs und 8 GB finden. Es wählt daher möglicherweise eine größere VM und bringt weniger Pods auf dem Node unter. Über den gesamten Cluster hinweg können überhöhte Requests zu ungenutzter Kapazität und höheren Kosten führen. Karpenter folgt schlicht den Ressourcenanforderungen, die Sie definiert haben.
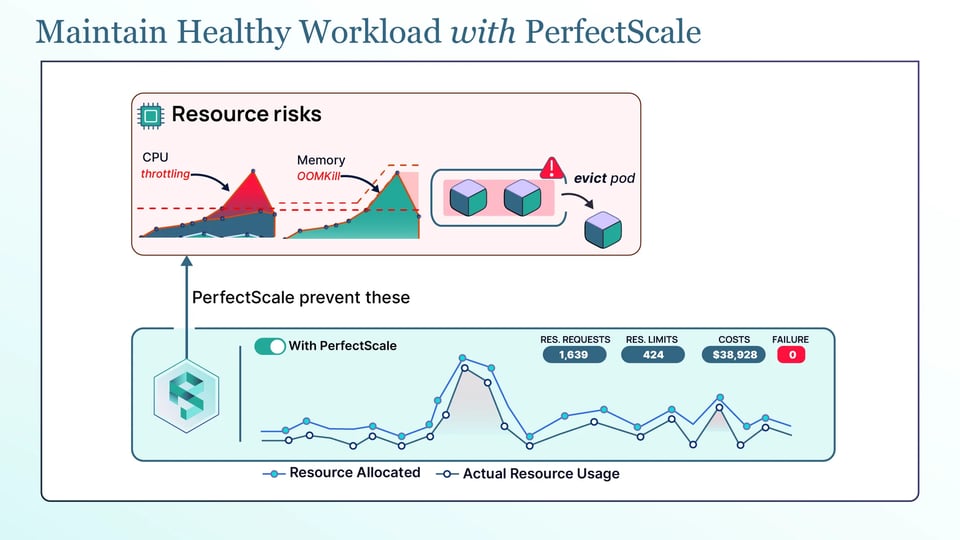
Genau hier zahlt sich kontinuierliches Right-Sizing aus. Die Kubernetes-Governance-Plattform von PerfectScale beobachtet, wie Ihre Workloads CPU und Memory tatsächlich nutzen, und macht daraus umsetzbare, automatisierte Right-Sizing-Empfehlungen, die Sie manuell oder autonom anwenden können. Präzise Requests sind es, die NAP seine Arbeit machen lassen: Mit Requests, die der Realität entsprechen, provisioniert Karpenter kleinere, günstigere VMs und packt sie dicht – so kommen die von NAP versprochenen Einsparungen tatsächlich auf Ihrer Rechnung an. Teams wie Paramount Pictures und Creditas setzen auf PerfectScale, um ihre Cluster effizient zu halten. Registrieren Sie sich oder buchen Sie eine technische Session.
NAP-Node-Aktivität, Provisioning-Latenz und Node-Kosten überwachen
Sobald NAP läuft, sollten Sie im Blick haben, was es tut. Beginnen Sie mit den NodeClaims: Sie zeigen, was Karpenter provisioniert, und machen die Provisioning-Aktivität in Echtzeit nachvollziehbar.
AKS stellt Karpenter-Events in den Control-Plane-Logs bereit (Kategorie karpenter-events) – hier schauen Sie nach, wenn ein Node nicht provisioniert oder registriert werden kann.
Für Metriken aktivieren Sie Control-Plane-Metriken über den Azure Monitor Managed Service for Prometheus, um das Verhalten von Karpenter inklusive Provisioning-Aktivität und -Latenz zu überwachen.
Kostentransparenz ist ebenso wichtig, denn NAP verändert den Mix der VM-SKUs im Cluster kontinuierlich. Tools wie Kubecost und OpenCost bieten eine grundlegende Kostenzuordnung, während PerfectScale zusätzlich ineffiziente Resource Requests und ungenutzte Kapazität identifizieren kann – so lässt sich die Kostenwirkung von NAP leichter messen.
Best Practices für den Betrieb von Karpenter auf AKS
Diese Best Practices sollten Sie kennen:
a. Pod Requests vor der Aktivierung von NAP richtig dimensionieren: Karpenter provisioniert Nodes auf Basis der Pod Resource Requests, präzise Requests haben also großen Einfluss auf die Kosten. Nehmen Sie zuerst das Right-Sizing vor, um nicht mehr Kapazität zu provisionieren, als Ihre Workloads benötigen.
b. NodePool-Requirements breit genug halten, um günstigere SKUs zu finden: Wer Karpenter auf ein oder zwei VM-Größen beschränkt, schränkt dessen Fähigkeit ein, kosteneffiziente Optionen zu finden. Erlauben Sie eine sinnvolle Bandbreite an VM-Familien und -Größen, damit Karpenter mehr Auswahl hat.
c. Ephemere OS-Disks und Spot-Kapazität für fehlertolerante Workloads nutzen: Ephemere OS-Disks können schnelleren Speicher bieten, Spot-VMs können deutlich weniger kosten als On-Demand-Kapazität. Beide haben Trade-offs – nutzen Sie sie also für Workloads, die Node-Ersetzungen oder Unterbrechungen verkraften. Kritische Workloads bleiben auf On-Demand-Kapazität, wenn Zuverlässigkeit wichtiger ist als Kosten.
d. NodePool-Limits definieren, um unkontrolliertes Provisioning zu verhindern: Setzen Sie immer CPU- und Memory-Limits auf Ihren NodePool-Ressourcen. Ohne sie könnte ein fehlkonfigurierter Workload oder ein außer Kontrolle geratenes Deployment dazu führen, dass Karpenter weit mehr Kapazität und Kosten provisioniert als beabsichtigt.
e. NodePools und AKSNodeClasses als Code verwalten: Pflegen Sie Ihre NodePool- und AKSNodeClass-Definitionen in Terraform oder Bicep zusammen mit dem Rest Ihrer Infrastruktur – so ist die Provisioning-Policy versioniert, reviewt und clusterübergreifend reproduzierbar, statt von Hand editiert zu werden.