


Karpenter on Azureは、必要なタイミングで最適なノードをAKSに作成させる仕組みです。VMサイズを事前に選んで固定のノードプールを管理する代わりに、Karpenterは保留中のPodを確認し、それらを最も低コストで実行できるVMを見つけて、必要なときにノードを作成します。AKSでは、これはNode Auto Provisioning(NAP)というマネージド機能として提供されており、2025年に一般提供が開始されました。
本ガイドでは、KarpenterがAKS上でノードをプロビジョニングする仕組み、マネージドのNAPとセルフホスト型Karpenterの違い、設定に使用するカスタムリソース、AWSプロバイダーやAKSクラスターオートスケーラーとの比較、有効化の手順、そしてコストと耐障害性のためのチューニング方法を解説します。
Karpenter on Azureとは
Karpenterは、同一構成のマシンを固定グループ単位でスケールするのではなく、Podが実際に必要とするリソースに基づいてノードをプロビジョニングするオープンソースのノードオートスケーラーです。Azureでは、AKSにおけるKarpenterのマネージド統合であるNode Auto Provisioning(NAP)を通じて利用します。NAPはクラスター上のKarpenterを自動的にデプロイ・設定・管理し、アップストリームのKarpenterプロジェクトと、Microsoftがメンテナンスを行うAKS Karpenterプロバイダーの上に構築されています。
違いはノードの選び方にあります。従来のノードプールでは、VMサイズを事前に決める必要があり、別のプールを作成してワークロードを移行しない限り、そのSKUから変更できません。NAPはこのステップを不要にします。スケジュールできないPodのリソースリクエストを確認し、それらを収容できる最もコスト効率の高いVM SKUを選択してプロビジョニングします。需要が減れば、より少ないノードに処理を集約し、不要になったノードを削除します。
KarpenterがAKS上でノードをプロビジョニングする仕組み
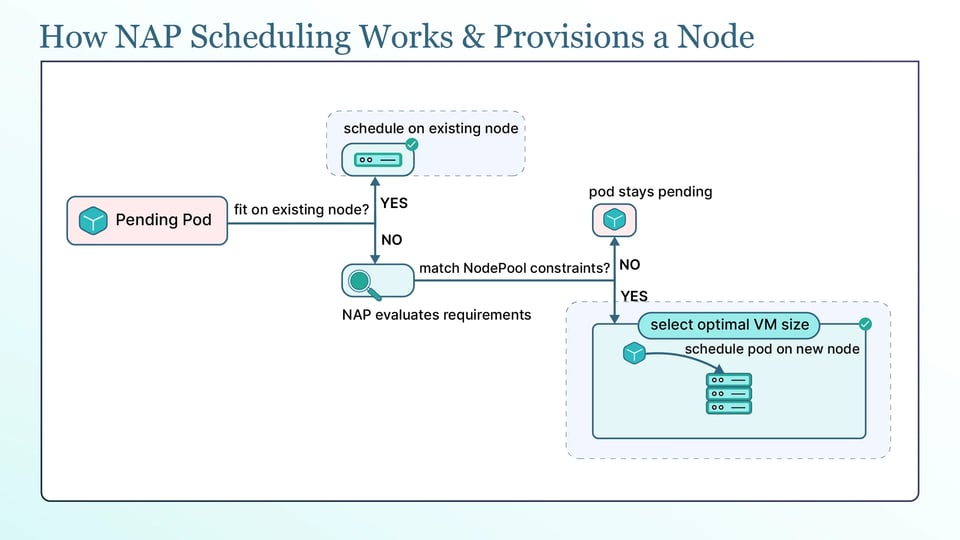
Karpenterはクラスター内のスケジュール不能なPodを監視します。Podが既存のノードに収まらない場合、KarpenterはそのCPU、メモリなどのリソースリクエストに加え、ノードセレクター、アフィニティ、tolerationといった制約を確認します。これらの情報をもとにPodがどのようなノードを必要としているかを判断するため、正確なリソースリクエストが重要になります。
その後、Karpenterは適切なVM SKUを選択し、保留中のPodをそこに詰め込みます。固定の1種類のマシンタイプを使うのではなく、設定で許可されたVMサイズの中から、Podを収容できるコスト効率の良い選択肢を選びます。また、新しいノードにできるだけ多くのPodを配置し、未使用の容量を減らします。
Karpenterは、作成予定の各ノードをNodeClaimで表現します。NodeClaimは、Karpenterの判断と実際のVMを結び付けるものです。KarpenterがNodeClaimを作成すると、Azureプロバイダーが対応するVMを起動し、VMがクラスターに参加して、保留中のPodがそこにスケジュールされます。NodeClaimを確認すれば、Karpenterがどのノードをプロビジョニングしているかを把握できます。
Karpenterは、作成後のノードも管理します。使用率の低いノードのPodをより少ないノードに移動して集約し、不要になったノードを削除します。また、ノードイメージや設定の変更後など、ノードが望ましい構成と一致しなくなった場合にはドリフトを検出し、正しく構成されたノードに置き換えます。
Node Auto Provisioningとセルフホスト型Karpenterの比較
AKSでKarpenterを実行する方法は2つあり、どちらが適しているかは、自分たちでどこまで管理したいかによって決まります。
Node Auto Provisioning(NAP)は、KarpenterをマネージドなAKSアドオンとして実行します。MicrosoftがKarpenterコントローラーのデプロイと運用、アップグレードを担い、AKSの一部としてサポートを提供します。利用者は、ノードをどのようにプロビジョニングするかを定義するカスタムリソースを作成するだけです。ほとんどのチームにとって、こちらがシンプルな選択肢です。AKS Automaticクラスターでは、NAPがデフォルトで事前構成されており、対象となるPodの99.9%が5分以内にReady状態になることを保証するPod readiness SLAが含まれます。
セルフホスト型Karpenterでは、オープンソースのAKS Karpenterプロバイダーを自分でインストールして運用する必要があります。より細かな制御が可能になる一方、インストール、アップグレード、ID構成、日々の運用も自分たちで管理することになります。NAPとセルフホストのKarpenterコントローラーが同時にノードを管理することはできないため、クラスターは手動プロビジョニングを使用する必要があります。Azureプロバイダーは現在、Azure CNI OverlayとCiliumデータプレーンをサポートし、テスト済みです。
主な違いは、サポートと運用責任の所在にあります。NAPはMicrosoftによって管理・サポートされているため、ほとんどの本番ワークロードにとってより良い出発点となります。セルフホスト型Karpenterはコミュニティによるサポートとなるため、NAPでは提供されないカスタマイズが必要で、かつ自ら運用できるチームがいる場合に適しています。
AzureにおけるKarpenterのカスタムリソース
AKS上のKarpenterは、NodePoolとAKSNodeClassという2つのカスタムリソースを使用します。
NodePoolは、Karpenterがノードを作成する際に従うルールを定義します。使用できるVMファミリーとサイズ、Spotとオンデマンドのどちらの容量を使えるか、許可するCPUアーキテクチャと可用性ゾーン、遵守すべき上限などを指定します。集約とノードのライフサイクルを制御するdisruption設定も含まれます。
AKSNodeClassには、Azure固有のノード設定が含まれます。ノードのOSイメージ、OSディスクサイズ、ノードあたりの最大Pod数、ノードタグのほか、必要に応じて特定のサブネットにノードを配置するためのvnetSubnetIDなどを定義します。
簡単に言えば、NodePoolはKarpenterが何を作成できるかを定義し、AKSNodeClassはAzureノードをどのように構成するかを定義します。最小構成のAKSNodeClassは次のようになります:
apiVersion: karpenter.azure.com/v1beta1kind: AKSNodeClassmetadata: name: defaultspec: imageFamily: Ubuntu osDiskSizeGB: 128 tags: team: platformKarpenter on AzureとKarpenter on AWSの違い
EKSでKarpenterを使った経験のほとんどはAKSにもそのまま当てはまり、主な違いはクラウド固有のNodeClassにあります。NodePool APIはアップストリームのKarpenter由来のため、両クラウドで同様に動作します。要件、リソース上限、disruption設定の定義に使用します。NodeClassはプロバイダー固有で、AzureはAKSNodeClassを、AWSはEC2NodeClassを使用します。各NodeClassには、それぞれのクラウドに固有の設定が含まれます。AzureはVM SKUを、AWSはEC2インスタンスタイプをプロビジョニングするため、選択に使うラベルや値はプロバイダー間で異なります。
最大の違いはプロバイダーの成熟度です。AWSプロバイダーはより長く提供されており、機能も豊富です。一方、Azureプロバイダーは比較的新しく、すべてのAWS機能に完全に対応する同等機能があるとは限りません。プロビジョニング、集約、Spot容量、ドリフトといった中核機能はどちらもサポートしていますが、AWS固有の機能がAzureでも同じように動作すると想定する前に、ドキュメントを確認してください。
Node Auto ProvisioningとAKSクラスターオートスケーラーの比較
NAPとAKSクラスターオートスケーラーは、同じ課題を異なる方法で解決します。クラスターオートスケーラーは、事前に定義したノードプールの範囲内で動作します。保留中のPodを監視して固定プールを拡大・縮小しますが、追加できるのは事前に選んだVMサイズだけです。NAPにはそのような制約がありません。幅広いSKUの中から適切なサイズのVMをその場でプロビジョニングし、Podを効率よく詰め込み、積極的に集約するため、通常は無駄な容量が減り、手動でのプール設計も少なくて済みます。
重要なルールが1つあります。両者を同時に実行してはいけません。NAPとクラスターオートスケーラーはどちらもノード容量を管理しようとするため、NAPを有効化する際は、クラスターのオートスケーラーを無効化します。ノードのスケーリングは1つのシステムに任せましょう。
Node Auto Provisioningの制限事項と未サポート機能
NAPは本番環境で利用できる水準にありますが、すべてのAKS構成をサポートしているわけではありません。有効化する前に、以下の制限事項を確認する必要があります。
a. オペレーティングシステムとクラスタータイプ:Windowsノードプールはサポートされていないため、NAPがプロビジョニングするのはLinuxノードのみです。IPv6クラスターもサポートされていません。
b. IDとクラスター操作:サービスプリンシパルはサポートされていないため、クラスターはシステム割り当てまたはユーザー割り当てのマネージドIDを使用する必要があります。また、NAPを有効化したクラスターは停止できず、作成後にクラスターのアウトバウンド(egress)の種類を変更することもできません。
c. ネットワーク:NAPはAzure CNI Overlay、Ciliumを利用したAzure CNI Overlay、Azure CNIで動作し、MicrosoftはCiliumを利用したAzure CNIを推奨しています。Calicoネットワークポリシーと動的IP割り当てはサポートされていません。カスタム仮想ネットワークにNAPクラスターを作成する場合は、Basic Load Balancerがサポートされていないため、Standard Load Balancerを使用する必要があります。
AKSクラスターでNode Auto Provisioningを有効化する
NAPを有効化する前に、前提条件を満たしていることを確認してください。Azure CLIバージョン2.76.0以降が必要で、az --versionで確認できます。また、クラスターはサービスプリンシパルではなくマネージドIDを使用している必要があります。さらに、サポートされているネットワーク構成、つまりOverlayモードのAzure CNIが必要で、データプレーンにはCiliumが推奨されています。
新しいクラスターでNAPを有効化するには、ネットワーク設定とあわせてプロビジョニングモードをAutoに設定します:
az aks create \ --name myCluster \ --resource-group myResourceGroup \ --node-provisioning-mode Auto \ --network-plugin azure \ --network-plugin-mode overlay \ --network-dataplane cilium既存のクラスターで有効化するには、プロビジョニングモードを更新します:
az aks update \ --name myCluster \ --resource-group myResourceGroup \ --node-provisioning-mode Autoクラスターがカスタム仮想ネットワークで動作している場合は、Standard Load Balancerの要件に注意し、Karpenterがノードを接続できるよう、対象のVNetまたはサブネットに対してクラスターのマネージドIDにNetwork Contributorロールを付与してください。
NAPを有効化したら、Karpenterリソースの存在を確認したうえでスケールアップを発生させて動作を検証します。kubectl api-resources | grep karpenterでCRDが存在することを確認し、ワークロードをデプロイして現在の容量を超えるまでスケールさせ、Podを保留状態にします。Karpenterの反応を確認しましょう:
kubectl get nodeclaimskubectl get nodes -wNodeClaimが作成され、新しいVMがクラスターに参加し、保留中のPodがそこにスケジュールされる様子を確認できるはずです。
コストと耐障害性のためのNodePool設定
NodePoolは、Karpenterがコスト、容量、耐障害性のバランスをどう取るかを制御します:
a. VM SKUのファミリー、サイズ、世代を制限する:NodePoolのrequirementsを使って、Karpenterが選択できるVMを指定しましょう。ファミリー全体を許可したり、大きすぎるSKUを除外したり、新しい世代を優先したりできます。これにより、Karpenterに安価な選択肢を探す余地を残しつつ、プロビジョニングの予測可能性を保てます。許可するSKUの範囲が広いほど、Karpenterはコスト効率の良い選択肢を見つけやすくなります。
b. Spotとオンデマンド容量を組み合わせる:Karpenterはkarpenter.sh/capacity-typeのrequirementを通じてSpotとオンデマンドの両方のVMをプロビジョニングでき、重み付けした複数のNodePoolリソースを運用すれば、安価なSpot容量を優先しつつ、Spotが利用できないときはオンデマンドにフォールバックできます。中断を許容できるワークロードでは、ここから大きなコスト削減が生まれます。
c. ノードを複数の可用性ゾーンに分散させる:NodePoolのrequirements(topology.kubernetes.io/zone)で複数のゾーンを許可し、Karpenterがゾーンをまたいでノードを配置できるようにすることで、単一ゾーンの障害からワークロードを守れます。
d. 特殊なワークロード向けに上限とtaintを設定する:各NodePoolにCPUとメモリの上限を設定してプロビジョニング可能な容量を制限し、taintを使ってGPUジョブやバッチジョブなどの特定のワークロード専用にNodePoolを予約すれば、そのtaintを許容するPodだけがそれらのノードに配置されます。requirementsとlimitsを備えたNodePoolは次のようになります:
apiVersion: karpenter.sh/v1kind: NodePoolmetadata: name: generalspec: template: spec: requirements: - key: karpenter.sh/capacity-type operator: In values: ["spot", "on-demand"] - key: kubernetes.io/arch operator: In values: ["amd64"] nodeClassRef: name: default limits: cpu: "200" memory: 400Gi集約とdisruptionの制御
NodePoolのconsolidationPolicyが集約を制御します。WhenEmptyは、ワークロードのPodが存在しないノードのみを削除する、より保守的なオプションです。WhenEmptyOrUnderutilizedは、稼働中でも十分に使われていないノードも対象にします。KarpenterはそれらのPodを他のノードに移動して使用率の低いノードを削除できるため、より多くの節約が見込める一方、Podの移動頻度が上がる可能性があります。consolidateAfter設定は、Karpenterがノードを集約対象と見なすまでの待機時間を制御します。
Karpenterはノードのライフサイクルも管理します。一定の経過時間でノードを期限切れにして、定期的に置き換えるよう設定できます。NAPはノードイメージの更新にも対応し、クラスターをアップグレードするとノードをコントロールプレーンのKubernetesバージョンに合わせて維持します。適切な自動アップグレードチャネルと計画メンテナンスウィンドウを設定すれば、これらの更新がいつ実行されるかを制御しやすくなります。
これらの動作中も可用性を守るには、3つの制御を組み合わせて使いましょう。NodePoolのdisruption budgetは、Karpenterが一度に中断できるノード数を制限します。PodDisruptionBudgetは、集約などの自発的な中断の際に同時に利用不可となるPod数に上限を設けて、ワークロードを保護します。そして、Podやノードにkarpenter.sh/do-not-disrupt: "true"アノテーションを付与すると、Karpenterはその対象に一切干渉しなくなるため、中断してはならないジョブに有効です。
Podのリソースリクエストが節約額を左右する理由
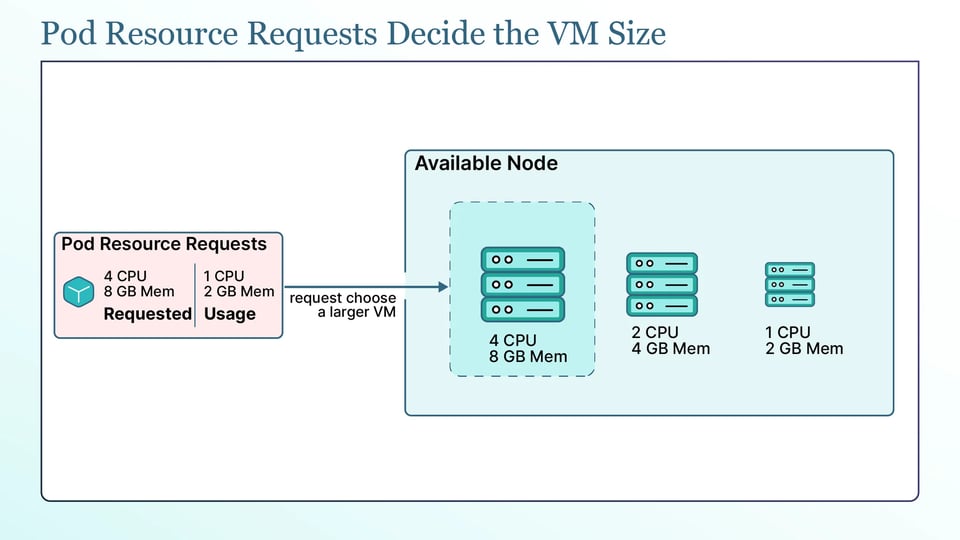
Karpenterは、実際のリソース使用量ではなく、Podのリソースリクエストに基づいてノードをプロビジョニングします。保留中のPodを収容できるVMの選択にリクエスト値を使用するため、リクエストの正確さは、プロビジョニングされる容量と支払うコストに直接影響します。
過大なリクエストは、Karpenterがより大きく高価なVM SKUを選択する原因になります。たとえば、あるPodが4 CPUと8 GBメモリをリクエストしながら実際には1 CPUと2 GBしか使っていない場合でも、Karpenterはリクエストされた4 CPUと8 GB分の容量を確保する必要があります。その結果、より大きなVMを選択し、ノードに載せられるPodの数が減る可能性があります。クラスター全体で見ると、過大なリクエストは未使用の容量とコストの増加につながります。Karpenterは、定義されたリソース要件に忠実に従っているだけなのです。
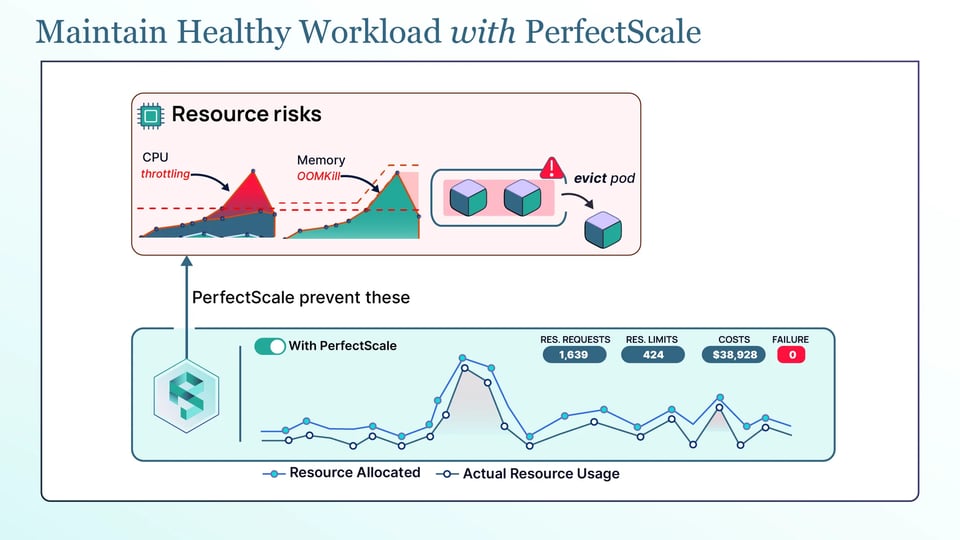
ここで効果を発揮するのが継続的なライトサイジングです。PerfectScaleのKubernetesガバナンスプラットフォームは、ワークロードが実際にCPUとメモリをどう使っているかを監視し、それを実行可能で自動化されたライトサイジングの推奨事項に変換します。推奨は手動でも自律的にも適用できます。NAPに正確なリクエストを与えることこそが、NAPの本来の力を引き出す鍵です。実態に合ったリクエストがあれば、Karpenterはより小さく安価なVMをプロビジョニングして高密度に詰め込むため、NAPが約束する節約が実際に請求額に反映されます。Paramount PicturesやCreditasといったチームがPerfectScaleでクラスターの効率を維持しています。サインアップ、またはテクニカルセッションの予約はこちらから。
NAPのノードアクティビティ、プロビジョニング遅延、ノードコストの監視
NAPの稼働を開始したら、その動作を把握できるようにしておきましょう。まずはNodeClaimから始めます。Karpenterが何をプロビジョニングしているかがわかり、プロビジョニングの動きをリアルタイムで確認できます。
AKSはKarpenterのイベントをコントロールプレーンログ(karpenter-eventsカテゴリ)に出力しており、ノードのプロビジョニングや登録が失敗した際の調査はここで行います。
メトリクスについては、Azure Monitor managed service for Prometheusでコントロールプレーンメトリクスを有効化すると、プロビジョニングのアクティビティや遅延など、Karpenterの挙動を監視できます。
NAPはクラスター内のVM SKUの構成を継続的に変化させるため、コストの可視性も同じくらい重要です。KubecostやOpenCostなどのツールで基本的なコスト配分は把握できますが、PerfectScaleは非効率なリソースリクエストや使用率の低い容量の特定にも役立つため、NAPのコストへの影響を測定しやすくなります。
AKSでKarpenterを運用するためのベストプラクティス
押さえておくべきベストプラクティスは以下のとおりです。
a. NAPを有効化する前にPodリクエストをライトサイジングする:KarpenterはPodのリソースリクエストに基づいてノードをプロビジョニングするため、リクエストの正確さはコストに大きく影響します。ワークロードが必要とする以上の容量をプロビジョニングしないよう、まずリクエストを適正化しましょう。
b. 安価なSKUを見つけられるようNodePoolのrequirementsは十分広く保つ:Karpenterを1〜2種類のVMサイズに制限すると、コスト効率の良い選択肢を見つける能力が損なわれます。Karpenterに多くの選択肢を与えられるよう、適度な範囲のVMファミリーとサイズを許可しましょう。
c. 障害耐性のあるワークロードにはエフェメラルOSディスクとSpot容量を使う:エフェメラルOSディスクはより高速なストレージを提供でき、Spot VMはオンデマンド容量よりはるかに低コストになる可能性があります。どちらにもトレードオフがあるため、ノードの置き換えや中断に耐えられるワークロードに使いましょう。コストより信頼性が重要なクリティカルなワークロードは、オンデマンド容量に置いてください。
d. 想定外のプロビジョニングを防ぐためNodePoolのlimitsを定義する:NodePoolリソースには必ずCPUとメモリのlimitsを設定してください。これがないと、ワークロードの設定ミスや暴走したデプロイによって、意図をはるかに超える容量とコストをKarpenterがプロビジョニングしてしまう恐れがあります。
e. NodePoolとAKSNodeClassをコードとして管理する:NodePoolとAKSNodeClassの定義は、他のインフラと同様にTerraformやBicepで管理しましょう。これにより、プロビジョニングポリシーがバージョン管理・レビューの対象となり、手作業での編集ではなく、クラスター間で再現可能な形で運用できます。