


Karpenter sur Azure aide AKS à créer les bons nœuds au bon moment. Au lieu de choisir des tailles de VM à l'avance et de gérer des pools de nœuds fixes, Karpenter analyse les pods en attente, identifie une VM capable de les exécuter au meilleur coût et crée le nœud lorsque c'est nécessaire. Sur AKS, cette fonctionnalité est proposée sous forme managée sous le nom de Node Auto Provisioning (NAP), passé en disponibilité générale en 2025.
Dans ce guide, vous découvrirez comment Karpenter provisionne les nœuds sur AKS, la différence entre le NAP managé et Karpenter auto-hébergé, les ressources personnalisées qui servent à le configurer, comment il se compare au provider AWS et au cluster autoscaler d'AKS, comment l'activer et comment l'optimiser pour le coût et la résilience.
Qu'est-ce que Karpenter sur Azure ?
Karpenter est un autoscaler de nœuds open source qui provisionne des nœuds en fonction des besoins réels de vos pods, plutôt que de faire évoluer des groupes fixes de machines identiques. Sur Azure, vous l'utilisez via Node Auto Provisioning (NAP), l'intégration managée de Karpenter dans AKS. NAP déploie, configure et gère automatiquement Karpenter sur votre cluster, et repose sur le projet Karpenter upstream et sur le provider Karpenter pour AKS maintenu par Microsoft.
La différence réside dans la façon dont les nœuds sont choisis. Avec les pools de nœuds traditionnels, vous décidez de la taille des VM à l'avance et vous restez lié à ce SKU, à moins de créer un autre pool et d'y migrer vos workloads. NAP supprime cette étape : il analyse les demandes de ressources des pods qui ne peuvent pas être planifiés, sélectionne le SKU de VM le plus rentable capable de les accueillir et le provisionne. Lorsque la demande diminue, il consolide les workloads sur moins de nœuds et supprime ceux qui ne sont plus nécessaires.
Comment Karpenter provisionne-t-il les nœuds sur AKS ?
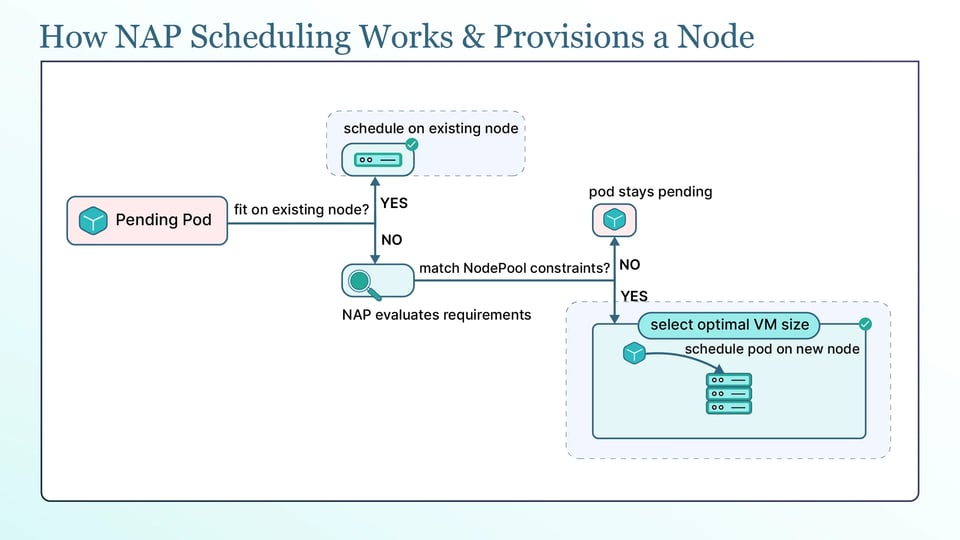
Karpenter surveille le cluster à la recherche de pods non planifiables. Lorsqu'un pod ne peut pas être placé sur un nœud existant, Karpenter examine ses demandes de CPU, de mémoire et d'autres ressources, ainsi que ses contraintes telles que les node selectors, l'affinité et les tolerations. Ces informations aident Karpenter à déterminer le type de nœud dont le pod a besoin, d'où l'importance de définir des requests de ressources précises.
Karpenter sélectionne ensuite un SKU de VM adapté et y regroupe les pods en attente. Plutôt que d'utiliser un type de machine fixe, Karpenter considère les tailles de VM autorisées par votre configuration et choisit une option rentable capable d'accueillir les pods. Il s'efforce également de placer autant de pods que possible sur le nouveau nœud, ce qui réduit la capacité inutilisée.
Karpenter représente chaque nœud planifié par un NodeClaim. Le NodeClaim relie la décision de Karpenter à la VM réelle : Karpenter crée le NodeClaim, le provider Azure lance la VM correspondante, la VM rejoint le cluster et les pods en attente y sont planifiés. Vous pouvez consulter les NodeClaims pour voir quels nœuds Karpenter est en train de provisionner.
Karpenter gère aussi les nœuds après leur création. Il consolide les nœuds sous-utilisés en déplaçant les pods vers un nombre réduit de nœuds et en supprimant ceux qui ne sont plus nécessaires. Il détecte également la dérive (drift) lorsqu'un nœud ne correspond plus à la configuration souhaitée, par exemple après un changement d'image ou de configuration, et le remplace par un nœud correctement configuré.
Node Auto Provisioning ou Karpenter auto-hébergé sur Azure
Il existe deux façons d'exécuter Karpenter sur AKS, et le bon choix dépend du niveau de gestion que vous souhaitez assumer.
Node Auto Provisioning (NAP) exécute Karpenter en tant qu'add-on AKS managé. Microsoft déploie et exploite le contrôleur Karpenter, gère les mises à niveau et fournit le support dans le cadre d'AKS. Vous créez uniquement les ressources personnalisées qui définissent la façon dont les nœuds doivent être provisionnés. C'est l'option la plus simple pour la plupart des équipes. Sur les clusters AKS Automatic, NAP est préconfiguré par défaut et inclut un SLA de disponibilité des pods garantissant que 99,9 % des pods éligibles sont prêts en moins de cinq minutes.
Karpenter auto-hébergé implique d'installer et d'exploiter vous-même le provider Karpenter open source pour AKS. Vous gagnez en contrôle, mais vous gérez aussi l'installation, les mises à niveau, la configuration des identités et l'exploitation au quotidien. Le cluster doit utiliser le provisionnement manuel, car NAP et un contrôleur Karpenter auto-hébergé ne peuvent pas gérer les nœuds en même temps. Le provider Azure prend actuellement en charge — et est testé avec — Azure CNI Overlay et le dataplane Cilium.
La différence principale tient au support et à la responsabilité opérationnelle. NAP est managé et pris en charge par Microsoft, ce qui en fait le meilleur point de départ pour la plupart des workloads de production. Karpenter auto-hébergé s'appuie sur le support de la communauté et se justifie surtout lorsque vous avez besoin d'une personnalisation que NAP n'offre pas et que vous disposez d'une équipe prête à l'exploiter vous-même.
Les ressources personnalisées de Karpenter sur Azure
Karpenter sur AKS utilise deux ressources personnalisées : NodePool et AKSNodeClass.
Le NodePool définit les règles que Karpenter suit lors de la création des nœuds. Il précise les familles et tailles de VM utilisables, l'usage de capacité Spot ou à la demande, les architectures CPU et zones de disponibilité autorisées, ainsi que les limites à respecter. Il inclut aussi les paramètres de disruption qui contrôlent la consolidation et le cycle de vie des nœuds.
L'AKSNodeClass contient les paramètres de nœud spécifiques à Azure. Elle définit des détails tels que l'image OS du nœud, la taille du disque OS, le nombre maximal de pods par nœud, les tags du nœud et, en option, le vnetSubnetID pour placer les nœuds dans un sous-réseau spécifique.
En résumé, le NodePool définit ce que Karpenter peut créer, tandis que l'AKSNodeClass définit comment le nœud Azure est configuré. Une AKSNodeClass minimale ressemble à ceci :
apiVersion: karpenter.azure.com/v1beta1kind: AKSNodeClassmetadata: name: defaultspec: imageFamily: Ubuntu osDiskSizeGB: 128 tags: team: platformKarpenter sur Azure et Karpenter sur AWS : quelles différences ?
L'essentiel de ce que vous connaissez de Karpenter sur EKS s'applique aussi à AKS, la principale différence étant la NodeClass propre à chaque cloud. L'API NodePool provient du projet Karpenter upstream et fonctionne donc de manière similaire sur les deux clouds. Vous l'utilisez pour définir les exigences, les limites de ressources et les paramètres de disruption. La NodeClass est spécifique au provider : Azure utilise AKSNodeClass, tandis qu'AWS utilise EC2NodeClass. Chaque NodeClass contient des paramètres propres à son cloud. Azure provisionne des SKU de VM, tandis qu'AWS provisionne des types d'instances EC2 ; les labels et valeurs servant à les sélectionner diffèrent donc d'un provider à l'autre.
La principale différence tient à la maturité des providers. Le provider AWS existe depuis plus longtemps et prend en charge davantage de fonctionnalités, tandis que le provider Azure est plus récent et n'a pas forcément d'équivalent exact pour chaque fonctionnalité AWS. Les deux couvrent les capacités essentielles comme le provisionnement, la consolidation, la capacité Spot et le drift, mais consultez la documentation avant de supposer qu'une fonctionnalité propre à AWS fonctionne de la même manière sur Azure.
Node Auto Provisioning face au cluster autoscaler d'AKS
NAP et le cluster autoscaler d'AKS résolvent le même problème de manières différentes. Le cluster autoscaler agit au sein de pools de nœuds déjà définis : il surveille les pods en attente et ajuste la taille de ces pools fixes, mais il ne peut ajouter que les tailles de VM choisies à l'avance. NAP n'a pas cette contrainte. Il provisionne à la volée des VM correctement dimensionnées à partir d'un large éventail de SKU, y regroupe les pods de manière optimale (bin-packing) et consolide de façon agressive, ce qui se traduit généralement par moins de capacité gaspillée et moins de planification manuelle des pools.
Une règle importante : n'exécutez pas les deux en même temps. NAP et le cluster autoscaler cherchent tous deux à gérer la capacité des nœuds ; lorsque vous activez NAP, vous désactivez donc le cluster autoscaler sur le cluster. Laissez un seul système piloter le scaling des nœuds.
Limites du Node Auto Provisioning et fonctionnalités non prises en charge
NAP est prêt pour la production, mais il ne prend pas en charge toutes les configurations AKS. Vérifiez les limitations suivantes avant de l'activer :
a. Système d'exploitation et type de cluster : les pools de nœuds Windows ne sont pas pris en charge ; NAP ne provisionne donc que des nœuds Linux. Les clusters IPv6 ne sont pas pris en charge non plus.
b. Identité et opérations sur le cluster : les service principals ne sont pas pris en charge ; le cluster doit donc utiliser une identité managée affectée par le système ou par l'utilisateur. Vous ne pouvez pas non plus arrêter un cluster où NAP est activé, ni modifier le type de sortie (egress) du cluster après sa création.
c. Réseau : NAP fonctionne avec Azure CNI Overlay, Azure CNI Overlay avec Cilium et Azure CNI, et Microsoft recommande Azure CNI avec Cilium. La politique réseau Calico et l'allocation dynamique d'adresses IP ne sont pas prises en charge. Si vous créez un cluster NAP dans un réseau virtuel personnalisé, vous devez utiliser un Standard Load Balancer, le Basic Load Balancer n'étant pas pris en charge.
Activer le Node Auto Provisioning sur un cluster AKS
Avant d'activer NAP, assurez-vous de remplir les prérequis. Vous avez besoin d'Azure CLI en version 2.76.0 ou ultérieure (vérifiable avec az --version), et le cluster doit utiliser une identité managée plutôt qu'un service principal. Il vous faut également une configuration réseau prise en charge, c'est-à-dire Azure CNI en mode overlay, Cilium étant le dataplane recommandé.
Pour activer NAP sur un nouveau cluster, définissez le mode de provisionnement sur Auto ainsi que les paramètres réseau :
az aks create \ --name myCluster \ --resource-group myResourceGroup \ --node-provisioning-mode Auto \ --network-plugin azure \ --network-plugin-mode overlay \ --network-dataplane ciliumPour l'activer sur un cluster existant, mettez à jour le mode de provisionnement :
az aks update \ --name myCluster \ --resource-group myResourceGroup \ --node-provisioning-mode AutoSi votre cluster s'exécute dans un réseau virtuel personnalisé, n'oubliez pas l'exigence du Standard Load Balancer et accordez à l'identité managée du cluster le rôle Network Contributor sur le VNet ou le sous-réseau cible, afin que Karpenter puisse y attacher des nœuds.
Une fois NAP activé, vérifiez son fonctionnement en confirmant la présence des ressources Karpenter, puis en déclenchant un scale-up. Vérifiez la présence des CRD avec kubectl api-resources | grep karpenter, puis déployez un workload et faites-le monter en charge au-delà de la capacité actuelle afin que des pods passent en attente. Observez la réaction de Karpenter :
kubectl get nodeclaimskubectl get nodes -wVous devriez voir un NodeClaim apparaître, une nouvelle VM rejoindre le cluster et les pods en attente y être planifiés.
Configurer les NodePools pour concilier coûts et résilience
Le NodePool contrôle la façon dont Karpenter arbitre entre coût, capacité et résilience :
a. Restreindre les familles, tailles et générations de SKU de VM : utilisez les requirements du NodePool pour indiquer à Karpenter quelles VM il peut choisir. Vous pouvez autoriser des familles entières, exclure les SKU surdimensionnés ou privilégier les générations récentes, ce qui garde le provisionnement prévisible tout en laissant à Karpenter la latitude de trouver une option économique. Plus l'éventail de SKU autorisés est large, plus Karpenter a d'options pour trouver un choix rentable.
b. Combiner capacité Spot et à la demande : Karpenter peut provisionner des VM Spot et à la demande via le requirement karpenter.sh/capacity-type, et l'exécution de plusieurs ressources NodePool pondérées vous permet de privilégier la capacité Spot, moins chère, avec un repli sur la capacité à la demande lorsque le Spot n'est pas disponible. C'est là qu'une grande partie des économies se réalise pour les workloads tolérants aux interruptions.
c. Répartir les nœuds entre les zones de disponibilité : autorisez plusieurs zones dans les requirements du NodePool (topology.kubernetes.io/zone) afin que Karpenter puisse placer les nœuds dans différentes zones, ce qui protège vos workloads contre la défaillance d'une zone unique.
d. Définir des plafonds et des taints pour les workloads spécifiques : attribuez à chaque NodePool des limites de CPU et de mémoire pour plafonner la capacité qu'il peut provisionner, et utilisez des taints pour réserver un NodePool à des workloads spécifiques comme les jobs GPU ou batch, afin que seuls les pods tolérant la taint soient planifiés sur ces nœuds. Un NodePool avec requirements et limites ressemble à ceci :
apiVersion: karpenter.sh/v1kind: NodePoolmetadata: name: generalspec: template: spec: requirements: - key: karpenter.sh/capacity-type operator: In values: ["spot", "on-demand"] - key: kubernetes.io/arch operator: In values: ["amd64"] nodeClassRef: name: default limits: cpu: "200" memory: 400GiContrôler la consolidation et les interruptions
Le paramètre consolidationPolicy du NodePool contrôle la consolidation. WhenEmpty ne supprime un nœud que lorsqu'il n'héberge aucun pod de workload, ce qui en fait l'option la plus conservatrice. WhenEmptyOrUnderutilized prend aussi en compte les nœuds actifs mais sous-utilisés : Karpenter peut déplacer leurs pods vers d'autres nœuds et supprimer les nœuds sous-utilisés, ce qui permet d'économiser davantage mais peut entraîner des déplacements de pods plus fréquents. Le paramètre consolidateAfter détermine combien de temps Karpenter attend avant d'envisager la consolidation d'un nœud.
Karpenter gère aussi le cycle de vie des nœuds. Vous pouvez configurer l'expiration des nœuds après un certain âge afin qu'ils soient remplacés régulièrement. NAP gère également les mises à jour des images de nœuds et maintient les nœuds alignés sur la version Kubernetes du plan de contrôle lorsque vous mettez à niveau le cluster. Un canal de mise à niveau automatique adapté et une fenêtre de maintenance planifiée permettent de contrôler le moment où ces mises à jour ont lieu.
Pour préserver la disponibilité pendant que tout cela s'exécute, combinez trois mécanismes. Les disruption budgets du NodePool limitent le nombre de nœuds que Karpenter peut perturber simultanément. Les PodDisruptionBudgets protègent vos workloads en plafonnant le nombre de leurs pods pouvant être indisponibles lors d'interruptions volontaires comme la consolidation. Et l'annotation karpenter.sh/do-not-disrupt: "true" sur un pod ou un nœud indique à Karpenter de ne pas y toucher, ce qui est utile pour un job à ne surtout pas interrompre.
Pourquoi les requests de ressources des pods déterminent-elles les économies réalisées par Karpenter ?
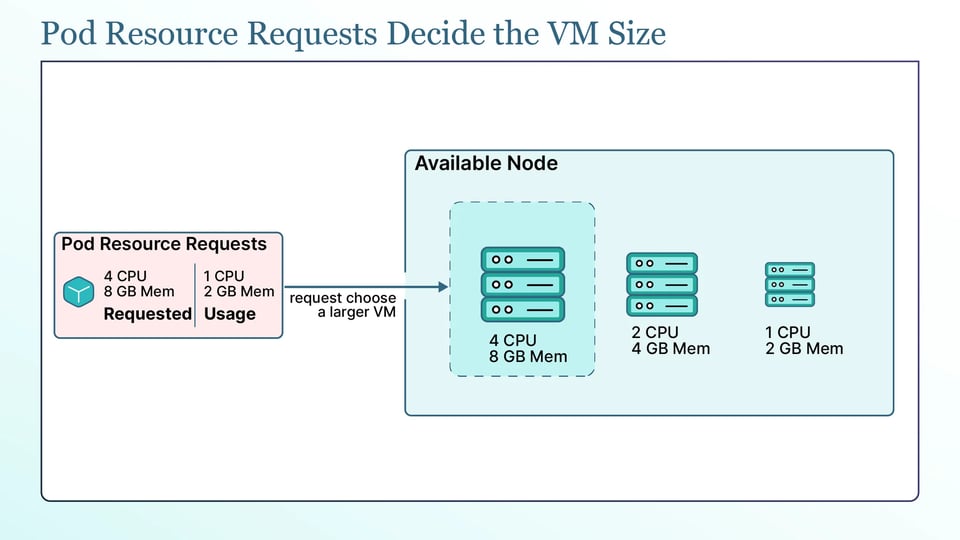
Karpenter provisionne les nœuds en fonction des requests de ressources des pods, et non de leur consommation réelle. Il s'appuie sur ces requests pour choisir une VM capable d'accueillir les pods en attente ; des requests précises influent donc directement sur la capacité provisionnée et sur votre facture.
Des requests surestimées peuvent amener Karpenter à choisir des SKU de VM plus grands et plus chers. Par exemple, si un pod demande 4 CPU et 8 Go de mémoire mais n'utilise que 1 CPU et 2 Go, Karpenter doit tout de même trouver la capacité correspondant aux 4 CPU et 8 Go demandés. Il peut donc choisir une VM plus grande et placer moins de pods sur le nœud. À l'échelle d'un cluster, des requests surestimées entraînent de la capacité inutilisée et des coûts plus élevés. Karpenter ne fait qu'appliquer les exigences de ressources que vous avez définies.
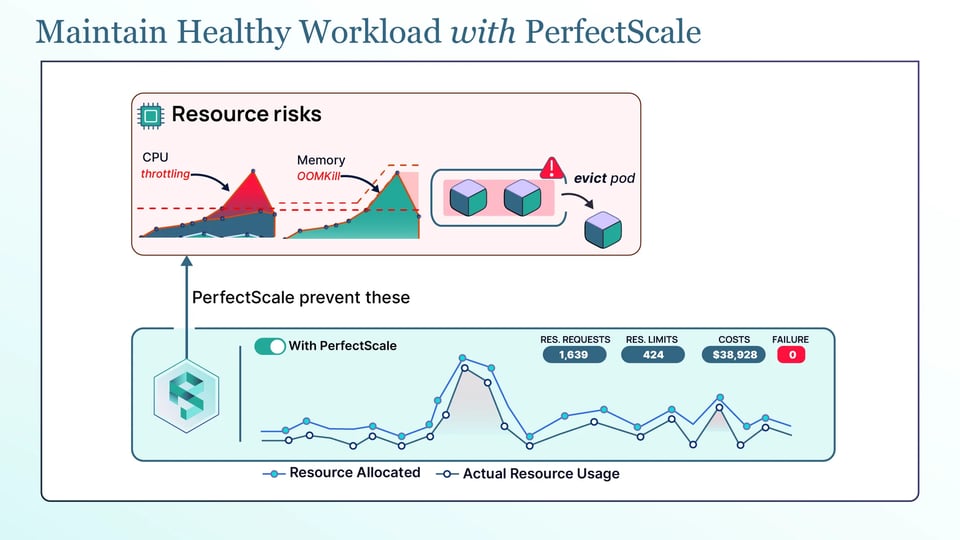
C'est là que le right-sizing continu prend tout son sens. La plateforme de gouvernance Kubernetes de PerfectScale observe la consommation réelle de CPU et de mémoire de vos workloads et la transforme en recommandations de right-sizing concrètes et automatisées, applicables manuellement ou de façon autonome. Fournir à NAP des requests précises est ce qui lui permet de faire son travail : avec des requests conformes à la réalité, Karpenter provisionne des VM plus petites et moins chères et les remplit efficacement, si bien que les économies promises par NAP se retrouvent réellement sur votre facture. Des équipes comme Paramount Pictures et Creditas utilisent PerfectScale pour maintenir l'efficacité de leurs clusters ; vous pouvez créer un compte ou réserver une session technique.
Superviser l'activité des nœuds NAP, la latence de provisionnement et le coût des nœuds
Une fois NAP en place, vous avez besoin de visibilité sur ce qu'il fait. Commencez par les NodeClaims, qui montrent ce que Karpenter provisionne et vous permettent de suivre l'activité de provisionnement en temps réel.
AKS expose les événements Karpenter dans les journaux du plan de contrôle (catégorie karpenter-events) ; c'est là qu'il faut regarder lorsqu'un nœud ne parvient pas à se provisionner ou à s'enregistrer.
Côté métriques, activez les métriques du plan de contrôle via le service managé Azure Monitor pour Prometheus afin de superviser le comportement de Karpenter, y compris l'activité et la latence de provisionnement.
La visibilité sur les coûts est tout aussi importante, car NAP fait évoluer en permanence le mix de SKU de VM du cluster. Des outils comme Kubecost et OpenCost fournissent une allocation de coûts de base, tandis que PerfectScale aide aussi à identifier les requests de ressources inefficaces et la capacité sous-utilisée, ce qui facilite la mesure de l'impact de NAP sur les coûts.
Bonnes pratiques pour exécuter Karpenter sur AKS
Voici les bonnes pratiques à connaître :
a. Ajuster les requests des pods avant d'activer NAP : Karpenter provisionne les nœuds en fonction des requests de ressources des pods ; des requests précises ont donc un impact majeur sur les coûts. Commencez par les dimensionner correctement afin d'éviter de provisionner plus de capacité que vos workloads n'en ont besoin.
b. Garder des requirements de NodePool suffisamment larges pour trouver des SKU moins chers : restreindre Karpenter à une ou deux tailles de VM limite sa capacité à trouver des options rentables. Autorisez un éventail raisonnable de familles et de tailles de VM pour lui laisser plus de choix.
c. Utiliser des disques OS éphémères et de la capacité Spot pour les workloads tolérants aux pannes : les disques OS éphémères offrent un stockage plus rapide, et les VM Spot peuvent coûter bien moins cher que la capacité à la demande. Les deux impliquent des compromis : réservez-les aux workloads capables de supporter le remplacement ou l'interruption d'un nœud. Gardez les workloads critiques sur de la capacité à la demande lorsque la fiabilité prime sur le coût.
d. Définir des limites de NodePool pour plafonner le provisionnement : définissez toujours des limites de CPU et de mémoire sur vos ressources NodePool. Sans elles, un workload mal configuré ou un déploiement hors de contrôle pourrait amener Karpenter à provisionner bien plus de capacité — et de coûts — que prévu.
e. Gérer les NodePools et les AKSNodeClasses comme du code : conservez vos définitions de NodePool et d'AKSNodeClass dans Terraform ou Bicep avec le reste de votre infrastructure, afin que la politique de provisionnement soit versionnée, revue et reproductible d'un cluster à l'autre plutôt que modifiée à la main.