


Karpenter su Azure aiuta AKS a creare i nodi giusti nel momento in cui servono. Invece di scegliere in anticipo le dimensioni delle VM e gestire node pool fissi, Karpenter analizza i pod in attesa, individua una VM in grado di eseguirli al costo più basso e crea il nodo quando serve. Su AKS, questa funzionalità è disponibile come feature gestita chiamata Node Auto Provisioning (NAP), che ha raggiunto la disponibilità generale nel 2025.
In questa guida scoprirai come Karpenter effettua il provisioning dei nodi su AKS, la differenza tra NAP gestito e Karpenter self-hosted, le custom resource da usare per configurarlo, come si posiziona rispetto al provider AWS e al cluster autoscaler di AKS, come abilitarlo e come ottimizzarlo per costi e resilienza.
Cos'è Karpenter su Azure?
Karpenter è un node autoscaler open source che effettua il provisioning dei nodi in base a ciò di cui i pod hanno effettivamente bisogno, invece di scalare gruppi fissi di macchine identiche. Su Azure lo si utilizza tramite il Node Auto Provisioning (NAP), l'integrazione gestita di Karpenter in AKS. NAP distribuisce, configura e gestisce automaticamente Karpenter sul cluster ed è basato sul progetto Karpenter upstream e sul provider Karpenter per AKS mantenuto da Microsoft.
La differenza sta nel modo in cui vengono scelti i nodi. Con i node pool tradizionali, decidi la dimensione della VM in anticipo e rimani vincolato a quello SKU, a meno di creare un altro pool e migrarvi i workloads. NAP elimina questo passaggio: analizza le resource request dei pod che non possono essere schedulati, sceglie lo SKU di VM più conveniente in grado di ospitarli ed effettua il provisioning. Quando la domanda cala, consolida il lavoro su un numero inferiore di nodi e rimuove quelli non più necessari.
In che modo Karpenter effettua il provisioning dei nodi su AKS?
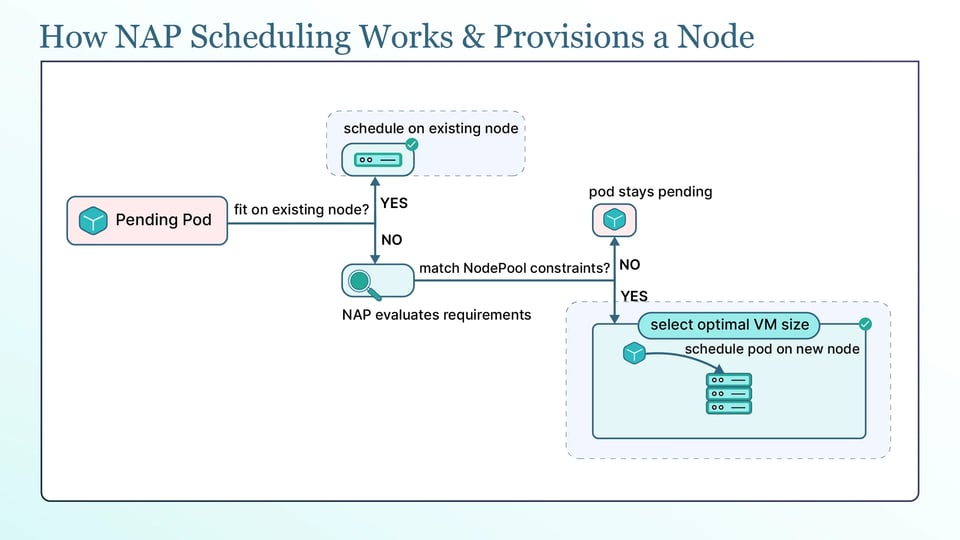
Karpenter monitora il cluster alla ricerca di pod non schedulabili. Quando un pod non trova posto su un nodo esistente, Karpenter ne analizza le richieste di CPU, memoria e altre risorse, insieme a vincoli come node selector, affinity e toleration. Questi dettagli aiutano Karpenter a decidere di che tipo di nodo ha bisogno il pod, ed è per questo che resource request accurate sono importanti.
Karpenter seleziona quindi uno SKU di VM adeguato e vi impacchetta i pod in attesa. Invece di usare un unico tipo di macchina fisso, Karpenter valuta le dimensioni di VM consentite dalla tua configurazione e sceglie un'opzione conveniente in grado di ospitare i pod. Cerca inoltre di collocare quanti più pod possibile sul nuovo nodo, riducendo la capacità inutilizzata.
Karpenter rappresenta ogni nodo pianificato con un NodeClaim. Il NodeClaim collega la decisione di Karpenter alla VM effettiva. Karpenter crea il NodeClaim, il provider Azure avvia la VM corrispondente, la VM entra nel cluster e i pod in attesa vengono schedulati su di essa. Puoi controllare i NodeClaim per vedere di quali nodi Karpenter sta effettuando il provisioning.
Karpenter gestisce i nodi anche dopo la loro creazione. Consolida i nodi sottoutilizzati spostando i pod su un numero inferiore di nodi e rimuovendo quelli non più necessari. Rileva inoltre il drift quando un nodo non corrisponde più alla configurazione desiderata, ad esempio dopo una modifica dell'immagine o della configurazione del nodo, e lo sostituisce con uno configurato correttamente.
Node Auto Provisioning vs Karpenter self-hosted su Azure
Esistono due modi per eseguire Karpenter su AKS, e la scelta giusta dipende da quanto vuoi gestire in autonomia.
Il Node Auto Provisioning (NAP) esegue Karpenter come add-on gestito di AKS. Microsoft distribuisce ed esegue il controller Karpenter, ne gestisce gli aggiornamenti e fornisce supporto come parte di AKS. Devi solo creare le custom resource che definiscono come vuoi che avvenga il provisioning dei nodi. Per la maggior parte dei team è l'opzione più semplice. Sui cluster AKS Automatic, NAP è preconfigurato di default e include uno SLA di pod readiness che garantisce che il 99,9% dei pod idonei diventi pronto entro cinque minuti.
Con Karpenter self-hosted devi installare ed eseguire tu stesso il provider Karpenter open source per AKS. Ottieni più controllo, ma gestisci anche installazione, aggiornamenti, configurazione delle identità e operatività quotidiana. Il cluster deve usare il provisioning manuale, perché NAP e un controller Karpenter self-hosted non possono gestire i nodi contemporaneamente. Il provider Azure attualmente supporta ed è testato con Azure CNI Overlay e il dataplane Cilium.
La differenza principale si riduce a supporto e responsabilità operativa. NAP è gestito e supportato da Microsoft, il che lo rende il punto di partenza migliore per la maggior parte dei workloads di produzione. Karpenter self-hosted è supportato dalla community e ha più senso quando servono personalizzazioni che NAP non offre e si dispone di un team pronto a gestirlo in autonomia.
Le custom resource di Karpenter su Azure
Karpenter su AKS usa due custom resource: NodePool e AKSNodeClass.
Il NodePool definisce le regole che Karpenter segue nella creazione dei nodi. Specifica quali famiglie e dimensioni di VM può utilizzare, se può usare capacità Spot o on-demand, quali architetture CPU e zone di disponibilità sono consentite e i limiti da rispettare. Include anche le impostazioni di disruption che controllano il consolidamento e il ciclo di vita dei nodi.
L'AKSNodeClass contiene le impostazioni dei nodi specifiche di Azure. Definisce dettagli come l'immagine del sistema operativo del nodo, la dimensione del disco del sistema operativo, il numero massimo di pod per nodo, i tag del nodo e, facoltativamente, il vnetSubnetID per collocare i nodi in una subnet specifica.
In parole semplici, il NodePool definisce cosa Karpenter può creare, mentre l'AKSNodeClass definisce come viene configurato il nodo Azure. Un AKSNodeClass minimale si presenta così:
apiVersion: karpenter.azure.com/v1beta1kind: AKSNodeClassmetadata: name: defaultspec: imageFamily: Ubuntu osDiskSizeGB: 128 tags: team: platformKarpenter su Azure vs Karpenter su AWS
Gran parte di ciò che sai dall'uso di Karpenter su EKS vale anche per AKS: la differenza principale è la NodeClass specifica del cloud. L'API NodePool proviene da Karpenter upstream, quindi funziona in modo simile su entrambi i cloud. La usi per definire requisiti, limiti di risorse e impostazioni di disruption. La NodeClass è specifica del provider: Azure usa AKSNodeClass, mentre AWS usa EC2NodeClass. Ogni NodeClass contiene impostazioni specifiche del proprio cloud. Azure effettua il provisioning di SKU di VM, mentre AWS di tipi di istanza EC2, quindi le label e i valori usati per selezionarli differiscono tra i provider.
La differenza principale è la maturità del provider. Il provider AWS è disponibile da più tempo e supporta più funzionalità, mentre il provider Azure è più recente e potrebbe non avere un equivalente esatto per ogni funzionalità AWS. Entrambi supportano le capacità di base come provisioning, consolidamento, capacità Spot e drift, ma consulta la documentazione prima di dare per scontato che una funzionalità specifica di AWS funzioni allo stesso modo su Azure.
Node Auto Provisioning vs cluster autoscaler di AKS
NAP e il cluster autoscaler di AKS risolvono lo stesso problema in modi diversi. Il cluster autoscaler opera all'interno dei node pool che hai già definito: monitora i pod in attesa e ridimensiona quei pool fissi verso l'alto o verso il basso, ma può solo aggiungere altre istanze delle dimensioni di VM scelte in anticipo. NAP non ha questo vincolo: effettua al volo il provisioning di VM dimensionate correttamente da un ampio insieme di SKU, vi impacchetta i pod e consolida in modo aggressivo, il che di solito si traduce in meno capacità sprecata e meno pianificazione manuale dei pool.
C'è una regola importante: non si eseguono entrambi. NAP e il cluster autoscaler cercano entrambi di gestire la capacità dei nodi, quindi quando abiliti NAP devi disabilitare il cluster autoscaler sul cluster. Lascia che un solo sistema sia responsabile dello scaling dei nodi.
Limitazioni e funzionalità non supportate del Node Auto Provisioning
NAP è pronto per la produzione, ma non supporta ogni configurazione di AKS. Le seguenti limitazioni vanno verificate prima di abilitarlo:
a. Sistema operativo e tipo di cluster: i node pool Windows non sono supportati, quindi NAP effettua il provisioning solo di nodi Linux. Anche i cluster IPv6 non sono supportati.
b. Identità e operazioni sul cluster: i service principal non sono supportati, quindi il cluster deve usare un'identità gestita assegnata dal sistema o dall'utente. Inoltre non è possibile arrestare un cluster con NAP abilitato, né modificare l'outbound type del cluster dopo la creazione.
c. Networking: NAP funziona con Azure CNI Overlay, Azure CNI Overlay powered by Cilium e Azure CNI, e Microsoft consiglia Azure CNI con Cilium. Le network policy Calico e l'allocazione dinamica degli IP non sono supportate. Se crei un cluster NAP in una rete virtuale personalizzata, devi usare uno Standard Load Balancer, perché il Basic Load Balancer non è supportato.
Abilitare il Node Auto Provisioning su un cluster AKS
Prima di abilitare NAP, assicurati di soddisfare i prerequisiti. Serve Azure CLI in versione 2.76.0 o successiva, verificabile con az --version, e il cluster deve usare un'identità gestita anziché un service principal. Serve inoltre una configurazione di rete supportata, ovvero Azure CNI in modalità overlay, con Cilium come dataplane consigliato.
Per abilitare NAP su un nuovo cluster, imposta la modalità di provisioning su Auto insieme alle impostazioni di rete:
az aks create \ --name myCluster \ --resource-group myResourceGroup \ --node-provisioning-mode Auto \ --network-plugin azure \ --network-plugin-mode overlay \ --network-dataplane ciliumPer abilitarlo su un cluster esistente, aggiorna la modalità di provisioning:
az aks update \ --name myCluster \ --resource-group myResourceGroup \ --node-provisioning-mode AutoSe il cluster viene eseguito in una rete virtuale personalizzata, ricorda il requisito dello Standard Load Balancer e assegna all'identità gestita del cluster il ruolo Network Contributor sulla VNet o subnet di destinazione, così che Karpenter possa collegarvi i nodi.
Una volta abilitato NAP, verificane il funzionamento confermando che le risorse Karpenter esistano e attivando poi uno scale-up. Controlla che le CRD siano presenti con kubectl api-resources | grep karpenter, quindi distribuisci un workload e scalalo oltre la capacità attuale in modo che i pod restino in attesa. Osserva la risposta di Karpenter:
kubectl get nodeclaimskubectl get nodes -wDovresti vedere comparire un NodeClaim, una nuova VM entrare nel cluster e i pod in attesa venire schedulati su di essa.
Configurare i NodePool per costi e resilienza
Il NodePool controlla come Karpenter bilancia costi, capacità e resilienza:
a. Limita famiglie, dimensioni e generazioni di SKU di VM: usa i requirement del NodePool per indicare a Karpenter quali VM può scegliere. Puoi consentire intere famiglie, escludere SKU sovradimensionati o preferire generazioni più recenti, mantenendo il provisioning prevedibile e lasciando comunque a Karpenter margine per trovare una soluzione economica. Un insieme più ampio di SKU consentiti dà a Karpenter più opzioni per trovare una soluzione conveniente.
b. Combina capacità Spot e on-demand: Karpenter può effettuare il provisioning sia di VM Spot che on-demand tramite il requirement karpenter.sh/capacity-type, ed eseguire risorse NodePool separate con pesi diversi ti consente di privilegiare la capacità Spot più economica e ripiegare sull'on-demand quando lo Spot non è disponibile. È qui che si concentra gran parte del risparmio per i workloads che tollerano le interruzioni.
c. Distribuisci i nodi tra le zone di disponibilità: consenti più zone nei requirement del NodePool (topology.kubernetes.io/zone) così che Karpenter possa collocare i nodi in zone diverse, proteggendo i tuoi workloads dal guasto di una singola zona.
d. Imposta tetti e taint per i workloads speciali: assegna a ogni NodePool limiti di CPU e memoria per porre un tetto alla capacità di cui può effettuare il provisioning, e usa i taint per riservare un NodePool a workloads specifici, come job GPU o batch, in modo che solo i pod che tollerano il taint finiscano su quei nodi. Un NodePool con requirement e limiti si presenta così:
apiVersion: karpenter.sh/v1kind: NodePoolmetadata: name: generalspec: template: spec: requirements: - key: karpenter.sh/capacity-type operator: In values: ["spot", "on-demand"] - key: kubernetes.io/arch operator: In values: ["amd64"] nodeClassRef: name: default limits: cpu: "200" memory: 400GiControllare il consolidamento e la disruption
La consolidationPolicy nel NodePool controlla il consolidamento. WhenEmpty rimuove un nodo solo quando non ha pod di workload, ed è quindi l'opzione più conservativa. WhenEmptyOrUnderutilized considera anche i nodi attivi ma non pienamente utilizzati: Karpenter può spostarne i pod su altri nodi e rimuovere quelli sottoutilizzati, il che può far risparmiare di più ma può comportare spostamenti di pod più frequenti. L'impostazione consolidateAfter controlla per quanto tempo Karpenter attende prima di considerare un nodo per il consolidamento.
Karpenter gestisce anche il ciclo di vita dei nodi. Puoi impostare i nodi in modo che scadano dopo un determinato periodo, così da essere sostituiti regolarmente. NAP gestisce inoltre gli aggiornamenti delle immagini dei nodi e mantiene i nodi allineati alla versione Kubernetes del control plane quando aggiorni il cluster. Un canale di auto-upgrade appropriato e una finestra di manutenzione pianificata aiutano a controllare quando avvengono questi aggiornamenti.
Per proteggere la disponibilità mentre tutto questo avviene, usa tre controlli insieme. I disruption budget nel NodePool limitano quanti nodi Karpenter può interrompere contemporaneamente. I PodDisruptionBudget proteggono i tuoi workloads limitando quanti dei loro pod possono risultare indisponibili durante disruption volontarie come il consolidamento. E l'annotazione karpenter.sh/do-not-disrupt: "true" su un pod o un nodo dice a Karpenter di non toccarlo, utile per un job che non deve essere interrotto.
Perché le resource request dei pod determinano quanto risparmia Karpenter?
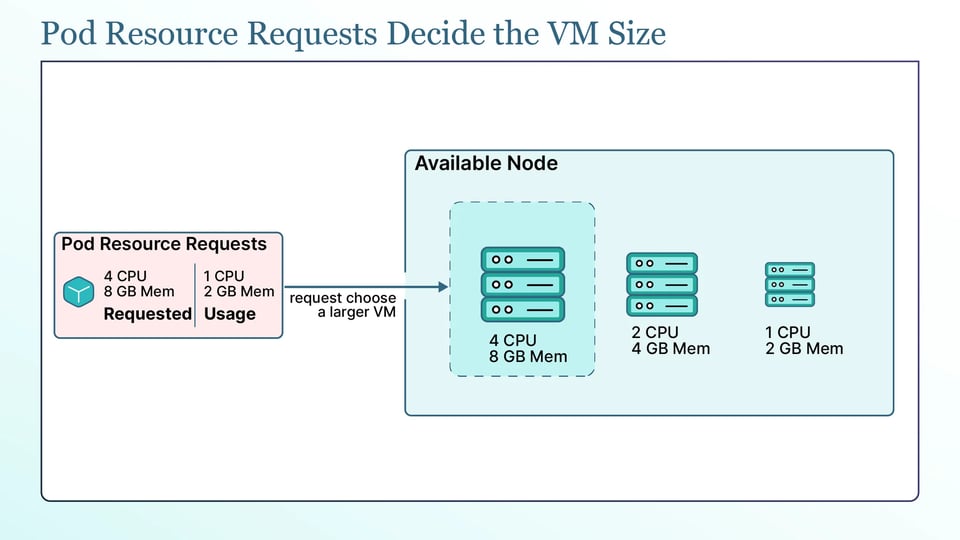
Karpenter effettua il provisioning dei nodi in base alle resource request dei pod, non all'utilizzo effettivo delle risorse. Usa quelle request per scegliere una VM in grado di ospitare i pod in attesa, quindi request accurate influiscono direttamente sulla capacità di cui viene effettuato il provisioning e su quanto paghi.
Request gonfiate possono spingere Karpenter a scegliere SKU di VM più grandi e costosi. Ad esempio, se un pod richiede 4 CPU e 8 GB di memoria ma usa solo 1 CPU e 2 GB, Karpenter deve comunque trovare capacità sufficiente per le 4 CPU e gli 8 GB richiesti. Potrebbe quindi scegliere una VM più grande e collocare meno pod sul nodo. A livello di cluster, request gonfiate possono portare a capacità inutilizzata e costi più alti. Karpenter si limita a rispettare i requisiti di risorse che hai definito.
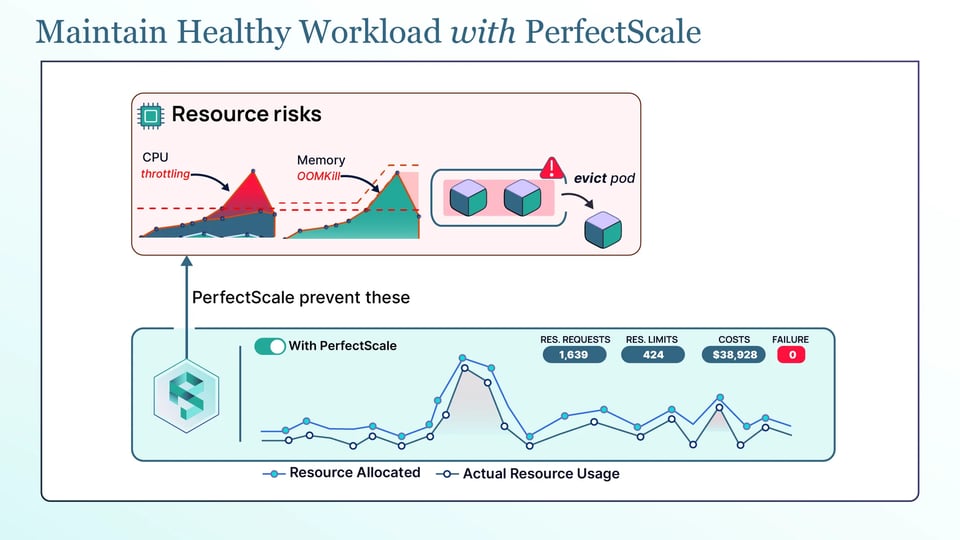
È qui che il right-sizing continuo ripaga. La piattaforma di governance Kubernetes di PerfectScale osserva come i tuoi workloads usano effettivamente CPU e memoria e trasforma questi dati in raccomandazioni di right-sizing concrete e automatizzate, applicabili manualmente o in modo autonomo. Fornire a NAP request accurate è ciò che gli permette di fare il suo lavoro: con request che rispecchiano la realtà, Karpenter effettua il provisioning di VM più piccole ed economiche e le impacchetta in modo compatto, così i risparmi promessi da NAP si vedono davvero in fattura. Team come Paramount Pictures e Creditas usano PerfectScale per mantenere efficienti i loro cluster: puoi registrarti o prenotare una sessione tecnica.
Monitorare l'attività dei nodi NAP, la latenza di provisioning e il costo dei nodi
Una volta che NAP è attivo, ti serve visibilità su ciò che sta facendo. Parti dai NodeClaim, che mostrano di cosa Karpenter sta effettuando il provisioning e ti permettono di osservare l'attività in tempo reale.
AKS espone gli eventi di Karpenter nei log del control plane (la categoria karpenter-events), dove puoi indagare quando il provisioning o la registrazione di un nodo falliscono.
Per le metriche, abilita le metriche del control plane tramite Azure Monitor managed service for Prometheus per monitorare il comportamento di Karpenter, inclusi attività e latenza di provisioning.
La visibilità sui costi è altrettanto importante, perché NAP modifica continuamente il mix di SKU di VM nel cluster. Strumenti come Kubecost e OpenCost possono offrire un'allocazione dei costi di base, mentre PerfectScale può anche aiutare a individuare resource request inefficienti e capacità sottoutilizzata, rendendo più facile misurare l'impatto di NAP sui costi.
Best practice per eseguire Karpenter su AKS
Ecco le best practice da conoscere:
a. Applica il right-sizing alle request dei pod prima di abilitare NAP: Karpenter effettua il provisioning dei nodi in base alle resource request dei pod, quindi request accurate hanno un impatto notevole sui costi. Correggile prima, per evitare di effettuare il provisioning di più capacità di quanta ne serva ai tuoi workloads.
b. Mantieni i requirement del NodePool abbastanza ampi da trovare SKU più economici: limitare Karpenter a una o due dimensioni di VM ne riduce la capacità di trovare opzioni convenienti. Consenti una gamma ragionevole di famiglie e dimensioni di VM, così Karpenter ha più scelta.
c. Usa dischi OS effimeri e capacità Spot per i workloads tolleranti ai guasti: i dischi OS effimeri possono offrire storage più veloce, mentre le VM Spot possono costare molto meno della capacità on-demand. Entrambi comportano compromessi, quindi usali per i workloads in grado di gestire la sostituzione o l'interruzione dei nodi. Mantieni i workloads critici su capacità on-demand quando l'affidabilità conta più del costo.
d. Definisci limiti nei NodePool per evitare un provisioning fuori controllo: imposta sempre limiti di CPU e memoria sulle tue risorse NodePool. Senza di essi, un workload mal configurato o un deployment fuori controllo potrebbe spingere Karpenter a effettuare il provisioning di molta più capacità, e quindi costi, di quanto previsto.
e. Gestisci NodePool e AKSNodeClass come codice: mantieni le definizioni di NodePool e AKSNodeClass in Terraform o Bicep insieme al resto della tua infrastruttura, così la policy di provisioning è versionata, revisionata e replicabile tra i cluster invece di essere modificata a mano.