


O Karpenter no Azure ajuda o AKS a criar os nós certos quando eles são necessários. Em vez de escolher tamanhos de VM com antecedência e gerenciar node pools fixos, o Karpenter analisa os pods pendentes, encontra uma VM capaz de executá-los pelo menor custo e cria o nó quando necessário. No AKS, isso está disponível como um recurso gerenciado chamado Node Auto Provisioning (NAP), que entrou em disponibilidade geral em 2025.
Neste guia, você vai aprender como o Karpenter provisiona nós no AKS, a diferença entre o NAP gerenciado e o Karpenter self-hosted, os recursos personalizados usados para configurá-lo, como ele se compara ao provider da AWS e ao cluster autoscaler do AKS, como habilitá-lo e como ajustá-lo para custo e resiliência.
O que é o Karpenter no Azure?
O Karpenter é um autoscaler de nós open source que provisiona nós com base no que seus pods realmente precisam, em vez de escalar grupos fixos de máquinas idênticas. No Azure, você o usa por meio do Node Auto Provisioning (NAP), que é a integração gerenciada do Karpenter no AKS. O NAP implanta, configura e gerencia o Karpenter automaticamente no seu cluster, e é construído sobre o projeto upstream do Karpenter e o provider Karpenter para AKS mantido pela Microsoft.
A diferença está em como os nós são escolhidos. Com node pools tradicionais, você decide o tamanho da VM de antemão e fica preso a esse SKU, a menos que crie outro pool e migre os workloads para ele. O NAP elimina essa etapa. Ele analisa as solicitações de recursos dos pods que não podem ser agendados, escolhe o SKU de VM mais econômico que os comporta e o provisiona. Quando a demanda cai, ele consolida o trabalho em menos nós e remove os que não são mais necessários.
Como o Karpenter provisiona nós no AKS?
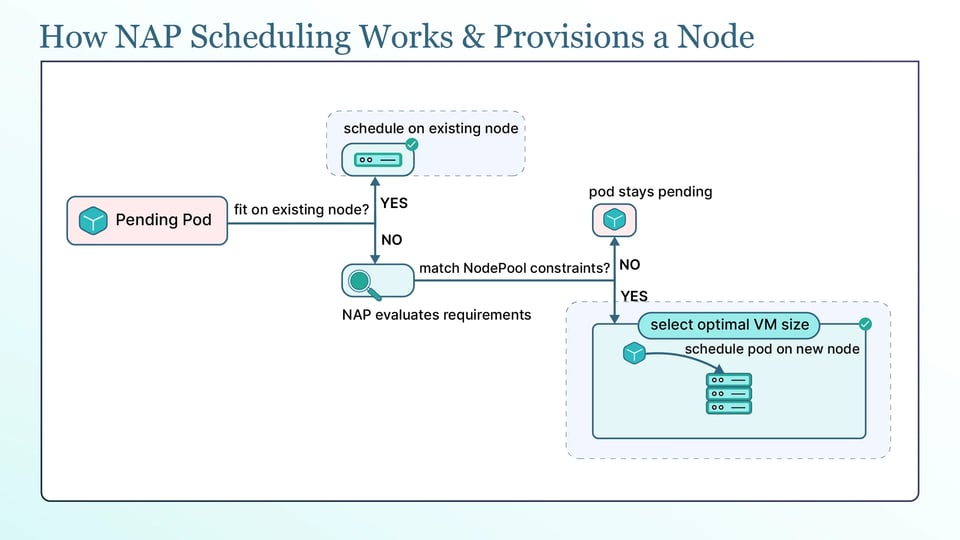
O Karpenter monitora o cluster em busca de pods não agendáveis. Quando um pod não cabe em nenhum nó existente, o Karpenter analisa suas solicitações de CPU, memória e outros recursos, além de restrições como node selectors, afinidade e tolerations. Esses detalhes ajudam o Karpenter a decidir de que tipo de nó o pod precisa, e é por isso que solicitações de recursos precisas são importantes.
Em seguida, o Karpenter seleciona um SKU de VM adequado e aloca os pods pendentes nele. Em vez de usar um tipo de máquina fixo, o Karpenter considera os tamanhos de VM permitidos pela sua configuração e escolhe uma opção econômica que comporte os pods. Ele também tenta colocar o maior número possível de pods no novo nó, reduzindo a capacidade ociosa.
O Karpenter representa cada nó planejado com um NodeClaim. O NodeClaim conecta a decisão do Karpenter à VM real. O Karpenter cria o NodeClaim, o provider do Azure inicia a VM correspondente, a VM entra no cluster e os pods pendentes são agendados nela. Você pode consultar os NodeClaims para ver quais nós o Karpenter está provisionando.
O Karpenter também gerencia os nós depois de criados. Ele consolida nós subutilizados movendo pods para menos nós e removendo os que não são mais necessários. Ele também detecta drift quando um nó deixa de corresponder à configuração desejada, como após uma mudança de imagem ou de configuração do nó, e o substitui por um nó configurado corretamente.
Node Auto Provisioning vs Karpenter self-hosted no Azure
Existem duas formas de rodar o Karpenter no AKS, e a escolha certa depende de quanto você quer gerenciar por conta própria.
O Node Auto Provisioning (NAP) executa o Karpenter como um add-on gerenciado do AKS. A Microsoft implanta e opera o controller do Karpenter, cuida das atualizações e oferece suporte como parte do AKS. Você só cria os recursos personalizados que definem como os nós devem ser provisionados. Essa é a opção mais simples para a maioria das equipes. Em clusters AKS Automatic, o NAP vem pré-configurado por padrão e inclui um SLA de prontidão de pods que garante que 99,9% dos pods qualificados fiquem prontos em até cinco minutos.
O Karpenter self-hosted exige que você mesmo instale e opere o provider Karpenter para AKS de código aberto. Você ganha mais controle, mas também gerencia instalação, upgrades, configuração de identidade e a operação contínua. O cluster precisa usar provisionamento manual, porque o NAP e um controller Karpenter self-hosted não podem gerenciar nós ao mesmo tempo. O provider do Azure atualmente oferece suporte e é testado com Azure CNI Overlay e o dataplane Cilium.
A principal diferença se resume a suporte e responsabilidade operacional. O NAP é gerenciado e suportado pela Microsoft, o que o torna o melhor ponto de partida para a maioria dos workloads de produção. O Karpenter self-hosted tem suporte da comunidade e faz mais sentido quando você precisa de personalizações que o NAP não oferece e tem uma equipe pronta para operá-lo.
Recursos personalizados do Karpenter no Azure
O Karpenter no AKS usa dois recursos personalizados: NodePool e AKSNodeClass.
O NodePool define as regras que o Karpenter segue ao criar nós. Ele especifica quais famílias e tamanhos de VM podem ser usados, se é permitido usar capacidade Spot ou sob demanda, quais arquiteturas de CPU e zonas de disponibilidade são permitidas e os limites que devem ser respeitados. Ele também inclui configurações de disrupção que controlam a consolidação e o ciclo de vida dos nós.
O AKSNodeClass contém as configurações de nó específicas do Azure. Ele define detalhes como a imagem do sistema operacional do nó, o tamanho do disco do SO, o máximo de pods por nó, as tags do nó e, opcionalmente, o vnetSubnetID para posicionar os nós em uma sub-rede específica.
Em termos simples, o NodePool define o que o Karpenter pode criar, enquanto o AKSNodeClass define como o nó do Azure é configurado. Um AKSNodeClass mínimo se parece com isto:
apiVersion: karpenter.azure.com/v1beta1kind: AKSNodeClassmetadata: name: defaultspec: imageFamily: Ubuntu osDiskSizeGB: 128 tags: team: platformKarpenter no Azure vs Karpenter na AWS
A maior parte do que você já sabe por usar o Karpenter no EKS também vale para o AKS; a principal diferença é o NodeClass específico de cada nuvem. A API NodePool vem do Karpenter upstream, então funciona de forma semelhante nas duas nuvens. Você a usa para definir requirements, limites de recursos e configurações de disrupção. O NodeClass é específico do provider: o Azure usa AKSNodeClass, enquanto a AWS usa EC2NodeClass. Cada NodeClass contém configurações específicas da sua nuvem. O Azure provisiona SKUs de VM, enquanto a AWS provisiona tipos de instância EC2, então os labels e valores usados para selecioná-los diferem entre providers.
A principal diferença é a maturidade do provider. O provider da AWS está disponível há mais tempo e oferece mais recursos, enquanto o do Azure é mais recente e pode não ter um equivalente exato para todas as funcionalidades da AWS. Ambos oferecem os recursos essenciais, como provisionamento, consolidação, capacidade Spot e detecção de drift, mas consulte a documentação antes de assumir que um recurso específico da AWS funciona da mesma forma no Azure.
Node Auto Provisioning vs cluster autoscaler do AKS
O NAP e o cluster autoscaler do AKS resolvem o mesmo problema de formas diferentes. O cluster autoscaler trabalha dentro de node pools que você já definiu. Ele monitora pods pendentes e redimensiona esses pools fixos para cima ou para baixo, mas só consegue adicionar mais VMs dos tamanhos que você escolheu com antecedência. O NAP não tem essa restrição. Ele provisiona VMs no tamanho certo em tempo real, a partir de um conjunto amplo de SKUs, aloca os pods de forma otimizada (bin-packing) e consolida agressivamente, o que geralmente significa menos capacidade desperdiçada e menos planejamento manual de pools.
Há uma regra importante: você não executa os dois ao mesmo tempo. O NAP e o cluster autoscaler tentam gerenciar a capacidade de nós, então, ao habilitar o NAP, você desabilita o cluster autoscaler no cluster. Deixe um único sistema responsável por escalar os nós.
Limitações e recursos não suportados do Node Auto Provisioning
O NAP está pronto para produção, mas não oferece suporte a todas as configurações do AKS. Verifique as limitações a seguir antes de habilitá-lo:
a. Sistema operacional e tipo de cluster: node pools Windows não são suportados, então o NAP provisiona apenas nós Linux. Clusters IPv6 também não são suportados.
b. Identidade e operações de cluster: service principals não são suportados, então o cluster precisa usar uma identidade gerenciada atribuída pelo sistema ou pelo usuário. Você também não pode parar um cluster com NAP habilitado, nem alterar o tipo de saída de rede (egress outbound type) do cluster após a criação.
c. Rede: o NAP funciona com Azure CNI Overlay, Azure CNI Overlay com Cilium e Azure CNI, e a Microsoft recomenda Azure CNI com Cilium. A política de rede Calico e a alocação dinâmica de IP não são suportadas. Se você criar um cluster com NAP em uma rede virtual personalizada, precisará usar um Standard Load Balancer, pois o Basic Load Balancer não é suportado.
Habilitando o Node Auto Provisioning em um cluster AKS
Antes de habilitar o NAP, verifique se você atende aos pré-requisitos. Você precisa da Azure CLI versão 2.76.0 ou superior, que pode ser verificada com az --version, e o cluster deve usar uma identidade gerenciada em vez de um service principal. Também é necessária uma configuração de rede suportada, ou seja, Azure CNI em modo overlay, sendo o Cilium o dataplane recomendado.
Para habilitar o NAP em um cluster novo, defina o modo de provisionamento como Auto junto com as configurações de rede:
az aks create \ --name myCluster \ --resource-group myResourceGroup \ --node-provisioning-mode Auto \ --network-plugin azure \ --network-plugin-mode overlay \ --network-dataplane ciliumPara habilitá-lo em um cluster existente, atualize o modo de provisionamento:
az aks update \ --name myCluster \ --resource-group myResourceGroup \ --node-provisioning-mode AutoSe o seu cluster roda em uma rede virtual personalizada, lembre-se do requisito do Standard Load Balancer e conceda à identidade gerenciada do cluster a função Network Contributor na VNet ou sub-rede de destino, para que o Karpenter possa anexar nós a ela.
Depois de habilitar o NAP, verifique se ele está funcionando: confirme que os recursos do Karpenter existem e dispare um scale-up. Confira se os CRDs estão presentes com kubectl api-resources | grep karpenter, depois implante um workload e escale-o além da capacidade atual para que os pods fiquem pendentes. Observe o Karpenter responder:
kubectl get nodeclaimskubectl get nodes -wVocê deve ver um NodeClaim aparecer, uma nova VM entrar no cluster e os pods pendentes serem agendados nela.
Configurando NodePools para custo e resiliência
O NodePool controla como o Karpenter equilibra custo, capacidade e resiliência:
a. Restrinja famílias, tamanhos e gerações de SKUs de VM: use os requirements do NodePool para informar ao Karpenter quais VMs ele pode escolher. Você pode permitir famílias inteiras, excluir SKUs superdimensionados ou dar preferência a gerações mais recentes, o que mantém o provisionamento previsível sem tirar do Karpenter a liberdade de encontrar uma opção barata. Um conjunto mais amplo de SKUs permitidos dá ao Karpenter mais opções para encontrar uma alternativa econômica.
b. Combine capacidade Spot e sob demanda: o Karpenter pode provisionar VMs Spot e sob demanda por meio do requirement karpenter.sh/capacity-type, e executar recursos NodePool separados com pesos permite priorizar a capacidade Spot, mais barata, e recorrer à capacidade sob demanda quando o Spot não estiver disponível. É daí que vem boa parte da economia para workloads que toleram interrupções.
c. Distribua os nós entre zonas de disponibilidade: permita várias zonas nos requirements do NodePool (topology.kubernetes.io/zone) para que o Karpenter possa posicionar nós em diferentes zonas, protegendo seus workloads contra a falha de uma única zona.
d. Defina tetos e taints para workloads especiais: dê a cada NodePool limites de CPU e memória para limitar a capacidade que ele pode provisionar, e use taints para reservar um NodePool para workloads específicos, como jobs de GPU ou batch, de modo que apenas pods que toleram o taint sejam alocados nesses nós. Um NodePool com requirements e limites se parece com isto:
apiVersion: karpenter.sh/v1kind: NodePoolmetadata: name: generalspec: template: spec: requirements: - key: karpenter.sh/capacity-type operator: In values: ["spot", "on-demand"] - key: kubernetes.io/arch operator: In values: ["amd64"] nodeClassRef: name: default limits: cpu: "200" memory: 400GiControlando a consolidação e a disrupção
O consolidationPolicy no NodePool controla a consolidação. WhenEmpty remove um nó apenas quando ele não tem pods de workload, sendo a opção mais conservadora. WhenEmptyOrUnderutilized também considera nós que estão em execução, mas não totalmente utilizados. O Karpenter pode mover os pods desses nós para outros e remover os subutilizados, o que pode gerar mais economia, mas também pode mover pods com mais frequência. A configuração consolidateAfter controla quanto tempo o Karpenter espera antes de considerar um nó para consolidação.
O Karpenter também gerencia o ciclo de vida dos nós. Você pode configurar os nós para expirarem após uma idade específica, de modo que sejam substituídos regularmente. O NAP também cuida das atualizações de imagem dos nós e os mantém alinhados à versão do Kubernetes do control plane quando você atualiza o cluster. Um canal de auto-upgrade adequado e uma janela de manutenção planejada ajudam a controlar quando essas atualizações acontecem.
Para proteger a disponibilidade enquanto tudo isso acontece, use três controles em conjunto. Os disruption budgets no NodePool limitam quantos nós o Karpenter pode interromper de uma vez. Os PodDisruptionBudgets protegem seus workloads ao limitar quantos de seus pods podem ficar indisponíveis durante disrupções voluntárias, como a consolidação. E a annotation karpenter.sh/do-not-disrupt: "true" em um pod ou nó diz ao Karpenter para deixá-lo em paz, o que é útil para um job que não pode ser interrompido.
Por que as solicitações de recursos dos pods determinam quanto o Karpenter economiza?
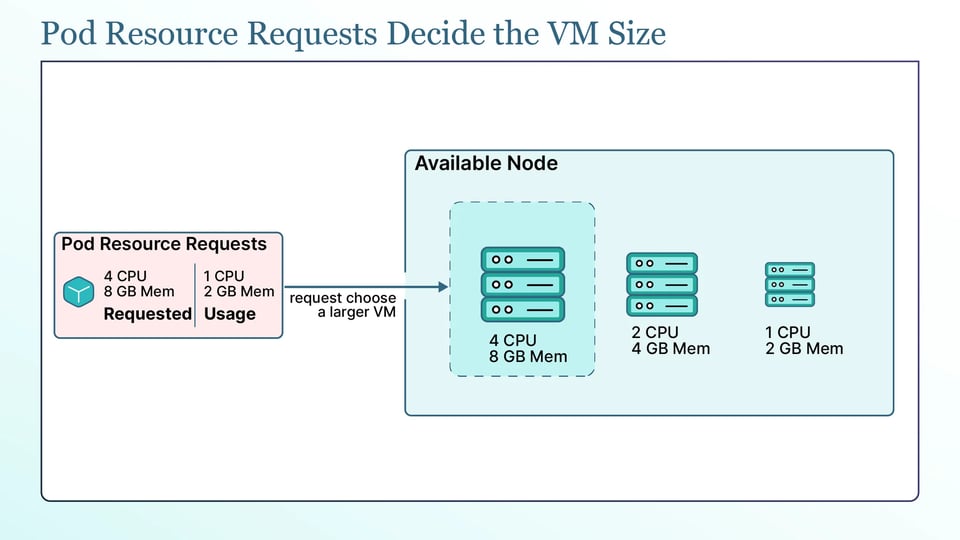
O Karpenter provisiona nós com base nas solicitações de recursos dos pods, não no uso real. Ele usa essas solicitações para escolher uma VM que comporte os pods pendentes, então solicitações precisas afetam diretamente quanta capacidade é provisionada e quanto você paga.
Solicitações infladas podem levar o Karpenter a escolher SKUs de VM maiores e mais caros. Por exemplo, se um pod solicita 4 CPUs e 8 GB de memória, mas usa apenas 1 CPU e 2 GB, o Karpenter ainda precisa encontrar capacidade suficiente para os 4 CPUs e 8 GB solicitados. Assim, ele pode escolher uma VM maior e alocar menos pods no nó. Em todo o cluster, solicitações infladas podem gerar capacidade ociosa e custos mais altos. O Karpenter está apenas seguindo os requisitos de recursos que você definiu.
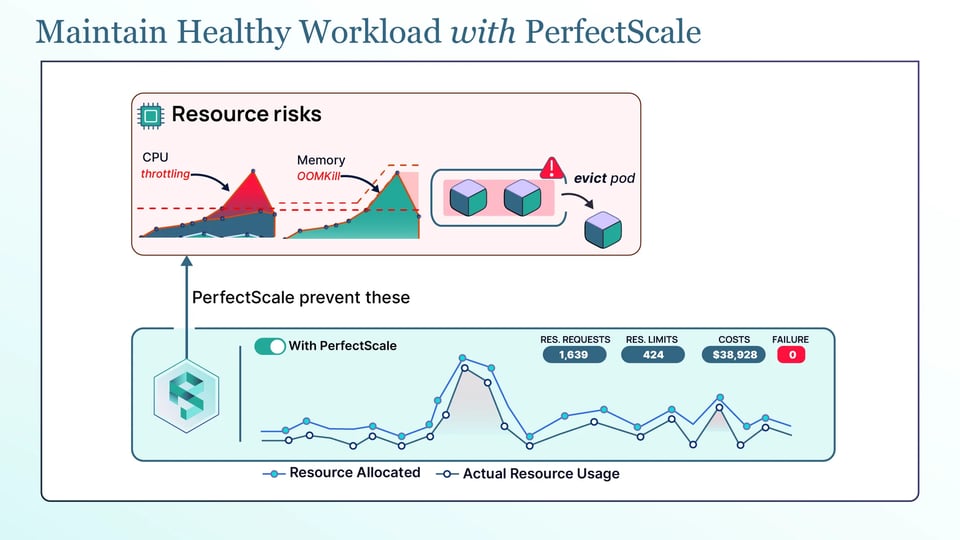
É aqui que o right-sizing contínuo faz toda a diferença. A plataforma de governança de Kubernetes da PerfectScale observa como seus workloads realmente usam CPU e memória e transforma isso em recomendações de right-sizing acionáveis e automatizadas, que você pode aplicar manualmente ou de forma autônoma. Alimentar o NAP com solicitações precisas é o que permite que ele faça seu trabalho: com solicitações que refletem a realidade, o Karpenter provisiona VMs menores e mais baratas e as aproveita ao máximo, para que a economia prometida pelo NAP realmente apareça na sua fatura. Equipes como Paramount Pictures e Creditas usam a PerfectScale para manter seus clusters eficientes, e você pode criar sua conta ou agendar uma sessão técnica.
Monitorando a atividade dos nós do NAP, a latência de provisionamento e o custo dos nós
Com o NAP em execução, você precisa de visibilidade sobre o que ele está fazendo. Comece pelos NodeClaims, que mostram o que o Karpenter está provisionando e permitem acompanhar a atividade de provisionamento em tempo real.
O AKS expõe os eventos do Karpenter nos logs do control plane (a categoria karpenter-events), que é onde você deve procurar quando um nó falha ao ser provisionado ou registrado.
Para métricas, habilite as métricas do control plane por meio do serviço gerenciado do Azure Monitor para Prometheus, o que permite monitorar o comportamento do Karpenter, incluindo atividade e latência de provisionamento.
A visibilidade de custos é igualmente importante, porque o NAP muda continuamente o mix de SKUs de VM no cluster. Ferramentas como Kubecost e OpenCost podem fornecer alocação básica de custos, enquanto a PerfectScale também ajuda a identificar solicitações de recursos ineficientes e capacidade subutilizada, facilitando a medição do impacto do NAP nos custos.
Boas práticas para rodar o Karpenter no AKS
Estas são as boas práticas que você deve conhecer:
a. Faça o right-sizing das solicitações dos pods antes de habilitar o NAP: o Karpenter provisiona nós com base nas solicitações de recursos dos pods, então solicitações precisas têm um grande impacto no custo. Faça o right-sizing primeiro para evitar provisionar mais capacidade do que seus workloads precisam.
b. Mantenha os requirements do NodePool amplos o suficiente para encontrar SKUs mais baratos: restringir o Karpenter a um ou dois tamanhos de VM limita sua capacidade de encontrar opções econômicas. Permita uma variedade razoável de famílias e tamanhos de VM para que o Karpenter tenha mais escolhas.
c. Use discos de SO efêmeros e capacidade Spot para workloads tolerantes a falhas: discos de SO efêmeros podem oferecer armazenamento mais rápido, enquanto VMs Spot podem custar muito menos que a capacidade sob demanda. Ambos envolvem trade-offs, então use-os para workloads que suportam substituição ou interrupção de nós. Mantenha workloads críticos em capacidade sob demanda quando a confiabilidade for mais importante que o custo.
d. Defina limites no NodePool para conter o provisionamento descontrolado: sempre defina limites de CPU e memória nos seus recursos NodePool. Sem eles, um workload mal configurado ou um deployment fora de controle pode fazer o Karpenter provisionar muito mais capacidade — e custo — do que você pretendia.
e. Gerencie NodePools e AKSNodeClasses como código: mantenha suas definições de NodePool e AKSNodeClass no Terraform ou Bicep junto com o restante da sua infraestrutura, para que a política de provisionamento seja versionada, revisada e replicável entre clusters, em vez de editada manualmente.