


La optimización de costos en Kubernetes rompe producción cuando una herramienta recorta recursos a partir de una visión incorrecta de un workload. Reduce la memoria o el CPU a lo que un workload necesitaba la semana pasada. Luego el siguiente release necesita más, y termina con un OOM kill o con throttling. Los ahorros se ven bien en el reporte, hasta que un incidente los borra de un plumazo.
La solución no es dejar de optimizar. Es optimizar según lo que cada workload está haciendo ahora, en ambas direcciones, con guardrails alrededor de cada cambio. Este artículo muestra por qué la optimización de costos sale mal y cómo la optimización consciente de revisiones mantiene alineados el costo y la confiabilidad en cada deploy.
La mayoría de los clústeres de Kubernetes están sobreaprovisionados
Empecemos por lo que se pierde. Los datos de PerfectScale muestran que cerca del 80% de los clústeres de Kubernetes están sobreaprovisionados, y cada clúster sin optimizar pierde entre $5,000 y $10,000 dólares al mes. La pérdida es simple: recursos que pagaste pero nunca usaste, como reservar 4 CPUs y 8Gi de memoria para un workload que apenas llega a 1 CPU y 2Gi.
Así que hay dinero real en el right-sizing. El problema es que recortar recursos se siente peligroso, y con razón.
El falso dilema entre costo y confiabilidad
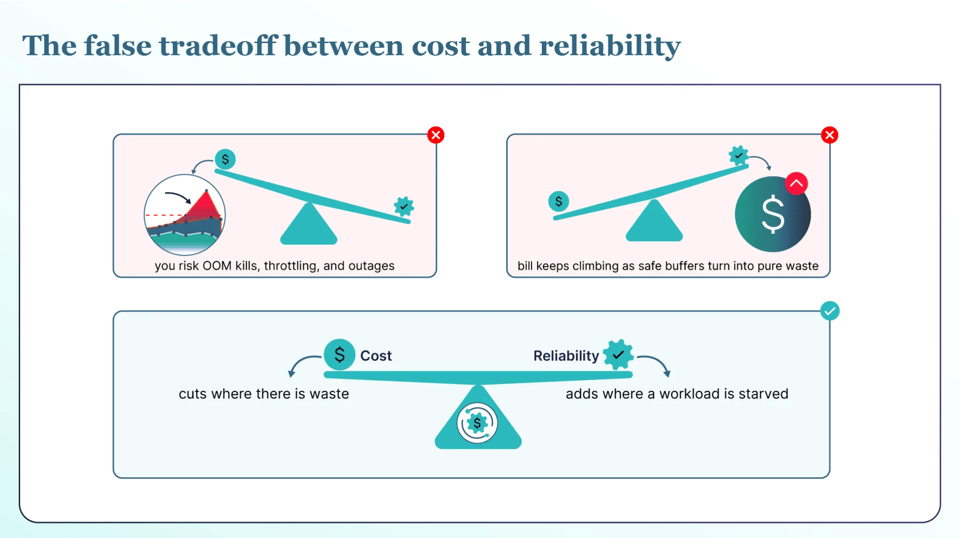
A los Engineers se les evalúa por si el sistema sigue en pie, no por cuánto ahorraron, así que recortar un workload se siente como quitar un colchón de seguridad. Y el riesgo es desigual: un solo incidente grave puede borrar meses de ahorros en una tarde. Ese es el dilema en el que se quedan atrapados los equipos. Si recortas a fondo por el costo, te arriesgas a OOM kills, throttling y caídas. Si proteges la confiabilidad, la factura sigue subiendo mientras los colchones de seguridad se convierten en pura pérdida.
No deberías tener que elegir. El enfoque correcto recorta donde hay pérdida y agrega donde a un workload le faltan recursos, y lo sigue haciendo a medida que el workload cambia.
Qué se rompe realmente: OOM kills y CPU throttling
Para recortar de forma segura, necesitas saber qué falla cuando recortas de más, y el CPU y la memoria fallan de maneras distintas. Si recortas la memoria de un workload por debajo de lo que necesita, Kubernetes mata el contenedor en el momento en que cruza el límite. Se manifiesta como un OOM kill y un reinicio, y si sigue ocurriendo el pod queda atrapado en un ciclo de reinicios. Si recortas el CPU demasiado, el workload no muere; sufre throttling: sigue corriendo pero se vuelve lento en silencio, sin ningún error en los logs.
Ambos vienen del mismo error: recortar con demasiada agresividad por perseguir la cifra de ahorro. Y ambos se vuelven mucho más probables en el momento en que un workload cambia.
El costo real cuando algo sale mal
Cuando un recorte mal hecho causa un incidente, sale caro. La investigación de la industria recopilada en el reporte de downtime de DataBank estima el costo promedio del downtime no planificado en unos $9,000 dólares por minuto. Kubernetes suele empeorar un incidente, no mejorarlo. Los servicios comparten un ingress, un plano de control y, a menudo, un mesh, así que una sola falla puede golpear a muchos servicios a la vez. Y como Kubernetes intenta autorrepararse, puede ocultar el problema, por lo que el equipo tarda más en darse cuenta. Un incidente así empuja a los equipos de vuelta al trabajo manual y sobreaprovisionado. Después de que ocurre una vez, la mayoría apaga la automatización para siempre y deja todos los ahorros sobre la mesa.
La solución: optimización consciente de revisiones que prioriza la confiabilidad
La optimización que prioriza la confiabilidad invierte el objetivo. No se trata del ahorro máximo que un reporte puede mostrar, sino del ahorro máximo seguro en el que un equipo puede confiar lo suficiente como para dejarlo funcionando, porque los ahorros que apagas no son ahorros.
Dos cosas lo hacen posible. Primero, aplicar right-sizing en ambas direcciones. Recortar cuando hay pérdida y agregar recursos antes de que un workload se quede corto. Y hacerlo de forma continua, porque los números correctos no dejan de moverse.
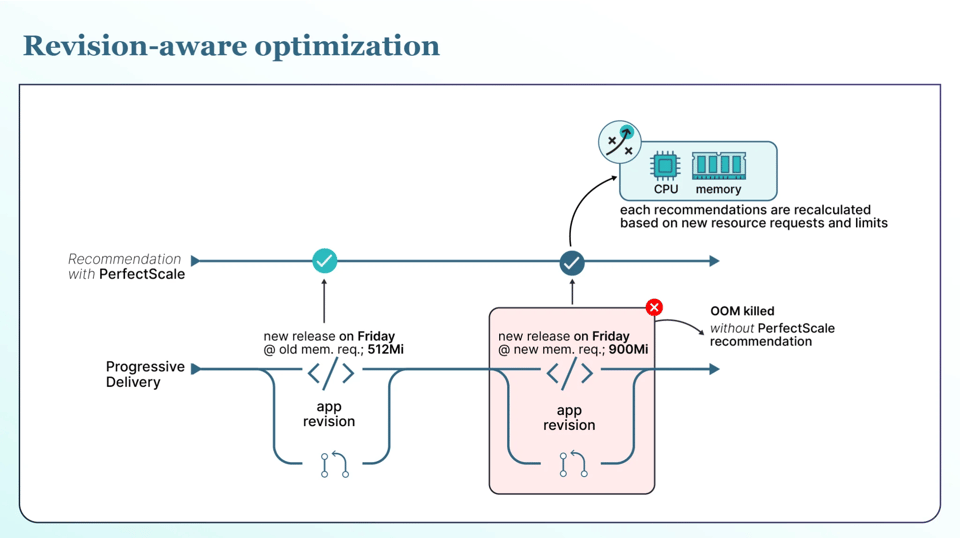
Segundo, y esta es la parte que realmente previene incidentes: basar cada cambio en lo que un workload está haciendo ahora, no en lo que hizo la semana pasada. Los workloads cambian de un release al siguiente. Una nueva versión puede agregar una capa de caché, cambiar una librería o modificar cómo fluye el tráfico, y sus necesidades reales de CPU y memoria cambian con ella. Una herramienta que optimiza solo con el uso pasado siempre está mirando la versión anterior, así que recorta un workload hacia los números de la semana pasada justo cuando un nuevo release necesita más. Ese es exactamente el momento en que sufre un OOM kill o throttling.
Aquí es donde la optimización consciente de revisiones y de rollouts de PerfectScale marca la diferencia. PerfectScale detecta cuando una nueva revisión entra en producción y evalúa esa versión por su propio comportamiento. Trata cada réplica y cada versión por separado, y entiende la estrategia de rollout en juego, ya sea blue-green, canary o A/B a través de Argo Rollouts, sin etiquetado manual. Basa los cambios en la versión que realmente está corriendo y, por defecto, pausa los cambios nuevos mientras un rollout sigue en curso. Obtienes los ahorros sin apostar tu uptime a datos obsoletos, y eso hace que cada deploy sea más seguro.
Así se ve en la práctica. El viernes publicas un release que agrega caché en memoria, y la necesidad real de memoria del servicio salta de 512Mi a 900Mi. Una herramienta que trabaja con los datos de la semana pasada sigue viendo 512Mi y recorta el límite hacia esa cifra, así que en el momento en que la nueva versión recibe tráfico, sufre un OOM kill. La optimización consciente de revisiones detecta la nueva revisión, la evalúa según su propio uso y frena el recorte anterior. La misma automatización, sin incidente.
PerfectScale mantiene todo esto dentro de guardrails que tú controlas: políticas que puedes definir por workload, namespace o clúster; ventanas de mantenimiento que deciden cuándo se permiten los cambios; un arranque en modo de solo monitoreo que no aplica nada hasta que actives la automatización; y, cuando el workload lo permite, cambios aplicados in-place, sin reiniciar tus pods.
Costo y confiabilidad resueltos con PerfectScale by DoiT
La optimización de costos en Kubernetes solo rinde cuando los equipos confían en ella lo suficiente como para dejarla encendida. PerfectScale by DoiT está diseñado para eso. Vigila tus clústeres en busca de riesgos de recursos como OOM kills, CPU throttling y evicciones, y los convierte en right-sizing que puedes aplicar de forma manual o automática, siempre con datos actuales y siempre dentro de tus guardrails. Equipos como Paramount Pictures y Creditas usan PerfectScale para reducir el gasto en la nube sin sacrificar la estabilidad de producción. Se instala con un solo comando de Helm y arranca en modo de solo lectura, para que veas los ahorros antes de activar nada. Regístrate o agenda una demo para comenzar.