


L'optimisation des coûts Kubernetes casse la production lorsqu'un outil réduit les ressources sur la base d'une vision erronée d'un workload. Ramenez la mémoire ou le CPU au niveau dont un workload avait besoin la semaine dernière. Puis la version suivante en demande davantage, et le conteneur se fait OOM kill ou throttler. Les économies font bonne figure dans le rapport, jusqu'à ce qu'un incident les efface.
La solution n'est pas d'arrêter d'optimiser, mais d'optimiser sur la base de ce que chaque workload fait maintenant, dans les deux sens, avec des garde-fous autour de chaque changement. Cet article montre pourquoi l'optimisation des coûts déraille, et comment une optimisation revision-aware maintient coûts et fiabilité alignés à chaque déploiement.
La plupart des clusters Kubernetes sont surprovisionnés
Commençons par le gaspillage. Les données de PerfectScale montrent qu'environ 80 % des clusters Kubernetes sont surprovisionnés, et que chaque cluster non optimisé gaspille entre 5 000 et 10 000 $ par mois. Le gaspillage, c'est simple : des ressources payées mais jamais utilisées, comme réserver 4 CPU et 8Gi de mémoire pour un workload qui n'en consomme jamais plus de 1 CPU et 2Gi.
Il y a donc de vraies économies à faire avec le right-sizing. Le problème, c'est que réduire les ressources semble risqué — et pour de bonnes raisons.
Le faux dilemme entre coûts et fiabilité
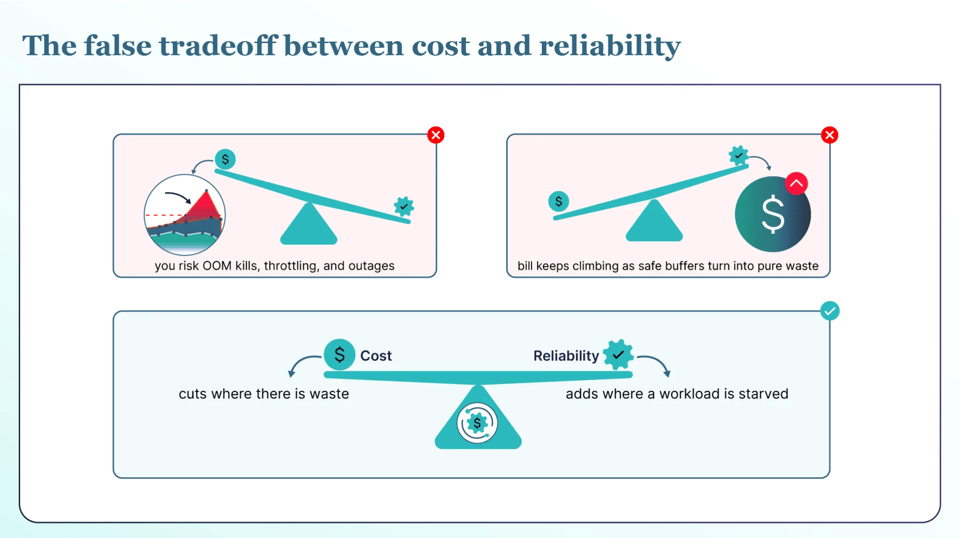
Les ingénieurs sont jugés sur la disponibilité du système, pas sur les économies réalisées : rogner sur un workload revient donc à retirer une marge de sécurité. Et le risque est asymétrique : un seul incident grave peut effacer des mois d'économies en un après-midi. C'est le dilemme dans lequel les équipes s'enferment. Coupez fort pour réduire les coûts et vous risquez OOM kills, throttling et pannes. Protégez la fiabilité et la facture continue de grimper, les marges de sécurité se transformant en pur gaspillage.
Vous ne devriez pas avoir à choisir. La bonne approche coupe là où il y a du gaspillage, ajoute là où un workload est à court de ressources, et continue de le faire à mesure que le workload évolue.
Ce qui casse vraiment : OOM kills et throttling CPU
Pour réduire en toute sécurité, il faut savoir ce qui lâche quand on coupe trop — et le CPU et la mémoire ne défaillent pas de la même façon. Réduisez la mémoire d'un workload en dessous de ses besoins, et Kubernetes tue le conteneur dès qu'il franchit la limite. Résultat : un OOM kill et un redémarrage, et si cela se répète, le pod reste bloqué dans une boucle de redémarrages. Serrez trop le CPU, et le workload n'est pas tué : il est throttlé — il continue de tourner mais ralentit en silence, sans la moindre erreur dans les logs.
Les deux découlent de la même erreur : couper trop agressivement pour gonfler le chiffre des économies. Et les deux deviennent bien plus probables dès qu'un workload change.
Le coût réel quand ça tourne mal
Quand une réduction mal calibrée provoque un incident, la facture est lourde. Les études sectorielles compilées dans le rapport de DataBank sur les interruptions estiment le coût moyen d'une indisponibilité imprévue à environ 9 000 $ la minute. Kubernetes aggrave généralement l'incident au lieu de l'atténuer. Les services partagent un ingress, un control plane et souvent un mesh : une seule défaillance peut toucher plusieurs services à la fois. Et comme Kubernetes tente de s'auto-réparer, il peut masquer le problème, si bien que l'équipe met plus de temps à le remarquer. Un seul incident de ce type renvoie les équipes vers un fonctionnement manuel et surprovisionné. Une fois que c'est arrivé, la plupart désactivent l'automatisation pour de bon et laissent toutes les économies derrière elles.
La solution : une optimisation revision-aware, axée sur la fiabilité
L'optimisation axée sur la fiabilité inverse l'objectif. Il ne s'agit pas du maximum d'économies qu'un rapport peut afficher, mais du maximum d'économies sûres qu'une équipe peut laisser tourner en toute confiance — car des économies que l'on désactive ne sont pas des économies.
Deux choses rendent cela possible. D'abord, faire du right-sizing dans les deux sens. Couper là où il y a du gaspillage, et ajouter des ressources avant qu'un workload ne sature. Et le faire en continu, car les bons chiffres évoluent en permanence.
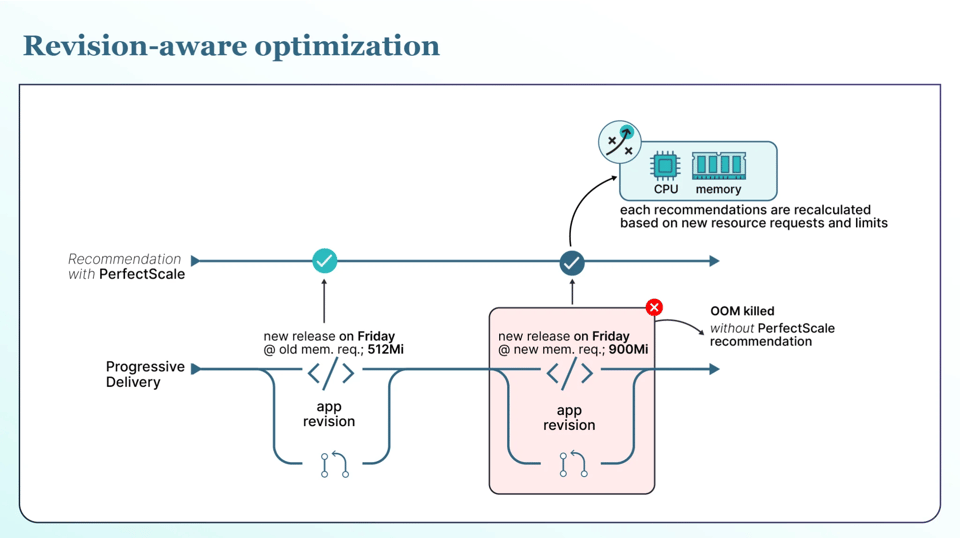
Ensuite, et c'est ce qui prévient réellement les incidents : fonder chaque changement sur ce qu'un workload fait maintenant, pas sur ce qu'il faisait la semaine dernière. Les workloads changent d'une version à l'autre. Une nouvelle version peut ajouter une couche de cache, remplacer une bibliothèque ou modifier les flux de trafic, et ses besoins réels en CPU et en mémoire évoluent avec elle. Un outil qui n'optimise que sur l'usage passé regarde toujours l'ancienne version : il rogne un workload vers les chiffres de la semaine dernière au moment précis où la nouvelle version en demande plus. C'est exactement là qu'elle se fait OOM kill ou throttler.
C'est là que l'optimisation revision-aware et rollout-aware de PerfectScale fait la différence. PerfectScale détecte la mise en production d'une nouvelle révision et évalue cette version sur son propre comportement. Il traite chaque replica et chaque version individuellement, et comprend la stratégie de rollout en cours — blue-green, canary ou A/B via Argo Rollouts — sans aucun tagging manuel. Il fonde ses changements sur la version qui tourne réellement et, par défaut, suspend les nouveaux changements tant qu'un rollout est en cours. Vous obtenez les économies sans parier votre disponibilité sur des données obsolètes, et chaque déploiement devient plus sûr.
Voici ce que cela donne en pratique. Vous livrez vendredi une version qui ajoute du cache en mémoire, et le besoin réel en mémoire du service passe de 512Mi à 900Mi. Un outil qui travaille sur les données de la semaine dernière voit toujours 512Mi et abaisse la limite en conséquence : dès que la nouvelle version reçoit du trafic, elle se fait OOM kill. L'optimisation revision-aware voit la nouvelle révision, l'évalue sur sa propre consommation et suspend l'ancienne réduction. Même automatisation, zéro incident.
PerfectScale garde tout cela à l'intérieur de garde-fous que vous contrôlez : des politiques configurables par workload, namespace ou cluster ; des fenêtres de maintenance qui déterminent quand les changements peuvent s'exécuter ; un démarrage en mode monitoring seul, qui n'applique rien tant que vous n'activez pas l'automatisation ; et, lorsque le workload le permet, des changements appliqués à chaud, sans redémarrer vos pods.
Concilier coûts et fiabilité avec PerfectScale by DoiT
L'optimisation des coûts Kubernetes n'est rentable que si les équipes lui font suffisamment confiance pour la laisser activée. PerfectScale by DoiT est conçu pour cela. Il surveille vos clusters à la recherche de risques liés aux ressources — OOM kills, throttling CPU, évictions — et les transforme en actions de right-sizing que vous pouvez appliquer manuellement ou automatiquement, toujours sur des données actuelles et toujours dans le cadre de vos garde-fous. Des équipes comme Paramount Pictures et Creditas utilisent PerfectScale pour réduire leurs dépenses cloud sans sacrifier la stabilité de la production. Il s'installe avec une seule commande Helm et démarre en lecture seule : vous voyez les économies avant d'activer quoi que ce soit. Inscrivez-vous ou réservez une démo pour vous lancer.