


Kubernetesのコスト最適化が本番環境を壊すのは、ツールがワークロードの実態を誤って捉えたままリソースを削減するときです。メモリやCPUを、先週ワークロードが必要としていた量まで削る。すると次のリリースではより多くのリソースが必要になり、OOM killやスロットリングが発生します。レポート上の削減額は立派に見えても、インシデント一つでそれが帳消しになります。
解決策は最適化をやめることではありません。各ワークロードが今何をしているかに基づいて、増減の両方向に、すべての変更にガードレールを設けて最適化することです。本記事では、コスト最適化が失敗する理由と、リビジョン対応の最適化がデプロイのたびにコストと信頼性を両立させる仕組みを解説します。
ほとんどのKubernetesクラスタは過剰プロビジョニング
まずは無駄から見ていきましょう。PerfectScaleのデータによると、Kubernetesクラスタの約80%が過剰プロビジョニング状態にあり、最適化されていないクラスタ1つあたり月額およそ5,000〜10,000ドルが無駄になっています。無駄の定義はシンプルです。支払ったのに使われなかったリソース、たとえば1 CPUと2Giしか使わないワークロードに4 CPUと8Giのメモリを確保しているようなケースです。
つまり、ライトサイジングには実際の金銭的メリットがあります。問題は、リソース削減が危険に感じられることです。しかも、それには正当な理由があります。
コストと信頼性の誤ったトレードオフ
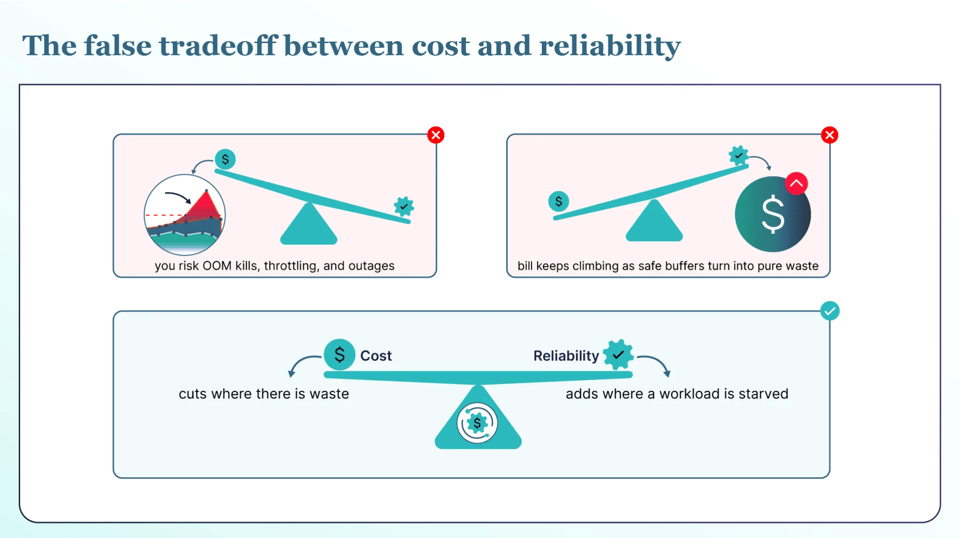
エンジニアが評価されるのはシステムを止めないことであり、いくら節約したかではありません。そのため、ワークロードのリソース削減は安全マージンを取り払う行為のように感じられます。しかもリスクは非対称です。深刻なインシデント1件で、数か月分の削減効果が半日で吹き飛ぶこともあります。これがチームが陥るトレードオフです。コスト重視で大胆に削れば、OOM kill、スロットリング、障害のリスクが高まります。信頼性を守れば、安全マージンが純粋な無駄と化し、請求額は増え続けます。
本来、どちらかを選ぶ必要はないはずです。正しいアプローチは、無駄がある部分は削り、リソース不足のワークロードには追加し、ワークロードの変化に合わせてそれを継続することです。
実際に何が壊れるのか:OOM killとCPUスロットリング
安全に削減するには、削りすぎたときに何が壊れるかを知る必要があります。CPUとメモリでは壊れ方が異なります。ワークロードのメモリを必要量以下に削ると、Kubernetesは上限を超えた瞬間にコンテナを強制終了します。それはOOM killと再起動として現れ、繰り返されるとPodは再起動ループに陥ります。CPUを絞りすぎた場合、ワークロードは強制終了されず、スロットリングされます。動き続けますが静かに遅くなり、ログにはエラーが残りません。
どちらも同じミス、つまり削減額の数字のために過度に削ることが原因です。そしてワークロードが変化した瞬間、どちらの発生確率も大幅に上がります。
失敗したときの本当のコスト
誤った削減がインシデントを引き起こすと、その代償は高くつきます。DataBankのダウンタイムレポートにまとめられた業界調査によると、計画外ダウンタイムの平均コストは1分あたり約9,000ドルです。Kubernetesは通常、インシデントを軽減するどころか悪化させます。サービス群はingress、コントロールプレーン、多くの場合サービスメッシュを共有しているため、1つの障害が複数のサービスを同時に直撃しかねません。さらにKubernetesは自己修復を試みるため問題が隠れてしまい、チームの検知が遅れます。この種のインシデントが1回起きれば、チームは手作業による過剰プロビジョニング運用に逆戻りします。一度経験すると、ほとんどのチームは自動化を永久にオフにし、削減効果をすべて手放してしまいます。
解決策:信頼性ファーストのリビジョン対応最適化
信頼性ファーストの最適化は、目標を反転させます。目指すのはレポートに表示できる最大の削減額ではありません。チームが信頼して稼働させ続けられる、最大限の安全な削減です。オフにしてしまう削減は、削減とは言えないからです。
それを可能にするのは2つのことです。第一に、両方向のライトサイジングです。無駄があれば削り、ワークロードが逼迫する前にリソースを追加する。適正値は動き続けるので、これを継続します。
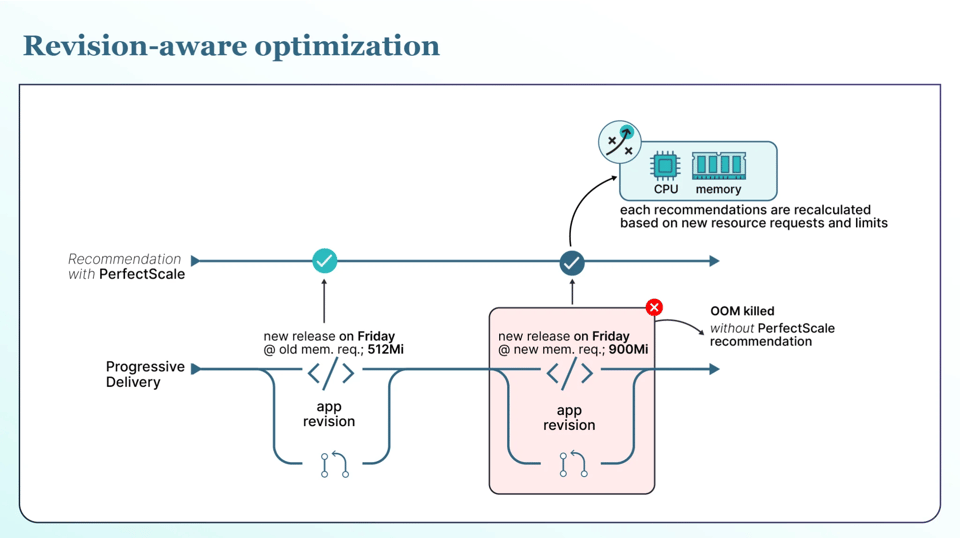
第二に、そしてこれこそが実際にインシデントを防ぐ部分ですが、すべての変更を先週ではなく今のワークロードの挙動に基づいて行うことです。ワークロードはリリースごとに変化します。新バージョンでキャッシュ層が追加されたり、ライブラリが差し替えられたり、トラフィックの流れが変わったりすれば、実際に必要なCPUとメモリもそれに伴って変わります。過去の使用状況だけで最適化するツールは常に旧バージョンを見ているため、新リリースがより多くのリソースを必要とするまさにそのタイミングで、先週の数値に向けてワークロードを削ってしまいます。それこそがOOM killやスロットリングが起きる瞬間です。
ここがPerfectScaleのリビジョン対応・ロールアウト対応の最適化の違いです。PerfectScaleは新しいリビジョンの稼働開始を検知し、そのバージョンをそれ自身の挙動で判断します。各レプリカと各バージョンを個別に扱い、Argo Rolloutsによるブルーグリーン、カナリア、A/Bなど、進行中のロールアウト戦略を手動タグ付けなしで理解します。実際に稼働しているバージョンに基づいて変更を行い、デフォルトではロールアウトの進行中は新たな変更を一時停止します。古いデータにアップタイムを賭けることなく削減効果が得られ、すべてのデプロイがより安全になります。
実際の例で見てみましょう。金曜日にインメモリキャッシュを追加するリリースを出し、サービスの実際のメモリ必要量が512Miから900Miに跳ね上がったとします。先週のデータで動くツールはまだ512Miを見ており、上限をそこに向けて削るため、新バージョンがトラフィックを受けた瞬間にOOM killされます。リビジョン対応の最適化は新リビジョンを認識し、そのリビジョン自身の使用状況で判断し、古い削減を保留します。同じ自動化で、インシデントはゼロです。
PerfectScaleはこれらすべてを、ユーザーが制御できるガードレールの中で実行します。ワークロード、namespace、クラスタ単位で設定できるポリシー。変更の実行を許可するタイミングを決めるメンテナンスウィンドウ。自動化をオンにするまで何も適用しないモニタリング専用の開始モード。そしてワークロードが対応している場合は、Podを再起動せずにその場で変更を適用します。
PerfectScale by DoiTでコストと信頼性を両立
Kubernetesのコスト最適化は、チームが信頼してオンにし続けられて初めて成果につながります。PerfectScale by DoiTはそのために作られています。OOM kill、CPUスロットリング、evictionといったリソースリスクをクラスタ全体で監視し、手動でも自動でも適用できるライトサイジングに変換します。常に最新のデータに基づき、常にガードレールの範囲内で動作します。Paramount PicturesやCreditasといったチームがPerfectScaleを活用し、本番環境の安定性を犠牲にすることなくクラウド支出を削減しています。Helmコマンド1つでインストールでき、読み取り専用モードで開始するため、何かをオンにする前に削減効果を確認できます。サインアップまたはデモを予約して始めましょう。