


L'ottimizzazione dei costi Kubernetes rompe la produzione quando uno strumento taglia le risorse basandosi su una visione errata di un workload. Si riducono memoria o CPU a quanto serviva al workload la settimana scorsa. Poi la release successiva ha bisogno di più risorse e finisce in OOM kill o in throttling. I risparmi fanno bella figura nel report, finché un incidente non li azzera.
La soluzione non è smettere di ottimizzare, ma ottimizzare in base a ciò che ogni workload sta facendo adesso, in entrambe le direzioni, con guardrail intorno a ogni modifica. Questo articolo spiega perché l'ottimizzazione dei costi va storta e come l'ottimizzazione revision-aware mantiene allineati costi e affidabilità a ogni deploy.
La maggior parte dei cluster Kubernetes è sovradimensionata
Partiamo dallo spreco. I dati di PerfectScale mostrano che circa l'80% dei cluster Kubernetes è sovradimensionato e ogni cluster non ottimizzato spreca tra i 5.000 e i 10.000 dollari al mese. Lo spreco è semplice: risorse pagate ma mai utilizzate, come riservare 4 CPU e 8Gi di memoria per un workload che non supera mai 1 CPU e 2Gi.
Nel right-sizing c'è quindi denaro vero. Il problema è che tagliare le risorse sembra pericoloso, e a ragione.
Il falso compromesso tra costi e affidabilità
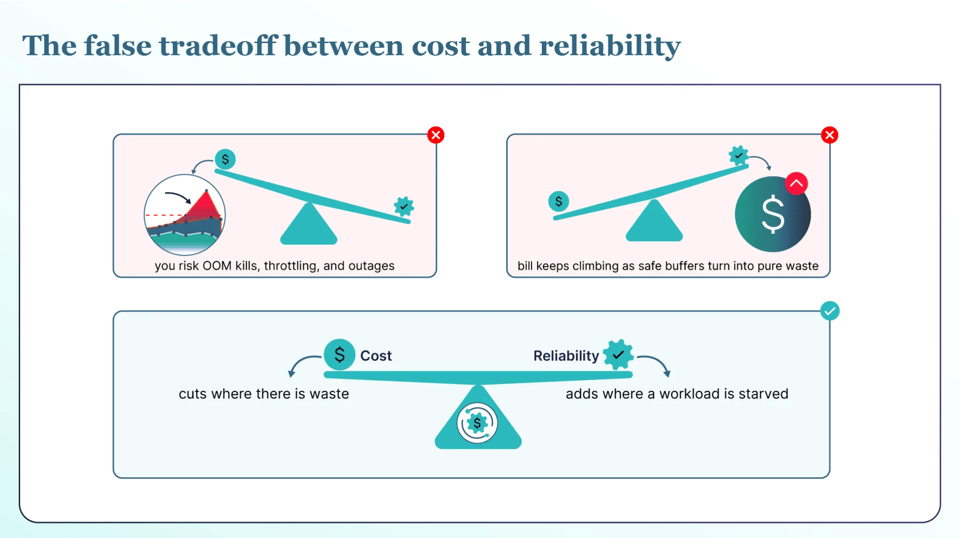
Gli engineer vengono valutati in base alla stabilità del sistema, non a quanto hanno risparmiato, quindi ridurre un workload viene percepito come rimuovere un margine di sicurezza. E il rischio è asimmetrico: un solo incidente grave può azzerare mesi di risparmi in un pomeriggio. È il compromesso in cui i team restano bloccati. Tagliando in modo aggressivo per i costi si rischiano OOM kill, throttling e interruzioni. Proteggendo l'affidabilità, la bolletta continua a salire mentre i margini di sicurezza si trasformano in puro spreco.
Non dovrebbe essere necessario scegliere. L'approccio giusto taglia dove c'è spreco e aggiunge dove un workload è a corto di risorse, e continua a farlo man mano che il workload cambia.
Cosa si rompe davvero: OOM kill e throttling della CPU
Per tagliare in sicurezza bisogna sapere cosa si guasta quando si taglia troppo, e CPU e memoria falliscono in modi diversi. Se si riduce la memoria di un workload al di sotto del necessario, Kubernetes termina il container nel momento in cui supera il limite. Il risultato è un OOM kill con conseguente riavvio e, se il fenomeno si ripete, il pod resta bloccato in un loop di riavvii. Se invece si stringe troppo la CPU, il workload non viene terminato, bensì sottoposto a throttling: continua a funzionare, ma rallenta in silenzio, senza alcun errore nei log.
Entrambi derivano dallo stesso errore: tagliare in modo troppo aggressivo in nome della cifra di risparmio. Ed entrambi diventano molto più probabili nel momento in cui un workload cambia.
Il costo reale quando qualcosa va storto
Quando un taglio sbagliato causa un incidente, il conto è salato. Le ricerche di settore raccolte nel report sui downtime di DataBank stimano il costo medio dei downtime non pianificati in circa 9.000 dollari al minuto. Kubernetes di solito peggiora un incidente, non lo migliora. I servizi condividono un ingress, un control plane e spesso una mesh, quindi un singolo guasto può colpire molti servizi contemporaneamente. E poiché Kubernetes cerca di autoripararsi, può nascondere il problema, così il team se ne accorge più tardi. Un incidente di questo tipo riporta i team al lavoro manuale e al sovradimensionamento. Dopo che è successo una volta, la maggior parte disattiva l'automazione per sempre, lasciandosi alle spalle tutti i risparmi.
La soluzione: un'ottimizzazione revision-aware che mette l'affidabilità al primo posto
L'ottimizzazione reliability-first ribalta l'obiettivo. Non è il risparmio massimo che un report può mostrare, ma il risparmio massimo sicuro di cui un team può fidarsi al punto da lasciarlo attivo, perché i risparmi che si spengono non sono risparmi.
Due elementi lo rendono possibile. Primo: fare right-sizing in entrambe le direzioni. Tagliare dove c'è spreco e aggiungere risorse prima che un workload vada in sofferenza. E continuare a farlo, perché i valori corretti si spostano di continuo.
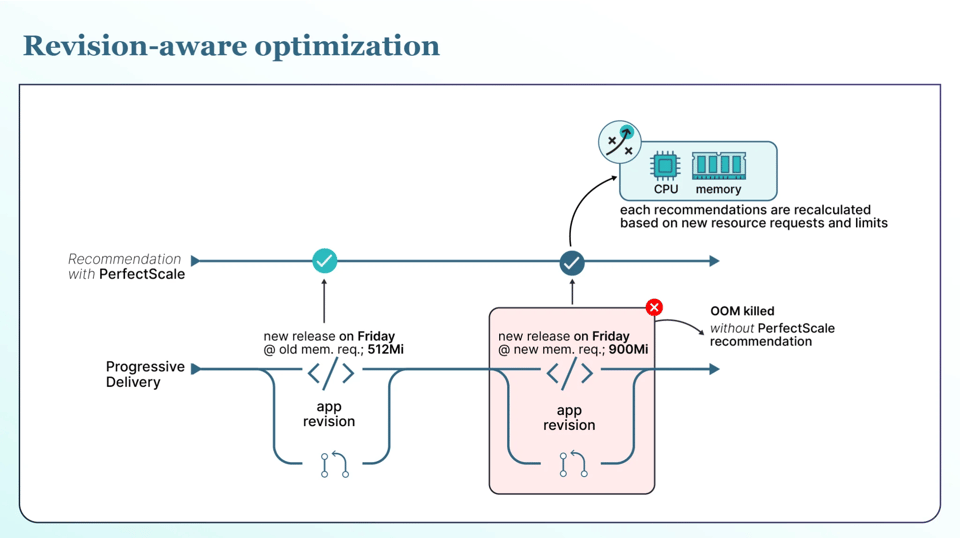
Secondo, ed è questa la parte che previene davvero gli incidenti: basare ogni modifica su ciò che un workload sta facendo adesso, non su ciò che faceva la settimana scorsa. I workload cambiano da una release all'altra. Una nuova versione può aggiungere un layer di caching, sostituire una libreria o modificare i flussi di traffico, e le sue reali esigenze di CPU e memoria cambiano di conseguenza. Uno strumento che ottimizza solo sull'utilizzo passato guarda sempre la versione vecchia, quindi riduce un workload verso i numeri della settimana precedente proprio quando la nuova release ha bisogno di più risorse. Ed è esattamente in quel momento che subisce un OOM kill o il throttling.
È qui che l'ottimizzazione revision-aware e rollout-aware di PerfectScale fa la differenza. PerfectScale rileva quando una nuova revision va in produzione e valuta quella versione in base al suo comportamento specifico. Tratta ogni replica e versione singolarmente e comprende la strategia di rollout in uso, che sia blue-green, canary o A/B tramite Argo Rollouts, senza alcun tagging manuale. Basa le modifiche sulla versione effettivamente in esecuzione e, per impostazione predefinita, sospende le nuove modifiche mentre un rollout è ancora in corso. Si ottengono i risparmi senza scommettere l'uptime su dati obsoleti, e questo rende ogni deploy più sicuro.
Ecco come si traduce in pratica. Immagini di rilasciare venerdì una release che aggiunge il caching in-memory: il fabbisogno reale di memoria del servizio passa da 512Mi a 900Mi. Uno strumento che lavora sui dati della settimana precedente vede ancora 512Mi e riduce il limite verso quel valore, quindi nel momento in cui la nuova versione riceve traffico subisce un OOM kill. L'ottimizzazione revision-aware riconosce la nuova revision, la valuta in base al suo utilizzo effettivo e sospende il vecchio taglio. Stessa automazione, nessun incidente.
PerfectScale mantiene tutto questo entro guardrail sotto il Suo controllo: policy impostabili per workload, namespace o cluster; finestre di manutenzione che stabiliscono quando le modifiche possono essere applicate; una modalità iniziale di solo monitoraggio che non applica nulla finché non attiva l'automazione; e, dove il workload lo supporta, modifiche applicate in place senza riavviare i pod.
Costi e affidabilità sotto controllo con PerfectScale by DoiT
L'ottimizzazione dei costi Kubernetes ripaga solo quando i team si fidano abbastanza da tenerla attiva. PerfectScale by DoiT è costruito proprio per questo. Monitora i cluster alla ricerca di rischi legati alle risorse come OOM kill, throttling della CPU ed eviction, e li trasforma in interventi di right-sizing applicabili manualmente o in automatico, sempre su dati aggiornati e sempre entro i Suoi guardrail. Team come Paramount Pictures e Creditas usano PerfectScale per ridurre la spesa cloud senza sacrificare la stabilità della produzione. Si installa con un singolo comando Helm e parte in modalità di sola lettura, così può vedere i risparmi prima di attivare qualsiasi cosa. Si registri o prenoti una demo per iniziare.