


Kubernetes-Kostenoptimierung legt die Produktion lahm, wenn ein Tool Ressourcen auf Basis einer falschen Sicht auf einen Workload kürzt. Speicher oder CPU werden auf das reduziert, was ein Workload letzte Woche brauchte. Dann benötigt das nächste Release mehr – und wird per OOM-Kill beendet oder gedrosselt. Die Einsparungen sehen im Report gut aus, bis ein Vorfall sie zunichtemacht.
Die Lösung ist nicht, mit dem Optimieren aufzuhören. Sondern auf Basis dessen zu optimieren, was jeder Workload jetzt gerade tut – in beide Richtungen, mit Guardrails um jede Änderung. Dieser Artikel zeigt, warum Kostenoptimierung schiefgeht und wie Revision-aware Optimierung Kosten und Zuverlässigkeit bei jedem Deploy in Einklang hält.
Die meisten Kubernetes-Cluster sind überprovisioniert
Beginnen wir beim Waste. Die Daten von PerfectScale zeigen: Rund 80 % der Kubernetes-Cluster sind überprovisioniert, und jeder nicht optimierte Cluster verschwendet etwa 5.000 bis 10.000 US-Dollar pro Monat. Waste ist einfach erklärt: Ressourcen, die Sie bezahlt, aber nie genutzt haben – etwa wenn Sie 4 CPUs und 8Gi Speicher für einen Workload reservieren, der nie mehr als 1 CPU und 2Gi anrührt.
In Right-Sizing steckt also echtes Geld. Das Problem: Ressourcen zu kürzen fühlt sich riskant an – und das aus gutem Grund.
Der falsche Zielkonflikt zwischen Kosten und Zuverlässigkeit
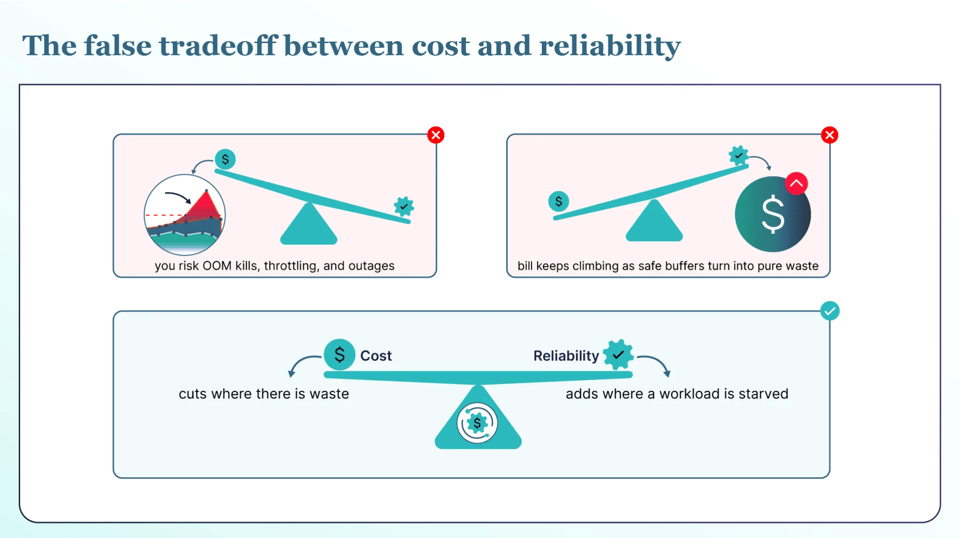
Engineers werden daran gemessen, ob das System läuft, nicht daran, wie viel sie gespart haben. Einen Workload zu kürzen fühlt sich deshalb an, als würde man einen Sicherheitspuffer entfernen. Und das Risiko ist ungleich verteilt: Ein einziger schwerer Vorfall kann monatelange Einsparungen an einem Nachmittag auslöschen. Genau in diesem Zielkonflikt stecken Teams fest. Wer aggressiv kürzt, riskiert OOM-Kills, Throttling und Ausfälle. Wer die Zuverlässigkeit schützt, sieht die Rechnung weiter steigen, weil Sicherheitspuffer zu purem Waste werden.
Sie sollten sich nicht entscheiden müssen. Der richtige Ansatz kürzt dort, wo Waste entsteht, stockt auf, wo ein Workload unterversorgt ist – und macht das kontinuierlich, während sich der Workload verändert.
Was tatsächlich kaputtgeht: OOM-Kills und CPU-Throttling
Um sicher kürzen zu können, müssen Sie wissen, was fehlschlägt, wenn Sie zu weit gehen – und CPU und Speicher scheitern auf unterschiedliche Weise. Kürzen Sie den Speicher eines Workloads unter den tatsächlichen Bedarf, beendet Kubernetes den Container in dem Moment, in dem er das Limit überschreitet. Das Ergebnis: ein OOM-Kill und ein Neustart – und wenn das immer wieder passiert, hängt der Pod in einer Restart-Schleife fest. Setzen Sie die CPU zu knapp an, wird der Workload nicht beendet, sondern gedrosselt: Er läuft weiter, wird aber unbemerkt langsamer – ohne Fehler in den Logs.
Beides entsteht aus demselben Fehler: zu aggressives Kürzen um der Einsparzahl willen. Und beides wird deutlich wahrscheinlicher, sobald sich ein Workload verändert.
Die wahren Kosten, wenn es schiefgeht
Verursacht eine schlechte Kürzung einen Vorfall, wird es teuer. Branchenanalysen im Downtime-Report von DataBank beziffern die durchschnittlichen Kosten ungeplanter Ausfallzeiten auf rund 9.000 US-Dollar pro Minute. Kubernetes macht einen Vorfall meist schlimmer, nicht besser. Services teilen sich einen Ingress, eine Control Plane und oft ein Mesh – ein einzelner Fehler kann also viele Services gleichzeitig treffen. Und weil Kubernetes versucht, sich selbst zu heilen, kann es das Problem verschleiern, sodass das Team es erst später bemerkt. Ein einziger solcher Vorfall drängt Teams zurück in manuelle, überprovisionierte Arbeit. Ist es einmal passiert, schalten die meisten die Automatisierung dauerhaft ab – und lassen sämtliche Einsparungen liegen.
Die Lösung: Reliability-first, Revision-aware Optimierung
Reliability-first-Optimierung dreht das Ziel um. Es geht nicht um die maximalen Einsparungen, die ein Report ausweisen kann, sondern um die maximalen sicheren Einsparungen, denen ein Team so weit vertraut, dass es sie laufen lässt – denn Einsparungen, die Sie abschalten, sind keine Einsparungen.
Zwei Dinge machen das möglich. Erstens: Right-Sizing in beide Richtungen. Kürzen, wo Waste entsteht, und Ressourcen aufstocken, bevor ein Workload heißläuft. Und zwar kontinuierlich, denn die richtigen Werte verschieben sich ständig.
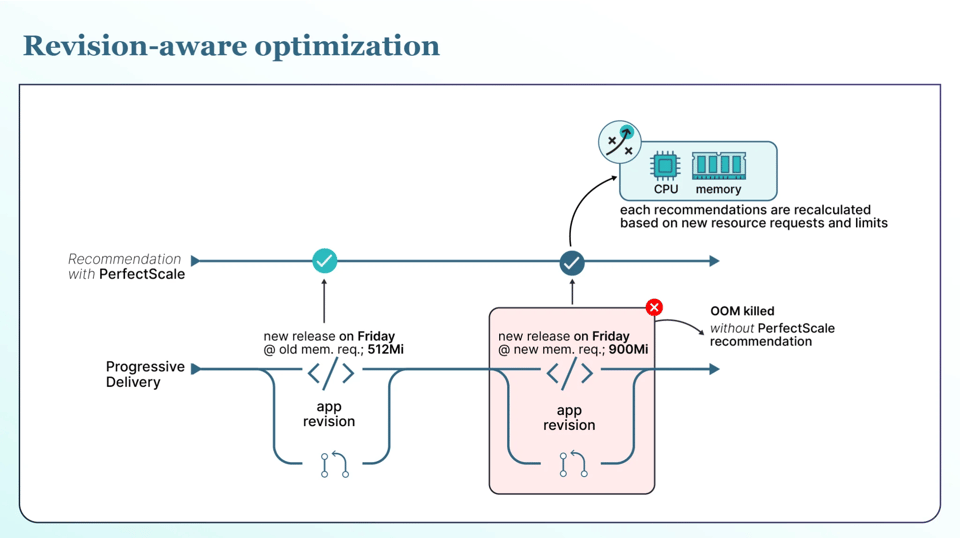
Zweitens – und das ist der Teil, der Vorfälle tatsächlich verhindert: Jede Änderung basiert auf dem, was ein Workload jetzt gerade tut, nicht auf dem, was er letzte Woche getan hat. Workloads verändern sich von Release zu Release. Eine neue Version kann einen Caching-Layer hinzufügen, eine Library austauschen oder den Traffic-Fluss verändern – und ihr realer CPU- und Speicherbedarf verändert sich mit. Ein Tool, das nur auf Basis vergangener Nutzung optimiert, schaut immer auf die alte Version. Es kürzt einen Workload auf die Werte der letzten Woche – genau dann, wenn ein neues Release mehr braucht. Und genau dann wird es per OOM-Kill beendet oder gedrosselt.
Genau hier unterscheidet sich die Revision-aware und Rollout-aware Optimierung von PerfectScale. PerfectScale erkennt, wenn eine neue Revision live geht, und bewertet diese Version anhand ihres eigenen Verhaltens. Jede Replica und jede Version wird für sich betrachtet, und die eingesetzte Rollout-Strategie wird berücksichtigt – ob Blue-Green, Canary oder A/B über Argo Rollouts, ganz ohne manuelles Tagging. Änderungen basieren auf der Version, die tatsächlich läuft, und standardmäßig pausiert PerfectScale neue Änderungen, solange ein Rollout noch läuft. Sie erhalten die Einsparungen, ohne Ihre Uptime auf veraltete Daten zu setzen – und das macht jeden Deploy sicherer.
So sieht das in der Praxis aus: Sie liefern am Freitag ein Release aus, das In-Memory-Caching hinzufügt, und der reale Speicherbedarf des Service springt von 512Mi auf 900Mi. Ein Tool, das mit den Daten der letzten Woche arbeitet, sieht weiterhin 512Mi und senkt das Limit in diese Richtung – in dem Moment, in dem die neue Version Traffic übernimmt, wird sie per OOM-Kill beendet. Revision-aware Optimierung erkennt die neue Revision, bewertet sie anhand ihrer eigenen Nutzung und hält die alte Kürzung zurück. Gleiche Automatisierung, kein Vorfall.
PerfectScale hält all das innerhalb von Guardrails, die Sie kontrollieren: Policies, die Sie pro Workload, Namespace oder Cluster festlegen können; Maintenance Windows, die bestimmen, wann Änderungen ausgeführt werden dürfen; ein Monitoring-only-Start, der nichts anwendet, bis Sie die Automatisierung einschalten; und – wo der Workload es unterstützt – Änderungen, die in-place angewendet werden, ohne Ihre Pods neu zu starten.
Kosten und Zuverlässigkeit im Griff – mit PerfectScale by DoiT
Kubernetes-Kostenoptimierung zahlt sich nur aus, wenn Teams ihr so weit vertrauen, dass sie eingeschaltet bleibt. Genau dafür ist PerfectScale by DoiT gebaut. Es überwacht Ihre Cluster auf Ressourcenrisiken wie OOM-Kills, CPU-Throttling und Eviction und übersetzt sie in Right-Sizing, das Sie manuell oder automatisch anwenden können – immer auf Basis aktueller Daten und immer innerhalb Ihrer Guardrails. Teams wie Paramount Pictures und Creditas nutzen PerfectScale, um ihre Cloud-Ausgaben zu senken, ohne die Stabilität der Produktion zu opfern. Die Installation erfolgt mit einem einzigen Helm-Befehl und startet read-only – Sie sehen die Einsparungen also, bevor Sie irgendetwas aktivieren. Registrieren Sie sich oder buchen Sie eine Demo, um loszulegen.