


A otimização de custos do Kubernetes quebra a produção quando uma ferramenta corta recursos com base em uma visão incorreta de um workload. Corte a memória ou a CPU para o que o workload precisava na semana passada. Aí a próxima release precisa de mais, e ele sofre OOM kill ou throttling. A economia parece ótima no relatório, até que um incidente apague tudo.
A solução não é parar de otimizar. É otimizar com base no que cada workload está fazendo agora, nas duas direções, com guardrails em torno de cada mudança. Este artigo mostra por que a otimização de custos dá errado e como a otimização revision-aware mantém custo e confiabilidade alinhados a cada deploy.
A maioria dos clusters Kubernetes está superprovisionada
Comece pelo desperdício. Os dados da PerfectScale mostram que cerca de 80% dos clusters Kubernetes estão superprovisionados, e cada cluster não otimizado desperdiça algo entre US$ 5.000 e US$ 10.000 por mês. Desperdício é simples: recursos pelos quais você pagou mas nunca usou, como reservar 4 CPUs e 8Gi de memória para um workload que só usa 1 CPU e 2Gi.
Ou seja, há dinheiro de verdade no right-sizing. O problema é que cortar recursos parece perigoso — e com razão.
O falso dilema entre custo e confiabilidade
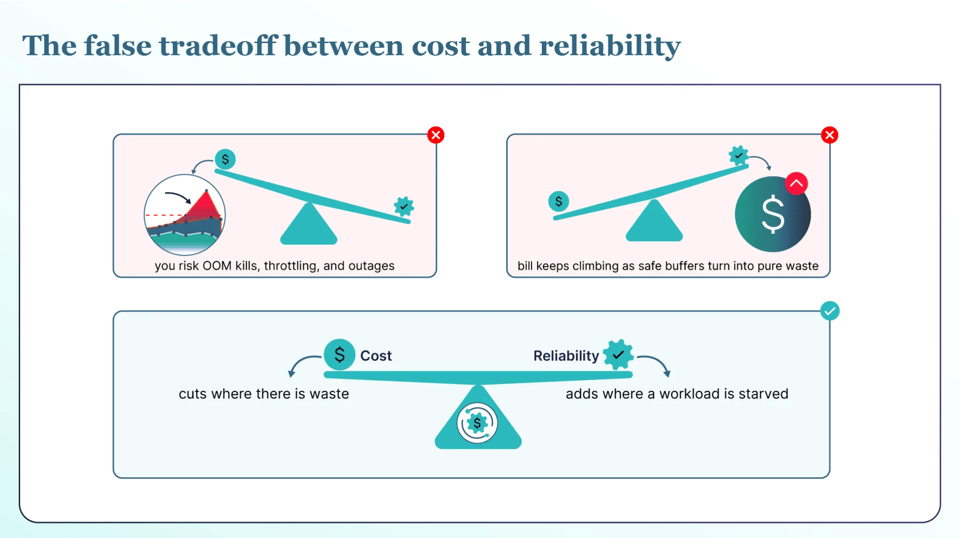
Engenheiros são avaliados por manter o sistema no ar, não por quanto economizaram, então enxugar um workload parece remover uma margem de segurança. E o risco é desigual: um único incidente grave pode apagar meses de economia em uma tarde. É nesse dilema que os times ficam presos. Corte pesado em nome do custo e você arrisca OOM kills, throttling e quedas. Proteja a confiabilidade e a fatura continua subindo, à medida que margens de segurança viram puro desperdício.
Você não deveria ter que escolher. A abordagem certa corta onde há desperdício e adiciona onde o workload está com falta de recursos — e continua fazendo isso conforme o workload muda.
O que realmente quebra: OOM kills e CPU throttling
Para cortar com segurança, você precisa saber o que falha quando corta demais — e CPU e memória falham de formas diferentes. Corte a memória de um workload abaixo do que ele precisa, e o Kubernetes mata o container no momento em que ele cruza o limite. O resultado aparece como um OOM kill e um restart, e se isso continuar acontecendo, o pod fica preso em um loop de reinicialização. Aperte demais a CPU, e o workload não é morto; ele sofre throttling: continua rodando, mas fica lento silenciosamente, sem nenhum erro nos logs.
Os dois vêm do mesmo erro: cortar de forma agressiva demais em nome do número de economia. E os dois ficam muito mais prováveis no momento em que o workload muda.
O custo real quando dá errado
Quando um corte malfeito causa um incidente, sai caro. Pesquisas do setor reunidas no relatório de downtime da DataBank estimam o custo médio de downtime não planejado em cerca de US$ 9.000 por minuto. O Kubernetes normalmente torna um incidente pior, não melhor. Os serviços compartilham um ingress, um control plane e, muitas vezes, um mesh, então uma única falha pode atingir vários serviços de uma vez. E como o Kubernetes tenta se autorrecuperar, ele pode esconder o problema, e o time demora mais para perceber. Um incidente assim empurra os times de volta para o trabalho manual e superprovisionado. Depois que acontece uma vez, a maioria desliga a automação de vez e deixa toda a economia para trás.
A solução: otimização reliability-first e revision-aware
A otimização reliability-first inverte o objetivo. Não é a economia máxima que um relatório pode mostrar. É a economia máxima segura em que um time confia o suficiente para deixar rodando — porque economia que você desliga não é economia.
Duas coisas tornam isso possível. Primeiro, right-sizing nas duas direções. Corte quando há desperdício e adicione recursos antes que o workload fique no limite. E continue fazendo isso, porque os números certos não param de mudar.
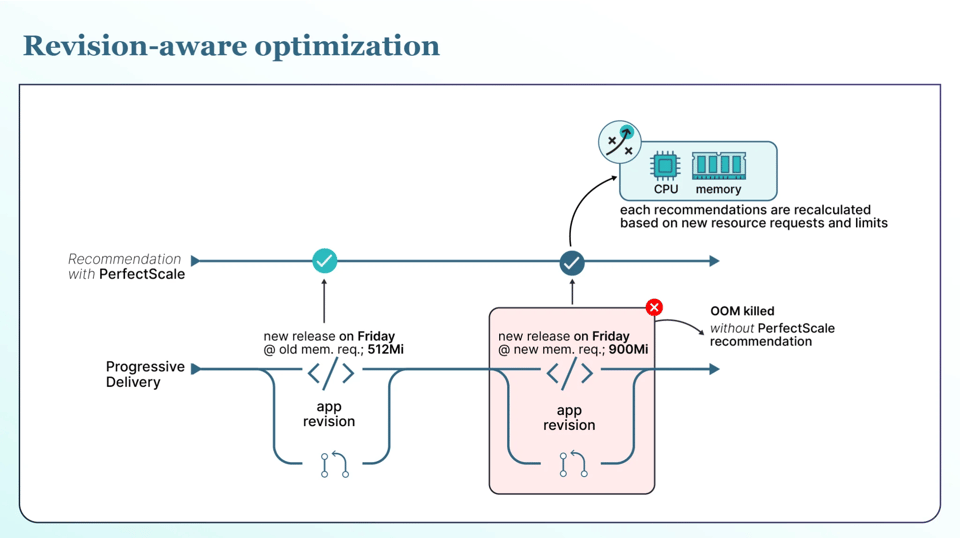
Segundo — e essa é a parte que realmente evita incidentes: baseie cada mudança no que o workload está fazendo agora, não no que ele fez na semana passada. Workloads mudam de uma release para outra. Uma nova versão pode adicionar uma camada de cache, trocar uma biblioteca ou alterar o fluxo de tráfego, e as necessidades reais de CPU e memória mudam junto. Uma ferramenta que otimiza apenas com base no uso passado está sempre olhando para a versão antiga, então ela enxuga o workload rumo aos números da semana passada exatamente quando a nova release precisa de mais. É exatamente aí que ele sofre OOM kill ou throttling.
É aqui que a otimização revision-aware e rollout-aware da PerfectScale é diferente. A PerfectScale detecta quando uma nova revisão entra no ar e avalia essa versão pelo comportamento dela mesma. Ela trata cada réplica e versão individualmente e entende a estratégia de rollout em uso — seja blue-green, canary ou A/B via Argo Rollouts — sem nenhuma marcação manual. Ela baseia as mudanças na versão que está de fato rodando e, por padrão, pausa novas mudanças enquanto um rollout ainda está em andamento. Você fica com a economia sem apostar seu uptime em dados desatualizados, e isso torna cada deploy mais seguro.
Na prática, é assim: você lança uma release na sexta-feira que adiciona cache em memória, e a necessidade real de memória do serviço salta de 512Mi para 900Mi. Uma ferramenta trabalhando com os dados da semana passada ainda vê 512Mi e reduz o limite nessa direção, então no momento em que a nova versão recebe tráfego, ela sofre OOM kill. A otimização revision-aware vê a nova revisão, avalia pelo uso dela mesma e segura o corte antigo. Mesma automação, nenhum incidente.
A PerfectScale mantém tudo isso dentro de guardrails que você controla: políticas configuráveis por workload, namespace ou cluster; janelas de manutenção que definem quando as mudanças podem rodar; um modo inicial apenas de monitoramento, que não aplica nada até você ativar a automação; e, quando o workload suporta, mudanças aplicadas in place, sem reiniciar seus pods.
Resolvendo custo e confiabilidade com PerfectScale by DoiT
A otimização de custos do Kubernetes só compensa quando os times confiam nela o suficiente para mantê-la ligada. O PerfectScale by DoiT foi feito para isso. Ele monitora seus clusters em busca de riscos de recursos, como OOM kills, CPU throttling e eviction, e os transforma em right-sizing que você pode aplicar manual ou automaticamente — sempre com dados atuais e sempre dentro dos seus guardrails. Times como Paramount Pictures e Creditas usam o PerfectScale para reduzir gastos com nuvem sem abrir mão da estabilidade em produção. A instalação é feita com um único comando Helm e começa em modo somente leitura, para você ver a economia antes de ativar qualquer coisa. Crie sua conta ou agende uma demo para começar.