


¿Qué es GKE Autopilot?
GKE Autopilot es un modo de Google Kubernetes Engine (GKE) en el que Google gestiona gran parte de la infraestructura subyacente del clúster. En lugar de configurar y mantener nodos, grupos de nodos y su capacidad, defines los workloads de Kubernetes y sus requerimientos de recursos. GKE aprovisiona y escala automáticamente los recursos de cómputo necesarios.
Autopilot también se encarga de tareas de infraestructura como las actualizaciones de nodos, la configuración de seguridad y la optimización de recursos. Los workloads siguen usando los objetos y las APIs estándar de Kubernetes, pero Autopilot aplica restricciones y valores predeterminados adicionales para respaldar un modelo operativo gestionado. Esto reduce la administración del clúster sin perder las capacidades de despliegue y orquestación de Kubernetes.
Google Kubernetes Engine (GKE) Autopilot cobra un cargo fijo de gestión de $0.10 por clúster por hora (limitado o compensado por un crédito mensual del nivel gratuito de $74.40 para un clúster que califique), más precios por pod basados en recursos.
Este artículo forma parte de una serie sobre los precios de Kubernetes
En este artículo:
- ¿Qué factores afectan los costos de GKE Autopilot?
- Cómo funcionan los precios de Google Kubernetes Engine
- Los CUDs de Autopilot migraron a Flex CUDs basados en gasto
- Buenas prácticas de precios en GKE Autopilot
¿Qué factores afectan los costos de GKE Autopilot?
Solicitudes de CPU y memoria sobredimensionadas
En los workloads que se facturan según las solicitudes de recursos de los pods, pedir más CPU o memoria de la que una aplicación necesita aumenta el costo aunque esos recursos queden sin usar. Por ejemplo, un pod que solicita 4 vCPU pero normalmente usa 1 vCPU puede facturarse por bastante más cómputo del que la aplicación realmente requiere.
Por eso, unas solicitudes de recursos precisas son importantes tanto para la programación de pods como para el control de costos. Los equipos pueden apoyarse en métricas históricas de utilización, pruebas de carga y recomendaciones de escalado automático vertical de pods para identificar solicitudes sobredimensionadas. Aun así, las solicitudes deben dejar capacidad suficiente para los picos de tráfico normales y el arranque de la aplicación.
Solicitudes mínimas de recursos y ajustes de Autopilot
Autopilot impone requisitos mínimos de CPU, memoria y almacenamiento efímero para los workloads compatibles. Cuando un pod solicita recursos por debajo de estos límites, Autopilot puede aumentar las solicitudes de forma automática. También puede modificarlas cuando la relación CPU-memoria queda fuera del rango que soporta la clase de cómputo seleccionada.
Estos ajustes importan porque los valores usados para la programación y la facturación pueden ser más altos que los especificados originalmente en el manifiesto del workload. Vale la pena revisar en especial las aplicaciones compuestas por muchos pods muy pequeños, ya que los requisitos mínimos de recursos pueden reducir los beneficios de costo que se esperan al dividir el trabajo en contenedores diminutos.
Contenido relacionado: Aprende más sobre cómo las requests y los limits de Kubernetes afectan la programación y el costo
Cantidad de pods en ejecución
La cantidad de pods en ejecución afecta los costos porque cada workload requiere cierta capacidad de cómputo. Aumentar el número de réplicas por disponibilidad, despliegues continuos o escalado horizontal incrementa los requerimientos totales de CPU y memoria. Los pods que permanecen en ejecución de forma continua generan costos incluso en períodos de baja actividad de la aplicación.
La cantidad de pods debe considerarse junto con las solicitudes de recursos. Diez réplicas pequeñas y dos réplicas más grandes pueden ofrecer una capacidad total similar, pero con características distintas de programación y escalado. Los servicios en segundo plano, los sidecars y los componentes del sistema también pueden aumentar los recursos asociados a cada workload.
Selección de la clase de cómputo
Autopilot ofrece clases de cómputo diseñadas para distintos requerimientos: workloads de propósito general, aplicaciones de alto rendimiento, workloads de escalado horizontal y workloads que requieren aceleradores. La clase seleccionada influye en el hardware disponible, los límites de recursos, el comportamiento de programación y los precios aplicables.
Una clase de cómputo especializada puede ser útil cuando una aplicación necesita características de rendimiento específicas, pero puede costar más que una opción de propósito general. Los equipos deberían elegir las clases según los requerimientos medidos de cada workload, en lugar de asignar recursos de mayor rendimiento por defecto. Distintos workloads dentro de un entorno pueden usar clases diferentes cuando sea apropiado.
Región
Los precios de Google Cloud varían según la región, por lo que workloads idénticos pueden tener costos de infraestructura diferentes dependiendo de dónde se ejecuten. Las diferencias regionales pueden afectar los recursos de cómputo, así como el almacenamiento y algunos cargos de red.
El precio no debería ser el único factor al elegir una región. Es posible que las aplicaciones necesiten ejecutarse cerca de los usuarios, las bases de datos u otros servicios para reducir la latencia y la transferencia de red. Los requisitos de residencia de datos y la disponibilidad de servicios también pueden restringir las regiones viables, de modo que el costo regional es solo una parte de una decisión de ubicación más amplia.
Consumo de almacenamiento
Los costos de almacenamiento son independientes de la CPU y la memoria usadas para ejecutar los pods. Las aplicaciones pueden generar cargos por volúmenes persistentes, snapshots, copias de seguridad y otros recursos de almacenamiento. El monto facturado depende de factores como el tipo de almacenamiento, la capacidad aprovisionada, la región y las operaciones realizadas contra el servicio de almacenamiento.
Los recursos persistentes también tienen un ciclo de vida distinto al de los pods. Eliminar o reducir un workload no elimina necesariamente sus discos persistentes, snapshots o copias de seguridad. Por eso, los volúmenes sin uso pueden seguir generando cargos después de que el workload de cómputo haya desaparecido, lo que convierte la gestión del ciclo de vida del almacenamiento en una parte importante del control de costos.
Tráfico de red
Los costos de red dependen de la cantidad de datos transferidos y de hacia dónde viajan. El tráfico entre servicios en regiones distintas, los datos enviados a internet y el tráfico procesado por servicios como Cloud Load Balancing pueden sumar cargos más allá del costo de ejecutar los pods.
La arquitectura de red puede tener, en consecuencia, un gran impacto en las aplicaciones intensivas en datos. Mantener los servicios que se comunican con frecuencia en ubicaciones adecuadas puede reducir tanto la latencia como los costos de transferencia. Los equipos también deberían monitorear el comportamiento de la aplicación para detectar llamadas innecesarias entre regiones, respuestas salientes de gran tamaño y transferencias repetidas de los mismos datos.
GPUs y hardware especializado
Las GPUs y otros aceleradores especializados pueden hacer que ciertos workloads resulten significativamente más caros que los workloads estándar basados en CPU. Los costos dependen del tipo de acelerador, la cantidad de dispositivos, la región, la configuración de cómputo y el tiempo durante el cual se requieren los recursos.
La utilización es especialmente importante en los workloads con aceleradores. Una GPU asignada a un workload que pasa gran parte del tiempo esperando datos o realizando trabajo limitado por CPU ofrece una eficiencia de costos muy baja. La programación por lotes, el escalado automático, la selección adecuada del acelerador y el perfilado de la aplicación pueden ayudar a garantizar que el hardware costoso se use solo cuando aporta un beneficio medible.
Contenido relacionado: Lee nuestro artículo sobre cómo ejecutar workloads de GPU en Kubernetes
Cómo funcionan los precios de Google Kubernetes Engine
Nivel gratuito de GKE y créditos
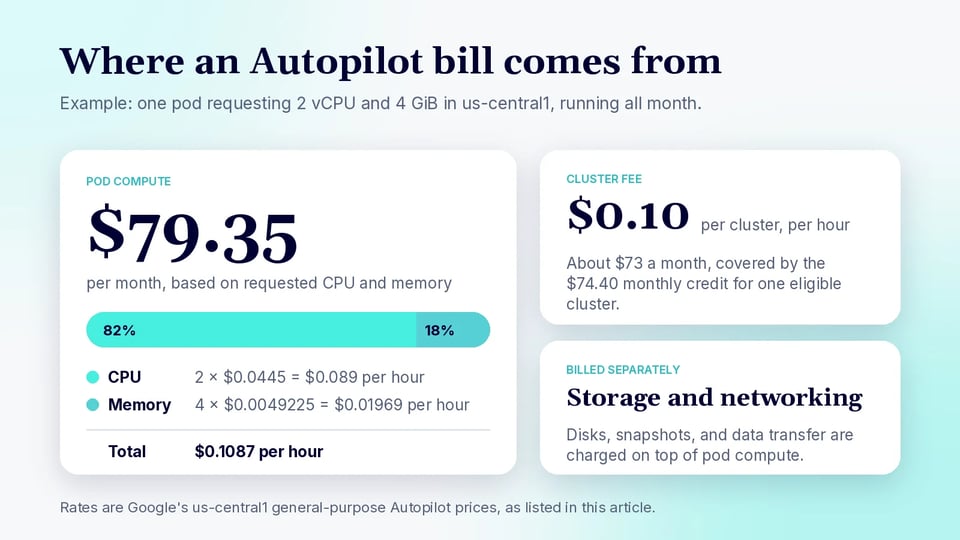
Google Cloud ofrece $74.40 en créditos mensuales de GKE por cuenta de facturación. El crédito se aplica al cargo de gestión de clúster de los clústeres zonales Standard y Autopilot elegibles. Como el cargo de gestión estándar es de $0.10 por clúster por hora, $74.40 alcanza aproximadamente para cubrir un clúster elegible ejecutándose de forma continua durante un mes típico.
Por ejemplo, un clúster que funcione durante 730 horas normalmente generaría alrededor de $73 en cargos de gestión:
730 hours × $0.10 = $73
En este ejemplo, el crédito mensual podría compensar todo el cargo de gestión. No cubre la CPU, la memoria, el almacenamiento ni la red que consumen los workloads.
Cargos de gestión de clúster
GKE cobra un cargo de gestión de $0.10 por clúster por hora, sin importar si el clúster usa el modo Standard o Autopilot.
Por ejemplo, un clúster en ejecución continua durante 730 horas costaría aproximadamente:
730 × $0.10 = $73 per month
Cinco clústeres en ejecución continua generarían aproximadamente $365 al mes en cargos de gestión antes de los créditos aplicables:
5 × $73 = $365
Para los clústeres Autopilot y Standard zonales elegibles, el crédito mensual del nivel gratuito de $74.40 puede compensar parte o la totalidad de estos cargos.
Costos de cómputo
Para los workloads de Autopilot de propósito general en Iowa (us-central1), Google publica actualmente precios bajo demanda de aproximadamente $0.0445 por vCPU por hora y $0.0049225 por GiB de memoria por hora. El almacenamiento efímero se cobra por separado, a aproximadamente $0.0001389 por GiB por hora.
Por ejemplo, considera un pod en ejecución continua que solicita 2 vCPU y 4 GiB de memoria:
- CPU:
2 × $0.0445 = $0.089/hour - Memoria:
4 × $0.0049225 = $0.01969/hour - Total: aproximadamente $0.1087/hora
A lo largo de 730 horas, ese pod costaría alrededor de $79.35 al mes, sin incluir almacenamiento efímero, almacenamiento persistente, red ni otros servicios.
Los recursos de la clase de cómputo Balanced cuestan más. En us-central1, Google publica aproximadamente $0.0645 por vCPU por hora y $0.0071354 por GiB de memoria por hora para los pods Balanced de Autopilot.
Facturación por pod vs. por nodo
Los workloads de Autopilot de propósito general usan facturación por pod. Esto significa que la facturación se basa principalmente en la CPU, la memoria y el almacenamiento efímero que solicita el pod, y no en la capacidad total del nodo subyacente.
Por ejemplo, en us-central1, un pod de propósito general que solicita 1 vCPU y 2 GiB de memoria costaría aproximadamente:
$0.0445 + (2 × $0.0049225) = $0.054345/hour
Eso equivale a unos $39.67 al mes si se ejecuta de forma continua durante 730 horas.
Los workloads de Autopilot que seleccionan hardware específico, como ciertas series de máquinas o GPUs, usan en cambio facturación por nodo. En este modelo, pagas por todo el nodo de Compute Engine subyacente más un recargo de gestión de Autopilot. Por ejemplo, Google publica un recargo de Autopilot Performance de alrededor de $0.004 por vCPU por hora y $0.0005 por GiB de memoria por hora en us-central1, además de los cargos subyacentes de Compute Engine.
Costos de almacenamiento y red
El almacenamiento persistente y el tráfico de red se facturan por separado de los cargos de CPU y memoria de Autopilot. El monto depende de la clase de almacenamiento, la capacidad, el origen y destino del tráfico y la región.
Por ejemplo, los precios de Persistent Disk de Google Cloud en us-central1 incluyen almacenamiento SSD aprovisionado a aproximadamente $0.000232877 por GiB por hora. Un disco SSD de 100 GiB aprovisionado de forma continua costaría, por lo tanto, alrededor de:
100 × $0.000232877 × 730 ≈ $17 per month
El almacenamiento se sigue facturando incluso cuando el pod que lo usa está detenido, si el disco persistente permanece aprovisionado.
Los costos de red también pueden ser significativos. Por ejemplo, la transferencia de datos entre dos regiones de Google Cloud en Norteamérica cuesta actualmente $0.02 por GiB. Transferir 1 TiB entre regiones costaría entonces aproximadamente:
1,024 GiB × $0.02 = $20.48
Los precios de transferencia de datos a internet varían según el destino y el nivel de uso. Por ejemplo, el tráfico saliente de Premium Tier desde una región de EE. UU. hacia Norteamérica está publicado a $0.12 por GiB para el primer TiB después de la cuota gratuita.
Los CUDs de Autopilot migraron a Flex CUDs basados en gasto
Google cambió la forma en que los descuentos por uso comprometido se aplican a GKE Autopilot. Los CUDs basados en gasto específicos de Autopilot ya no están disponibles para nuevas compras. Los commitments existentes de Autopilot siguen siendo válidos hasta que expiren, pero los nuevos commitments para uso elegible de GKE se compran como Compute Flexible CUDs (Flex CUDs).
Los Compute Flexible CUDs son commitments basados en gasto, no compromisos a una cantidad fija de recursos de Kubernetes. Una organización se compromete a un gasto mínimo por hora en dólares durante un plazo de uno o tres años, y el descuento resultante puede aplicarse al uso elegible de GKE, Compute Engine y Cloud Run asociado a la misma cuenta de Cloud Billing. Esto da a las organizaciones más flexibilidad cuando los workloads se mueven entre servicios, regiones o configuraciones de cómputo compatibles.
Google también migró todas las cuentas de Cloud Billing a su nuevo modelo de consumo de CUDs basado en gasto. Con este modelo, el uso elegible se cobra directamente al precio con descuento aplicable, en lugar de facturarse primero a precio de lista y compensarse después con créditos de CUD. Google anunció en febrero de 2026 que todas las cuentas de Cloud Billing habían sido migradas automáticamente y que la cobertura ampliada de Compute Flexible CUDs estaba disponible para todos los clientes.
Para los usuarios de GKE Autopilot, la diferencia práctica es que los ahorros ya no están tan ligados a Autopilot en sí. Un commitment de Compute Flexible puede cubrir el gasto elegible en un conjunto más amplio de servicios de cómputo de Google Cloud, lo que facilita mantener la utilización de los CUDs cuando los requerimientos de infraestructura cambian. Sin embargo, las organizaciones siguen pagando el monto comprometido durante todo el plazo del commitment, por lo que, en general, conviene dimensionar los Flex CUDs en función del gasto base predecible y no de picos temporales.
Buenas prácticas de precios en GKE Autopilot
Estas son algunas prácticas útiles para ayudarte a gestionar los costos al usar GKE Autopilot.
1. Basa las solicitudes de recursos en datos de uso reales
Define las solicitudes de CPU y memoria con base en la utilización observada, no solo en estimaciones. Recopila métricas durante el tráfico normal, los períodos pico, los despliegues y los trabajos en segundo plano para determinar cuánta capacidad requiere realmente cada workload.
Evita reducir las solicitudes al promedio de utilización sin tener en cuenta los picos. Las solicitudes deben dejar suficiente margen para evitar el throttling, la terminación por falta de memoria o el escalado innecesario. Las recomendaciones del escalado automático vertical de pods pueden aportar datos útiles para refinar estos valores con el tiempo.
Acciones clave:
- Mide el uso de CPU y memoria en períodos normales y pico.
- Usa las recomendaciones del VPA para refinar las solicitudes con el tiempo.
- Mantén suficiente margen para evitar throttling o fallos de memoria.
2. Revisa los ajustes de recursos de Autopilot
Verifica los recursos asignados a los pods después del despliegue, en lugar de asumir que los valores del manifiesto original no cambiaron. Autopilot puede modificar las solicitudes de recursos para cumplir los mínimos y otros requisitos asociados a la configuración del workload y las clases de cómputo.
Los ajustes frecuentes pueden indicar que las especificaciones de recursos no se alinean bien con los requisitos de Autopilot. Actualizar los manifiestos para reflejar la configuración efectiva de recursos hace los costos más predecibles y evita que los equipos estimen gastos con valores que en realidad no se están aplicando.
Acciones clave:
- Compara los recursos solicitados con los valores que Autopilot aplica realmente.
- Identifica los pods que se ajustan repetidamente a los mínimos o a las relaciones compatibles.
- Actualiza los manifiestos para que las solicitudes configuradas coincidan con los recursos facturados esperados.
3. Monitorea el costo junto con el rendimiento de la aplicación
Unas solicitudes de recursos más bajas no producen automáticamente costos totales más bajos. Un workload subdimensionado puede experimentar mayor latencia, throttling de CPU, presión de memoria o un escalado horizontal agresivo, lo que puede anular los ahorros esperados.
Compara las métricas de costo con métricas de la aplicación como latencia, rendimiento, tasa de errores, cantidad de réplicas y utilización de recursos. Así es más fácil encontrar configuraciones que reduzcan el gasto sin degradar los objetivos de nivel de servicio ni la confiabilidad de la aplicación.
Acciones clave:
- Haz seguimiento del costo junto con la latencia, el rendimiento, los errores y la cantidad de réplicas.
- Vigila los ahorros que provoquen throttling o un escalado automático excesivo.
- Optimiza tanto la eficiencia de costos como los objetivos de nivel de servicio.
4. Separa los workloads predecibles de los que tienen picos
Los workloads con requerimientos de recursos estables deberían configurarse de forma distinta a las aplicaciones con cambios de tráfico grandes o impredecibles. Los servicios predecibles suelen poder usar solicitudes y cantidades de réplicas bien ajustadas, mientras que los workloads con picos se benefician más del escalado automático.
Separar estos tipos de workloads también facilita entender el comportamiento de capacidad y costos. Por ejemplo, el procesamiento por lotes, los trabajos programados y los servicios orientados a solicitudes pueden usar políticas de escalado distintas en lugar de compartir una configuración diseñada para la demanda máxima posible.
Acciones clave:
- Usa solicitudes y cantidades de réplicas estables para los workloads predecibles.
- Aplica políticas de escalado automático a los servicios variables o con picos.
- Configura por separado los workloads por lotes, programados y orientados a solicitudes.
5. Usa capacidad Spot donde las interrupciones sean aceptables
Los Spot Pods pueden reducir los costos de cómputo de los workloads que toleran interrupciones. Son adecuados para tareas como procesamiento por lotes, trabajos en paralelo, workloads de desarrollo y procesamiento distribuido, donde el trabajo interrumpido puede reintentarse o moverse a otro lugar.
No dependas de la capacidad Spot para workloads que no toleran una terminación repentina, a menos que la aplicación esté diseñada con suficiente redundancia. Usa lógica de reintentos, checkpoints, manejo de apagado controlado y estrategias de interrupción apropiadas para que la capacidad reclamada no cause pérdida de trabajo ni interrupciones de servicio inaceptables.
Acciones clave:
- Usa Spot Pods para workloads reintentables y tolerantes a fallos.
- Agrega checkpoints, reintentos y manejo de apagado controlado.
- Evita la capacidad Spot en workloads que no toleran una terminación repentina.
Preguntas frecuentes
¿Cuánto cuesta GKE Autopilot? GKE Autopilot cobra un cargo de gestión de $0.10 por clúster por hora, unos $73 al mes, más precios por pod según la CPU, la memoria y el almacenamiento efímero que solicitan tus pods. En us-central1, los pods de propósito general están publicados a unos $0.0445 por vCPU por hora y $0.0049225 por GiB de memoria por hora.
¿Existe un nivel gratuito para GKE Autopilot? Google Cloud otorga a cada cuenta de facturación $74.40 en créditos mensuales de GKE. El crédito se aplica al cargo de gestión de clúster de los clústeres zonales Standard y Autopilot elegibles, suficiente para cubrir aproximadamente un clúster. No cubre CPU, memoria, almacenamiento ni red.
¿GKE Autopilot factura según las solicitudes de recursos o el uso real? Los workloads de Autopilot de propósito general usan facturación por pod, que cobra por la CPU, la memoria y el almacenamiento efímero que solicita el pod. Las solicitudes sobredimensionadas cuestan más incluso cuando los recursos quedan ociosos, y Autopilot puede aumentar las solicitudes que están por debajo de sus mínimos.
¿Cuál es la diferencia entre la facturación por pod y por nodo en Autopilot? Con la facturación por pod, pagas por los recursos que solicitan tus pods. Los workloads que seleccionan hardware específico, como ciertas series de máquinas o GPUs, usan en cambio facturación por nodo. En ese caso pagas por todo el nodo de Compute Engine subyacente más un recargo de gestión de Autopilot.
¿Qué pasó con los descuentos por uso comprometido de Autopilot? Los CUDs basados en gasto específicos de Autopilot ya no están disponibles para nuevas compras, y los existentes continúan hasta que expiren. Los nuevos commitments se compran como Compute Flexible CUDs, que pueden aplicarse al gasto elegible de GKE, Compute Engine y Cloud Run en la misma cuenta de Cloud Billing.
Controla los costos de GKE Autopilot con PerfectScale
Como Autopilot factura según las solicitudes de recursos de los pods, la precisión de esas solicitudes determina directamente la factura, y mantenerlas precisas en un entorno cambiante no es una tarea puntual. PerfectScale reduce el gasto en Kubernetes analizando continuamente el comportamiento real de los workloads y aplicando right-sizing de forma automática, para que los clústeres se mantengan eficientes en costos sin sacrificar la resiliencia, la disponibilidad ni el rendimiento de las aplicaciones.
Capacidades clave de PerfectScale:
- Right-sizing autónomo de workloads: optimización continua y en tiempo real que se adapta a los patrones de uso, a las configuraciones de nodos y de escalado automático y a los cambios de código, eliminando la pérdida sin comprometer el rendimiento.
- Reconocimiento de revisiones: las configuraciones de los workloads se reoptimizan dinámicamente con cada nueva versión de código, por lo que las recomendaciones nunca contradicen los cambios de desarrollo.
- Integración con autoscalers: funciona con HPA, KEDA, Karpenter, Cluster Autoscaler, EKS Auto Mode, Fargate, Node Auto Provisioning y Google Autopilot para mejorar la efectividad del escalado que ya utilizas.
- Insights de utilización de nodos y binpacking: visibilidad granular de los nodos para identificar capacidad ociosa, seleccionar los tipos de nodo correctos y mejorar la programación de pods para reducir el tamaño del entorno.
- Visibilidad completa de costos: seguimiento detallado de los costos a lo largo del tiempo por clúster, namespace y workload, con agrupación flexible para asignar el gasto por equipo, subsistema o entorno.
- Insights predictivos de costos: pronostica el gasto futuro y compara el costo con las métricas de rendimiento para alinear las decisiones de ingeniería con los objetivos de FinOps.
- Aplicación de políticas de optimización: políticas dinámicas que gobiernan el costo y el nivel de servicio deseados de cada workload a escala.
- Amplio soporte de nubes y workloads: AWS, Azure, Google, OpenShift, Rancher y nube privada, incluidos workloads personalizados como Spark, Flink y Rollouts.
Descubre cómo PerfectScale reduce los costos de Kubernetes sin sacrificar nada →