


Qu'est-ce que GKE Autopilot ?
GKE Autopilot est un mode de Google Kubernetes Engine (GKE) dans lequel Google gère une grande partie de l'infrastructure sous-jacente du cluster. Au lieu de configurer et de maintenir les nœuds, les pools de nœuds et leur capacité, vous définissez des workloads Kubernetes et leurs besoins en ressources. GKE provisionne et dimensionne automatiquement les ressources de calcul nécessaires.
Autopilot prend également en charge les tâches d'infrastructure telles que la mise à niveau des nœuds, la configuration de la sécurité et l'optimisation des ressources. Les workloads continuent d'utiliser les objets et API Kubernetes standard, mais Autopilot applique des contraintes et des valeurs par défaut supplémentaires au service d'un modèle d'exploitation managé. Cela réduit l'administration du cluster tout en conservant les capacités de déploiement et d'orchestration de Kubernetes.
Google Kubernetes Engine (GKE) Autopilot facture des frais de gestion fixes de 0,10 $ par cluster et par heure (plafonnés ou compensés par un crédit mensuel gratuit de 74,40 $ pour un cluster éligible), plus une tarification au pod basée sur les ressources.
Cet article fait partie d'une série consacrée à la tarification de Kubernetes
Dans cet article :
- Quels facteurs influencent les coûts de GKE Autopilot ?
- Comprendre la tarification de Google Kubernetes Engine
- Les CUD Autopilot remplacées par des Flex CUD basées sur la dépense
- Bonnes pratiques pour la tarification de GKE Autopilot
Quels facteurs influencent les coûts de GKE Autopilot ?
Requests CPU et mémoire surdimensionnées
Pour les workloads facturés sur la base des requests de ressources des pods, demander plus de CPU ou de mémoire que nécessaire augmente le coût, même lorsque ces ressources restent inutilisées. Par exemple, un pod qui demande 4 vCPU mais n'en utilise habituellement qu'un seul peut être facturé sur une capacité de calcul nettement supérieure à ce dont l'application a réellement besoin.
C'est pourquoi des requests de ressources précises sont essentielles, tant pour la planification que pour la maîtrise des coûts. Les équipes peuvent s'appuyer sur les métriques d'utilisation historiques, les tests de charge et les recommandations de l'autoscaling vertical des pods pour identifier les requests surdimensionnées. Les requests doivent néanmoins laisser suffisamment de capacité pour absorber les pics de trafic normaux et le démarrage des applications.
Requests minimales et ajustements d'Autopilot
Autopilot impose des exigences minimales en CPU, mémoire et stockage éphémère pour les workloads pris en charge. Lorsqu'un pod demande des ressources inférieures à ces seuils, Autopilot peut augmenter automatiquement les requests. Il peut également les modifier lorsque le ratio CPU/mémoire sort de la plage prise en charge par la classe de calcul sélectionnée.
Ces ajustements sont importants, car les valeurs utilisées pour la planification et la facturation peuvent être supérieures à celles spécifiées à l'origine dans le manifeste du workload. Les applications composées de nombreux très petits pods méritent une attention particulière, car les exigences minimales de ressources peuvent réduire les gains de coûts attendus du découpage du travail en conteneurs de petite taille.
Contenu associé : découvrez comment les requests et les limits Kubernetes influencent la planification et les coûts
Nombre de pods en cours d'exécution
Le nombre de pods en cours d'exécution influe sur les coûts, car chaque workload nécessite une certaine capacité de calcul. Augmenter le nombre de réplicas pour la disponibilité, les déploiements progressifs ou la mise à l'échelle horizontale accroît les besoins agrégés en CPU et en mémoire. Les pods qui tournent en continu génèrent des coûts même pendant les périodes de faible activité applicative.
Le nombre de pods doit être considéré conjointement avec les requests de ressources. Dix petits réplicas et deux réplicas plus grands peuvent offrir une capacité totale similaire, mais présentent des caractéristiques de planification et de mise à l'échelle différentes. Les services d'arrière-plan, les sidecars et les composants système peuvent également augmenter les ressources associées à chaque workload.
Choix de la classe de calcul
Autopilot propose des classes de calcul conçues pour différents besoins : workloads généralistes, applications haute performance, workloads scale-out ou workloads nécessitant des accélérateurs. La classe sélectionnée détermine le matériel disponible, les limites de ressources, le comportement de planification et la tarification applicable.
Une classe de calcul spécialisée peut être utile lorsqu'une application a besoin de caractéristiques de performance spécifiques, mais elle peut coûter plus cher qu'une option généraliste. Les équipes doivent choisir les classes en fonction des besoins mesurés des workloads plutôt que d'attribuer par défaut des ressources plus performantes. Différents workloads d'un même environnement peuvent utiliser des classes différentes lorsque c'est pertinent.
Région
La tarification de Google Cloud varie selon la région : des workloads identiques peuvent donc avoir des coûts d'infrastructure différents selon l'endroit où ils s'exécutent. Les écarts régionaux peuvent concerner les ressources de calcul, mais aussi le stockage et certains frais réseau.
Le prix ne doit pas être le seul critère de choix d'une région. Les applications peuvent devoir s'exécuter à proximité des utilisateurs, des bases de données ou d'autres services afin de réduire la latence et les transferts réseau. Les exigences de résidence des données et la disponibilité des services peuvent également restreindre les régions envisageables : le coût régional n'est donc qu'un élément d'une décision de placement plus large.
Consommation de stockage
Les coûts de stockage sont distincts du CPU et de la mémoire utilisés pour exécuter les pods. Les applications peuvent générer des frais pour les volumes persistants, les snapshots, les sauvegardes et d'autres ressources de stockage. Le montant facturé dépend de facteurs tels que le type de stockage, la capacité provisionnée, la région et les opérations effectuées sur le service de stockage.
Les ressources persistantes ont par ailleurs un cycle de vie différent de celui des pods. Supprimer ou réduire un workload ne supprime pas nécessairement ses disques persistants, snapshots ou sauvegardes. Des volumes inutilisés peuvent donc continuer à générer des frais après la disparition du workload de calcul, ce qui fait de la gestion du cycle de vie du stockage un élément important de la maîtrise des coûts.
Trafic réseau
Les coûts réseau dépendent du volume de données transférées et de leur destination. Le trafic entre services situés dans des régions différentes, les données envoyées vers l'internet public et le trafic traité par des services comme Cloud Load Balancing peuvent engendrer des frais au-delà du coût d'exécution des pods eux-mêmes.
L'architecture réseau peut donc avoir un impact majeur sur les applications gourmandes en données. Placer les services qui communiquent fréquemment dans des emplacements adaptés permet de réduire à la fois la latence et les coûts de transfert. Les équipes doivent également surveiller le comportement des applications pour détecter les appels inter-régions inutiles, les réponses sortantes volumineuses et les transferts répétés des mêmes données.
GPU et matériel spécialisé
Les GPU et autres accélérateurs spécialisés peuvent rendre certains workloads nettement plus coûteux que les workloads standard basés sur le CPU. Les coûts dépendent du type d'accélérateur, du nombre d'unités, de la région, de la configuration de calcul et de la durée d'utilisation des ressources.
L'utilisation est particulièrement importante pour les workloads avec accélérateurs. Un GPU affecté à un workload qui passe l'essentiel de son temps à attendre des données ou à effectuer des traitements limités par le CPU offre une efficacité économique médiocre. La planification par lots, l'autoscaling, le choix d'un accélérateur adapté et le profilage des applications permettent de s'assurer que le matériel coûteux n'est utilisé que lorsqu'il apporte un bénéfice mesurable.
Contenu associé : lisez notre article sur l'exécution de workloads GPU dans Kubernetes
Comprendre la tarification de Google Kubernetes Engine
Niveau gratuit de GKE et crédits de facturation
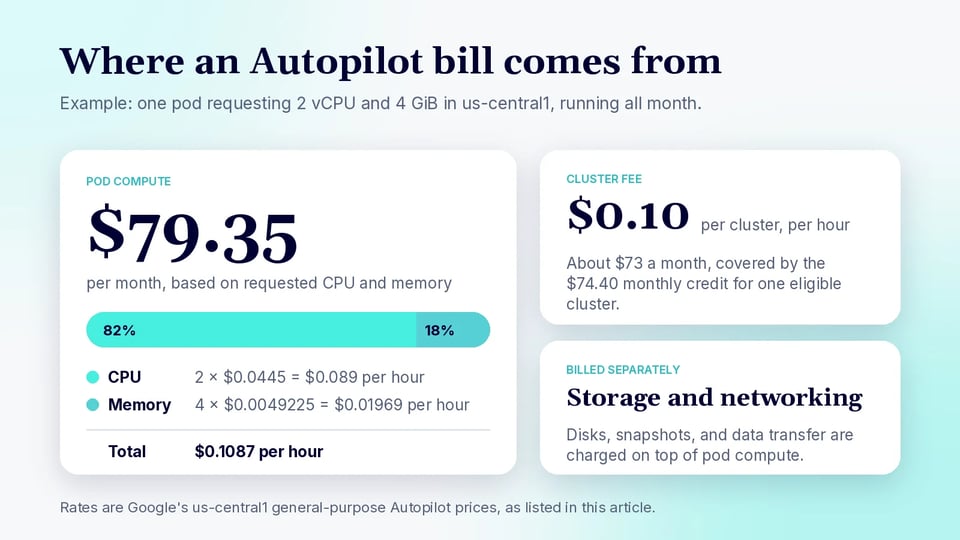
Google Cloud offre 74,40 $ de crédits GKE mensuels par compte de facturation. Ce crédit s'applique aux frais de gestion de cluster des clusters zonaux Standard et Autopilot éligibles. Les frais de gestion standard étant de 0,10 $ par cluster et par heure, 74,40 $ suffisent à peu près à couvrir un cluster éligible fonctionnant en continu pendant un mois type.
Par exemple, un cluster fonctionnant 730 heures engendrerait normalement environ 73 $ de frais de gestion :
730 hours × $0.10 = $73
Dans cet exemple, le crédit mensuel pourrait donc compenser l'intégralité des frais de gestion. Il ne couvre pas le CPU, la mémoire, le stockage ni le réseau consommés par les workloads.
Frais de gestion des clusters
GKE facture des frais de gestion de 0,10 $ par cluster et par heure, que le cluster soit en mode Standard ou Autopilot.
Par exemple, un cluster fonctionnant en continu pendant 730 heures coûterait environ :
730 × $0.10 = $73 per month
Cinq clusters fonctionnant en continu représenteraient environ 365 $ par mois de frais de gestion avant application des crédits :
5 × $73 = $365
Pour les clusters Autopilot et Standard zonaux éligibles, le crédit mensuel gratuit de 74,40 $ peut compenser tout ou partie de ces frais.
Coûts de calcul
Pour les workloads Autopilot généralistes en Iowa (us-central1), Google affiche actuellement une tarification à la demande d'environ 0,0445 $ par vCPU et par heure et 0,0049225 $ par GiB de mémoire et par heure. Le stockage éphémère est facturé séparément, à environ 0,0001389 $ par GiB et par heure.
Prenons l'exemple d'un pod fonctionnant en continu et demandant 2 vCPU et 4 GiB de mémoire :
- CPU :
2 × $0.0445 = $0.089/hour - Mémoire :
4 × $0.0049225 = $0.01969/hour - Total : environ 0,1087 $/heure
Sur 730 heures, ce pod coûterait environ 79,35 $ par mois, hors stockage éphémère, stockage persistant, réseau et autres services.
Les ressources de la classe de calcul Balanced coûtent plus cher. Dans us-central1, Google affiche environ 0,0645 $ par vCPU et par heure et 0,0071354 $ par GiB de mémoire et par heure pour les pods Autopilot Balanced.
Facturation au pod ou au nœud
Les workloads Autopilot généralistes utilisent la facturation au pod. La facturation repose alors principalement sur le CPU, la mémoire et le stockage éphémère demandés par le pod, plutôt que sur la capacité totale du nœud sous-jacent.
Par exemple, dans us-central1, un pod généraliste demandant 1 vCPU et 2 GiB de mémoire coûterait environ :
$0.0445 + (2 × $0.0049225) = $0.054345/hour
Soit environ 39,67 $ par mois s'il fonctionne en continu pendant 730 heures.
Les workloads Autopilot qui sélectionnent du matériel spécifique, comme certaines séries de machines ou des GPU, utilisent en revanche la facturation au nœud. Dans ce modèle, vous payez l'intégralité du nœud Compute Engine sous-jacent, plus une majoration de gestion Autopilot. Par exemple, Google affiche une majoration Autopilot Performance d'environ 0,004 $ par vCPU et par heure et 0,0005 $ par GiB de mémoire et par heure dans us-central1, en plus des frais Compute Engine sous-jacents.
Coûts de stockage et de réseau
Le stockage persistant et le trafic réseau sont facturés séparément des frais de CPU et de mémoire d'Autopilot. Le montant dépend de la classe de stockage, de la capacité, de la source et de la destination du trafic, ainsi que de la région.
Par exemple, la tarification de Google Cloud Persistent Disk dans us-central1 inclut le stockage SSD provisionné à environ 0,000232877 $ par GiB et par heure. Un disque SSD de 100 GiB provisionné en continu coûterait donc environ :
100 × $0.000232877 × 730 ≈ $17 per month
Le stockage reste facturable même lorsque le pod qui l'utilise est arrêté, tant que le disque persistant reste provisionné.
Le réseau peut lui aussi peser dans la facture. Par exemple, le transfert de données inter-régions entre deux régions Google Cloud nord-américaines est actuellement facturé 0,02 $ par GiB. Transférer 1 TiB entre régions coûterait donc environ :
1,024 GiB × $0.02 = $20.48
Les tarifs de transfert de données vers Internet varient selon la destination et le palier d'utilisation. Par exemple, le trafic sortant Premium Tier d'une région américaine vers l'Amérique du Nord est affiché à 0,12 $ par GiB pour le premier TiB au-delà du quota gratuit.
Les CUD Autopilot remplacées par des Flex CUD basées sur la dépense
Google a modifié la manière dont les remises sur engagement d'utilisation (CUD) s'appliquent à GKE Autopilot. Les CUD basées sur la dépense spécifiques à Autopilot ne sont plus disponibles à l'achat. Les commitments Autopilot existants restent pris en charge jusqu'à leur expiration, mais les nouveaux commitments pour l'utilisation GKE éligible s'achètent sous forme de Compute Flexible CUD (Flex CUD).
Les Compute Flexible CUD sont des engagements basés sur la dépense plutôt que sur un nombre fixe de ressources Kubernetes. Une organisation s'engage sur une dépense horaire minimale en dollars pour une durée d'un ou trois ans, et la remise obtenue peut s'appliquer à l'utilisation éligible de GKE, Compute Engine et Cloud Run associée au même compte Cloud Billing. Les organisations gagnent ainsi en flexibilité lorsque les workloads passent d'un service, d'une région ou d'une configuration de calcul prise en charge à l'autre.
Google a également migré tous les comptes Cloud Billing vers son nouveau modèle de consommation des CUD basé sur la dépense. Dans ce modèle, l'utilisation éligible est directement facturée au tarif remisé applicable, au lieu d'être d'abord facturée au prix catalogue puis compensée par des crédits CUD. Google a annoncé en février 2026 que tous les comptes Cloud Billing avaient été automatiquement migrés et que la couverture étendue des Compute Flexible CUD était disponible pour tous les clients.
Pour les utilisateurs de GKE Autopilot, la différence concrète est que les économies sont désormais moins étroitement liées à Autopilot lui-même. Un engagement Compute Flexible peut couvrir les dépenses éligibles d'un éventail plus large de services de calcul Google Cloud, ce qui facilite le maintien de l'utilisation des CUD lorsque les besoins d'infrastructure évoluent. Les organisations paient toutefois le montant engagé pendant toute la durée du commitment : les Flex CUD doivent donc généralement être dimensionnées sur la dépense de base prévisible plutôt que sur des pics temporaires.
Bonnes pratiques pour la tarification de GKE Autopilot
Voici quelques pratiques utiles pour maîtriser vos coûts avec GKE Autopilot.
1. Basez les requests de ressources sur des données d'utilisation réelles
Définissez les requests CPU et mémoire à partir de l'utilisation observée plutôt que sur de simples estimations. Collectez des métriques sur le trafic normal, les périodes de pic, les déploiements et les tâches d'arrière-plan afin de déterminer la capacité réellement nécessaire à chaque workload.
Évitez de réduire les requests à l'utilisation moyenne sans tenir compte des pics. Les requests doivent offrir une marge suffisante pour éviter le throttling, les arrêts pour dépassement de mémoire ou une mise à l'échelle inutile. Les recommandations de l'autoscaling vertical des pods fournissent des données utiles pour affiner ces valeurs au fil du temps.
Actions clés :
- Mesurez l'utilisation CPU et mémoire en période normale comme en période de pic.
- Appuyez-vous sur les recommandations du VPA pour affiner les requests au fil du temps.
- Conservez une marge suffisante pour éviter le throttling ou les erreurs mémoire.
2. Vérifiez les ajustements de ressources d'Autopilot
Vérifiez les ressources attribuées aux pods après le déploiement, plutôt que de supposer que les valeurs du manifeste d'origine restent inchangées. Autopilot peut modifier les requests de ressources pour respecter les minimums et les autres exigences liées à la configuration des workloads et aux classes de calcul.
Des ajustements fréquents peuvent indiquer que les spécifications de ressources ne correspondent pas bien aux exigences d'Autopilot. Mettre à jour les manifestes pour refléter la configuration effective rend les coûts plus prévisibles et évite aux équipes d'estimer leurs dépenses à partir de valeurs qui ne sont pas réellement appliquées.
Actions clés :
- Comparez les ressources demandées aux valeurs effectivement appliquées par Autopilot.
- Identifiez les pods régulièrement ajustés aux minimums ou aux ratios pris en charge.
- Mettez à jour les manifestes pour que les requests configurées correspondent aux ressources facturées attendues.
3. Surveillez les coûts en parallèle des performances applicatives
Des requests plus faibles ne se traduisent pas automatiquement par des coûts globaux plus bas. Un workload sous-dimensionné peut subir une latence accrue, du throttling CPU, une pression mémoire ou une mise à l'échelle horizontale agressive, autant d'effets susceptibles d'annuler les économies attendues.
Comparez les métriques de coûts avec les métriques applicatives telles que la latence, le débit, le taux d'erreur, le nombre de réplicas et l'utilisation des ressources. Il devient ainsi plus facile de trouver des configurations qui réduisent les dépenses sans dégrader les objectifs de niveau de service ni la fiabilité des applications.
Actions clés :
- Suivez les coûts conjointement avec la latence, le débit, les erreurs et le nombre de réplicas.
- Repérez les économies qui déclenchent du throttling ou un autoscaling excessif.
- Optimisez à la fois l'efficacité économique et les objectifs de niveau de service.
4. Séparez les workloads prévisibles des workloads à pics de charge
Les workloads aux besoins en ressources stables doivent être configurés différemment des applications soumises à des variations de trafic importantes ou imprévisibles. Les services prévisibles peuvent souvent s'appuyer sur des requests et des nombres de réplicas finement ajustés, tandis que les workloads à pics de charge tirent davantage parti de l'autoscaling.
Séparer ces types de workloads rend également le comportement en matière de capacité et de coûts plus lisible. Par exemple, les traitements par lots, les tâches planifiées et les services pilotés par les requêtes peuvent utiliser des politiques de mise à l'échelle différentes au lieu de partager une configuration dimensionnée sur la demande maximale possible.
Actions clés :
- Utilisez des requests et des nombres de réplicas stables pour les workloads prévisibles.
- Appliquez des politiques d'autoscaling aux services variables ou à pics de charge.
- Configurez séparément les workloads batch, planifiés et pilotés par les requêtes.
5. Utilisez la capacité Spot lorsque les interruptions sont acceptables
Les Spot Pods peuvent réduire les coûts de calcul des workloads capables de tolérer les interruptions. Ils conviennent aux traitements par lots, aux tâches parallèles, aux workloads de développement et aux traitements distribués, lorsque le travail interrompu peut être relancé ou déplacé ailleurs.
Ne vous appuyez pas sur la capacité Spot pour les workloads qui ne tolèrent pas un arrêt soudain, sauf si l'application est conçue avec une redondance suffisante. Prévoyez des mécanismes de reprise, des checkpoints, une gestion propre de l'arrêt (graceful shutdown) et des stratégies de disruption adaptées, afin que la récupération de capacité n'entraîne ni perte de travail ni interruption de service inacceptable.
Actions clés :
- Utilisez les Spot Pods pour les workloads relançables et tolérants aux pannes.
- Ajoutez des checkpoints, des mécanismes de reprise et une gestion propre de l'arrêt.
- Évitez la capacité Spot pour les workloads qui ne tolèrent pas un arrêt soudain.
FAQ
Combien coûte GKE Autopilot ? GKE Autopilot facture des frais de gestion de 0,10 $ par cluster et par heure, soit environ 73 $ par mois, plus une tarification au pod pour le CPU, la mémoire et le stockage éphémère demandés par vos pods. Dans us-central1, les pods généralistes sont affichés à environ 0,0445 $ par vCPU et par heure et 0,0049225 $ par GiB de mémoire et par heure.
GKE Autopilot propose-t-il un niveau gratuit ? Google Cloud accorde à chaque compte de facturation 74,40 $ de crédits GKE mensuels. Ce crédit s'applique aux frais de gestion des clusters zonaux Standard et Autopilot éligibles, ce qui suffit à couvrir environ un cluster. Il ne couvre pas le CPU, la mémoire, le stockage ni le réseau.
GKE Autopilot facture-t-il les requests de ressources ou l'utilisation réelle ? Les workloads Autopilot généralistes utilisent la facturation au pod, qui porte sur le CPU, la mémoire et le stockage éphémère demandés par le pod. Des requests surdimensionnées coûtent plus cher même lorsque les ressources restent inutilisées, et Autopilot peut relever les requests inférieures à ses minimums.
Quelle est la différence entre la facturation au pod et la facturation au nœud dans Autopilot ? Avec la facturation au pod, vous payez les ressources demandées par vos pods. Les workloads qui sélectionnent du matériel spécifique, comme certaines séries de machines ou des GPU, utilisent la facturation au nœud. Vous payez alors l'intégralité du nœud Compute Engine sous-jacent, plus une majoration de gestion Autopilot.
Qu'est-il advenu des remises sur engagement d'utilisation (CUD) d'Autopilot ? Les CUD basées sur la dépense spécifiques à Autopilot ne sont plus disponibles à l'achat, et celles qui existent restent valables jusqu'à leur expiration. Les nouveaux commitments s'achètent sous forme de Compute Flexible CUD, applicables aux dépenses éligibles GKE, Compute Engine et Cloud Run d'un même compte Cloud Billing.
Maîtriser les coûts de GKE Autopilot avec PerfectScale
Comme Autopilot facture sur la base des requests de ressources des pods, leur précision détermine directement la facture — et les maintenir justes dans un environnement en constante évolution n'est pas un exercice ponctuel. PerfectScale réduit les dépenses Kubernetes en analysant en continu le comportement réel des workloads et en appliquant automatiquement le right-sizing, afin que les clusters restent économes sans sacrifier la résilience, la disponibilité ni les performances applicatives.
Principales capacités de PerfectScale :
- Right-sizing autonome des workloads : optimisation continue et en temps réel qui s'adapte aux schémas d'utilisation, aux configurations de nœuds et d'autoscaling et aux évolutions du code, éliminant le gaspillage sans compromettre les performances.
- Prise en compte des révisions : les configurations des workloads sont réoptimisées dynamiquement à chaque nouvelle version du code, de sorte que les recommandations ne contredisent jamais les changements de développement.
- Intégration avec les autoscalers : fonctionne avec HPA, KEDA, Karpenter, Cluster Autoscaler, EKS Auto Mode, Fargate, Node Auto Provisioning et Google Autopilot pour renforcer l'efficacité de la mise à l'échelle déjà en place.
- Analyse de l'utilisation des nœuds et du binpacking : visibilité granulaire sur les nœuds pour identifier la capacité inutilisée, choisir les bons types de nœuds et améliorer la planification des pods afin de réduire la taille de l'environnement.
- Visibilité complète sur les coûts : suivi détaillé des coûts dans le temps par cluster, namespace et workload, avec des regroupements flexibles pour ventiler les dépenses par équipe, sous-système ou environnement.
- Analyses prédictives des coûts : prévoyez les dépenses futures et comparez les coûts aux métriques de performance pour aligner les décisions d'engineering sur les objectifs FinOps.
- Application de politiques d'optimisation : des politiques dynamiques qui régissent à grande échelle le coût et le niveau de service souhaités de chaque workload.
- Large prise en charge des clouds et des workloads : AWS, Azure, Google, OpenShift, Rancher et cloud privé, y compris les workloads personnalisés comme Spark, Flink et Rollouts.
Découvrez comment PerfectScale réduit les coûts Kubernetes sans compromis →