


O que é o GKE Autopilot?
O GKE Autopilot é um modo do Google Kubernetes Engine (GKE) em que o Google gerencia grande parte da infraestrutura subjacente do cluster. Em vez de configurar e manter nós, pools de nós e sua capacidade, você define as workloads do Kubernetes e seus requisitos de recursos. O GKE provisiona e escala automaticamente os recursos de computação necessários.
O Autopilot também cuida de tarefas de infraestrutura, como upgrades de nós, configuração de segurança e otimização de recursos. As workloads continuam usando objetos e APIs padrão do Kubernetes, mas o Autopilot aplica restrições e padrões adicionais para dar suporte a um modelo operacional gerenciado. Isso reduz a administração do cluster, mantendo os recursos de implantação e orquestração do Kubernetes.
O Google Kubernetes Engine (GKE) Autopilot cobra uma taxa fixa de gerenciamento de US$ 0,10 por cluster por hora (limitada ou compensada por um crédito mensal gratuito de US$ 74,40 para um cluster qualificado), além da cobrança por pod baseada em recursos.
Este artigo faz parte de uma série sobre preços do Kubernetes
Neste artigo:
- Quais fatores afetam os custos do GKE Autopilot?
- Entendendo os preços do Google Kubernetes Engine
- Os CUDs do Autopilot migraram para os Flex CUDs baseados em gastos
- Boas práticas de preços do GKE Autopilot
Quais fatores afetam os custos do GKE Autopilot?
Requests de CPU e memória superprovisionados
Para workloads cobradas com base nos requests de recursos dos pods, solicitar mais CPU ou memória do que a aplicação precisa aumenta o custo mesmo quando esses recursos permanecem ociosos. Por exemplo, um pod que solicita 4 vCPUs, mas normalmente usa 1 vCPU, pode ser cobrado com base em uma capacidade de computação substancialmente maior do que a aplicação realmente exige.
Por isso, requests de recursos precisos são importantes tanto para o agendamento quanto para o controle de custos. As equipes podem usar métricas históricas de utilização, testes de carga e recomendações de escalonamento automático vertical de pods para identificar requests superdimensionados. Os requests ainda devem deixar capacidade suficiente para os picos normais de tráfego e para a inicialização da aplicação.
Requests mínimos de recursos e ajustes do Autopilot
O Autopilot impõe requisitos mínimos de CPU, memória e armazenamento efêmero para as workloads compatíveis. Quando um pod solicita recursos abaixo desses limites, o Autopilot pode aumentar os requests automaticamente. Ele também pode modificar os requests quando a proporção entre CPU e memória fica fora do intervalo compatível com a classe de computação selecionada.
Esses ajustes são importantes porque os valores usados para agendamento e cobrança podem ser maiores do que os especificados originalmente no manifesto da workload. Aplicações compostas por muitos pods muito pequenos merecem atenção especial, já que os requisitos mínimos de recursos podem reduzir os benefícios de custo esperados ao dividir o trabalho em contêineres minúsculos.
Conteúdo relacionado: saiba mais sobre como requests e limits do Kubernetes afetam o agendamento e os custos
Número de pods em execução
O número de pods em execução afeta os custos porque toda workload exige alguma capacidade de computação. Aumentar a quantidade de réplicas para disponibilidade, deployments graduais ou escalonamento horizontal eleva os requisitos agregados de CPU e memória. Pods que permanecem em execução contínua geram custos mesmo em períodos de baixa atividade da aplicação.
A contagem de pods deve ser considerada junto com os requests de recursos. Dez réplicas pequenas e duas réplicas maiores podem oferecer uma capacidade total semelhante, mas com características diferentes de agendamento e escalonamento. Serviços em segundo plano, sidecars e componentes do sistema também podem aumentar os recursos associados a cada workload.
Seleção da classe de computação
O Autopilot oferece classes de computação projetadas para diferentes requisitos de workloads, como workloads de uso geral, aplicações de alto desempenho, workloads de scale-out e workloads que exigem aceleradores. A classe selecionada influencia o hardware disponível, os limites de recursos, o comportamento de agendamento e os preços aplicáveis.
Uma classe de computação especializada pode ser útil quando uma aplicação precisa de características específicas de desempenho, mas pode custar mais do que uma opção de uso geral. As equipes devem selecionar as classes com base em requisitos medidos das workloads, em vez de atribuir recursos de maior desempenho por padrão. Workloads diferentes dentro de um ambiente podem usar classes diferentes quando apropriado.
Região
Os preços do Google Cloud variam por região, então workloads idênticas podem ter custos de infraestrutura diferentes dependendo de onde são executadas. As diferenças regionais podem afetar os recursos de computação, bem como o armazenamento e algumas cobranças de rede.
O preço não deve ser o único fator na escolha da região. As aplicações podem precisar ser executadas perto dos usuários, dos bancos de dados ou de outros serviços para reduzir a latência e a transferência de rede. Requisitos de residência de dados e a disponibilidade de serviços também podem restringir as regiões viáveis, tornando o custo regional apenas uma parte de uma decisão de posicionamento mais ampla.
Consumo de armazenamento
Os custos de armazenamento são separados da CPU e da memória usadas para executar os pods. As aplicações podem gerar cobranças por volumes persistentes, snapshots, backups e outros recursos de armazenamento. O valor cobrado depende de fatores como tipo de armazenamento, capacidade provisionada, região e as operações realizadas no serviço de armazenamento.
Os recursos persistentes também têm um ciclo de vida diferente do ciclo dos pods. Excluir ou reduzir uma workload não necessariamente exclui seus discos persistentes, snapshots ou backups. Volumes não utilizados podem, portanto, continuar gerando cobranças depois que a workload de computação desapareceu, o que torna o gerenciamento do ciclo de vida do armazenamento uma parte importante do controle de custos.
Tráfego de rede
Os custos de rede dependem da quantidade de dados transferidos e do destino desses dados. O tráfego entre serviços em regiões diferentes, os dados enviados para a internet pública e o tráfego processado por serviços como o Cloud Load Balancing podem adicionar cobranças além do custo de execução dos próprios pods.
A arquitetura de rede pode, portanto, ter um grande impacto em aplicações com uso intensivo de dados. Manter serviços que se comunicam com frequência em locais apropriados pode reduzir tanto a latência quanto os custos de transferência. As equipes também devem monitorar o comportamento das aplicações para identificar chamadas desnecessárias entre regiões, respostas de saída grandes e transferências repetidas dos mesmos dados.
GPUs e hardware especializado
GPUs e outros aceleradores especializados podem tornar workloads individuais significativamente mais caras do que workloads padrão baseadas em CPU. Os custos dependem do tipo de acelerador, do número de dispositivos, da região, da configuração de computação e do tempo durante o qual os recursos são necessários.
A utilização é particularmente importante para workloads com aceleradores. Uma GPU atribuída a uma workload que passa grande parte do tempo esperando por dados ou executando trabalho limitado pela CPU oferece baixa eficiência de custo. Agendamento em lote, escalonamento automático, seleção adequada de aceleradores e profiling da aplicação podem ajudar a garantir que o hardware caro seja usado apenas quando oferece um benefício mensurável.
Conteúdo relacionado: leia nosso artigo sobre a execução de workloads de GPU no Kubernetes
Entendendo os preços do Google Kubernetes Engine
Nível gratuito e créditos do GKE
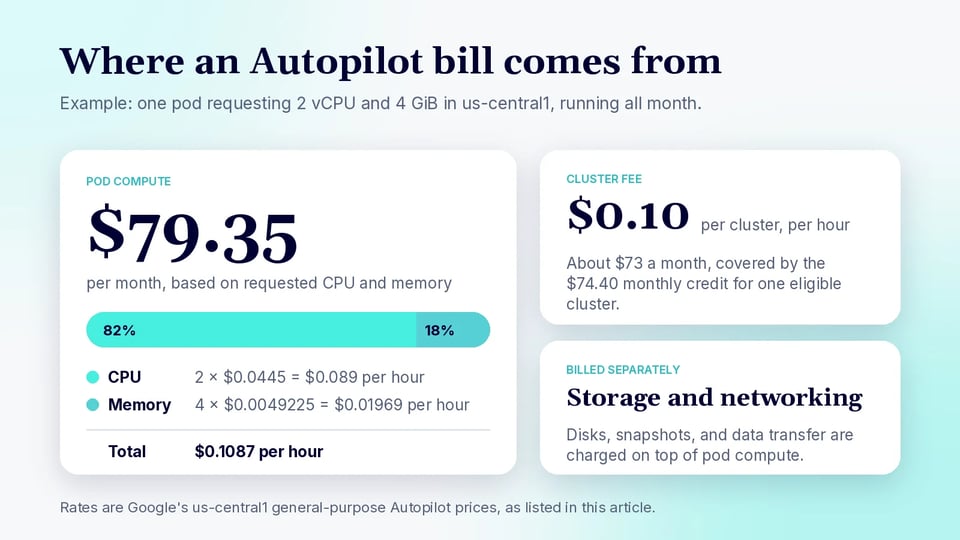
O Google Cloud oferece US$ 74,40 em créditos mensais do GKE por conta de faturamento. O crédito se aplica à taxa de gerenciamento de cluster para clusters zonais Standard e Autopilot qualificados. Como a taxa padrão de gerenciamento de cluster é de US$ 0,10 por cluster por hora, US$ 74,40 são aproximadamente suficientes para cobrir um cluster qualificado em execução contínua durante um mês típico.
Por exemplo, um cluster em execução por 730 horas normalmente geraria cerca de US$ 73 em taxas de gerenciamento:
730 hours × $0.10 = $73
O crédito mensal poderia, portanto, compensar toda a taxa de gerenciamento neste exemplo. Ele não cobre a CPU, a memória, o armazenamento nem a rede consumidos pelas workloads.
Taxas de gerenciamento de cluster
O GKE cobra uma taxa de gerenciamento de US$ 0,10 por cluster por hora, independentemente de o cluster usar o modo Standard ou Autopilot.
Por exemplo, um cluster em execução contínua por 730 horas custaria aproximadamente:
730 × $0.10 = $73 per month
Cinco clusters em execução contínua gerariam aproximadamente US$ 365 por mês em taxas de gerenciamento, antes dos créditos aplicáveis:
5 × $73 = $365
Para clusters Autopilot e Standard zonais qualificados, o crédito mensal de US$ 74,40 do nível gratuito pode compensar parte ou a totalidade dessas cobranças.
Custos de computação
Para workloads de uso geral do Autopilot em Iowa (us-central1), o Google atualmente lista preços sob demanda de aproximadamente US$ 0,0445 por vCPU por hora e US$ 0,0049225 por GiB de memória por hora. O armazenamento efêmero é cobrado separadamente, a aproximadamente US$ 0,0001389 por GiB por hora.
Por exemplo, considere um pod em execução contínua que solicita 2 vCPUs e 4 GiB de memória:
- CPU:
2 × $0.0445 = $0.089/hour - Memória:
4 × $0.0049225 = $0.01969/hour - Total: aproximadamente US$ 0,1087/hora
Ao longo de 730 horas, esse pod custaria cerca de US$ 79,35 por mês, excluindo armazenamento efêmero, armazenamento persistente, rede e outros serviços.
Os recursos da classe de computação Balanced custam mais. Em us-central1, o Google lista aproximadamente US$ 0,0645 por vCPU por hora e US$ 0,0071354 por GiB de memória por hora para pods Balanced do Autopilot.
Cobrança por pod vs. cobrança por nó
As workloads de uso geral do Autopilot usam a cobrança por pod. Isso significa que a cobrança se baseia principalmente na CPU, na memória e no armazenamento efêmero solicitados pelo pod, e não na capacidade total do nó subjacente.
Por exemplo, em us-central1, um pod de uso geral que solicita 1 vCPU e 2 GiB de memória custaria aproximadamente:
$0.0445 + (2 × $0.0049225) = $0.054345/hour
Isso dá cerca de US$ 39,67 por mês se ele for executado continuamente por 730 horas.
As workloads do Autopilot que selecionam hardware específico, como determinadas séries de máquinas ou GPUs, usam a cobrança por nó. Nesse modelo, você paga por todo o nó subjacente do Compute Engine, além de um adicional de gerenciamento do Autopilot. Por exemplo, o Google lista um adicional de Autopilot Performance de cerca de US$ 0,004 por vCPU por hora e US$ 0,0005 por GiB de memória por hora em us-central1, além das cobranças subjacentes do Compute Engine.
Custos de armazenamento e rede
O armazenamento persistente e o tráfego de rede são cobrados separadamente das cobranças de CPU e memória do Autopilot. O valor depende da classe de armazenamento, da capacidade, da origem e do destino do tráfego e da região.
Por exemplo, os preços do Persistent Disk do Google Cloud em us-central1 incluem armazenamento SSD provisionado a aproximadamente US$ 0,000232877 por GiB por hora. Um disco SSD de 100 GiB provisionado continuamente custaria, portanto, cerca de:
100 × $0.000232877 × 730 ≈ $17 per month
O armazenamento continua sendo cobrado mesmo quando o pod que o utiliza está parado, se o próprio disco persistente permanecer provisionado.
A rede também pode se tornar significativa. Por exemplo, a transferência de dados entre duas regiões do Google Cloud na América do Norte custa atualmente US$ 0,02 por GiB. Transferir 1 TiB entre regiões custaria, portanto, aproximadamente:
1,024 GiB × $0.02 = $20.48
As tarifas de transferência de dados pela internet variam conforme o destino e a faixa de uso. Por exemplo, o tráfego de saída do Nível Premium de uma região dos EUA para a América do Norte é listado a US$ 0,12 por GiB para o primeiro 1 TiB após a franquia gratuita.
Os CUDs do Autopilot migraram para os Flex CUDs baseados em gastos
O Google mudou a forma como os descontos por compromisso de uso (CUDs) se aplicam ao GKE Autopilot. Os CUDs baseados em gastos específicos do Autopilot não estão mais disponíveis para novas compras. Os commitments existentes do Autopilot continuam tendo suporte até expirarem, mas novos commitments para uso qualificado do GKE são adquiridos como Compute Flexible CUDs (Flex CUDs).
Os Compute Flexible CUDs são commitments baseados em gastos, e não compromissos com um número fixo de recursos do Kubernetes. A organização se compromete com um gasto mínimo por hora, em dólares, por um período de um ou três anos, e o desconto resultante pode se aplicar ao uso qualificado do GKE, do Compute Engine e do Cloud Run associado à mesma conta do Cloud Billing. Isso dá às organizações mais flexibilidade quando as workloads se movem entre serviços, regiões ou configurações de computação compatíveis.
O Google também migrou todas as contas do Cloud Billing para o seu novo modelo de consumo de CUDs baseado em gastos. Nesse modelo, o uso qualificado é cobrado diretamente pelo preço com desconto aplicável, em vez de ser primeiro faturado pelo preço de tabela e depois compensado por créditos de CUD. O Google anunciou em fevereiro de 2026 que todas as contas do Cloud Billing haviam sido migradas automaticamente e que a cobertura ampliada dos Compute Flexible CUDs estava disponível para todos os clientes.
Para os usuários do GKE Autopilot, a diferença prática é que as economias agora estão menos atreladas ao próprio Autopilot. Um commitment do tipo Compute Flexible pode cobrir gastos qualificados em um conjunto mais amplo de serviços de computação do Google Cloud, facilitando a manutenção da utilização dos CUDs quando os requisitos de infraestrutura mudam. No entanto, as organizações continuam pagando pelo valor comprometido durante todo o prazo do commitment, então os Flex CUDs geralmente devem ser dimensionados com base nos gastos previsíveis de linha de base, e não em picos temporários.
Boas práticas de preços do GKE Autopilot
Veja algumas práticas úteis para gerenciar os custos ao usar o GKE Autopilot.
1. Baseie os requests de recursos em dados reais de uso
Defina os requests de CPU e memória com base na utilização observada, e não apenas em estimativas. Colete métricas durante o tráfego normal, os períodos de pico, os deployments e os jobs em segundo plano para determinar quanta capacidade cada workload realmente exige.
Evite reduzir os requests para a utilização média sem considerar os picos. Os requests devem oferecer margem suficiente para evitar throttling, encerramentos por falta de memória ou escalonamento desnecessário. As recomendações de escalonamento automático vertical de pods podem fornecer dados úteis para refinar esses valores ao longo do tempo.
Ações principais:
- Meça o uso de CPU e memória em períodos normais e de pico.
- Use as recomendações do VPA para refinar os requests ao longo do tempo.
- Mantenha margem suficiente para evitar throttling ou falhas de memória.
2. Revise os ajustes de recursos do Autopilot
Verifique os recursos atribuídos aos pods após o deployment, em vez de presumir que os valores do manifesto original permanecem inalterados. O Autopilot pode modificar os requests de recursos para atender aos mínimos e a outros requisitos associados à configuração da workload e às classes de computação.
Ajustes frequentes podem indicar que as especificações de recursos não estão bem alinhadas aos requisitos do Autopilot. Atualizar os manifestos para refletir a configuração efetiva de recursos torna os custos mais previsíveis e evita que as equipes estimem despesas com valores que não estão realmente sendo aplicados.
Ações principais:
- Compare os recursos solicitados com os valores que o Autopilot realmente aplica.
- Identifique pods que são ajustados repetidamente para os mínimos ou para as proporções compatíveis.
- Atualize os manifestos para que os requests configurados correspondam aos recursos que serão cobrados.
3. Monitore o custo junto com o desempenho da aplicação
Requests de recursos menores não produzem automaticamente custos totais menores. Uma workload subdimensionada pode sofrer aumento de latência, throttling de CPU, pressão de memória ou escalonamento horizontal agressivo, o que pode anular a economia esperada.
Compare as métricas de custo com métricas da aplicação, como latência, throughput, taxa de erros, número de réplicas e utilização de recursos. Isso facilita encontrar configurações que reduzam os gastos sem degradar os objetivos de nível de serviço ou a confiabilidade da aplicação.
Ações principais:
- Acompanhe o custo junto com latência, throughput, erros e número de réplicas.
- Fique atento a economias que provoquem throttling ou escalonamento automático excessivo.
- Otimize tanto a eficiência de custos quanto os objetivos de nível de serviço.
4. Separe as workloads previsíveis das workloads com picos de demanda
Workloads com requisitos estáveis de recursos devem ser configuradas de forma diferente de aplicações com variações grandes ou imprevisíveis de tráfego. Serviços previsíveis geralmente podem usar requests e contagens de réplicas cuidadosamente ajustados, enquanto workloads com picos se beneficiam mais do escalonamento automático.
Separar esses tipos de workload também torna o comportamento de capacidade e de custo mais fácil de entender. Por exemplo, processamento em lote, jobs agendados e serviços orientados a requisições podem usar políticas de escalonamento diferentes, em vez de compartilhar uma configuração projetada para a maior demanda possível.
Ações principais:
- Use requests e contagens de réplicas estáveis para workloads previsíveis.
- Aplique políticas de escalonamento automático a serviços variáveis ou com picos de demanda.
- Configure separadamente as workloads em lote, agendadas e orientadas a requisições.
5. Use capacidade Spot quando interrupções forem aceitáveis
Os Spot Pods podem reduzir os custos de computação para workloads que toleram interrupções. Eles são adequados para tarefas como processamento em lote, jobs paralelos, workloads de desenvolvimento e processamento distribuído, nas quais o trabalho interrompido pode ser repetido ou movido para outro lugar.
Não dependa da capacidade Spot para workloads que não toleram encerramentos repentinos, a menos que a aplicação tenha sido projetada com redundância suficiente. Use lógica de novas tentativas, checkpoints, tratamento de desligamento gradual (graceful shutdown) e estratégias adequadas de disrupção para que a capacidade recuperada não cause perda de trabalho ou interrupções inaceitáveis no serviço.
Ações principais:
- Use Spot Pods para workloads tolerantes a falhas e que podem ser reexecutadas.
- Adicione checkpoints, novas tentativas e tratamento de desligamento gradual.
- Evite a capacidade Spot para workloads que não toleram encerramentos repentinos.
FAQ
Quanto custa o GKE Autopilot? O GKE Autopilot cobra uma taxa de gerenciamento de US$ 0,10 por cluster por hora, cerca de US$ 73 por mês, além da cobrança por pod para a CPU, a memória e o armazenamento efêmero que seus pods solicitam. Em us-central1, os pods de uso geral são listados a cerca de US$ 0,0445 por vCPU por hora e US$ 0,0049225 por GiB de memória por hora.
O GKE Autopilot tem um nível gratuito? O Google Cloud concede a cada conta de faturamento US$ 74,40 em créditos mensais do GKE. O crédito se aplica à taxa de gerenciamento de cluster de clusters zonais Standard e Autopilot qualificados, o que é suficiente para cobrir cerca de um cluster. Ele não cobre CPU, memória, armazenamento nem rede.
O GKE Autopilot cobra pelos requests de recursos ou pelo uso real? As workloads de uso geral do Autopilot usam a cobrança por pod, que cobra pela CPU, pela memória e pelo armazenamento efêmero que o pod solicita. Requests superdimensionados custam mais mesmo quando os recursos ficam ociosos, e o Autopilot pode aumentar requests que ficam abaixo dos seus mínimos.
Qual é a diferença entre a cobrança por pod e a cobrança por nó no Autopilot? Com a cobrança por pod, você paga pelos recursos que seus pods solicitam. Workloads que selecionam hardware específico, como determinadas séries de máquinas ou GPUs, usam a cobrança por nó. Nesse caso, você paga por todo o nó subjacente do Compute Engine, além de um adicional de gerenciamento do Autopilot.
O que aconteceu com os descontos por compromisso de uso do Autopilot? Os CUDs baseados em gastos específicos do Autopilot não estão mais disponíveis para novas compras, e os existentes continuam até expirarem. Novos commitments são adquiridos como Compute Flexible CUDs, que podem se aplicar a gastos qualificados do GKE, do Compute Engine e do Cloud Run na mesma conta do Cloud Billing.
Controlando os custos do GKE Autopilot com o PerfectScale
Como o Autopilot cobra com base nos requests de recursos dos pods, a precisão desses requests determina diretamente a fatura — e mantê-los precisos em um ambiente que muda o tempo todo não é uma tarefa pontual. O PerfectScale reduz os gastos com Kubernetes analisando continuamente como as workloads realmente se comportam e fazendo o right-sizing delas automaticamente, para que os clusters continuem eficientes em custo sem sacrificar resiliência, disponibilidade ou desempenho das aplicações.
Principais recursos do PerfectScale:
- Right-sizing autônomo de workloads: otimização contínua e em tempo real que se adapta aos padrões de uso, às configurações de nós e de escalonamento automático e às mudanças de código, eliminando o desperdício sem comprometer o desempenho.
- Reconhecimento de revisões: as configurações das workloads são reotimizadas dinamicamente a cada nova release de código, para que as recomendações nunca contradigam as mudanças de desenvolvimento.
- Integração com autoscalers: funciona com HPA, KEDA, Karpenter, Cluster Autoscaler, EKS Auto Mode, Fargate, Node Auto Provisioning e Google Autopilot para melhorar a eficácia do escalonamento que você já usa.
- Insights de utilização de nós e binpacking: visibilidade granular dos nós para identificar capacidade ociosa, selecionar os tipos de nó certos e melhorar o agendamento de pods para reduzir o tamanho do ambiente.
- Visibilidade completa de custos: acompanhamento detalhado dos custos ao longo do tempo por cluster, namespace e workload, com agrupamento flexível para alocar gastos por equipe, subsistema ou ambiente.
- Insights preditivos de custos: preveja gastos futuros e compare custos com métricas de desempenho para alinhar as decisões de engenharia aos objetivos de FinOps.
- Aplicação de políticas de otimização: políticas dinâmicas que governam o custo e o nível de serviço desejados de cada workload em escala.
- Amplo suporte a nuvens e workloads: AWS, Azure, Google, OpenShift, Rancher e nuvem privada, incluindo workloads personalizadas como Spark, Flink e Rollouts.
Saiba como o PerfectScale reduz os custos do Kubernetes sem concessões →