


Was ist GKE Autopilot?
GKE Autopilot ist ein Betriebsmodus von Google Kubernetes Engine (GKE), bei dem Google einen Großteil der zugrunde liegenden Cluster-Infrastruktur verwaltet. Statt Nodes, Node-Pools und deren Kapazität zu konfigurieren und zu pflegen, definieren Sie Kubernetes-Workloads und deren Ressourcenanforderungen. GKE stellt die benötigten Compute-Ressourcen automatisch bereit und skaliert sie.
Autopilot übernimmt zudem Infrastrukturaufgaben wie Node-Upgrades, Sicherheitskonfiguration und Ressourcenoptimierung. Workloads nutzen weiterhin Standard-Kubernetes-Objekte und -APIs, Autopilot wendet jedoch zusätzliche Einschränkungen und Standardwerte an, um ein verwaltetes Betriebsmodell zu unterstützen. Das reduziert den Cluster-Verwaltungsaufwand, ohne auf die Deployment- und Orchestrierungsfunktionen von Kubernetes zu verzichten.
Google Kubernetes Engine (GKE) Autopilot berechnet eine pauschale Verwaltungsgebühr von 0,10 $ pro Cluster und Stunde (gedeckelt bzw. ausgeglichen durch ein monatliches Free-Tier-Guthaben von 74,40 $ für einen qualifizierten Cluster) plus ressourcenbasierte Pod-Preise.
Dieser Artikel ist Teil einer Serie über Kubernetes-Preise
In diesem Artikel:
- Welche Faktoren beeinflussen die Kosten von GKE Autopilot?
- Die Preisstruktur von Google Kubernetes Engine verstehen
- Autopilot-CUDs werden zu ausgabenbasierten Flex CUDs
- Best Practices für GKE Autopilot Pricing
Welche Faktoren beeinflussen die Kosten von GKE Autopilot?
Überdimensionierte CPU- und Memory-Requests
Bei Workloads, die auf Basis der Pod-Resource-Requests abgerechnet werden, erhöht die Anforderung von mehr CPU oder Memory, als eine Anwendung benötigt, die Kosten – selbst wenn diese Ressourcen ungenutzt bleiben. Ein Pod, der beispielsweise 4 vCPU anfordert, aber normalerweise nur 1 vCPU nutzt, wird unter Umständen auf Basis deutlich höherer Rechenleistung abgerechnet, als die Anwendung tatsächlich benötigt.
Deshalb sind präzise Resource-Requests sowohl für das Scheduling als auch für die Kostenkontrolle wichtig. Teams können historische Auslastungsmetriken, Lasttests und Empfehlungen des Vertical Pod Autoscaling nutzen, um überdimensionierte Requests zu identifizieren. Die Requests sollten dennoch genug Kapazität für normale Traffic-Spitzen und den Anwendungsstart lassen.
Mindest-Resource-Requests und automatische Anpassungen durch Autopilot
Autopilot setzt für unterstützte Workloads Mindestanforderungen an CPU, Memory und ephemeren Speicher durch. Fordert ein Pod Ressourcen unterhalb dieser Grenzwerte an, kann Autopilot die Requests automatisch erhöhen. Auch wenn das Verhältnis von CPU zu Memory außerhalb des von der gewählten Compute-Klasse unterstützten Bereichs liegt, kann Autopilot die Requests anpassen.
Diese Anpassungen sind relevant, weil die für Scheduling und Abrechnung herangezogenen Werte höher ausfallen können als die ursprünglich im Workload-Manifest angegebenen. Besonders Anwendungen, die aus vielen sehr kleinen Pods bestehen, lohnen eine Überprüfung, da Mindestanforderungen die erwarteten Kostenvorteile einer Aufteilung in winzige Container schmälern können.
Weiterführende Inhalte: Erfahren Sie mehr darüber, wie sich Kubernetes-Requests und -Limits auf Scheduling und Kosten auswirken
Anzahl laufender Pods
Die Anzahl laufender Pods beeinflusst die Kosten, denn jeder Workload benötigt eine gewisse Compute-Kapazität. Höhere Replica-Zahlen für Verfügbarkeit, Rolling Deployments oder horizontale Skalierung erhöhen den Gesamtbedarf an CPU und Memory. Dauerhaft laufende Pods verursachen auch in Phasen geringer Anwendungsaktivität Kosten.
Die Pod-Anzahl sollte zusammen mit den Resource-Requests betrachtet werden. Zehn kleine Replicas und zwei größere Replicas können eine ähnliche Gesamtkapazität bieten, verhalten sich beim Scheduling und Skalieren aber unterschiedlich. Auch Hintergrunddienste, Sidecars und Systemkomponenten können die mit jedem Workload verbundenen Ressourcen erhöhen.
Auswahl der Compute-Klasse
Autopilot bietet Compute-Klassen für unterschiedliche Workload-Anforderungen, etwa General-Purpose-Workloads, Hochleistungsanwendungen, Scale-out-Workloads und Workloads mit Beschleuniger-Bedarf. Die gewählte Klasse beeinflusst die verfügbare Hardware, Ressourcenlimits, das Scheduling-Verhalten und die geltenden Preise.
Eine spezialisierte Compute-Klasse kann sinnvoll sein, wenn eine Anwendung bestimmte Performance-Eigenschaften benötigt, kostet aber unter Umständen mehr als eine Allzweck-Option. Teams sollten Klassen anhand gemessener Workload-Anforderungen auswählen, statt standardmäßig leistungsstärkere Ressourcen zuzuweisen. Unterschiedliche Workloads innerhalb einer Umgebung können, wo sinnvoll, verschiedene Klassen nutzen.
Region
Die Preise von Google Cloud variieren je nach Region, sodass identische Workloads abhängig vom Ausführungsort unterschiedliche Infrastrukturkosten verursachen können. Regionale Unterschiede können Compute-Ressourcen ebenso betreffen wie Speicher und einige Netzwerkgebühren.
Der Preis sollte nicht der einzige Faktor bei der Regionswahl sein. Anwendungen müssen unter Umständen in der Nähe von Nutzern, Datenbanken oder anderen Diensten laufen, um Latenz und Netzwerk-Transfer zu reduzieren. Auch Anforderungen an die Datenresidenz und die Serviceverfügbarkeit können die praktikablen Regionen einschränken – die regionalen Kosten sind damit nur ein Teil einer umfassenderen Platzierungsentscheidung.
Speicherverbrauch
Speicherkosten fallen getrennt von den für den Betrieb der Pods genutzten CPU- und Memory-Ressourcen an. Anwendungen können Kosten für Persistent Volumes, Snapshots, Backups und andere Speicherressourcen verursachen. Die Höhe der Abrechnung hängt von Faktoren wie Speichertyp, bereitgestellter Kapazität, Region und den am Speicherdienst ausgeführten Operationen ab.
Persistente Ressourcen haben zudem einen anderen Lebenszyklus als Pods. Das Löschen oder Herunterskalieren eines Workloads löscht nicht zwangsläufig dessen Persistent Disks, Snapshots oder Backups. Ungenutzte Volumes können daher weiter Kosten verursachen, nachdem der Compute-Workload längst verschwunden ist – das Lifecycle-Management von Speicher ist deshalb ein wichtiger Teil der Kostenkontrolle.
Netzwerk-Traffic
Netzwerkkosten hängen von der übertragenen Datenmenge ab und davon, wohin die Daten fließen. Traffic zwischen Diensten in verschiedenen Regionen, Daten ins öffentliche Internet und Traffic über Dienste wie Cloud Load Balancing können zusätzliche Kosten über den reinen Betrieb der Pods hinaus verursachen.
Die Netzwerkarchitektur kann sich daher stark auf datenintensive Anwendungen auswirken. Häufig miteinander kommunizierende Dienste an geeigneten Standorten zu platzieren, senkt sowohl Latenz als auch Transferkosten. Teams sollten das Anwendungsverhalten zudem auf unnötige regionsübergreifende Aufrufe, große ausgehende Antworten und wiederholte Übertragungen derselben Daten hin überwachen.
GPUs und Spezialhardware
GPUs und andere spezialisierte Beschleuniger können einzelne Workloads deutlich teurer machen als Standard-CPU-Workloads. Die Kosten hängen vom Beschleunigertyp, der Anzahl der Geräte, der Region, der Compute-Konfiguration und der Nutzungsdauer ab.
Die Auslastung ist bei Beschleuniger-Workloads besonders wichtig. Eine GPU, die einem Workload zugewiesen ist, der die meiste Zeit auf Daten wartet oder CPU-lastige Arbeit verrichtet, ist kostenineffizient. Batch-Scheduling, Autoscaling, die passende Beschleunigerwahl und Application Profiling helfen sicherzustellen, dass teure Hardware nur dann genutzt wird, wenn sie einen messbaren Nutzen bringt.
Weiterführende Inhalte: Lesen Sie unseren Artikel über GPU-Workloads in Kubernetes
Die Preisstruktur von Google Kubernetes Engine verstehen
GKE Free Tier und Gutschriften
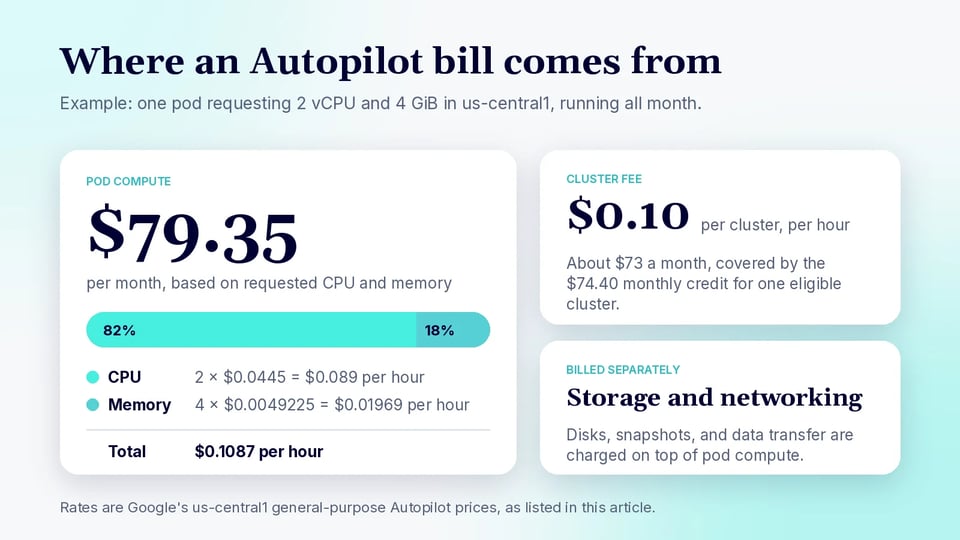
Google Cloud gewährt 74,40 $ an monatlichen GKE-Gutschriften pro Abrechnungskonto. Die Gutschrift wird auf die Cluster-Verwaltungsgebühr für berechtigte zonale Standard- und Autopilot-Cluster angerechnet. Da die Standard-Verwaltungsgebühr 0,10 $ pro Cluster und Stunde beträgt, reichen 74,40 $ in etwa aus, um einen berechtigten, durchgehend laufenden Cluster in einem typischen Monat abzudecken.
Ein Beispiel: Ein Cluster, der 730 Stunden läuft, würde normalerweise etwa 73 $ an Verwaltungsgebühren verursachen:
730 Stunden × $0.10 = $73
Die monatliche Gutschrift könnte in diesem Beispiel also die gesamte Verwaltungsgebühr ausgleichen. Sie deckt jedoch nicht die von Workloads verbrauchten CPU-, Memory-, Speicher- oder Netzwerkressourcen ab.
Cluster-Verwaltungsgebühren
GKE berechnet eine Verwaltungsgebühr von 0,10 $ pro Cluster und Stunde – unabhängig davon, ob der Cluster im Standard- oder Autopilot-Modus läuft.
Ein durchgehend laufender Cluster kostet über 730 Stunden beispielsweise ungefähr:
730 × $0.10 = $73 pro Monat
Fünf durchgehend laufende Cluster würden vor anrechenbaren Gutschriften etwa 365 $ pro Monat an Verwaltungsgebühren verursachen:
5 × $73 = $365
Für berechtigte Autopilot- und zonale Standard-Cluster kann die monatliche Free-Tier-Gutschrift von 74,40 $ diese Kosten teilweise oder vollständig ausgleichen.
Compute-Kosten
Für General-Purpose-Autopilot-Workloads in Iowa (us-central1) listet Google derzeit On-Demand-Preise von etwa 0,0445 $ pro vCPU und Stunde und 0,0049225 $ pro GiB Memory und Stunde. Ephemerer Speicher wird separat mit etwa 0,0001389 $ pro GiB und Stunde berechnet.
Betrachten wir beispielsweise einen durchgehend laufenden Pod, der 2 vCPU und 4 GiB Memory anfordert:
- CPU:
2 × $0.0445 = $0.089/Stunde - Memory:
4 × $0.0049225 = $0.01969/Stunde - Gesamt: etwa 0,1087 $/Stunde
Über 730 Stunden würde dieser Pod rund 79,35 $ pro Monat kosten – ohne ephemeren Speicher, persistenten Speicher, Netzwerk und andere Dienste.
Ressourcen der Balanced-Compute-Klasse kosten mehr. In us-central1 listet Google für Balanced-Autopilot-Pods etwa 0,0645 $ pro vCPU und Stunde und 0,0071354 $ pro GiB Memory und Stunde.
Pod-basierte vs. Node-basierte Abrechnung
General-Purpose-Autopilot-Workloads nutzen die Pod-basierte Abrechnung. Das bedeutet, dass sich die Abrechnung primär an den vom Pod angeforderten CPU-, Memory- und ephemeren Speicherressourcen orientiert – nicht an der Gesamtkapazität des zugrunde liegenden Nodes.
Ein General-Purpose-Pod in us-central1, der 1 vCPU und 2 GiB Memory anfordert, würde beispielsweise etwa so viel kosten:
$0.0445 + (2 × $0.0049225) = $0.054345/Stunde
Das sind rund 39,67 $ pro Monat bei durchgehendem Betrieb über 730 Stunden.
Autopilot-Workloads, die spezifische Hardware wählen – etwa bestimmte Maschinenserien oder GPUs –, nutzen stattdessen die Node-basierte Abrechnung. In diesem Modell zahlen Sie für den gesamten zugrunde liegenden Compute-Engine-Node plus einen Autopilot-Verwaltungsaufschlag. Google listet in us-central1 beispielsweise einen Autopilot-Performance-Aufschlag von etwa 0,004 $ pro vCPU und Stunde und 0,0005 $ pro GiB Memory und Stunde – zusätzlich zu den zugrunde liegenden Compute-Engine-Kosten.
Speicher- und Netzwerkkosten
Persistenter Speicher und Netzwerk-Traffic werden getrennt von den Autopilot-CPU- und -Memory-Kosten abgerechnet. Die Höhe hängt von Speicherklasse, Kapazität, Quelle und Ziel des Traffics sowie der Region ab.
Die Google-Cloud-Preise für Persistent Disk in us-central1 umfassen beispielsweise bereitgestellten SSD-Speicher für etwa 0,000232877 $ pro GiB und Stunde. Eine durchgehend bereitgestellte 100-GiB-SSD würde damit grob kosten:
100 × $0.000232877 × 730 ≈ $17 pro Monat
Speicher bleibt auch dann kostenpflichtig, wenn der nutzende Pod gestoppt ist, solange die Persistent Disk selbst bereitgestellt bleibt.
Auch das Netzwerk kann ins Gewicht fallen. Der Datentransfer zwischen zwei nordamerikanischen Google-Cloud-Regionen kostet derzeit beispielsweise 0,02 $ pro GiB. Die Übertragung von 1 TiB zwischen Regionen würde damit etwa so viel kosten:
1,024 GiB × $0.02 = $20.48
Die Preise für Internet-Datentransfer variieren je nach Ziel und Nutzungsstufe. Ausgehender Premium-Tier-Traffic von einer US-Region nach Nordamerika ist beispielsweise mit 0,12 $ pro GiB für das erste TiB nach dem Freikontingent gelistet.
Autopilot-CUDs werden zu ausgabenbasierten Flex CUDs
Google hat geändert, wie Committed Use Discounts (Rabatte für zugesicherte Nutzung) auf GKE Autopilot angewendet werden. Autopilot-spezifische ausgabenbasierte CUDs sind für Neukäufe nicht mehr verfügbar. Bestehende Autopilot-Commitments werden bis zu ihrem Ablauf weiter unterstützt, neue Commitments für berechtigte GKE-Nutzung werden jedoch als Compute Flexible CUDs (Flex CUDs) erworben.
Compute Flexible CUDs sind ausgabenbasierte Commitments und keine Zusagen für eine feste Anzahl an Kubernetes-Ressourcen. Eine Organisation verpflichtet sich für eine Laufzeit von einem oder drei Jahren zu einem stündlichen Mindestbetrag, und der daraus resultierende Rabatt kann auf berechtigte GKE-, Compute-Engine- und Cloud-Run-Nutzung desselben Cloud-Billing-Kontos angewendet werden. Das gibt Organisationen mehr Flexibilität, wenn Workloads zwischen Diensten, Regionen oder unterstützten Compute-Konfigurationen wechseln.
Google hat zudem alle Cloud-Billing-Konten auf sein neueres ausgabenbasiertes CUD-Verbrauchsmodell umgestellt. In diesem Modell wird berechtigte Nutzung direkt zum geltenden rabattierten Preis abgerechnet, statt zunächst zum Listenpreis berechnet und anschließend über CUD-Gutschriften ausgeglichen zu werden. Im Februar 2026 gab Google bekannt, dass alle Cloud-Billing-Konten automatisch migriert wurden und die erweiterte Compute-Flexible-CUD-Abdeckung allen Kunden zur Verfügung steht.
Für Nutzer von GKE Autopilot besteht der praktische Unterschied darin, dass die Einsparungen nun weniger eng an Autopilot selbst gebunden sind. Ein Compute-Flexible-Commitment kann berechtigte Ausgaben über einen größeren Pool von Google-Cloud-Compute-Diensten abdecken, wodurch sich die CUD-Auslastung bei veränderten Infrastrukturanforderungen leichter aufrechterhalten lässt. Organisationen zahlen jedoch über die gesamte Laufzeit für den zugesagten Betrag – Flex CUDs sollten daher in der Regel am vorhersehbaren Grundbedarf und nicht an temporären Spitzen ausgerichtet werden.
Best Practices für GKE Autopilot Pricing
Hier einige bewährte Vorgehensweisen, um die Kosten bei der Nutzung von GKE Autopilot im Griff zu behalten.
1. Resource-Requests auf Basis echter Nutzungsdaten festlegen
Legen Sie CPU- und Memory-Requests anhand beobachteter Auslastung fest, nicht allein auf Basis von Schätzungen. Erfassen Sie Metriken über normalen Traffic, Spitzenzeiten, Deployments und Hintergrundjobs hinweg, um zu ermitteln, wie viel Kapazität jeder Workload tatsächlich benötigt.
Reduzieren Sie Requests nicht auf die Durchschnittsauslastung, ohne Spitzen zu berücksichtigen. Requests sollten genug Spielraum bieten, um Throttling, Out-of-Memory-Abbrüche oder unnötige Skalierung zu vermeiden. Empfehlungen des Vertical Pod Autoscaling liefern nützliche Daten, um diese Werte im Laufe der Zeit zu verfeinern.
Wichtige Maßnahmen:
- Messen Sie die CPU- und Memory-Nutzung in normalen Phasen und zu Spitzenzeiten.
- Nutzen Sie VPA-Empfehlungen, um Requests im Laufe der Zeit zu verfeinern.
- Lassen Sie genug Spielraum, um Throttling oder Memory-Fehler zu vermeiden.
2. Ressourcenanpassungen durch Autopilot überprüfen
Prüfen Sie nach dem Deployment die den Pods tatsächlich zugewiesenen Ressourcen, statt davon auszugehen, dass die Werte aus dem ursprünglichen Manifest unverändert gelten. Autopilot kann Resource-Requests ändern, um Mindestwerte und andere Anforderungen zu erfüllen, die mit der Workload-Konfiguration und den Compute-Klassen zusammenhängen.
Häufige Anpassungen können darauf hindeuten, dass die Ressourcenangaben nicht gut zu den Autopilot-Anforderungen passen. Wenn Sie die Manifeste an die effektive Ressourcenkonfiguration anpassen, werden die Kosten vorhersehbarer – und Teams kalkulieren nicht mit Werten, die gar nicht angewendet werden.
Wichtige Maßnahmen:
- Vergleichen Sie die angeforderten Ressourcen mit den Werten, die Autopilot tatsächlich anwendet.
- Identifizieren Sie Pods, die wiederholt auf Mindestwerte oder unterstützte Verhältnisse angepasst werden.
- Aktualisieren Sie Manifeste, sodass die konfigurierten Requests den erwarteten abgerechneten Ressourcen entsprechen.
3. Kosten gemeinsam mit der Anwendungsperformance überwachen
Niedrigere Resource-Requests führen nicht automatisch zu niedrigeren Gesamtkosten. Ein unterdimensionierter Workload kann unter höherer Latenz, CPU-Throttling, Memory-Druck oder aggressiver horizontaler Skalierung leiden – was die erwarteten Einsparungen zunichtemachen kann.
Vergleichen Sie Kostenmetriken mit Anwendungsmetriken wie Latenz, Durchsatz, Fehlerrate, Replica-Anzahl und Ressourcenauslastung. So finden Sie leichter Konfigurationen, die Ausgaben senken, ohne Service-Level-Ziele oder die Zuverlässigkeit der Anwendung zu beeinträchtigen.
Wichtige Maßnahmen:
- Verfolgen Sie Kosten zusammen mit Latenz, Durchsatz, Fehlern und Replica-Zahlen.
- Achten Sie auf Einsparungen, die Throttling oder übermäßiges Autoscaling auslösen.
- Optimieren Sie sowohl auf Kosteneffizienz als auch auf Service-Level-Ziele.
4. Vorhersehbare und Burst-Workloads trennen
Workloads mit stabilen Ressourcenanforderungen sollten anders konfiguriert werden als Anwendungen mit großen oder unvorhersehbaren Traffic-Schwankungen. Vorhersehbare Dienste kommen oft mit sorgfältig abgestimmten Requests und Replica-Zahlen aus, während Burst-Workloads stärker von Autoscaling profitieren.
Die Trennung dieser Workload-Typen macht auch das Kapazitäts- und Kostenverhalten verständlicher. Batch-Verarbeitung, geplante Jobs und anfragegetriebene Dienste können etwa unterschiedliche Skalierungsrichtlinien nutzen, statt eine Konfiguration zu teilen, die auf den größtmöglichen Bedarf ausgelegt ist.
Wichtige Maßnahmen:
- Nutzen Sie stabile Requests und Replica-Zahlen für vorhersehbare Workloads.
- Wenden Sie Autoscaling-Richtlinien auf variable oder Burst-getriebene Dienste an.
- Konfigurieren Sie Batch-, geplante und anfragegetriebene Workloads getrennt.
5. Spot-Kapazität nutzen, wo Unterbrechungen akzeptabel sind
Spot Pods können die Compute-Kosten für Workloads senken, die Unterbrechungen tolerieren. Sie eignen sich für Aufgaben wie Batch-Verarbeitung, parallele Jobs, Entwicklungs-Workloads und verteilte Verarbeitung, bei denen abgebrochene Arbeit wiederholt oder verlagert werden kann.
Verlassen Sie sich bei Workloads, die eine plötzliche Beendigung nicht tolerieren, nur dann auf Spot-Kapazität, wenn die Anwendung mit ausreichender Redundanz ausgelegt ist. Nutzen Sie Retry-Logik, Checkpoints, Graceful-Shutdown-Handling und geeignete Disruption-Strategien, damit entzogene Kapazität nicht zu verlorener Arbeit oder inakzeptablen Serviceunterbrechungen führt.
Wichtige Maßnahmen:
- Nutzen Sie Spot Pods für wiederholbare und fehlertolerante Workloads.
- Ergänzen Sie Checkpoints, Retries und Graceful-Shutdown-Handling.
- Vermeiden Sie Spot-Kapazität für Workloads, die eine plötzliche Beendigung nicht tolerieren.
FAQ
Wie viel kostet GKE Autopilot? GKE Autopilot berechnet eine Verwaltungsgebühr von 0,10 $ pro Cluster und Stunde – rund 73 $ pro Monat – plus Pod-basierte Preise für die von Ihren Pods angeforderten CPU-, Memory- und ephemeren Speicherressourcen. In us-central1 sind General-Purpose-Pods mit etwa 0,0445 $ pro vCPU und Stunde und 0,0049225 $ pro GiB Memory und Stunde gelistet.
Gibt es ein Free Tier für GKE Autopilot? Google Cloud gewährt jedem Abrechnungskonto 74,40 $ an monatlichen GKE-Gutschriften. Die Gutschrift gilt für die Cluster-Verwaltungsgebühr berechtigter zonaler Standard- und Autopilot-Cluster und reicht für etwa einen Cluster. CPU, Memory, Speicher und Netzwerk sind nicht abgedeckt.
Rechnet GKE Autopilot nach Resource-Requests oder nach tatsächlicher Nutzung ab? General-Purpose-Autopilot-Workloads nutzen die Pod-basierte Abrechnung, bei der die vom Pod angeforderten CPU-, Memory- und ephemeren Speicherressourcen berechnet werden. Überdimensionierte Requests kosten auch dann mehr, wenn die Ressourcen ungenutzt bleiben, und Autopilot kann Requests anheben, die unter seinen Mindestwerten liegen.
Was ist der Unterschied zwischen Pod-basierter und Node-basierter Abrechnung in Autopilot? Bei der Pod-basierten Abrechnung zahlen Sie für die Ressourcen, die Ihre Pods anfordern. Workloads, die spezifische Hardware wählen – etwa bestimmte Maschinenserien oder GPUs –, nutzen stattdessen die Node-basierte Abrechnung. Sie zahlen dann für den gesamten zugrunde liegenden Compute-Engine-Node plus einen Autopilot-Verwaltungsaufschlag.
Was ist aus den Autopilot Committed Use Discounts geworden? Autopilot-spezifische ausgabenbasierte CUDs sind für Neukäufe nicht mehr verfügbar; bestehende laufen bis zu ihrem Ablauf weiter. Neue Commitments werden als Compute Flexible CUDs erworben, die auf berechtigte GKE-, Compute-Engine- und Cloud-Run-Ausgaben desselben Cloud-Billing-Kontos angewendet werden können.
GKE-Autopilot-Kosten mit PerfectScale im Griff
Da Autopilot auf Basis der Pod-Resource-Requests abrechnet, bestimmt deren Genauigkeit direkt die Rechnung – und sie in einer sich ständig wandelnden Umgebung aktuell zu halten, ist keine einmalige Aufgabe. PerfectScale senkt die Kubernetes-Ausgaben, indem es kontinuierlich analysiert, wie sich Workloads tatsächlich verhalten, und sie automatisch per Right-Sizing anpasst. So bleiben Cluster kosteneffizient, ohne Resilienz, Verfügbarkeit oder Anwendungsperformance zu opfern.
Zentrale Funktionen von PerfectScale:
- Autonomes Workload-Right-Sizing: Kontinuierliche Echtzeit-Optimierung, die sich an Nutzungsmuster, Node- und Autoscaling-Konfigurationen sowie Code-Änderungen anpasst und Verschwendung eliminiert, ohne die Performance zu beeinträchtigen.
- Release-Awareness: Workload-Konfigurationen werden mit jedem neuen Code-Release dynamisch neu optimiert, sodass Empfehlungen nie im Widerspruch zu Entwicklungsänderungen stehen.
- Autoscaler-Integration: Funktioniert mit HPA, KEDA, Karpenter, Cluster Autoscaler, EKS Auto Mode, Fargate, Node Auto Provisioning und Google Autopilot und steigert die Wirksamkeit Ihrer bestehenden Skalierung.
- Node-Auslastung und Binpacking-Insights: Granulare Node-Transparenz, um ungenutzte Kapazität zu identifizieren, die richtigen Node-Typen zu wählen und das Pod-Scheduling zu verbessern, um die Umgebungsgröße zu reduzieren.
- Vollständige Kostentransparenz: Detaillierte Kostenverfolgung über die Zeit nach Cluster, Namespace und Workload – mit flexibler Gruppierung, um Ausgaben Teams, Subsystemen oder Umgebungen zuzuordnen.
- Prädiktive Kosten-Insights: Prognostizieren Sie künftige Ausgaben und stellen Sie Kosten Performance-Metriken gegenüber, um Engineering-Entscheidungen mit FinOps-Zielen in Einklang zu bringen.
- Durchsetzung von Optimierungsrichtlinien: Dynamische Richtlinien, die Kosten- und Service-Level-Ziele jedes Workloads in großem Maßstab steuern.
- Breite Cloud- und Workload-Unterstützung: AWS, Azure, Google, OpenShift, Rancher und Private Cloud, einschließlich Custom Workloads wie Spark, Flink und Rollouts.
Erfahren Sie, wie PerfectScale Kubernetes-Kosten ohne Kompromisse senkt →