


Che cos'è GKE Autopilot?
GKE Autopilot è una modalità di Google Kubernetes Engine (GKE) in cui Google gestisce gran parte dell'infrastruttura sottostante del cluster. Invece di configurare e mantenere nodi, pool di nodi e la loro capacità, si definiscono i workloads Kubernetes e i relativi requisiti di risorse. GKE effettua automaticamente il provisioning e la scalabilità delle risorse di calcolo necessarie.
Autopilot gestisce inoltre attività infrastrutturali come gli upgrade dei nodi, la configurazione della sicurezza e l'ottimizzazione delle risorse. I workloads continuano a utilizzare oggetti e API Kubernetes standard, ma Autopilot applica vincoli e impostazioni predefinite aggiuntivi a supporto di un modello operativo gestito. Questo riduce l'amministrazione del cluster, mantenendo al tempo stesso le capacità di deployment e orchestrazione di Kubernetes.
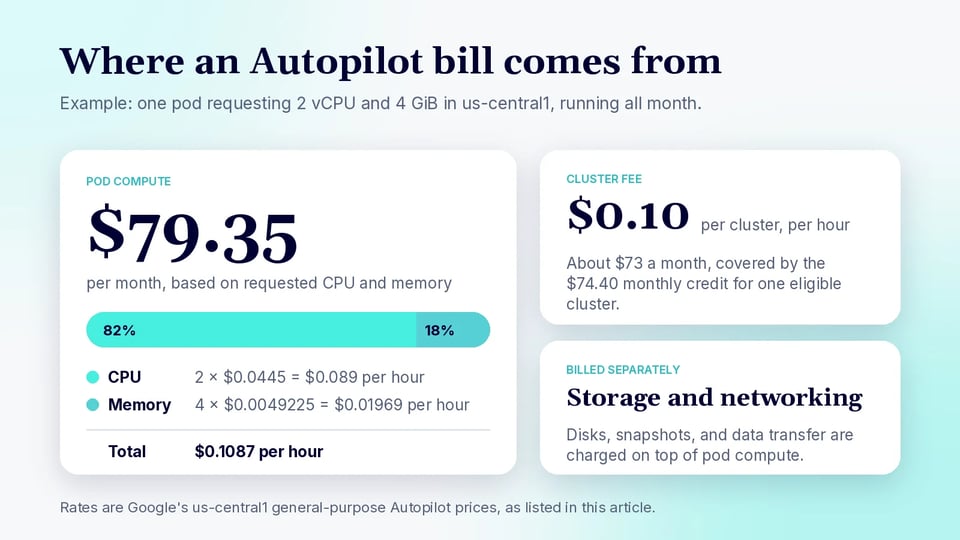
Google Kubernetes Engine (GKE) Autopilot applica una tariffa di gestione fissa di $0.10 per cluster all'ora (coperta o compensata da un credito mensile del livello gratuito di $74.40 per un cluster idoneo), oltre a un prezzo dei pod basato sulle risorse.
Questo articolo fa parte di una serie di approfondimenti sui prezzi di Kubernetes
In questo articolo:
- Quali fattori influenzano i costi di GKE Autopilot?
- Capire i prezzi di Google Kubernetes Engine
- I CUD di Autopilot passano ai Flex CUD basati sulla spesa
- Best practice sui prezzi di GKE Autopilot
Quali fattori influenzano i costi di GKE Autopilot?
Richieste di CPU e memoria sovradimensionate
Per i workloads fatturati in base alle richieste di risorse dei pod, richiedere più CPU o memoria di quanto l'applicazione necessiti aumenta i costi anche quando tali risorse rimangono inutilizzate. Ad esempio, un pod che richiede 4 vCPU ma ne utilizza normalmente 1 può essere fatturato sulla base di una capacità di calcolo nettamente superiore a quella effettivamente necessaria all'applicazione.
Per questo motivo, richieste di risorse accurate sono importanti sia per lo scheduling sia per il controllo dei costi. I team possono utilizzare metriche di utilizzo storiche, test di carico e le raccomandazioni del vertical pod autoscaling per individuare richieste sovradimensionate. Le richieste devono comunque lasciare capacità sufficiente per i normali picchi di traffico e per l'avvio dell'applicazione.
Richieste minime di risorse e aggiustamenti di Autopilot
Autopilot impone requisiti minimi di CPU, memoria e archiviazione effimera per i workloads supportati. Quando un pod richiede risorse inferiori a questi limiti, Autopilot può aumentare automaticamente le richieste. Può inoltre modificarle quando il rapporto tra CPU e memoria esce dall'intervallo supportato dalla classe di calcolo selezionata.
Questi aggiustamenti sono rilevanti perché i valori utilizzati per lo scheduling e la fatturazione possono risultare superiori a quelli specificati originariamente nel manifest del workload. Vale la pena esaminare in particolare le applicazioni composte da molti pod molto piccoli, poiché i requisiti minimi di risorse possono ridurre i benefici di costo attesi dalla suddivisione del lavoro in container di dimensioni ridotte.
Contenuti correlati: Scopra di più su come requests e limits di Kubernetes influiscono su scheduling e costi
Numero di pod in esecuzione
Il numero di pod in esecuzione incide sui costi perché ogni workload richiede una certa quantità di capacità di calcolo. Aumentare il numero di repliche per disponibilità, rolling deployment o scalabilità orizzontale incrementa i requisiti aggregati di CPU e memoria. I pod che restano in esecuzione in modo continuativo generano costi anche nei periodi di scarsa attività dell'applicazione.
Il numero di pod va considerato insieme alle richieste di risorse. Dieci repliche piccole e due repliche più grandi possono offrire una capacità totale simile, ma presentano caratteristiche di scheduling e scaling diverse. Anche servizi in background, sidecar e componenti di sistema possono aumentare le risorse associate a ciascun workload.
Scelta della classe di calcolo
Autopilot offre classi di calcolo progettate per requisiti diversi dei workloads, come workloads general-purpose, applicazioni ad alte prestazioni, workloads scale-out e workloads che richiedono acceleratori. La classe selezionata influenza l'hardware disponibile, i limiti di risorse, il comportamento di scheduling e i prezzi applicabili.
Una classe di calcolo specializzata può essere utile quando un'applicazione necessita di caratteristiche prestazionali specifiche, ma può costare di più rispetto a un'opzione general-purpose. I team dovrebbero selezionare le classi in base ai requisiti misurati dei workloads, invece di assegnare per impostazione predefinita risorse a prestazioni più elevate. Workloads diversi all'interno di uno stesso ambiente possono usare classi diverse, laddove opportuno.
Regione
I prezzi di Google Cloud variano in base alla regione, quindi workloads identici possono avere costi infrastrutturali diversi a seconda di dove vengono eseguiti. Le differenze regionali possono riguardare le risorse di calcolo, così come lo storage e alcuni costi di rete.
Il prezzo non dovrebbe essere l'unico fattore nella scelta della regione. Le applicazioni potrebbero dover essere eseguite vicino a utenti, database o altri servizi per ridurre latenza e trasferimento di rete. Anche i requisiti di residenza dei dati e la disponibilità dei servizi possono limitare le regioni effettivamente praticabili, rendendo il costo regionale solo uno degli elementi di una decisione di posizionamento più ampia.
Consumo di storage
I costi di storage sono separati da quelli di CPU e memoria utilizzate per eseguire i pod. Le applicazioni possono generare addebiti per volumi persistenti, snapshot, backup e altre risorse di archiviazione. L'importo fatturato dipende da fattori come il tipo di storage, la capacità sottoposta a provisioning, la regione e le operazioni eseguite sul servizio di archiviazione.
Le risorse persistenti hanno inoltre un ciclo di vita diverso da quello dei pod. Eliminare o ridimensionare un workload non elimina necessariamente i relativi dischi persistenti, snapshot o backup. I volumi inutilizzati possono quindi continuare a generare costi anche dopo la scomparsa del workload di calcolo, rendendo la gestione del ciclo di vita dello storage una parte importante del controllo dei costi.
Traffico di rete
I costi di rete dipendono dalla quantità di dati trasferiti e dalla loro destinazione. Il traffico tra servizi in regioni diverse, i dati inviati verso la rete internet pubblica e il traffico elaborato da servizi come Cloud Load Balancing possono aggiungere costi oltre a quelli di esecuzione dei pod.
L'architettura di rete può quindi avere un impatto notevole sulle applicazioni ad alta intensità di dati. Mantenere nelle posizioni appropriate i servizi che comunicano frequentemente può ridurre sia la latenza sia i costi di trasferimento. I team dovrebbero inoltre monitorare il comportamento delle applicazioni per individuare chiamate cross-region non necessarie, risposte in uscita di grandi dimensioni e trasferimenti ripetuti degli stessi dati.
GPU e hardware specializzato
Le GPU e altri acceleratori specializzati possono rendere singoli workloads notevolmente più costosi rispetto ai workloads standard basati su CPU. I costi dipendono dal tipo di acceleratore, dal numero di dispositivi, dalla regione, dalla configurazione di calcolo e dal tempo per cui le risorse sono necessarie.
L'utilizzo è particolarmente importante per i workloads con acceleratori. Una GPU assegnata a un workload che trascorre gran parte del tempo in attesa di dati o nell'esecuzione di operazioni vincolate alla CPU offre una scarsa efficienza in termini di costi. Scheduling batch, autoscaling, una selezione adeguata degli acceleratori e il profiling delle applicazioni possono contribuire a garantire che l'hardware costoso venga utilizzato solo quando offre un beneficio misurabile.
Contenuti correlati: Legga il nostro articolo sull'esecuzione di workloads GPU in Kubernetes
Capire i prezzi di Google Kubernetes Engine
Livello gratuito di GKE e crediti
Google Cloud offre $74.40 di crediti GKE mensili per account di fatturazione. Il credito si applica alla tariffa di gestione del cluster per i cluster zonali Standard e Autopilot idonei. Poiché la tariffa standard di gestione del cluster è di $0.10 per cluster all'ora, $74.40 sono all'incirca sufficienti a coprire un cluster idoneo in esecuzione continuativa per un mese tipico.
Ad esempio, un cluster in esecuzione per 730 ore genererebbe normalmente circa $73 di tariffe di gestione:
730 hours × $0.10 = $73
In questo esempio, il credito mensile potrebbe quindi compensare interamente la tariffa di gestione. Non copre invece CPU, memoria, storage o networking consumati dai workloads.
Tariffe di gestione del cluster
GKE applica una tariffa di gestione di $0.10 per cluster all'ora, indipendentemente dal fatto che il cluster utilizzi la modalità Standard o Autopilot.
Ad esempio, un cluster in esecuzione continuativa per 730 ore costerebbe circa:
730 × $0.10 = $73 per month
Cinque cluster in esecuzione continuativa genererebbero circa $365 al mese di tariffe di gestione, al lordo dei crediti applicabili:
5 × $73 = $365
Per i cluster Autopilot e Standard zonali idonei, il credito mensile del livello gratuito di $74.40 può compensare in tutto o in parte questi addebiti.
Costi di calcolo
Per i workloads Autopilot general-purpose in Iowa (us-central1), Google indica attualmente prezzi on-demand di circa $0.0445 per vCPU all'ora e $0.0049225 per GiB di memoria all'ora. L'archiviazione effimera ha un prezzo separato di circa $0.0001389 per GiB all'ora.
Ad esempio, si consideri un pod in esecuzione continuativa che richiede 2 vCPU e 4 GiB di memoria:
- CPU:
2 × $0.0445 = $0.089/hour - Memoria:
4 × $0.0049225 = $0.01969/hour - Totale: circa $0.1087/ora
Su 730 ore, quel pod costerebbe all'incirca $79.35 al mese, esclusi archiviazione effimera, storage persistente, networking e altri servizi.
Le risorse della classe di calcolo Balanced costano di più. In us-central1, Google indica circa $0.0645 per vCPU all'ora e $0.0071354 per GiB di memoria all'ora per i pod Autopilot Balanced.
Fatturazione basata sui pod vs. basata sui nodi
I workloads Autopilot general-purpose utilizzano la fatturazione basata sui pod. Ciò significa che la fatturazione si basa principalmente su CPU, memoria e archiviazione effimera richieste dal pod, e non sulla capacità totale del nodo sottostante.
Ad esempio, in us-central1, un pod general-purpose che richiede 1 vCPU e 2 GiB di memoria costerebbe circa:
$0.0445 + (2 × $0.0049225) = $0.054345/hour
Si tratta di circa $39.67 al mese se eseguito in modo continuativo per 730 ore.
I workloads Autopilot che selezionano hardware specifico, come determinate serie di macchine o GPU, utilizzano invece la fatturazione basata sui nodi. In questo modello si paga l'intero nodo Compute Engine sottostante più un sovrapprezzo di gestione Autopilot. Ad esempio, Google indica un sovrapprezzo Autopilot Performance di circa $0.004 per vCPU all'ora e $0.0005 per GiB di memoria all'ora in us-central1, in aggiunta ai costi Compute Engine sottostanti.
Costi di storage e networking
Lo storage persistente e il traffico di rete vengono fatturati separatamente rispetto agli addebiti per CPU e memoria di Autopilot. L'importo dipende dalla classe di storage, dalla capacità, dall'origine e dalla destinazione del traffico e dalla regione.
Ad esempio, i prezzi di Google Cloud Persistent Disk in us-central1 includono storage SSD sottoposto a provisioning a circa $0.000232877 per GiB all'ora. Un disco SSD da 100 GiB sottoposto a provisioning in modo continuativo costerebbe quindi all'incirca:
100 × $0.000232877 × 730 ≈ $17 per month
Lo storage resta fatturabile anche quando il pod che lo utilizza è fermo, se il disco persistente rimane sottoposto a provisioning.
Anche il networking può diventare significativo. Ad esempio, il trasferimento di dati tra due regioni Google Cloud nordamericane costa attualmente $0.02 per GiB. Trasferire 1 TiB tra regioni costerebbe quindi circa:
1,024 GiB × $0.02 = $20.48
Le tariffe di trasferimento dati verso internet variano in base alla destinazione e al livello di utilizzo. Ad esempio, il traffico Premium Tier in uscita da una regione statunitense verso il Nord America è indicato a $0.12 per GiB per il primo 1 TiB oltre la quota gratuita.
I CUD di Autopilot passano ai Flex CUD basati sulla spesa
Google ha cambiato il modo in cui gli sconti per impegno di utilizzo (CUD) si applicano a GKE Autopilot. I CUD basati sulla spesa specifici per Autopilot non sono più disponibili per nuovi acquisti. I commitments Autopilot esistenti continuano a essere supportati fino alla scadenza, ma i nuovi commitments per l'utilizzo GKE idoneo vengono acquistati come Compute Flexible CUD (Flex CUD).
I Compute Flexible CUD sono commitments basati sulla spesa, anziché impegni su un numero fisso di risorse Kubernetes. Un'organizzazione si impegna a una spesa oraria minima in dollari per un periodo di uno o tre anni e lo sconto risultante può applicarsi all'utilizzo idoneo di GKE, Compute Engine e Cloud Run associato allo stesso account di fatturazione Cloud. Questo offre alle organizzazioni maggiore flessibilità quando i workloads si spostano tra servizi, regioni o configurazioni di calcolo supportate.
Google ha inoltre migrato tutti gli account di fatturazione Cloud al suo nuovo modello di consumo dei CUD basato sulla spesa. In questo modello, l'utilizzo idoneo viene addebitato direttamente al prezzo scontato applicabile, invece di essere prima fatturato a prezzo di listino e poi compensato tramite crediti CUD. A febbraio 2026 Google ha annunciato che tutti gli account di fatturazione Cloud erano stati migrati automaticamente e che la copertura estesa dei Compute Flexible CUD era disponibile per tutti i clienti.
Per gli utenti di GKE Autopilot, la differenza pratica è che i risparmi sono ora meno strettamente legati ad Autopilot in sé. Un commitment Compute Flexible può coprire la spesa idonea su un insieme più ampio di servizi di calcolo Google Cloud, rendendo più facile mantenere l'utilizzo dei CUD quando i requisiti infrastrutturali cambiano. Tuttavia, le organizzazioni continuano a pagare l'importo impegnato per tutta la durata del commitment, quindi è in genere preferibile dimensionare i Flex CUD sulla spesa di base prevedibile piuttosto che sui picchi temporanei.
Best practice sui prezzi di GKE Autopilot
Di seguito alcune pratiche utili per gestire i costi quando si utilizza GKE Autopilot.
1. Basare le richieste di risorse su dati di utilizzo reali
Impostare le richieste di CPU e memoria in base all'utilizzo osservato, e non solo su stime. Raccogliere metriche in condizioni di traffico normale, periodi di picco, deployment e job in background per determinare quanta capacità richiede effettivamente ciascun workload.
Evitare di ridurre le richieste all'utilizzo medio senza tenere conto dei picchi. Le richieste devono garantire un margine sufficiente per prevenire throttling, terminazioni per esaurimento della memoria o scalabilità non necessaria. Le raccomandazioni del vertical pod autoscaling possono fornire dati utili per affinare questi valori nel tempo.
Azioni chiave:
- Misurare l'utilizzo di CPU e memoria nei periodi normali e di picco.
- Utilizzare le raccomandazioni del VPA per affinare le richieste nel tempo.
- Mantenere un margine sufficiente per evitare throttling o errori di memoria.
2. Verificare gli aggiustamenti delle risorse di Autopilot
Controllare le risorse assegnate ai pod dopo il deployment, invece di presumere che i valori del manifest originale siano rimasti invariati. Autopilot può modificare le richieste di risorse per soddisfare i minimi e altri requisiti associati alla configurazione del workload e alle classi di calcolo.
Aggiustamenti frequenti possono indicare che le specifiche delle risorse non sono ben allineate ai requisiti di Autopilot. Aggiornare i manifest per riflettere la configurazione effettiva delle risorse rende i costi più prevedibili ed evita che i team stimino le spese usando valori che in realtà non vengono applicati.
Azioni chiave:
- Confrontare le risorse richieste con i valori effettivamente applicati da Autopilot.
- Individuare i pod che vengono ripetutamente adeguati ai minimi o ai rapporti supportati.
- Aggiornare i manifest in modo che le richieste configurate corrispondano alle risorse fatturate previste.
3. Monitorare i costi insieme alle prestazioni dell'applicazione
Richieste di risorse più basse non producono automaticamente costi complessivi inferiori. Un workload sottodimensionato può subire aumenti di latenza, throttling della CPU, pressione sulla memoria o una scalabilità orizzontale aggressiva, che possono annullare i risparmi attesi.
Confrontare le metriche di costo con metriche applicative come latenza, throughput, tasso di errore, numero di repliche e utilizzo delle risorse. In questo modo è più facile trovare configurazioni che riducano la spesa senza compromettere gli obiettivi di livello di servizio o l'affidabilità dell'applicazione.
Azioni chiave:
- Tracciare i costi insieme a latenza, throughput, errori e numero di repliche.
- Prestare attenzione ai risparmi che provocano throttling o autoscaling eccessivo.
- Ottimizzare sia per l'efficienza dei costi sia per gli obiettivi di livello di servizio.
4. Separare i workloads prevedibili da quelli burstable
I workloads con requisiti di risorse stabili dovrebbero essere configurati in modo diverso dalle applicazioni con variazioni di traffico ampie o imprevedibili. I servizi prevedibili possono spesso usare richieste e numeri di repliche calibrati con cura, mentre i workloads burstable traggono maggiore beneficio dall'autoscaling.
Separare questi tipi di workloads rende inoltre più comprensibile il comportamento di capacità e costi. Ad esempio, elaborazioni batch, job pianificati e servizi guidati dalle richieste possono usare policy di scaling diverse, invece di condividere una configurazione progettata attorno alla massima domanda possibile.
Azioni chiave:
- Usare richieste e numeri di repliche stabili per i workloads prevedibili.
- Applicare policy di autoscaling ai servizi variabili o soggetti a burst.
- Configurare separatamente i workloads batch, pianificati e guidati dalle richieste.
5. Usare la capacità Spot dove le interruzioni sono accettabili
Gli Spot Pod possono ridurre i costi di calcolo per i workloads che tollerano le interruzioni. Sono adatti ad attività come elaborazioni batch, job paralleli, workloads di sviluppo ed elaborazione distribuita, in cui il lavoro interrotto può essere rieseguito o spostato altrove.
Non fare affidamento sulla capacità Spot per i workloads che non tollerano terminazioni improvvise, a meno che l'applicazione non sia progettata con una ridondanza sufficiente. Utilizzare logica di retry, checkpoint, gestione dello shutdown controllato e strategie di disruption adeguate, in modo che il recupero della capacità da parte del provider non causi perdita di lavoro o interruzioni di servizio inaccettabili.
Azioni chiave:
- Usare gli Spot Pod per workloads fault-tolerant che possono essere rieseguiti.
- Aggiungere checkpoint, retry e gestione dello shutdown controllato.
- Evitare la capacità Spot per i workloads che non tollerano terminazioni improvvise.
FAQ
Quanto costa GKE Autopilot? GKE Autopilot applica una tariffa di gestione di $0.10 per cluster all'ora, circa $73 al mese, più un prezzo basato sui pod per CPU, memoria e archiviazione effimera richieste dai pod. In us-central1, i pod general-purpose sono indicati a circa $0.0445 per vCPU all'ora e $0.0049225 per GiB di memoria all'ora.
Esiste un livello gratuito per GKE Autopilot? Google Cloud riconosce a ogni account di fatturazione $74.40 di crediti GKE mensili. Il credito si applica alla tariffa di gestione del cluster per i cluster zonali Standard e Autopilot idonei ed è sufficiente a coprire circa un cluster. Non copre CPU, memoria, storage o networking.
GKE Autopilot fattura in base alle richieste di risorse o all'utilizzo effettivo? I workloads Autopilot general-purpose usano la fatturazione basata sui pod, che addebita CPU, memoria e archiviazione effimera richieste dal pod. Richieste sovradimensionate costano di più anche quando le risorse restano inattive, e Autopilot può aumentare le richieste che scendono sotto i suoi minimi.
Qual è la differenza tra fatturazione basata sui pod e basata sui nodi in Autopilot? Con la fatturazione basata sui pod si pagano le risorse richieste dai pod. I workloads che selezionano hardware specifico, come determinate serie di macchine o GPU, usano invece la fatturazione basata sui nodi: si paga quindi l'intero nodo Compute Engine sottostante più un sovrapprezzo di gestione Autopilot.
Che fine hanno fatto gli sconti per impegno di utilizzo di Autopilot? I CUD basati sulla spesa specifici per Autopilot non sono più disponibili per nuovi acquisti; quelli esistenti restano validi fino alla scadenza. I nuovi commitments si acquistano come Compute Flexible CUD, applicabili alla spesa idonea di GKE, Compute Engine e Cloud Run sullo stesso account di fatturazione Cloud.
Tenere sotto controllo i costi di GKE Autopilot con PerfectScale
Poiché Autopilot fattura in base alle richieste di risorse dei pod, l'accuratezza di tali richieste determina direttamente la fattura, e mantenerle accurate in un ambiente in continua evoluzione non è un'attività una tantum. PerfectScale riduce la spesa Kubernetes analizzando continuamente il comportamento reale dei workloads ed effettuandone il right-sizing in modo automatico, così i cluster restano efficienti in termini di costi senza sacrificare resilienza, disponibilità o prestazioni applicative.
Funzionalità chiave di PerfectScale:
- Right-sizing autonomo dei workloads: ottimizzazione continua e in tempo reale che si adatta ai pattern di utilizzo, alle configurazioni di nodi e autoscaling e alle modifiche del codice, eliminando gli sprechi senza compromettere le prestazioni.
- Consapevolezza delle revisioni: le configurazioni dei workloads vengono riottimizzate dinamicamente a ogni nuova release del codice, così le raccomandazioni non entrano mai in conflitto con le modifiche di sviluppo.
- Integrazione con gli autoscaler: funziona con HPA, KEDA, Karpenter, Cluster Autoscaler, EKS Auto Mode, Fargate, Node Auto Provisioning e Google Autopilot per migliorare l'efficacia dello scaling già in uso.
- Insight su utilizzo dei nodi e binpacking: visibilità granulare sui nodi per identificare capacità inattiva, selezionare i tipi di nodo giusti e migliorare lo scheduling dei pod per ridurre le dimensioni dell'ambiente.
- Visibilità completa dei costi: tracciamento dettagliato dei costi nel tempo per cluster, namespace e workload, con raggruppamenti flessibili per allocare la spesa per team, sottosistema o ambiente.
- Insight predittivi sui costi: previsione della spesa futura e confronto tra costi e metriche di prestazione per allineare le decisioni ingegneristiche agli obiettivi FinOps.
- Applicazione di policy di ottimizzazione: policy dinamiche che governano su larga scala il costo e il livello di servizio desiderati di ciascun workload.
- Ampio supporto di cloud e workloads: AWS, Azure, Google, OpenShift, Rancher e cloud privato, inclusi workloads personalizzati come Spark, Flink e Rollouts.
Scopra come PerfectScale riduce i costi di Kubernetes senza compromessi →