


GKE Autopilotとは?
GKE Autopilotは、Google Kubernetes Engine(GKE)の運用モードの一つで、基盤となるクラスタインフラの大部分をGoogleが管理します。ノードやノードプール、その容量を構成・維持する代わりに、Kubernetesワークロードとそのリソース要件を定義するだけで、GKEが必要なコンピューティングリソースを自動的にプロビジョニングし、スケーリングします。
Autopilotは、ノードのアップグレード、セキュリティ構成、リソース最適化といったインフラタスクも処理します。ワークロードは引き続き標準のKubernetesオブジェクトとAPIを使用しますが、Autopilotはマネージドな運用モデルを支えるために追加の制約やデフォルト設定を適用します。これにより、Kubernetesのデプロイおよびオーケストレーション機能を維持しながら、クラスタ管理の負担を軽減できます。
Google Kubernetes Engine(GKE)Autopilotでは、クラスタあたり毎時$0.10の固定管理料金(対象クラスタ1つ分について月額$74.40の無料枠クレジットで上限設定または相殺可能)に加え、Podのリソース量に基づく課金が発生します。
本記事は、Kubernetesの料金に関する連載記事の一部です。
本記事の内容:
- GKE Autopilotのコストに影響する要因
- Google Kubernetes Engineの料金体系を理解する
- Autopilot CUDは支出ベースのFlex CUDへ移行
- GKE Autopilot料金のベストプラクティス
GKE Autopilotのコストに影響する要因
CPU・メモリリクエストの過剰割り当て
Podのリソースリクエストに基づいて課金されるワークロードでは、アプリケーションが必要とする以上のCPUやメモリをリクエストすると、そのリソースが未使用のままでもコストが増加します。たとえば、4 vCPUをリクエストしながら通常は1 vCPUしか使用しないPodは、アプリケーションが実際に必要とする量を大幅に上回るコンピューティングに基づいて課金される可能性があります。
そのため、正確なリソースリクエストはスケジューリングとコスト管理の両面で重要です。過去の使用率メトリクス、負荷テスト、垂直Pod自動スケーリングの推奨値を活用すれば、過大なリクエストを特定できます。ただし、通常のトラフィック急増やアプリケーションの起動に対応できるだけの余裕は残しておくべきです。
最小リソースリクエストとAutopilotによる調整
Autopilotは、サポート対象のワークロードに対してCPU、メモリ、エフェメラルストレージの最小要件を適用します。Podがこれらの下限を下回るリソースをリクエストした場合、Autopilotはリクエストを自動的に引き上げることがあります。また、CPUとメモリの比率が選択したコンピューティングクラスのサポート範囲外になった場合にも、リクエストが変更されることがあります。
こうした調整が重要なのは、スケジューリングと課金に使用される値が、ワークロードマニフェストで元々指定した値より高くなる可能性があるためです。非常に小さなPodを多数組み合わせたアプリケーションは特に見直す価値があります。最小リソース要件によって、処理を小さなコンテナに分割することで期待されるコストメリットが目減りする可能性があるからです。
関連コンテンツ:Kubernetesのrequestsとlimitsがスケジューリングとコストに与える影響について詳しくはこちら
稼働中のPod数
すべてのワークロードは一定のコンピューティング容量を必要とするため、稼働中のPod数はコストに影響します。可用性の確保、ローリングデプロイ、水平スケーリングのためにレプリカ数を増やすと、CPUとメモリの合計要件も増加します。常時稼働しているPodは、アプリケーションのアクティビティが低い期間でもコストを発生させます。
Pod数はリソースリクエストと併せて検討する必要があります。小さなレプリカ10個と大きなレプリカ2個では、合計容量は同程度でも、スケジューリングやスケーリングの特性が異なります。バックグラウンドサービス、サイドカー、システムコンポーネントも、各ワークロードに関連するリソースを増やす要因になります。
コンピューティングクラスの選択
Autopilotは、汎用ワークロード、高性能アプリケーション、スケールアウト型ワークロード、アクセラレータを必要とするワークロードなど、さまざまな要件に対応するコンピューティングクラスを提供しています。選択したクラスによって、利用可能なハードウェア、リソース上限、スケジューリング動作、適用される料金が変わります。
特化型のコンピューティングクラスは、アプリケーションが特定の性能特性を必要とする場合に有用ですが、汎用の選択肢よりコストが高くなる可能性があります。デフォルトで高性能なリソースを割り当てるのではなく、計測したワークロード要件に基づいてクラスを選択すべきです。同一環境内の異なるワークロードで、必要に応じて異なるクラスを使い分けることもできます。
リージョン
Google Cloudの料金はリージョンによって異なるため、同一のワークロードでも実行場所によってインフラコストが変わります。リージョン間の差は、コンピューティングリソースだけでなく、ストレージや一部のネットワーク料金にも影響します。
リージョン選択において価格だけを判断基準にすべきではありません。レイテンシやネットワーク転送を削減するために、アプリケーションをユーザー、データベース、その他のサービスの近くで実行する必要がある場合があります。データ所在地の要件やサービスの提供状況によって現実的に選べるリージョンが制限されることもあり、リージョンごとのコストは配置を決める上での一要素にすぎません。
ストレージ消費量
ストレージコストは、Podの実行に使用されるCPU・メモリとは別に課金されます。アプリケーションでは、永続ボリューム、スナップショット、バックアップなどのストレージリソースに対して料金が発生する可能性があります。課金額は、ストレージタイプ、プロビジョニングされた容量、リージョン、ストレージサービスに対して実行される操作などの要因によって決まります。
永続リソースのライフサイクルはPodとは異なります。ワークロードを削除またはスケールダウンしても、永続ディスク、スナップショット、バックアップが削除されるとは限りません。そのため、未使用のボリュームはコンピューティングワークロードが消えた後も課金され続ける可能性があり、ストレージのライフサイクル管理はコスト管理の重要な要素になります。
ネットワークトラフィック
ネットワークコストは、転送されるデータ量とその転送先によって決まります。異なるリージョン間のサービス間トラフィック、パブリックインターネットへの送信データ、Cloud Load Balancingなどのサービスで処理されるトラフィックは、Pod自体の実行コストに加えて料金を発生させる可能性があります。
そのため、ネットワークアーキテクチャはデータ集約型アプリケーションに大きな影響を与えることがあります。頻繁に通信するサービスを適切なロケーションに配置すれば、レイテンシと転送コストの両方を削減できます。また、不要なリージョン間呼び出し、大きなアウトバウンドレスポンス、同一データの繰り返し転送がないか、アプリケーションの挙動を監視すべきです。
GPUと特殊ハードウェア
GPUなどの特殊なアクセラレータを使用すると、個々のワークロードのコストが標準的なCPUベースのワークロードより大幅に高くなる可能性があります。コストは、アクセラレータの種類、デバイス数、リージョン、コンピューティング構成、リソースを必要とする時間によって決まります。
アクセラレータワークロードでは、使用率が特に重要です。データ待ちやCPUバウンドの処理に多くの時間を費やすワークロードにGPUを割り当てると、コスト効率が悪くなります。バッチスケジューリング、自動スケーリング、適切なアクセラレータの選択、アプリケーションのプロファイリングによって、高価なハードウェアを測定可能なメリットがある場合にのみ使用するようにできます。
関連コンテンツ:KubernetesでのGPUワークロードの実行に関する記事はこちら
Google Kubernetes Engineの料金体系を理解する
GKEの無料枠と料金クレジット
Google Cloudは請求先アカウントごとに月額$74.40のGKEクレジットを提供しています。このクレジットは、対象となるゾーンStandardクラスタおよびAutopilotクラスタのクラスタ管理料金に適用されます。標準のクラスタ管理料金はクラスタあたり毎時$0.10であるため、$74.40は対象クラスタ1つを通常の1か月間継続稼働させる費用をほぼカバーできる金額です。
たとえば、730時間稼働するクラスタでは、通常約**$73の管理料金**が発生します:
730 hours × $0.10 = $73
したがってこの例では、月次クレジットで管理料金全額を相殺できます。ただし、ワークロードが消費するCPU、メモリ、ストレージ、ネットワークはクレジットの対象外です。
クラスタ管理料金
GKEでは、StandardモードかAutopilotモードかにかかわらず、クラスタあたり毎時$0.10の管理料金が発生します。
たとえば、1つのクラスタを730時間継続稼働させた場合のコストはおよそ次のとおりです:
730 × $0.10 = $73 per month
5つのクラスタを継続稼働させた場合、クレジット適用前の管理料金は約月額$365になります:
5 × $73 = $365
対象となるAutopilotクラスタおよびゾーンStandardクラスタでは、月額$74.40の無料枠クレジットでこれらの料金の一部または全額を相殺できます。
コンピューティングコスト
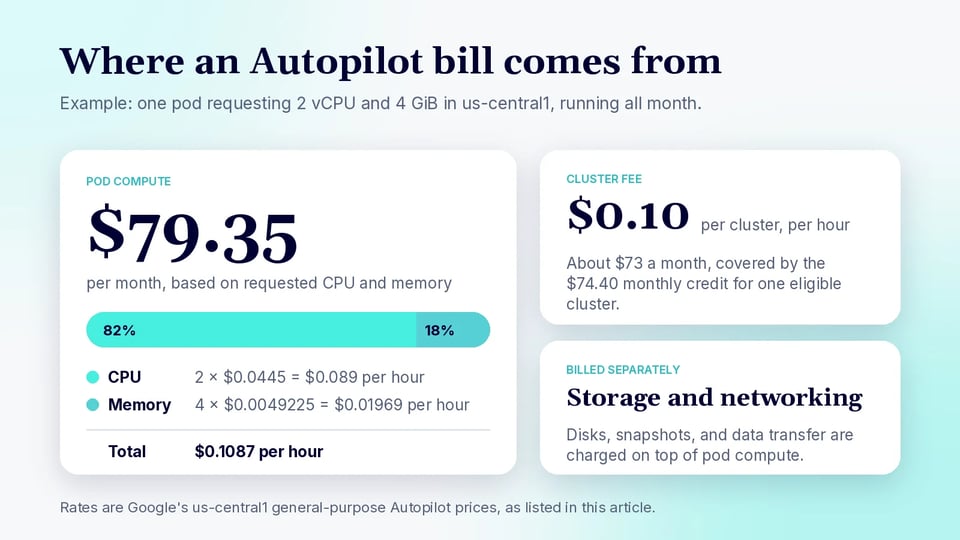
アイオワ(us-central1)の汎用Autopilotワークロードについて、Googleは現在、オンデマンド料金として約vCPUあたり毎時$0.0445、メモリ1 GiBあたり毎時$0.0049225を提示しています。エフェメラルストレージは別料金で、約1 GiBあたり毎時$0.0001389です。
たとえば、2 vCPUと4 GiBのメモリをリクエストして常時稼働するPodを考えてみましょう:
- CPU:
2 × $0.0445 = $0.089/hour - メモリ:
4 × $0.0049225 = $0.01969/hour - 合計: 約**$0.1087/時**
730時間では、このPodのコストは約月額$79.35になります(エフェメラルストレージ、永続ストレージ、ネットワーク、その他のサービスは除く)。
Balancedコンピューティングクラスのリソースはこれより高額です。us-central1では、GoogleはBalanced Autopilot Podについて約vCPUあたり毎時$0.0645、メモリ1 GiBあたり毎時$0.0071354を提示しています。
Podベース課金とNodeベース課金の違い
汎用AutopilotワークロードにはPodベース課金が適用されます。つまり、基盤となるノードの総容量ではなく、主にPodがリクエストしたCPU、メモリ、エフェメラルストレージに基づいて課金されます。
たとえばus-central1では、1 vCPUと2 GiBのメモリをリクエストする汎用Podのコストはおよそ次のとおりです:
$0.0445 + (2 × $0.0049225) = $0.054345/hour
730時間継続稼働した場合、約月額$39.67になります。
特定のマシンシリーズやGPUなど、特定のハードウェアを選択するAutopilotワークロードには、代わりにNodeベース課金が適用されます。このモデルでは、基盤となるCompute Engineノード全体の料金に加えて、Autopilot管理プレミアムを支払います。たとえばGoogleは、us-central1におけるAutopilot Performanceプレミアムとして、基盤となるCompute Engine料金に加えて約vCPUあたり毎時$0.004、メモリ1 GiBあたり毎時$0.0005を提示しています。
ストレージとネットワークのコスト
永続ストレージとネットワークトラフィックは、AutopilotのCPU・メモリ料金とは別に課金されます。金額は、ストレージクラス、容量、トラフィックの送信元と宛先、リージョンによって異なります。
たとえば、us-central1のGoogle Cloud Persistent Diskの料金には、SSDプロビジョニングストレージが約1 GiBあたり毎時$0.000232877で含まれています。100 GiBのSSDディスクを継続的にプロビジョニングした場合のコストはおよそ次のとおりです:
100 × $0.000232877 × 730 ≈ $17 per month
永続ディスク自体がプロビジョニングされたままであれば、それを使用するPodが停止していてもストレージは課金対象のままです。
ネットワークも大きなコスト要因になり得ます。たとえば、北米の2つのGoogle Cloudリージョン間のデータ転送は現在1 GiBあたり$0.02です。リージョン間で1 TiBを転送した場合のコストはおよそ次のとおりです:
1,024 GiB × $0.02 = $20.48
インターネットデータ転送料金は、宛先と使用量ティアによって異なります。たとえば、米国リージョンから北米へのPremium Tierの送信トラフィックは、無料枠超過後の最初の1 TiBについて1 GiBあたり$0.12と提示されています。
Autopilot CUDは支出ベースのFlex CUDへ移行
Googleは、確約利用割引(CUD)のGKE Autopilotへの適用方法を変更しました。Autopilot専用の支出ベースCUDは新規購入できなくなっています。既存のAutopilotコミットメントは有効期限まで引き続きサポートされますが、対象となるGKE使用量に対する新規のコミットメントは**Compute Flexible CUD(Flex CUD)**として購入します。
Compute Flexible CUDは、一定数のKubernetesリソースに対するコミットメントではなく、支出ベースのコミットメントです。組織は1年または3年の期間について時間あたりの最低支出額(ドル)をコミットし、その割引は同じCloud Billingアカウントに紐づく対象のGKE、Compute Engine、Cloud Runの使用量全体に適用できます。これにより、ワークロードがサービス、リージョン、サポート対象のコンピューティング構成の間を移動する際の柔軟性が高まります。
Googleはまた、すべてのCloud Billingアカウントを新しい支出ベースのCUD消費モデルに移行しました。このモデルでは、対象となる使用量が、まず定価で請求されてからCUDクレジットで相殺されるのではなく、適用される割引価格で直接課金されます。Googleは2026年2月に、すべてのCloud Billingアカウントが自動的に移行され、拡張されたCompute Flexible CUDの適用範囲がすべての顧客に提供されることを発表しました。
GKE Autopilotユーザーにとっての実務上の違いは、コスト削減がAutopilot自体に強く紐づかなくなったことです。Compute Flexibleのコミットメントは、より広範なGoogle Cloudコンピューティングサービス群の対象支出をカバーできるため、インフラ要件が変化してもCUDの利用率を維持しやすくなります。ただし、コミットした金額はコミットメント期間を通じて支払い続ける必要があるため、Flex CUDは一般に、一時的なピークではなく予測可能なベースライン支出に合わせてサイジングするのが最適です。
GKE Autopilot料金のベストプラクティス
GKE Autopilot利用時のコスト管理に役立つプラクティスを紹介します。
1. 実際の使用データに基づいてリソースリクエストを設定する
CPUとメモリのリクエストは、推定値だけに頼らず、実際に観測された使用率に基づいて設定しましょう。通常トラフィック、ピーク時、デプロイ、バックグラウンドジョブにわたってメトリクスを収集し、各ワークロードが実際に必要とする容量を把握します。
ピークを考慮せずにリクエストを平均使用率まで下げるのは避けてください。リクエストには、スロットリング、メモリ不足による強制終了、不要なスケーリングを防ぐのに十分な余裕を持たせるべきです。垂直Pod自動スケーリングの推奨値は、これらの値を継続的に調整するための有用なデータになります。
主なアクション:
- 通常時とピーク時のCPU・メモリ使用量を計測する
- VPAの推奨値を活用してリクエストを継続的に調整する
- スロットリングやメモリ障害を避けるのに十分な余裕を確保する
2. Autopilotによるリソース調整を確認する
元のマニフェストの値がそのまま適用されていると想定せず、デプロイ後にPodへ割り当てられたリソースを確認しましょう。Autopilotは、ワークロード構成やコンピューティングクラスに関連する最小要件などを満たすために、リソースリクエストを変更することがあります。
調整が頻発する場合は、リソース指定がAutopilotの要件と合っていない可能性があります。実際に適用されているリソース構成を反映するようマニフェストを更新すれば、コストの予測可能性が高まり、実際には適用されていない値でコストを見積もってしまう事態を防げます。
主なアクション:
- リクエストしたリソースとAutopilotが実際に適用した値を比較する
- 最小値やサポート対象の比率に繰り返し調整されているPodを特定する
- 設定したリクエストが想定される課金対象リソースと一致するようマニフェストを更新する
3. コストとアプリケーションパフォーマンスを併せて監視する
リソースリクエストを下げても、総コストが自動的に下がるとは限りません。リソースが不足したワークロードでは、レイテンシの増加、CPUスロットリング、メモリ逼迫、過剰な水平スケーリングが発生し、期待した節約が相殺される可能性があります。
コストメトリクスを、レイテンシ、スループット、エラー率、レプリカ数、リソース使用率などのアプリケーションメトリクスと比較しましょう。これにより、サービスレベル目標やアプリケーションの信頼性を損なわずに支出を削減できる構成を見つけやすくなります。
主なアクション:
- コストをレイテンシ、スループット、エラー、レプリカ数と併せて追跡する
- スロットリングや過剰な自動スケーリングを引き起こす節約に注意する
- コスト効率とサービスレベル目標の両方を最適化する
4. 予測可能なワークロードとバースト型ワークロードを分離する
リソース要件が安定しているワークロードと、トラフィックが大きくあるいは予測不能に変動するアプリケーションとでは、構成を変えるべきです。予測可能なサービスは、入念に調整したリクエストとレプリカ数で運用できる場合が多い一方、バースト型ワークロードには自動スケーリングの方が効果的です。
ワークロードの種類を分離すれば、容量とコストの挙動も把握しやすくなります。たとえば、バッチ処理、スケジュールジョブ、リクエスト駆動型サービスは、想定しうる最大需要に合わせた共通設定を使うのではなく、それぞれ異なるスケーリングポリシーを使えます。
主なアクション:
- 予測可能なワークロードには安定したリクエストとレプリカ数を使用する
- 変動型やバースト駆動型のサービスには自動スケーリングポリシーを適用する
- バッチ、スケジュール、リクエスト駆動型のワークロードを個別に構成する
5. 中断が許容できる場合はSpot容量を活用する
Spot Podは、中断を許容できるワークロードのコンピューティングコストを削減できます。バッチ処理、並列ジョブ、開発ワークロード、分散処理など、中断された処理を再試行したり別の場所に移したりできるタスクに適しています。
突然の終了を許容できないワークロードでは、アプリケーションに十分な冗長性が設計されていない限り、Spot容量に依存しないでください。再試行ロジック、チェックポイント、グレースフルシャットダウンの処理、適切なディスラプション戦略を活用し、容量の回収によって処理の喪失や許容できないサービス中断が起きないようにしましょう。
主なアクション:
- 再試行可能で耐障害性のあるワークロードにSpot Podを使用する
- チェックポイント、再試行、グレースフルシャットダウンの処理を追加する
- 突然の終了を許容できないワークロードではSpot容量を避ける
FAQ
GKE Autopilotの料金はいくらですか? GKE Autopilotでは、クラスタあたり毎時$0.10(月額約$73)の管理料金に加え、PodがリクエストするCPU、メモリ、エフェメラルストレージに対するPodベースの料金が発生します。us-central1では、汎用Podの料金は約vCPUあたり毎時$0.0445、メモリ1 GiBあたり毎時$0.0049225と提示されています。
GKE Autopilotに無料枠はありますか? Google Cloudは請求先アカウントごとに月額$74.40のGKEクレジットを提供しています。このクレジットは、対象となるゾーンStandardクラスタおよびAutopilotクラスタのクラスタ管理料金に適用され、クラスタ約1つ分をカバーできます。CPU、メモリ、ストレージ、ネットワークは対象外です。
GKE Autopilotの課金はリソースリクエストと実際の使用量のどちらに基づきますか? 汎用AutopilotワークロードはPodベース課金を採用しており、PodがリクエストするCPU、メモリ、エフェメラルストレージに対して課金されます。過大なリクエストは、リソースがアイドル状態のままでもコストを増やします。また、Autopilotは最小値を下回るリクエストを引き上げることがあります。
AutopilotにおけるPodベース課金とNodeベース課金の違いは何ですか? Podベース課金では、Podがリクエストしたリソースに対して支払います。特定のマシンシリーズやGPUなど、特定のハードウェアを選択するワークロードには、代わりにNodeベース課金が適用されます。この場合、基盤となるCompute Engineノード全体の料金に加えて、Autopilot管理プレミアムを支払います。
Autopilotの確約利用割引はどうなりましたか? Autopilot専用の支出ベースCUDは新規購入できなくなり、既存のものは有効期限まで継続します。新規のコミットメントはCompute Flexible CUDとして購入し、同じCloud Billingアカウント上の対象となるGKE、Compute Engine、Cloud Runの支出に適用できます。
PerfectScaleでGKE Autopilotのコストを管理
Autopilotの課金はPodのリソースリクエストに基づくため、リクエストの正確さがそのまま請求額を左右します。そして、変化し続ける環境でリクエストを正確に保つことは、一度きりの作業では終わりません。PerfectScaleは、ワークロードの実際の挙動を継続的に分析して自動的にライトサイジングすることでKubernetesの支出を削減し、レジリエンス、可用性、アプリケーションパフォーマンスを犠牲にすることなくクラスタのコスト効率を維持します。
PerfectScaleの主な機能:
- 自律的なワークロードのライトサイジング: 使用パターン、ノードや自動スケーリングの構成、コード変更に適応する継続的なリアルタイム最適化により、パフォーマンスを損なうことなく無駄を排除します。
- リビジョン認識: 新しいコードリリースのたびにワークロード構成を動的に再最適化するため、推奨事項が開発の変更と矛盾しません。
- オートスケーラー連携: HPA、KEDA、Karpenter、Cluster Autoscaler、EKS Auto Mode、Fargate、Node Auto Provisioning、Google Autopilotと連携し、既存のスケーリングの効果を高めます。
- ノード使用率とビンパッキングの分析: きめ細かなノードの可視化により、アイドル容量の特定、適切なノードタイプの選択、Podスケジューリングの改善を行い、環境の規模を縮小します。
- 完全なコスト可視性: クラスタ、Namespace、ワークロード別に詳細なコスト推移を追跡し、柔軟なグルーピングでチーム・サブシステム・環境ごとに支出を配分できます。
- 予測的コスト分析: 将来の支出を予測し、コストとパフォーマンスメトリクスを比較して、エンジニアリングの意思決定をFinOpsの目標に整合させます。
- 最適化ポリシーの適用: 各ワークロードの目標コストとサービスレベルを大規模に管理する動的ポリシー。
- 幅広いクラウドとワークロードのサポート: AWS、Azure、Google、OpenShift、Rancher、プライベートクラウドに対応し、Spark、Flink、Rolloutsなどのカスタムワークロードもサポートします。