


ErrImagePull es el error que muestra Kubernetes cuando el kubelet no puede descargar la imagen de contenedor de un pod. La imagen es lo que el contenedor necesita para ejecutarse, así que si el kubelet no puede descargarla, el contenedor nunca arranca. Normalmente lo verás como un pod atascado en ErrImagePull o ImagePullBackOff, sin logs de la aplicación que lo expliquen, porque la aplicación todavía no se ha ejecutado.
En esta guía aprenderás qué significa ErrImagePull, en qué se diferencia de ImagePullBackOff, cómo descarga Kubernetes las imágenes, las causas más comunes, cómo diagnosticar la falla y cómo solucionarla. También verás cómo los pods atascados pueden desaprovechar la capacidad de los nodos.
¿Qué es el error ErrImagePull en Kubernetes?
ErrImagePull significa que un intento individual de pull de imagen falló. Cuando creas un pod, el kubelet del nodo del pod le pide al runtime de contenedores que descargue la imagen indicada en el spec del pod. Si ese pull falla por cualquier motivo, el estado del contenedor pasa a ErrImagePull, y el contenedor queda en espera en lugar de arrancar.
Lo importante es que ErrImagePull tiene que ver con obtener la imagen, no con ejecutarla. La aplicación no ha arrancado, así que kubectl logs no tiene nada que mostrar. La razón de la falla está en los eventos del pod.
ErrImagePull vs. ImagePullBackOff
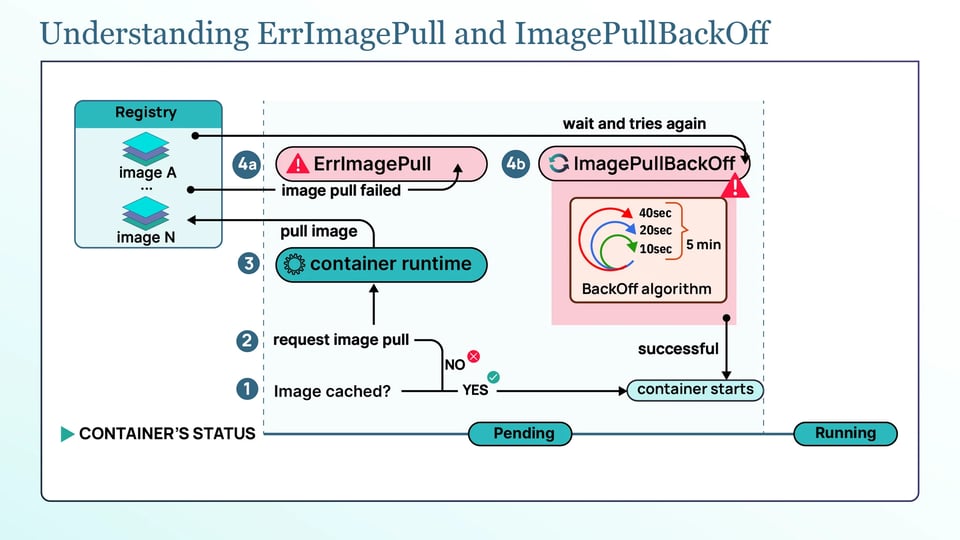
ErrImagePull significa que el kubelet intentó descargar la imagen del contenedor y el intento falló. No deja de intentarlo. Después de la falla, el kubelet espera antes de volver a intentar el pull.
ImagePullBackOff significa que el kubelet está esperando antes del siguiente intento de pull. El tiempo entre intentos aumenta después de fallas repetidas.
El backoff comienza en torno a los 10 segundos y aumenta de forma exponencial: aproximadamente 10 segundos, 20 segundos, 40 segundos, y así sucesivamente. Tiene un tope de 5 minutos (300 segundos). Una vez alcanzada la demora máxima, el kubelet sigue reintentando aproximadamente cada 5 minutos.
El pod no desaparece automáticamente. Permanece en este ciclo hasta que la imagen se puede descargar, se soluciona el problema de fondo o se elimina el pod.
¿Cómo descarga Kubernetes las imágenes de contenedor?
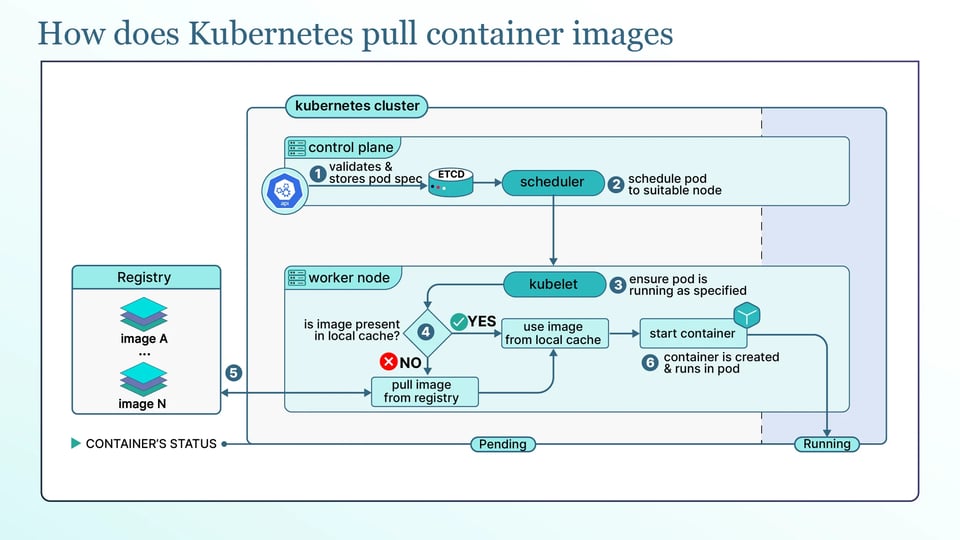
La mayoría de los errores ErrImagePull se entienden mejor cuando sabes cómo descarga Kubernetes una imagen. Cuando un pod se programa en un nodo, el kubelet de ese nodo le pide al runtime de contenedores (como containerd o CRI-O) que se asegure de que la imagen esté presente. El runtime primero revisa la política de pull de la imagen y si la imagen ya está en el nodo. Si necesita descargarla, contacta al registry, se autentica si el registry es privado, descarga las capas de la imagen y las desempaqueta. Solo cuando la imagen está lista arranca el contenedor. Una falla en cualquiera de estos pasos, como un nombre incorrecto, una credencial faltante o un problema de red, se manifiesta como ErrImagePull.
La política de pull de la imagen controla cuándo Kubernetes descarga una imagen. Hay tres opciones:
a. Always descarga la imagen cada vez que el pod arranca. Es el valor por defecto cuando la imagen usa el tag :latest o no tiene tag.
b. IfNotPresent descarga la imagen solo cuando no está ya en el nodo. Es el valor por defecto para imágenes con cualquier otro tag.
c. Never le indica al runtime que use únicamente una imagen que ya está en el nodo. Nunca descarga la imagen. Si la imagen no está disponible localmente, obtienes el error ErrImageNeverPull.
La referencia de la imagen controla exactamente qué imagen se descarga. Incluye un repositorio y un tag o un digest, escritos como repository:tag o repository@sha256:<digest>. Un tag como :1.4 es mutable, es decir, la imagen a la que apunta puede cambiar con el tiempo. Un digest es un identificador único de una imagen, por lo que siempre apunta a la misma imagen.
Causas comunes de ErrImagePull
ErrImagePull suele deberse a los siguientes problemas comunes:
a. Nombre de imagen, repositorio o tag incorrectos: Un error de tipeo en el nombre de la imagen, una ruta de registry equivocada o un tag que no existe hacen fallar el pull. El mensaje suele ser algo como manifest unknown o repository does not exist or may require authorization. Es lo primero que hay que revisar.
b. Credenciales del registry faltantes, incorrectas o vencidas: Un registry privado necesita credenciales, y si faltan o son incorrectas, el pull falla con unauthorized: authentication required. Los casos más comunes son un pull secret que nunca se asoció al pod, un secret en el namespace equivocado o un token vencido. Los tokens de Amazon ECR, por ejemplo, son de corta duración, así que una configuración que ayer descargaba sin problemas puede fallar hoy si no se configuró la renovación del token.
c. Límites de pull y throttling del registry: Los registries públicos limitan la frecuencia con la que puedes hacer pull. Docker Hub devuelve toomanyrequests (una respuesta 429) cuando superas su límite. Al día de hoy, los pulls anónimos están limitados a 100 cada 6 horas por dirección IP, las cuentas gratuitas autenticadas tienen 200 cada 6 horas y las cuentas de pago no tienen límite. La cifra muy difundida de "10 pulls por hora" se anunció pero nunca se aplicó, así que el límite actual es de 100 cada 6 horas. En un clúster con mucha actividad detrás de una sola IP pública, es más fácil de alcanzar de lo que parece.
d. Red del nodo, DNS o proxy bloqueando el registry: Si el nodo no puede alcanzar el registry, el pull falla con errores como dial tcp: lookup ... no such host o i/o timeout. Esto ocurre con un DNS que falla, un proxy corporativo que el runtime desconoce, una regla de firewall o un clúster aislado (air-gapped) sin ruta hacia un registry público.
e. Errores de certificado TLS con registries privados: Un registry privado que usa un certificado autofirmado o no confiable hace fallar el pull con x509: certificate signed by unknown authority. El runtime de contenedores del nodo no confía en el certificado del registry, por lo que rechaza la conexión.
f. La arquitectura de la imagen no coincide con la CPU del nodo: Una imagen compilada solo para amd64 no se ejecutará en un nodo arm64, y el pull falla con no matching manifest for linux/arm64. Es común en clústeres con CPUs mixtas y en nodos basados en Arm.
g. Presión de disco en el nodo y espacio insuficiente para las capas de la imagen: Las capas de la imagen necesitan espacio en el nodo. Si el nodo tiene poco disco, el pull falla con no space left on device, y el nodo puede además presentar una condición de disk pressure que impide que se programen nuevos pods en él.
¿Cómo diagnosticar un error ErrImagePull?
Encontrar la causa consiste, sobre todo, en leer la salida correcta en este orden:
a. Lee el estado del pod con kubectl get pods: Esto confirma el síntoma. El STATUS del pod muestra ErrImagePull o ImagePullBackOff, y un contador de RESTARTS en aumento o la antigüedad del pod te indican que lleva un rato atascado.
kubectl get pods
b. Encuentra el error real con kubectl describe pod: Este es el paso clave. La sección Events: de la salida de kubectl describe pod muestra el error real del pull de la imagen, que normalmente te dice con cuál de las causas estás lidiando.
kubectl describe pod <pod-name>Busca un evento Failed con un mensaje como Failed to pull image ...: unauthorized o ... no such host. Ese mensaje es la respuesta la mayoría de las veces.
c. Revisa los logs de kubelet y containerd en el nodo: Si el mensaje del evento no basta, los logs del nodo asignado tienen más detalle. En el nodo, consulta el log del kubelet con journalctl -u kubelet, y el log de containerd de la misma forma para ver el pull desde el punto de vista del runtime.
d. Reproduce el pull desde el nodo con crictl pull: Para confirmar si el problema está en el nodo mismo, descarga la imagen directamente con crictl, la herramienta de depuración de CRI, en el nodo:
crictl pull <image>Si esto falla con el mismo error, el problema está a nivel de nodo, como la red, las credenciales o la confianza TLS, y no en el spec del pod.
¿Cómo solucionar ErrImagePull?
Una vez identificada la causa, la solución suele ser sencilla. Estas son las soluciones para las causas anteriores:
a. Corrige la referencia de la imagen y ánclala a un digest: primero corrige cualquier error de tipeo en el repositorio, el tag o la ruta del registry. Para workloads en producción, ve un paso más allá y ancla la imagen a un digest (repository@sha256:<digest>) en lugar de un tag mutable, para que el pod siempre descargue exactamente la imagen que probaste.
b. Crea un imagePullSecret y asócialo: Para un registry privado, crea un pull secret y asígnaselo al pod. Crea el secret:
kubectl create secret docker-registry regcred \ --docker-server=<registry> \ --docker-username=<user> \ --docker-password=<password> \ --namespace=<namespace>Luego referéncialo en el spec del pod bajo imagePullSecrets, o asócialo al ServiceAccount del pod para que todos los pods que usen esa cuenta lo reciban automáticamente. El secret debe existir en el mismo namespace que el pod.
c. Arregla la red del nodo, la configuración del proxy y la confianza en la CA: Para causas de red, asegúrate de que el nodo pueda resolver y alcanzar el registry. Si el nodo usa un proxy, configura el runtime de contenedores para que lo utilice. Ante un error de TLS, agrega el certificado de la CA del registry al almacén de confianza del nodo o a la configuración del runtime, de modo que confíe en el registry.
d. Configura un registry mirror o un pull-through cache: Para evitar los límites de pull, deja de descargar una y otra vez las mismas imágenes públicas desde internet. Un pull-through cache o un registry mirror (por ejemplo, un pull-through cache de ECR) almacena las imágenes más cerca de tu clúster, y autenticar tus pulls también aumenta tu límite.
e. Libera espacio en disco y ajusta la recolección de basura de imágenes: Ante disk pressure, libera espacio en el nodo y deja que el kubelet limpie las imágenes sin usar. La recolección de basura de imágenes del kubelet se controla con imageGCHighThresholdPercent (por defecto 85) e imageGCLowThresholdPercent (por defecto 80): cuando el uso de disco supera el umbral alto, el kubelet elimina imágenes sin usar hasta alcanzar el umbral bajo. Un umbral más bajo hace que la limpieza comience antes, lo que ayuda a evitar que los nodos se llenen.
ErrImagePull en clústeres administrados y locales
Algunos entornos manejan las credenciales de imágenes de forma diferente, así que conviene conocer los casos más comunes:
a. Amazon EKS descargando desde ECR: El nodo o el pod necesita permisos de AWS para hacer pull desde ECR, en lugar de un pull secret de Docker. El rol de IAM del nodo puede usar la política AmazonEC2ContainerRegistryReadOnly. Para un acceso más acotado, usa IRSA o EKS Pod Identity para dar acceso a workloads específicos. Los tokens de ECR son de corta duración, pero el kubelet los renueva automáticamente.
b. GKE descargando desde Artifact Registry: La cuenta de servicio del nodo necesita el rol Artifact Registry Reader. Para acceso a nivel de workload, usa Workload Identity para conectar una cuenta de servicio de Kubernetes con una cuenta de servicio de Google que tenga el rol Reader.
c. Clústeres locales como minikube y kind: Una imagen compilada en tu laptop puede no estar disponible en los nodos del clúster. Carga la imagen directamente en el clúster en lugar de subirla a un registry. Con minikube, usa minikube image load <image>. Con kind, usa kind load docker-image <image>. Luego establece imagePullPolicy en IfNotPresent o Never para que Kubernetes use la imagen local.
¿Cómo los pods atascados en ImagePullBackOff desaprovechan la capacidad del nodo y tu presupuesto?
Cuando un pod llega a ImagePullBackOff, ya fue asignado a un nodo. Sus requests de CPU y memoria cuentan para la capacidad reservada del nodo, y esa reserva se mantiene mientras el pod espera la imagen. Es decir, el nodo está reteniendo capacidad para un pod que no hace ningún trabajo.
Un solo pod atascado puede no importar mucho. Pero un despliegue con muchas réplicas atascadas, o pods con requests de recursos sobredimensionados, puede reservar una cantidad significativa de capacidad. En un clúster con autoescalado, esto puede incluso hacer que el Cluster Autoscaler agregue nodos para hacer lugar a otros workloads. Terminas pagando por capacidad mientras los pods atascados no hacen nada.
Como el kubelet sigue reintentando el pull de la imagen, esta capacidad desaprovechada puede mantenerse hasta que se solucione el problema de la imagen o se elimine el pod.
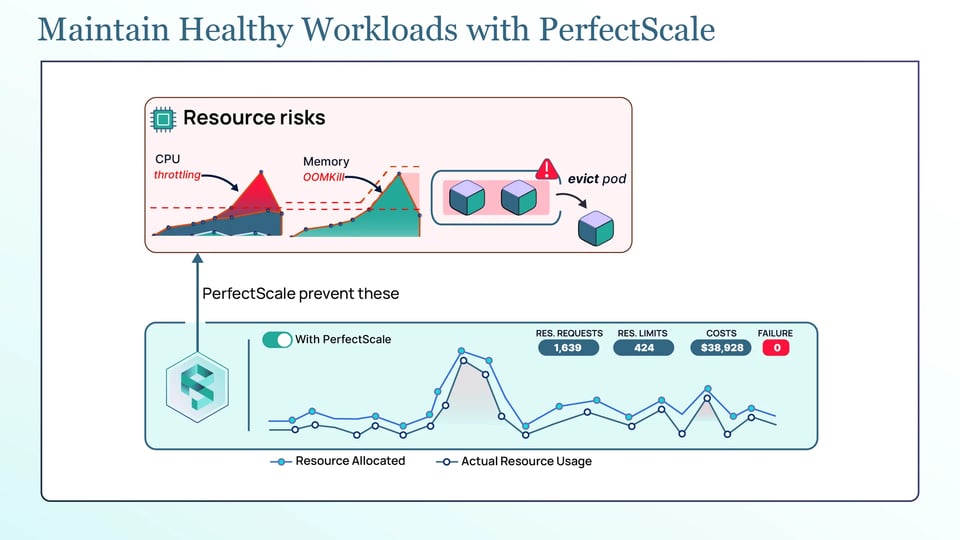
Aquí es donde PerfectScale ayuda en materia de costos. La plataforma de gobernanza de Kubernetes de PerfectScale te da visibilidad sobre cómo tus workloads usan realmente la CPU y la memoria, y convierte esa información en recomendaciones de right-sizing concretas y automatizadas que puedes aplicar de forma manual o autónoma. Con requests bien dimensionados, un pod atascado reserva solo lo que realmente necesita en lugar de una cantidad sobredimensionada. Equipos como Paramount Pictures y Creditas usan PerfectScale para mantener sus clústeres eficientes. Puedes registrarte o agendar una sesión técnica.
Buenas prácticas para prevenir errores ErrImagePull
Estas son las principales prácticas para prevenir errores ErrImagePull:
a. Ancla los workloads de producción a digests de imagen en lugar de tags mutables: Un digest (@sha256:...) siempre apunta exactamente a la imagen que probaste, por lo que los cambios en un tag no pueden alterar la imagen que descargan tus pods.
b. Publica imágenes multiarquitectura para pools de nodos con CPUs mixtas: Si tus nodos incluyen tanto amd64 como arm64, usa imágenes multiarquitectura para que cada nodo pueda descargar la versión correcta.
c. Valida las referencias de imágenes en CI y usa políticas de admisión: Verifica los nombres y tags de las imágenes antes del despliegue. Las políticas de admisión también pueden exigir digests de imagen o permitir imágenes solo de registries aprobados.
d. Precarga las imágenes críticas antes de un despliegue: Conviene descargar las imágenes importantes en los nodos con anticipación, por ejemplo con un DaemonSet, para que el despliegue no dependa de descargar la imagen al arrancar.
e. Configura alertas para fallas de pull, disk pressure en los nodos y recolección de basura de imágenes: Las alertas tempranas ante pulls fallidos, poco espacio en disco y recolección de basura de imágenes ayudan a identificar los problemas antes de que afecten a más pods o nodos.