


ErrImagePullは、kubeletがPodのコンテナイメージを取得(pull)できないときにKubernetesが表示するエラーです。コンテナはイメージをもとに実行されるため、kubeletがイメージをダウンロードできなければ、コンテナは起動しません。多くの場合、PodがErrImagePullまたはImagePullBackOffの状態で止まったままになり、アプリケーションがまだ動いていないため、原因を示すアプリケーションログも出力されません。
このガイドでは、ErrImagePullの意味、ImagePullBackOffとの違い、Kubernetesがイメージを取得する仕組み、よくある原因、障害の診断方法、そして解決策を解説します。あわせて、止まったままのPodがノードのキャパシティを無駄にする仕組みについても説明します。
KubernetesのErrImagePullエラーとは?
ErrImagePullは、1回のイメージ取得の試行が失敗したことを意味します。Podを作成すると、Podが配置されたノードのkubeletがコンテナランタイムに対して、Pod仕様に記載されたイメージの取得を依頼します。この取得が何らかの理由で失敗すると、コンテナの状態はErrImagePullになり、コンテナは起動せずに待機します。
重要なのは、ErrImagePullはイメージの「取得」に関するエラーであって、「実行」に関するものではないという点です。アプリケーションは起動していないため、kubectl logsには何も表示されません。失敗の理由はPodのイベントに記録されています。
ErrImagePullとImagePullBackOffの違い
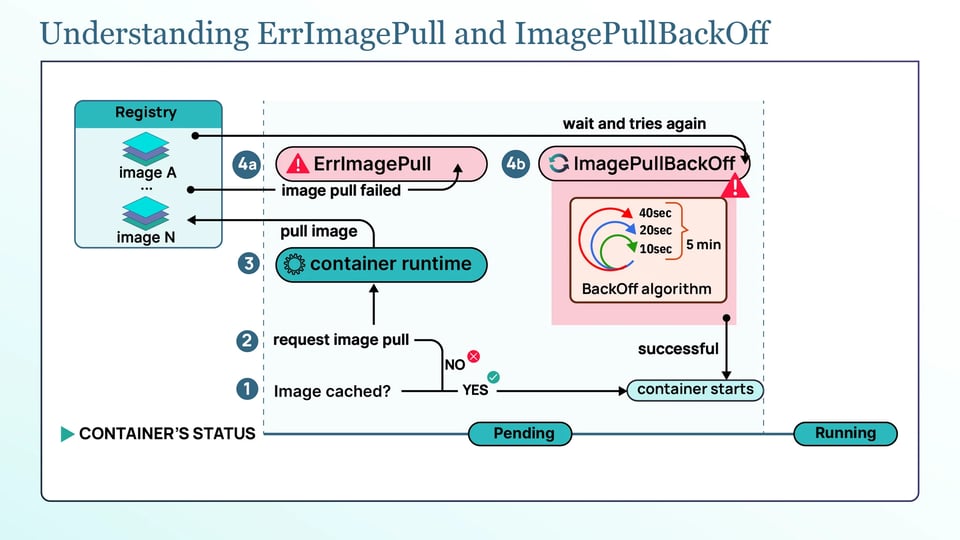
**ErrImagePull**は、kubeletがコンテナイメージの取得を試み、その試行が失敗したことを意味します。kubeletは試行をやめるわけではなく、失敗後、次の取得を試みる前に待機します。
**ImagePullBackOff**は、kubeletが次の取得試行までの間、待機している状態を意味します。失敗が繰り返されるほど、試行間の待機時間は長くなります。
バックオフは約10秒から始まり、指数関数的に増加します。おおよそ10秒、20秒、40秒という具合です。上限は5分(300秒)で、最大の待機時間に達すると、kubeletは約5分ごとに再試行を続けます。
Podが自動的に消えることはありません。イメージが取得可能になるか、根本的な問題が解決されるか、Podが削除されるまで、このサイクルが続きます。
Kubernetesはどのようにコンテナイメージを取得するのか?
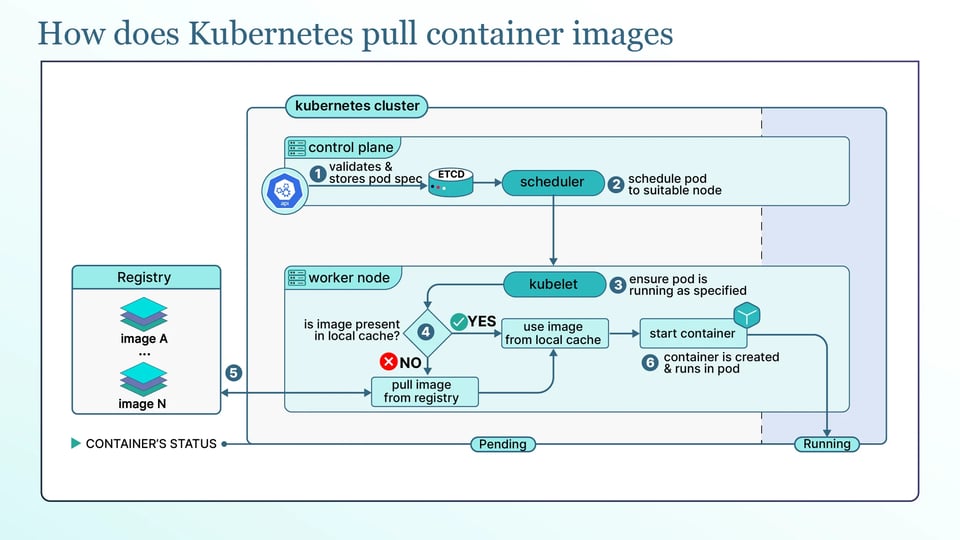
Kubernetesがイメージを取得する仕組みを理解すれば、ほとんどのErrImagePullエラーは把握しやすくなります。Podがノードにスケジュールされると、そのノードのkubeletがコンテナランタイム(containerdやCRI-Oなど)に対して、イメージが存在することを確認するよう依頼します。ランタイムはまずイメージ取得ポリシーと、イメージがすでにノード上にあるかどうかを確認します。取得が必要な場合はレジストリに接続し、レジストリがプライベートであれば認証を行い、イメージレイヤーをダウンロードして展開します。イメージの準備が整って初めてコンテナが起動します。名前の誤り、認証情報の欠如、ネットワークの問題など、これらのステップのいずれかで失敗するとErrImagePullとして現れます。
イメージ取得ポリシーは、Kubernetesがいつイメージを取得するかを制御します。選択肢は3つあります。
a. **Always**は、Podが起動するたびにイメージを取得します。イメージが:latestタグを使用しているか、タグがない場合のデフォルトです。
b. **IfNotPresent**は、イメージがまだノード上にない場合にのみ取得します。それ以外のタグを持つイメージのデフォルトです。
c. **Never**は、すでにノード上にあるイメージのみを使用するようランタイムに指示します。イメージの取得は一切行いません。イメージがローカルに存在しない場合、ErrImageNeverPullエラーが発生します。
イメージ参照は、正確にどのイメージを取得するかを制御します。リポジトリと、タグまたはダイジェストで構成され、repository:tagまたはrepository@sha256:<digest>と記述します。:1.4のようなタグは可変(mutable)であり、指し示すイメージが時間とともに変わる可能性があります。ダイジェストはイメージの一意なIDであり、常に同じイメージを指します。
ErrImagePullのよくある原因
ErrImagePullの原因は、たいてい次のいずれかです。
a. イメージ名、リポジトリ、タグの誤り:イメージ名のタイプミス、レジストリパスの誤り、存在しないタグは、いずれも取得の失敗を招きます。メッセージは通常、manifest unknownやrepository does not exist or may require authorizationのような内容です。まず最初に確認すべき項目です。
b. レジストリ認証情報の欠如・誤り・期限切れ:プライベートレジストリには認証情報が必要で、それが欠けていたり誤っていたりすると、unauthorized: authentication requiredで取得が失敗します。よくあるケースは、Podにpull secretがアタッチされていない、シークレットが誤ったnamespaceにある、トークンが期限切れになっている、といったものです。たとえばAmazon ECRのトークンは有効期間が短いため、トークンの更新が設定されていないと、昨日は問題なく取得できていた構成が今日は失敗することがあります。
c. レジストリのレート制限とpullのスロットリング:パブリックレジストリには取得頻度の制限があります。Docker Hubは制限を超えるとtoomanyrequests(429レスポンス)を返します。現時点では、匿名でのpullはIPアドレスごとに6時間あたり100回、認証済みの無料アカウントは6時間あたり200回に制限されており、有料アカウントは無制限です。広く知られた「1時間あたり10回」という数字は発表されたものの実際には適用されなかったため、現在の制限は6時間あたり100回です。1つのパブリックIPを共有する負荷の高いクラスタでは、思った以上に到達しやすい制限です。
d. ノードのネットワーク、DNS、プロキシによるレジストリへのアクセス遮断:ノードがレジストリに到達できない場合、dial tcp: lookup ... no such hostやi/o timeoutのようなエラーで取得が失敗します。DNSの不具合、ランタイムに設定されていない社内プロキシ、ファイアウォールルール、あるいはパブリックレジストリへの経路がないエアギャップ環境のクラスタで発生します。
e. プライベートレジストリでのTLS証明書エラー:自己署名証明書などの信頼されていない証明書を使用するプライベートレジストリでは、x509: certificate signed by unknown authorityで取得が失敗します。ノードのコンテナランタイムがレジストリの証明書を信頼していないため、接続を拒否するのです。
f. イメージのアーキテクチャがノードのCPUと一致しない:amd64向けにのみビルドされたイメージはarm64ノードでは動作せず、no matching manifest for linux/arm64で取得が失敗します。CPUアーキテクチャが混在するクラスタやArmベースのノードでよく発生します。
g. ノードのディスク逼迫とイメージレイヤー用の容量不足:イメージレイヤーにはノード上の空き容量が必要です。ノードのディスクが不足していると、no space left on deviceで取得が失敗し、さらにノードにdisk-pressure状態が発生して新しいPodの配置が止まることもあります。
ErrImagePullエラーの診断方法
原因の特定は、基本的に次の順序で正しい出力を読み解く作業です。
a. kubectl get podsでPodのステータスを確認する:これで症状を確認します。PodのSTATUSにErrImagePullまたはImagePullBackOffが表示され、増加するRESTARTS数や経過時間から、どれくらいの間止まっているかがわかります。
kubectl get pods
b. kubectl describe podで実際のエラーを見つける:これが鍵となるステップです。kubectl describe podの出力のEvents:セクションに実際のイメージ取得エラーが表示され、多くの場合、どの原因に該当するかがわかります。
kubectl describe pod <pod-name>Failed to pull image ...: unauthorizedや... no such hostといったメッセージを持つFailedイベントを探してください。ほとんどの場合、このメッセージが答えです。
c. ノード上でkubeletとcontainerdのログを確認する:イベントのメッセージだけでは不十分な場合、スケジュールされたノード上のログにより詳細な情報があります。ノード上で、journalctl -u kubeletでkubeletのログを読み、同様にcontainerdのログを読めば、ランタイム視点での取得状況を確認できます。
d. crictl pullでノード上から取得を再現する:問題がノード自体にあるかどうかを確認するには、CRIのデバッグツールであるcrictlを使ってノード上で直接イメージを取得します。
crictl pull <image>これが同じエラーで失敗する場合、問題はPod仕様ではなく、ネットワーク、認証情報、TLSの信頼設定など、ノードレベルにあります。
ErrImagePullの解決方法
原因がわかれば、解決策は多くの場合シンプルです。上記の原因に対応する解決策は次のとおりです。
a. イメージ参照を修正し、ダイジェストで固定する:まずリポジトリ、タグ、レジストリパスのタイプミスを修正してください。本番のworkloadsでは、さらに一歩進めて、可変のタグではなくダイジェスト(repository@sha256:<digest>)でイメージを固定し、Podが常にテスト済みのイメージそのものを取得するようにします。
b. imagePullSecretを作成してアタッチする:プライベートレジストリの場合、pull secretを作成してPodに渡します。次のコマンドでシークレットを作成します。
kubectl create secret docker-registry regcred \ --docker-server=<registry> \ --docker-username=<user> \ --docker-password=<password> \ --namespace=<namespace>次に、Pod仕様のimagePullSecretsで参照するか、PodのServiceAccountにアタッチして、そのアカウントを使用するすべてのPodに自動的に適用されるようにします。シークレットはPodと同じnamespaceに存在する必要があります。
c. ノードのネットワーク、プロキシ設定、CA信頼を修正する:ネットワークが原因の場合は、ノードからレジストリの名前解決と接続ができることを確認します。ノードがプロキシを使用する場合は、コンテナランタイムがプロキシを使うよう設定します。TLSエラーの場合は、レジストリのCA証明書をノードの信頼ストアまたはランタイムの設定に追加し、レジストリを信頼させます。
d. レジストリミラーまたはpull-throughキャッシュを設定する:レート制限を回避するには、同じパブリックイメージをインターネットから何度も取得するのをやめましょう。pull-throughキャッシュやレジストリミラー(たとえばECRのpull-throughキャッシュ)はイメージをクラスタの近くに保存できるうえ、認証付きでpullすれば制限も引き上げられます。
e. ディスク容量を解放し、イメージのガベージコレクションを調整する:ディスク逼迫の場合は、ノードの空き容量を確保し、kubeletに未使用イメージをクリーンアップさせます。kubeletのイメージガベージコレクションはimageGCHighThresholdPercent(デフォルト85)とimageGCLowThresholdPercent(デフォルト80)で制御され、ディスク使用率が高いしきい値を超えると、kubeletは低いしきい値に達するまで未使用イメージを削除します。しきい値を低くすればクリーンアップが早く始まり、ノードの容量逼迫を防ぐのに役立ちます。
マネージドクラスタとローカルクラスタにおけるErrImagePull
環境によってイメージの認証情報の扱いが異なるため、よくあるケースを知っておくと役立ちます。
a. Amazon EKSでECRから取得する場合:ECRからの取得には、Dockerのpull secretではなく、ノードまたはPodにAWSの権限が必要です。ノードのIAMロールにはAmazonEC2ContainerRegistryReadOnlyポリシーを使用できます。より限定的なアクセスには、IRSAまたはEKS Pod Identityを使って特定のworkloadsにアクセス権を付与します。ECRのトークンは有効期間が短いですが、kubeletが自動的に更新します。
b. GKEでArtifact Registryから取得する場合:ノードのサービスアカウントにはArtifact Registry Readerロールが必要です。workloadレベルのアクセスには、Workload Identityを使ってKubernetesのサービスアカウントとReaderロールを持つGoogleサービスアカウントを紐付けます。
c. minikubeやkindなどのローカルクラスタ:手元のノートPCでビルドしたイメージは、クラスタのノードでは利用できない場合があります。レジストリにプッシュする代わりに、イメージをクラスタに直接ロードしてください。minikubeの場合はminikube image load <image>、kindの場合はkind load docker-image <image>を使用します。その後、imagePullPolicyをIfNotPresentまたはNeverに設定し、Kubernetesがローカルイメージを使用するようにします。
ImagePullBackOffで止まったPodがノードのキャパシティと予算を無駄にする仕組み
PodがImagePullBackOffに達した時点で、そのPodはすでにノードにスケジュールされています。CPUとメモリのリクエストはノードの予約済みキャパシティにカウントされ、Podがイメージを待っている間、その予約は維持されます。つまり、ノードは何の仕事もしていないPodのためにキャパシティを確保し続けているのです。
止まっているPodが1つだけなら大きな問題にはならないかもしれません。しかし、多数のレプリカが止まったままのロールアウトや、過大なリソースリクエストを持つPodは、相当量のキャパシティを予約してしまいます。オートスケーリングを使用するクラスタでは、他のworkloadsの場所を確保するためにCluster Autoscalerがノードを追加してしまうことすらあります。止まったPodは何もしていないのに、キャパシティに対する支払いだけが発生するのです。
kubeletはイメージの取得を再試行し続けるため、イメージの問題が解決されるかPodが削除されるまで、この無駄なキャパシティが残り続ける可能性があります。
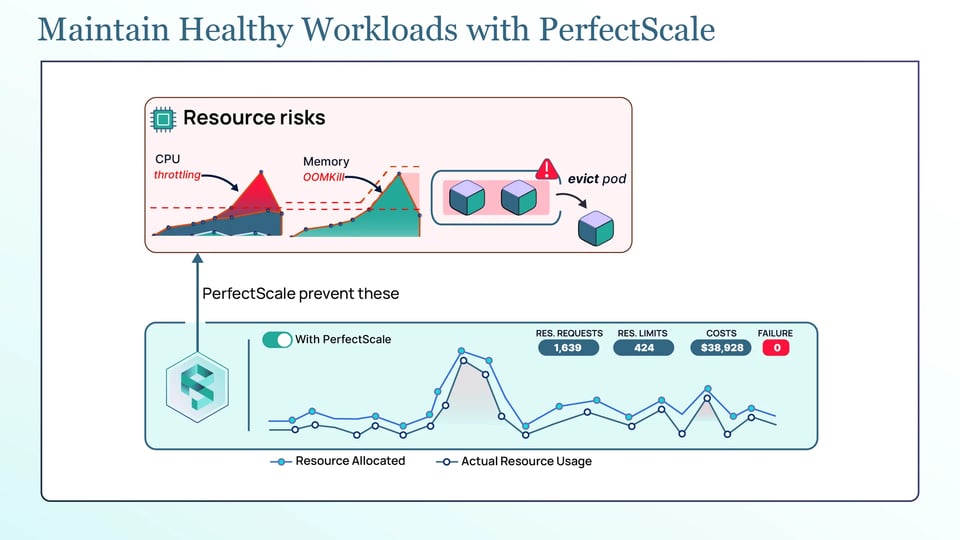
コスト面で役立つのがPerfectScaleです。PerfectScaleのKubernetesガバナンスプラットフォームは、workloadsによる実際のCPU・メモリ使用状況を可視化し、すぐに実行できる自動化されたライトサイジングの推奨として提示します。推奨は手動でも自律的にも適用できます。リクエストが適正化されていれば、止まったPodが確保するのは過大な量ではなく、本当に必要な分だけで済みます。Paramount PicturesやCreditasといったチームも、PerfectScaleを活用してクラスタの効率を維持しています。サインアップ、または技術セッションの予約が可能です。
ErrImagePullエラーを防ぐためのベストプラクティス
ErrImagePullエラーを防ぐための主なプラクティスは次のとおりです。
a. 本番のworkloadsでは可変タグではなくイメージダイジェストで固定する:ダイジェスト(@sha256:...)は常にテスト済みのイメージそのものを指すため、タグが変更されてもPodが取得するイメージは変わりません。
b. CPUが混在するノードプールにはマルチアーキテクチャイメージを公開する:ノードにamd64とarm64の両方が含まれる場合は、マルチアーキテクチャイメージを使用して、各ノードが正しいバージョンを取得できるようにします。
c. CIでイメージ参照を検証し、アドミッションポリシーを活用する:デプロイ前にイメージ名とタグを確認します。アドミッションポリシーを使えば、イメージダイジェストを必須にしたり、承認済みレジストリのイメージのみを許可したりすることもできます。
d. ロールアウト前に重要なイメージを事前に取得しておく:DaemonSetなどを使って重要なイメージを事前にノードへ取得しておけば、ロールアウトが起動時のイメージ取得に依存しなくなります。
e. イメージ取得の失敗、ノードのディスク逼迫、イメージガベージコレクションに対してアラートを設定する:取得の失敗、ディスク容量の不足、イメージガベージコレクションを早期に検知できれば、問題がより多くのPodやノードに波及する前に対処できます。