


ErrImagePull è l'errore che Kubernetes mostra quando il kubelet non riesce a effettuare il pull dell'immagine container di un pod. Il container viene eseguito a partire dall'immagine, quindi se il kubelet non riesce a scaricarla il container non si avvia mai. Di solito il sintomo è un pod bloccato in ErrImagePull o ImagePullBackOff, senza alcun log applicativo che lo spieghi, perché l'applicazione non è ancora stata eseguita.
In questa guida vedremo cosa significa ErrImagePull, in cosa differisce da ImagePullBackOff, come Kubernetes effettua il pull delle immagini, quali sono le cause più comuni, come diagnosticare il problema e come risolverlo. Vedremo inoltre come i pod bloccati possano sprecare capacità dei nodi.
Cos'è l'errore ErrImagePull in Kubernetes?
ErrImagePull indica che un singolo tentativo di pull dell'immagine è fallito. Quando si crea un pod, il kubelet sul nodo del pod chiede al container runtime di effettuare il pull dell'immagine indicata nella spec del pod. Se il pull fallisce per un motivo qualsiasi, lo stato del container diventa ErrImagePull e il container resta in attesa invece di avviarsi.
Il punto essenziale è che ErrImagePull riguarda il recupero dell'immagine, non la sua esecuzione. L'applicazione non è partita, quindi kubectl logs non ha nulla da mostrare. Il motivo del fallimento si trova negli eventi del pod.
ErrImagePull vs. ImagePullBackOff
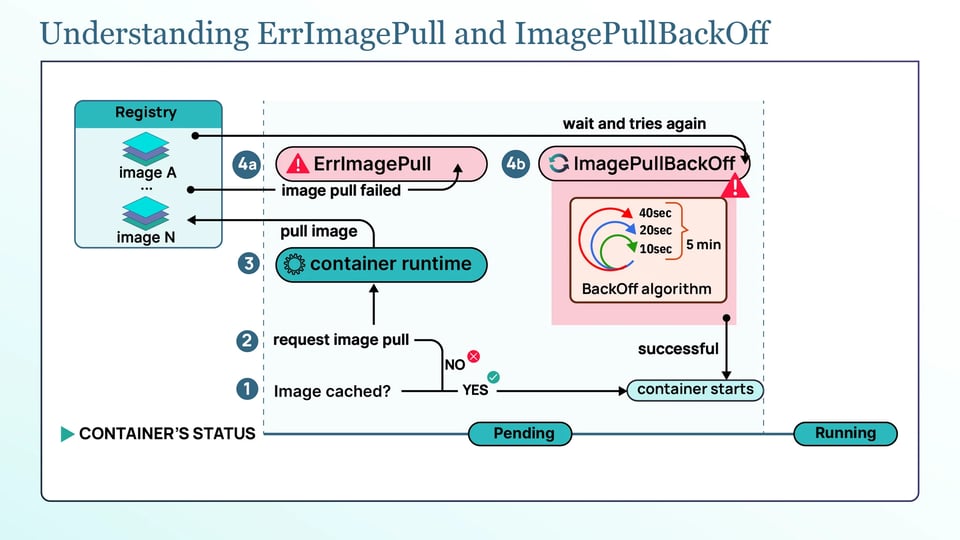
ErrImagePull significa che il kubelet ha tentato il pull dell'immagine container e il tentativo è fallito. I tentativi però non si fermano: dopo il fallimento, il kubelet attende prima di riprovare il pull.
ImagePullBackOff significa che il kubelet sta attendendo prima del prossimo tentativo di pull. L'intervallo tra i tentativi aumenta con il ripetersi dei fallimenti.
Il backoff parte da circa 10 secondi e cresce in modo esponenziale: all'incirca 10 secondi, 20 secondi, 40 secondi e così via, fino a un massimo di 5 minuti (300 secondi). Una volta raggiunto il ritardo massimo, il kubelet continua a riprovare all'incirca ogni 5 minuti.
Il pod non scompare automaticamente: resta in questo ciclo finché l'immagine non diventa scaricabile, il problema alla base non viene risolto o il pod non viene eliminato.
Come Kubernetes effettua il pull delle immagini container?
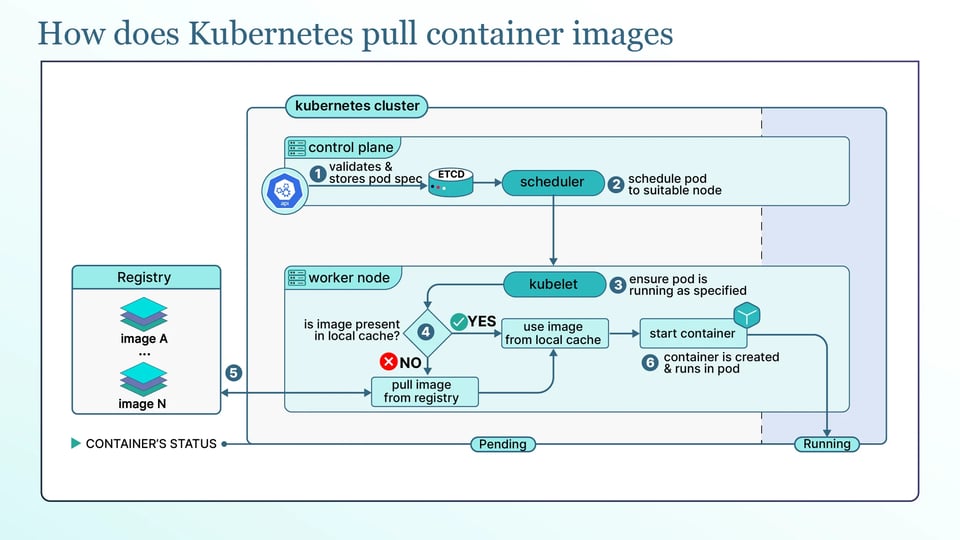
La maggior parte degli errori ErrImagePull è più facile da capire una volta compreso come Kubernetes effettua il pull di un'immagine. Quando un pod viene schedulato su un nodo, il kubelet di quel nodo chiede al container runtime (come containerd o CRI-O) di assicurarsi che l'immagine sia presente. Il runtime verifica prima la image pull policy e se l'immagine è già sul nodo. Se deve effettuare il pull, contatta il registry, si autentica se il registry è privato, scarica i layer dell'immagine e li estrae. Solo quando l'immagine è pronta il container si avvia. Un fallimento in uno qualsiasi di questi passaggi, ad esempio un nome errato, una credenziale mancante o un problema di rete, si manifesta come ErrImagePull.
La image pull policy determina quando Kubernetes effettua il pull di un'immagine. Le opzioni sono tre:
a. Always effettua il pull dell'immagine a ogni avvio del pod. È il valore predefinito quando l'immagine usa il tag :latest o non ha alcun tag.
b. IfNotPresent effettua il pull solo se l'immagine non è già presente sul nodo. È il valore predefinito per le immagini con qualsiasi altro tag.
c. Never indica al runtime di usare esclusivamente un'immagine già presente sul nodo, senza mai effettuare il pull. Se l'immagine non è disponibile localmente, si ottiene l'errore ErrImageNeverPull.
Il riferimento all'immagine determina esattamente quale immagine viene scaricata. Include un repository e un tag oppure un digest, nella forma repository:tag o repository@sha256:<digest>. Un tag come :1.4 è mutabile, cioè l'immagine a cui punta può cambiare nel tempo. Un digest è un identificativo univoco dell'immagine e punta quindi sempre alla stessa immagine.
Cause comuni di ErrImagePull
ErrImagePull deriva di solito dai seguenti problemi comuni:
a. Nome immagine, repository o tag errati: un refuso nel nome dell'immagine, un percorso di registry sbagliato o un tag inesistente fanno tutti fallire il pull. Il messaggio è in genere qualcosa come manifest unknown o repository does not exist or may require authorization. È la prima cosa da verificare.
b. Credenziali del registry mancanti, errate o scadute: un registry privato richiede credenziali e, se mancano o sono errate, il pull fallisce con unauthorized: authentication required. I casi più frequenti sono un pull secret mai associato al pod, un secret nel namespace sbagliato o un token scaduto. I token di Amazon ECR, ad esempio, hanno vita breve: una configurazione che ieri funzionava perfettamente può fallire oggi se il refresh del token non è stato configurato.
c. Rate limit del registry e throttling dei pull: i registry pubblici limitano la frequenza dei pull. Docker Hub restituisce toomanyrequests (una risposta 429) una volta superato il limite. Ad oggi, i pull anonimi sono limitati a 100 ogni 6 ore per indirizzo IP, gli account gratuiti autenticati arrivano a 200 ogni 6 ore e gli account a pagamento non hanno limiti. La cifra molto citata di "10 pull all'ora" era stata annunciata ma non è mai stata applicata: il limite attuale è quindi 100 ogni 6 ore. In un cluster molto attivo dietro un unico IP pubblico, è più facile raggiungerlo di quanto sembri.
d. Rete del nodo, DNS o proxy che bloccano il registry: se il nodo non riesce a raggiungere il registry, il pull fallisce con errori come dial tcp: lookup ... no such host o i/o timeout. Succede con un DNS malfunzionante, un proxy aziendale che il runtime non conosce, una regola firewall o un cluster air-gapped senza rotta verso un registry pubblico.
e. Errori di certificato TLS con registry privati: un registry privato che usa un certificato self-signed o comunque non attendibile fa fallire il pull con x509: certificate signed by unknown authority. Il container runtime del nodo non considera attendibile il certificato del registry e rifiuta la connessione.
f. Architettura dell'immagine non corrispondente alla CPU del nodo: un'immagine compilata solo per amd64 non funziona su un nodo arm64 e il pull fallisce con no matching manifest for linux/arm64. È un caso frequente nei cluster con CPU miste e sui nodi basati su Arm.
g. Disk pressure sul nodo e spazio insufficiente per i layer dell'immagine: i layer dell'immagine hanno bisogno di spazio sul nodo. Se lo spazio su disco è quasi esaurito, il pull fallisce con no space left on device e il nodo può inoltre presentare una condizione di disk pressure che impedisce a nuovi pod di essere schedulati lì.
Come diagnosticare un errore ErrImagePull?
Individuare la causa è soprattutto questione di leggere l'output giusto, nell'ordine seguente:
a. Leggere lo stato del pod con kubectl get pods: questo conferma il sintomo. Lo STATUS del pod mostra ErrImagePull o ImagePullBackOff, e un conteggio RESTARTS in aumento o l'età del pod indicano da quanto tempo è bloccato.
kubectl get pods
b. Trovare l'errore effettivo in kubectl describe pod: questo è il passaggio chiave. La sezione Events: nell'output di kubectl describe pod mostra l'errore di pull effettivo, che in genere indica con quale causa si ha a che fare.
kubectl describe pod <pod-name>Cercare un evento Failed con un messaggio come Failed to pull image ...: unauthorized o ... no such host. Nella maggior parte dei casi quel messaggio è già la risposta.
c. Controllare i log di kubelet e containerd sul nodo: se il messaggio dell'evento non basta, i log sul nodo su cui il pod è stato schedulato offrono maggiori dettagli. Sul nodo, leggere il log del kubelet con journalctl -u kubelet e, allo stesso modo, il log di containerd per il punto di vista del runtime sul pull.
d. Riprodurre il pull dal nodo con crictl pull: per confermare se il problema è sul nodo stesso, effettuare il pull dell'immagine direttamente con crictl, lo strumento di debugging CRI, sul nodo:
crictl pull <image>Se fallisce con lo stesso errore, il problema è a livello di nodo (rete, credenziali o trust TLS) e non nella spec del pod.
Come risolvere ErrImagePull?
Una volta individuata la causa, la soluzione è in genere semplice. Ecco le soluzioni per le cause elencate sopra:
a. Correggere il riferimento all'immagine e ancorarlo a un digest: bisogna prima correggere eventuali refusi nel repository, nel tag o nel percorso del registry. Per i workloads in produzione, è consigliabile andare oltre e ancorare l'immagine a un digest (repository@sha256:<digest>) invece che a un tag mutabile, così il pod scarica sempre esattamente l'immagine testata.
b. Creare un imagePullSecret e associarlo: per un registry privato, creare un pull secret e fornirlo al pod. Creare il secret:
kubectl create secret docker-registry regcred \ --docker-server=<registry> \ --docker-username=<user> \ --docker-password=<password> \ --namespace=<namespace>Poi referenziarlo nella spec del pod sotto imagePullSecrets, oppure associarlo al ServiceAccount del pod, così ogni pod che usa quell'account lo riceve automaticamente. Il secret deve trovarsi nello stesso namespace del pod.
c. Sistemare la rete del nodo, le impostazioni del proxy e il trust delle CA: per le cause di rete, assicurarsi che il nodo possa risolvere e raggiungere il registry. Se il nodo usa un proxy, configurare il container runtime perché lo utilizzi. Per un errore TLS, aggiungere il certificato CA del registry al trust store del nodo o alla configurazione del runtime, così che il registry venga considerato attendibile.
d. Configurare un registry mirror o una pull-through cache: per evitare i rate limit, evitare di scaricare ripetutamente le stesse immagini pubbliche da internet. Una pull-through cache o un registry mirror (ad esempio una pull-through cache di ECR) mantiene le immagini più vicine al cluster, e autenticare i pull aumenta inoltre il limite disponibile.
e. Liberare spazio su disco e regolare la garbage collection delle immagini: in caso di disk pressure, liberare spazio sul nodo e lasciare che il kubelet ripulisca le immagini inutilizzate. La garbage collection delle immagini del kubelet è controllata da imageGCHighThresholdPercent (default 85) e imageGCLowThresholdPercent (default 80): quando l'utilizzo del disco supera la soglia alta, il kubelet rimuove le immagini inutilizzate finché non raggiunge quella bassa. Una soglia più bassa fa partire prima la pulizia, aiutando a evitare che i nodi si riempiano.
ErrImagePull nei cluster gestiti e locali
Alcuni ambienti gestiscono le credenziali delle immagini in modo diverso, quindi è utile conoscere i casi più comuni:
a. Amazon EKS con pull da ECR: il nodo o il pod hanno bisogno di permessi AWS per effettuare il pull da ECR, non di un pull secret Docker. Il ruolo IAM del nodo può usare la policy AmazonEC2ContainerRegistryReadOnly. Per un accesso più limitato, usare IRSA o EKS Pod Identity per dare accesso a workloads specifici. I token ECR hanno vita breve, ma il kubelet li aggiorna automaticamente.
b. GKE con pull da Artifact Registry: il service account del nodo ha bisogno del ruolo Artifact Registry Reader. Per un accesso a livello di workload, usare Workload Identity per collegare un service account Kubernetes a un service account Google con il ruolo Reader.
c. Cluster locali come minikube e kind: un'immagine costruita sul proprio laptop potrebbe non essere disponibile sui nodi del cluster. Caricare l'immagine direttamente nel cluster invece di inviarla a un registry. Con minikube, usare minikube image load <image>. Con kind, usare kind load docker-image <image>. Impostare poi imagePullPolicy su IfNotPresent o Never, così che Kubernetes usi l'immagine locale.
Come i pod bloccati in ImagePullBackOff sprecano capacità dei nodi e budget?
Quando un pod arriva in ImagePullBackOff, è già stato schedulato su un nodo. Le sue richieste di CPU e memoria contano ai fini della capacità riservata del nodo, e la prenotazione resta attiva mentre il pod attende l'immagine. Il nodo, quindi, trattiene capacità per un pod che non sta facendo alcun lavoro.
Un singolo pod bloccato può non incidere molto. Ma un rollout con molte repliche bloccate, o pod con richieste di risorse sovradimensionate, può riservare una quantità di capacità significativa. In un cluster con autoscaling, questo può addirittura spingere il Cluster Autoscaler ad aggiungere nodi per fare spazio agli altri workloads. Il risultato è pagare capacità mentre i pod bloccati non fanno nulla.
Poiché il kubelet continua a ritentare il pull dell'immagine, questa capacità sprecata può persistere finché il problema con l'immagine non viene risolto o il pod non viene rimosso.
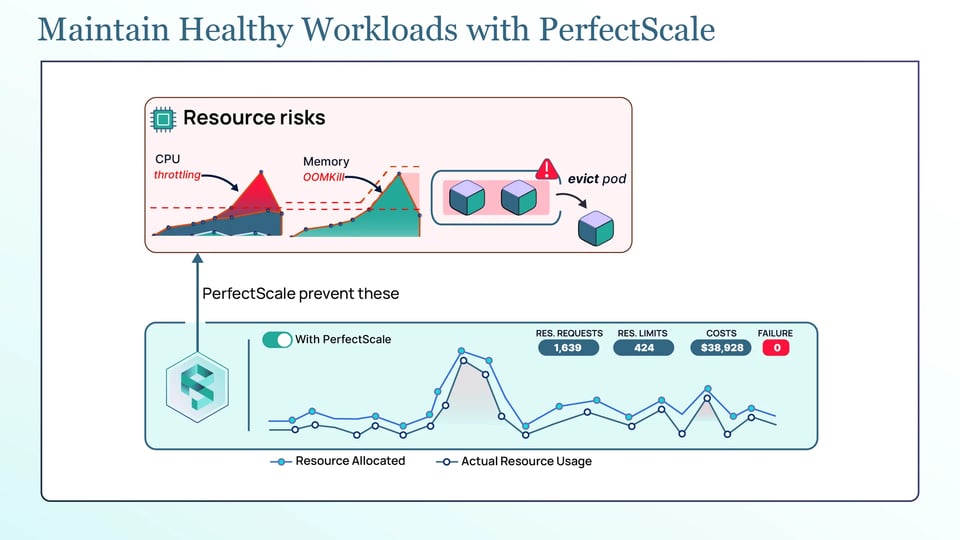
È qui che PerfectScale aiuta sul fronte dei costi. La piattaforma di governance Kubernetes di PerfectScale offre visibilità su come i workloads utilizzano realmente CPU e memoria e la traduce in raccomandazioni di right-sizing concrete e automatizzate, applicabili manualmente o in modo autonomo. Con richieste correttamente dimensionate, un pod bloccato riserva solo ciò di cui ha davvero bisogno, non una quantità sovradimensionata. Team come Paramount Pictures e Creditas usano PerfectScale per mantenere efficienti i propri cluster. È possibile registrarsi o prenotare una sessione tecnica.
Best practice per prevenire gli errori ErrImagePull
Ecco le principali pratiche per prevenire gli errori ErrImagePull:
a. Ancorare i workloads di produzione a digest delle immagini invece che a tag mutabili: un digest (@sha256:...) punta sempre esattamente all'immagine testata, quindi le modifiche a un tag non possono cambiare l'immagine scaricata dai pod.
b. Pubblicare immagini multi-architettura per node pool con CPU miste: se i nodi includono sia amd64 sia arm64, usare immagini multi-architettura così che ogni nodo possa scaricare la versione corretta.
c. Validare i riferimenti alle immagini in CI e usare admission policy: verificare nomi e tag delle immagini prima del deployment. Le admission policy possono anche imporre l'uso dei digest o consentire immagini solo da registry approvati.
d. Effettuare il pre-pull delle immagini critiche prima di un rollout: è opportuno scaricare in anticipo le immagini importanti sui nodi, ad esempio con un DaemonSet, così che il rollout non dipenda dal pull dell'immagine all'avvio.
e. Impostare alert su pull falliti, disk pressure dei nodi e garbage collection delle immagini: alert tempestivi su pull falliti, spazio su disco in esaurimento e garbage collection delle immagini aiutano a individuare i problemi prima che coinvolgano altri pod o nodi.